5.0 把
string拆成text(分词、全文检索)和keyword(不分词,精确匹配、排序、聚合)。对升级最有影响的有三点:5.x 期间 5.0 之前创建的索引里string照旧;新索引里写string会被改写成text或keyword,带了白名单之外的参数就直接报错;text默认不能用来排序和聚合,会抛异常。本文对照 v5.6.16 源码把这几条的边界核了一遍。
说明
来源和边界先交代:本文的依据出自 v5.6.16 标签下的官方文件(mapping.asciidoc、TextFieldMapper.java、DocumentParser.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
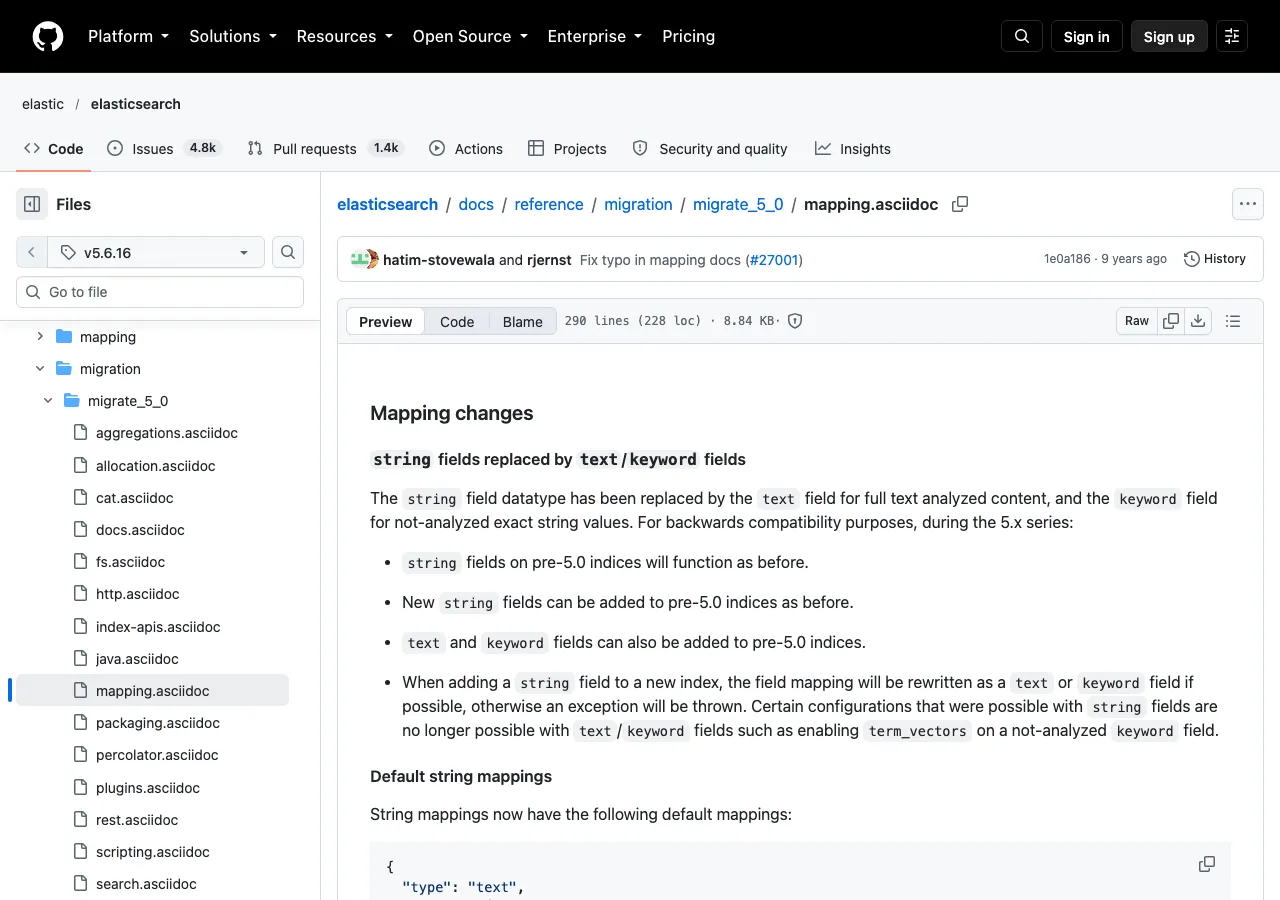
图 1:官方文件 mapping.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 mapping.asciidoc
官方说明
5.0 迁移文档(migrate_5_0/mapping.asciidoc 第 4–17 行)的原文:
The
stringfield datatype has been replaced by thetextfield for full text analyzed content, and thekeywordfield for not-analyzed exact string values. For backwards compatibility purposes, during the 5.x series:
向后兼容规则,仅限 5.x 系列:
- 5.0 之前索引里的
string字段行为不变; - 5.0 之前的索引仍可以新增
string字段,行为照旧; - 5.0 之前的索引也可以新增
text、keyword字段; - 给新索引加
string字段时,如果能改写成text或keyword就自动改写,否则抛异常。
最后一条文档举的例子是:在 not-analyzed 的 keyword 字段上开 term_vectors,用 string 时可以,换成 keyword 就不行。"改写不了"具体指什么,下文用源码核对。
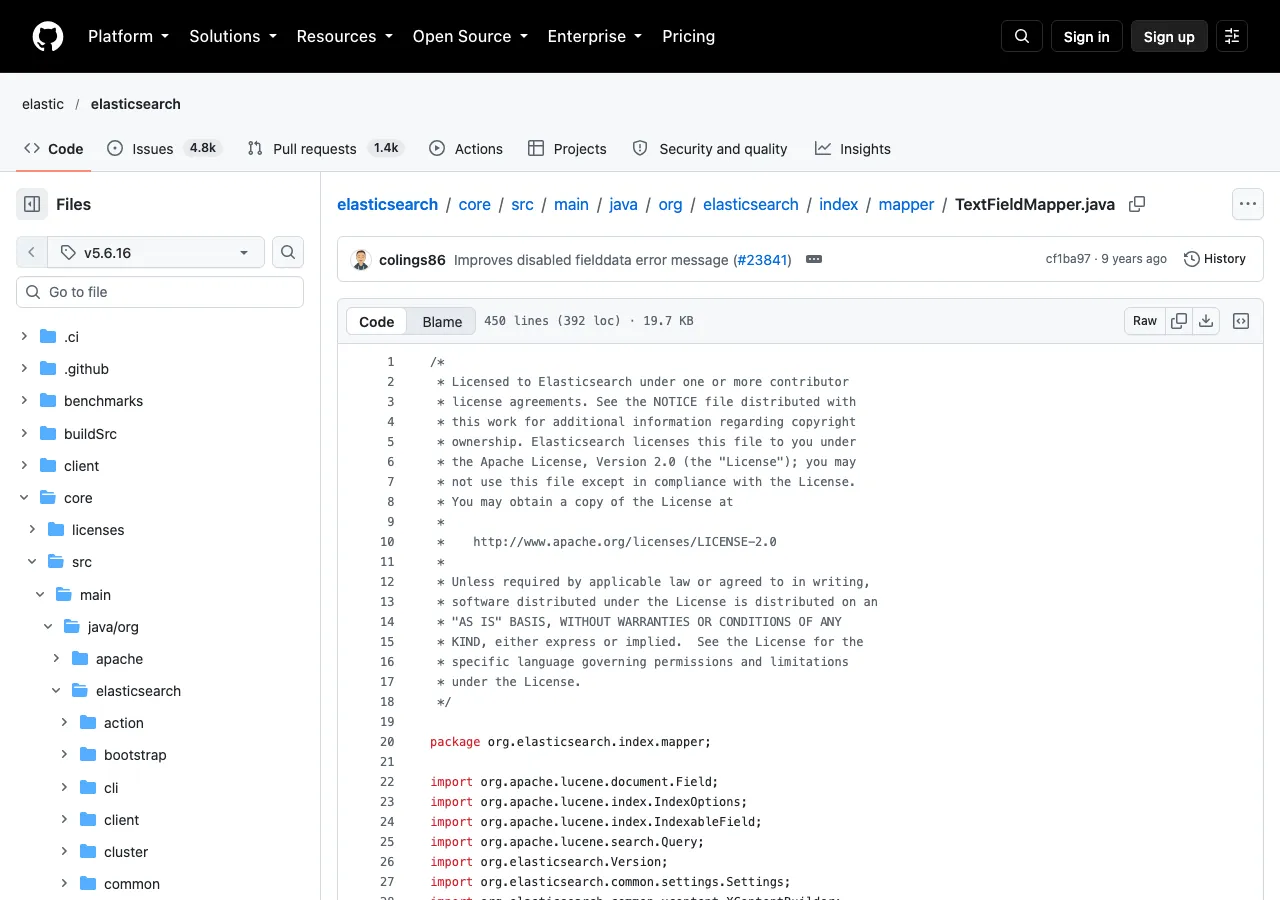
图 2:官方文件 TextFieldMapper.java(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 TextFieldMapper.java
为什么要拆
2.x 的 string 靠 index: analyzed|not_analyzed 一个开关切换两种形态:
- analyzed:走分析器,建倒排词项,支持全文检索,聚合和排序落在单个词项上,不适合精确值;
- not_analyzed:整个值作为一个词项入索引,支持精确过滤、排序、聚合,没有全文检索能力。
一个类型承担两种语义,想要"既能全文检索又能精确聚合"就得用 multi-field 手工搭一个 .raw 子字段。迁移文档里 index 参数的变化也能看出这一点:除了 string 之外,所有类型的 index 现在只接受 true 或 false(第 96–100 行)。拆成 text 和 keyword 之后,语义由类型名决定,不用再靠一个参数的取值去区分。
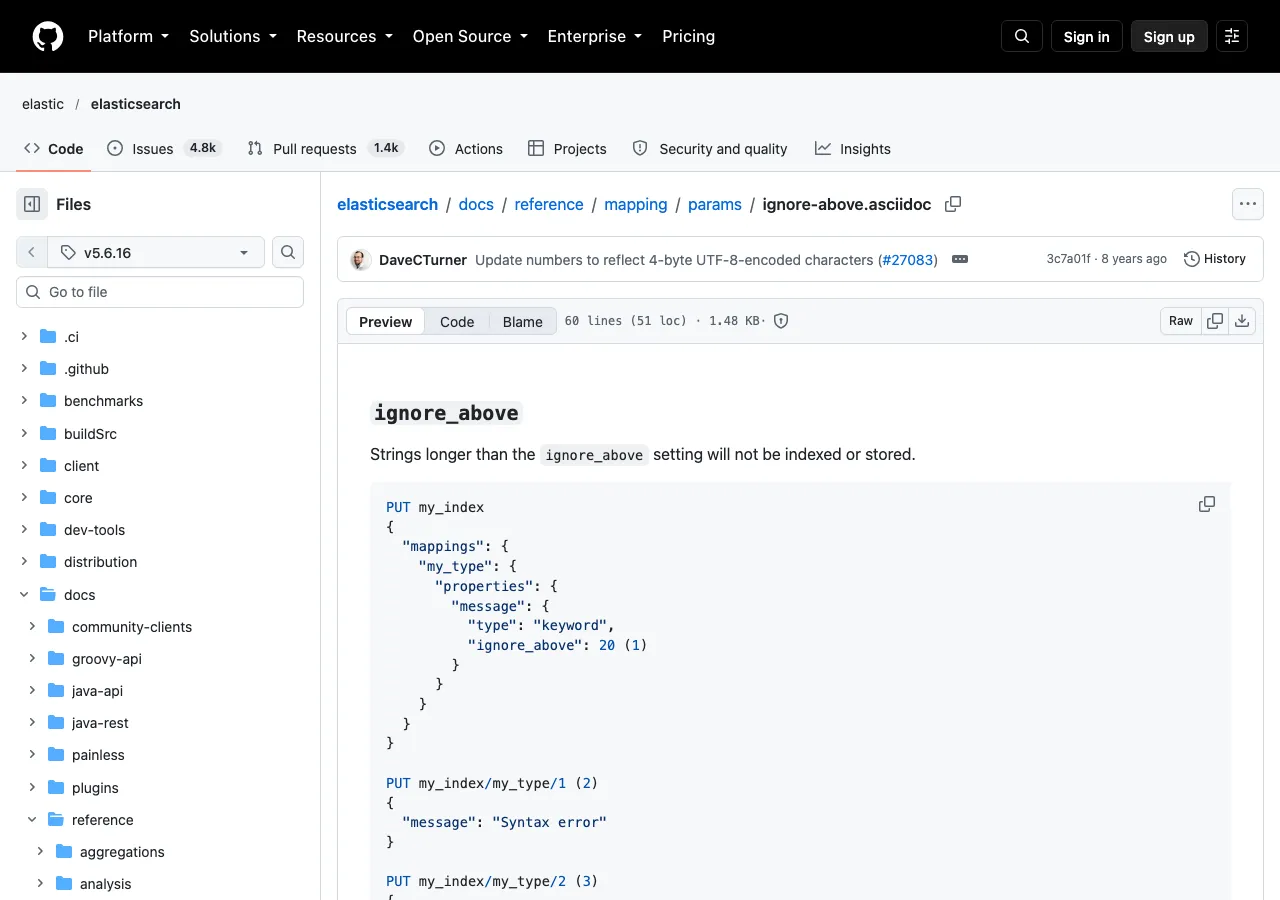
图 3:官方文件 ignore-above.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 ignore-above.asciidoc
拆分的价值是把隐含约定变成显式声明
string 的两种用途在查询侧很容易混:
- 对 analyzed 字段做 terms 聚合,聚合的是词项而不是整个值(见 facets 与聚合的由来);
- 对 analyzed 字段排序,用的是词项顺序而不是整个字段值;
- 想精确匹配却查了 analyzed 字段,匹配不上。
5.0 之后,类型名就说明了用途:text 分词,keyword 不分词。这类靠记忆避免的错误,在 mapping 层就能看出来。下面几节说的是升级时真正会碰到的几处行为,它们和这个判断直接相关:最典型的一条就是 text 默认拒绝排序和聚合。
text 默认不能排序和聚合
5.0 之前 string 的 fielddata 默认开着,analyzed 字段也能直接聚合。text 反过来,默认关闭。源码里 TextFieldMapper 第 334–340 行的 fielddataBuilder 在 fielddata 为 false 时直接抛 IllegalArgumentException:
Fielddata is disabled on text fields by default. Set fielddata=true on [字段名] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead.
所以对 text 字段做排序或 terms 聚合,结果是请求直接失败,不是算出个错值。错误消息本身给了两条路:给这个字段开 fielddata=true(会在堆内存里反转倒排索引,消息里明确说可能占用大量内存),或者改用 keyword 字段。
对应地,旧写法里直接对 analyzed 的 string 字段做聚合的查询,在 5.x 的新索引上会开始报这个错。这一点比"字段名要改成 .keyword"更需要先查。
动态映射的默认结构变了
5.0 起字符串的默认动态映射是这个(迁移文档 第 19–37 行):
{

  "type": "text",
  "fields": {

    "keyword": {

      "type": "keyword",
      "ignore_above": 256
    }
  }
}
官方解释了意图:
This allows to perform full-text search on the original field name and to sort and run aggregations on the sub keyword field.
对应的源码在 DocumentParser 第 745–750 行:没有匹配的 dynamic template 时,字符串值的默认 builder 是 TextFieldMapper.Builder,再 addMultiField 一个 keyword 子字段,ignoreAbove(256)。
一个 message 字段由此有两个入口:message 做全文检索,message.keyword 做排序和聚合。
两点需要说清楚。
第一,ignore_above: 256 按字符数算,不是字节数。KeywordFieldMapper 第 340 行的判断是 value.length() > ignoreAbove,length() 是字符数。官方的 ignore_above 文档也写了:这个值是字符数,Lucene 的词项长度上限 32766 是按字节算的,含大量非 ASCII 字符的 UTF-8 文本要留余量。超过 256 个字符的字符串不会进入 .keyword 子字段,在这个子字段上的精确匹配和聚合也就看不到这些值。
第二,每个字符串字段多一份 keyword 子字段,索引体积会上升。文档里没有给数字,本文也不编。字段多、文本长的索引需要评估,不需要精确匹配的字段可以用 dynamic template 把字符串显式映射成只有 text:
PUT my_index
{

  "mappings": {

    "my_type": {

      "dynamic_templates": [
        {

          "strings_as_text": {

            "match_mapping_type": "string",
            "mapping": {
    "type": "text" }
          }
        }
      ]
    }
  }
}
这个模板对应源码里"先找匹配的 dynamic template,找不到才用默认带子字段的 builder"的顺序。
新索引里写 string:什么能改写,什么直接报错
"能改写就改写,否则抛异常"的实现在 StringFieldMapper 第 197 行起的 TypeParser.parse。
对 5.0 及以后创建的索引:
index只接受no、not_analyzed、analyzed三个值(不写也行);- 写了
index且不是analyzed,改写成keyword,否则(analyzed或没写)改写成text。所以index: "no"的string会被改成keyword加index: false; - 如果字段里的所有参数都在白名单里,就改写成功,并输出一条 deprecation 日志:
The [string] field is deprecated, please use [text] or [keyword] instead on [字段名]; - 只要有一个参数不在白名单里,就抛
IllegalArgumentException,消息是The [string] type is removed in 5.0 and automatic upgrade failed because parameters [...] are not supported for automatic upgrades. You should now use either a [text] or [keyword] field instead for field [字段名]。
白名单在 第 58–71 行,分两份:
| 改写目标 | 允许的参数 |
|---|---|
keyword |
type、index、store、doc_values、omit_norms、norms、fields、copy_to、fielddata、include_in_all、ignore_above |
text |
type、index、store、doc_values、omit_norms、norms、fields、copy_to、fielddata、include_in_all、analyzer、search_analyzer、search_quote_analyzer、index_options、position_increment_gap |
从这张表能推出几条文档没有逐项列出的结论:
- 迁移文档的例子是
keyword加term_vectors。按白名单,term_vector不在任何一份里,所以带了term_vector的string无论走text还是keyword都不会被自动改写,新索引里会报错。想保留它,要自己把字段改写成text并显式配置term_vector; boost、null_value、similarity也不在白名单里,用了它们的string同样改不了;ignore_above只在keyword的白名单里,所以 analyzed 的string带ignore_above会失败。
以上是读源码得到的结论,没有在集群上跑过。重建索引前把旧 mapping 里每个 string 字段用到的参数列出来,对照这张表,比等报错更快。
老索引上的 text/keyword:反向降级
迁移文档说 5.0 之前的索引"也可以新增 text、keyword 字段"。源码的做法写在注释里:KeywordFieldMapper 第 133–150 行和 TextFieldMapper 第 146–180 行都是在 2.x 创建的索引里把 keyword、text 降级成 string,目的是"让你用新语法去操作老索引"。降级同样有白名单,超出会抛 Automatic downgrade from [text] to [string] failed because parameters [...] are not supported for automatic downgrades,keyword 同理。
两个细节。text 降级时 index 缺省会变成 analyzed,fielddata 缺省会被设成 false(源码注释写的是"string 里默认 true,text 里默认 false");keyword 降级时 index 缺省会变成 not_analyzed。所以老索引里新加的 text 字段,在排序和聚合上和新索引上的 text 一致,默认也不能用。但老索引里原有的 string 字段保持老行为,fielddata 默认仍是开着的。
迁移改写对照
| 2.x 写法 | 5.x 写法 |
|---|---|
{ "type": "string", "index": "analyzed" } |
{ "type": "text" } |
{ "type": "string", "index": "not_analyzed" } |
{ "type": "keyword" } |
{ "type": "string" } 加手工 .raw 子字段 |
{ "type": "text", "fields": { "raw": { "type": "keyword" } } },名字自己定;靠动态映射则自动是 .keyword |
{ "type": "string", "index": "no" } |
{ "type": "keyword", "index": false }(自动改写的结果) |
查询侧的改写取决于字段在新 mapping 里长什么样:
- 如果显式映射成
keyword,字段名不变,聚合和排序继续用原字段名:"field": "status"; - 如果走动态映射得到
text加.keyword,聚合和排序要写"field": "status.keyword"。
迁移文档的意图是第二种场景。我的判断是两种写法不要混:一个字段显式映射成 keyword 之后,再去写 status.keyword 会找不到字段。
升级路径
- 2.x 创建的索引不需要立刻重建,5.x 期间
string继续按老行为工作; - 新索引不要再写
string,直接用text、keyword,避免 deprecation 日志和改写失败; - 重建索引时把 mapping 改成新类型,旧的手工
.raw子字段可以保留,也可以换成动态映射的默认.keyword; - 检查聚合和排序请求:原来直接对 analyzed 字段做 terms 聚合或排序的,现在在
text上会报 fielddata 错误,要改指向 keyword 字段; - 重建前列出旧 mapping 里所有
string字段的参数,对照白名单,term_vector、boost、null_value、similarity这类不在表里的要手工改写。
先看现有索引里有多少 string 字段:
curl -s 'localhost:9200/_all/_mapping?pretty' | grep -c '"type" : "string"'
哪些配置要重新设计
我的建议是按字段用途定类型,比硬套旧配置更稳:
- 要全文检索:
text; - 要精确匹配、排序、聚合:
keyword; - 只要存着不索引:
keyword加"index": false(string的index: "no"自动改写的结果就是这个); - 要 term vectors 或词项级统计:用
text,并手工配置。
迁移文档提醒过 index: no 的一个差别(第 102–106 行):以前 index: no 会同时关闭 doc values,现在除了 text 和 binary 以外,doc values 默认开启,和 index 取值无关。所以一个 keyword 加 index: false 的字段仍然可以排序和聚合,磁盘上多一份 doc values。
写在最后
升级时要先确认三件事:
- 老索引不动,新索引不要写
string; - 聚合和排序不要落在
text上,text默认直接报错; - 重建前把
string字段用到的参数对照改写白名单,白名单外的参数没有自动路径。
拆分把"这个字段分不分词"写在了类型名里,这是它的价值。代价是旧 mapping 里依赖隐含行为的地方会在重建时变成显式的报错,早发现比晚发现便宜。
参考
本文对照 Elasticsearch
v5.6.16标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。