9.3 给 ES|QL 加了节点级延迟物化。这条改动不影响查询结果,只影响查询怎么执行——所以你看不到任何变化,但某些排序查询会明显变快。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.3.0.yml、EsqlCapabilities.java、ComputeService.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
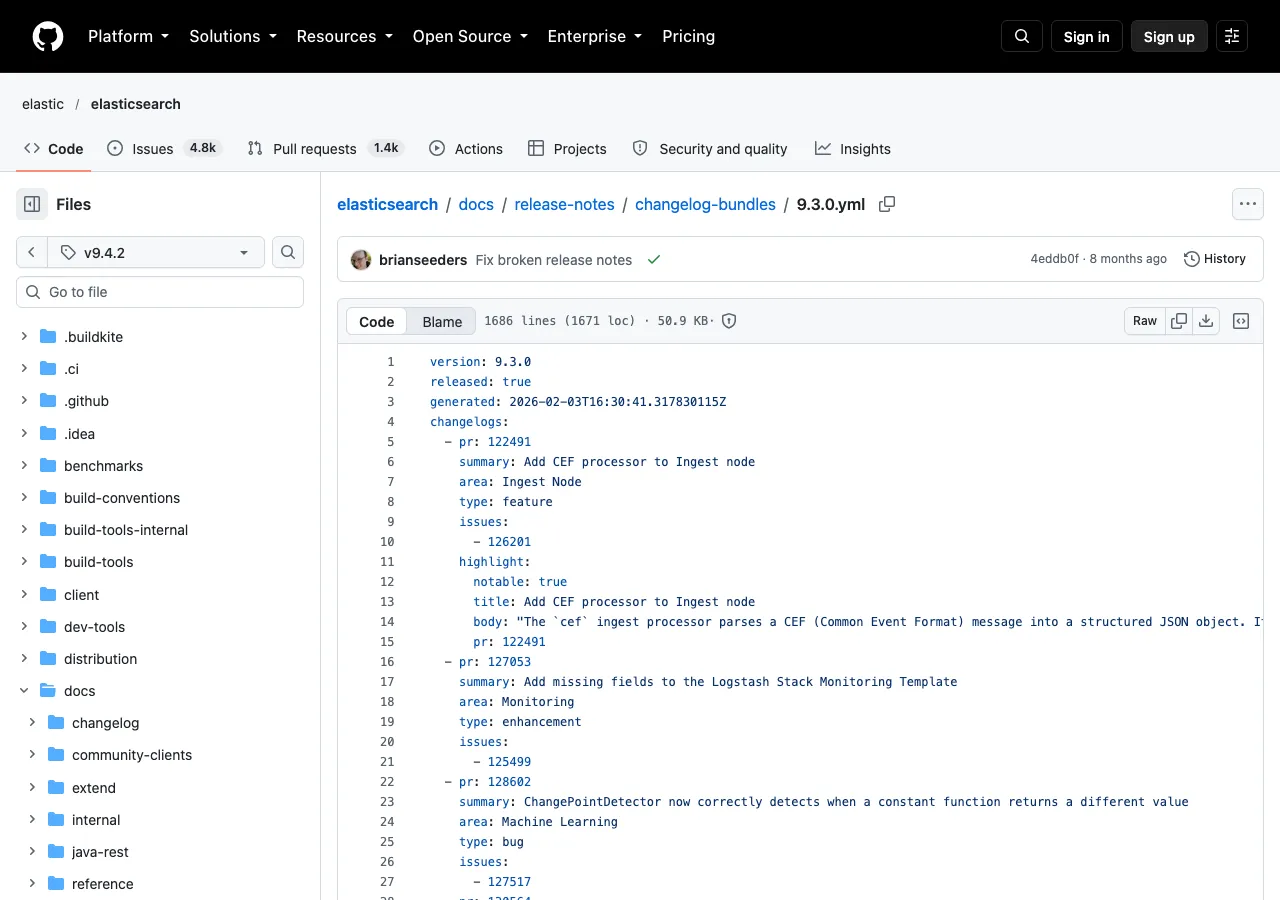
图 1:官方文件 9.3.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.3.0.yml
官方条目
9.3 的 changelog 标为 feature(9.3.0.yml 第 39–42 行 @ v9.4.2),area: ES|QL,PR 132962。
只有一行 summary。实质内容来自源码。
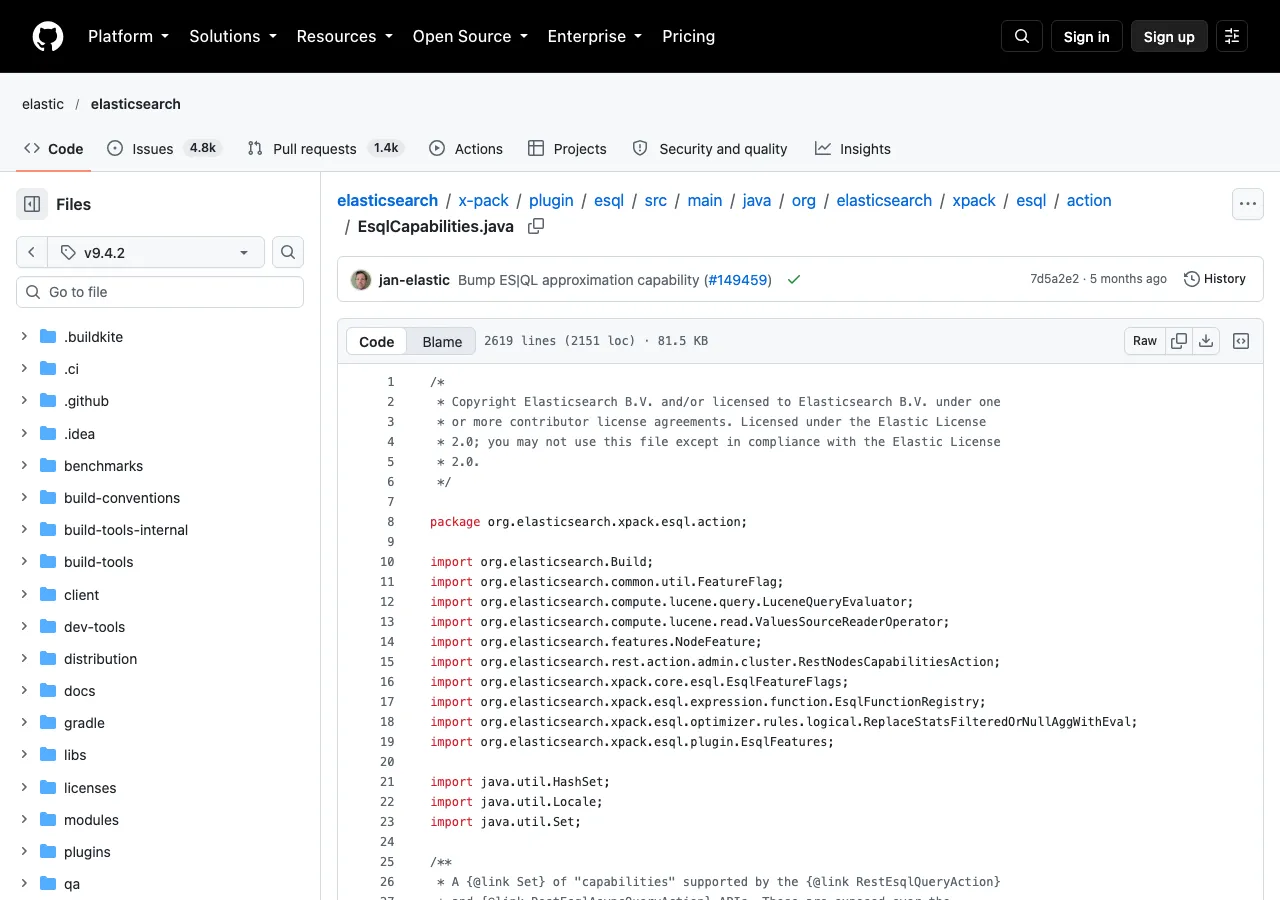
图 2:官方文件 EsqlCapabilities.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 EsqlCapabilities.java
先说物化是什么
ES|QL 查询里有两类数据:
- 排序键:
SORT用的字段; - 其余列:最终结果要返回的其他字段。
物化(materialization)指的是:把一行需要的字段值真正取出来。
朴素做法是先把所有列都取出来,再排序。问题在于:如果最终只要 Top 10,你却先把 100 万行的所有列都取出来了——其中 99.99% 的工作是白做的。
延迟物化就是把顺序反过来:
- 先只取排序键;
- 排序、截断,只留下 Top N;
- 这时候才去取这 N 行的其余列。
省掉的是步骤 1 里那些"取了又扔掉"的列。
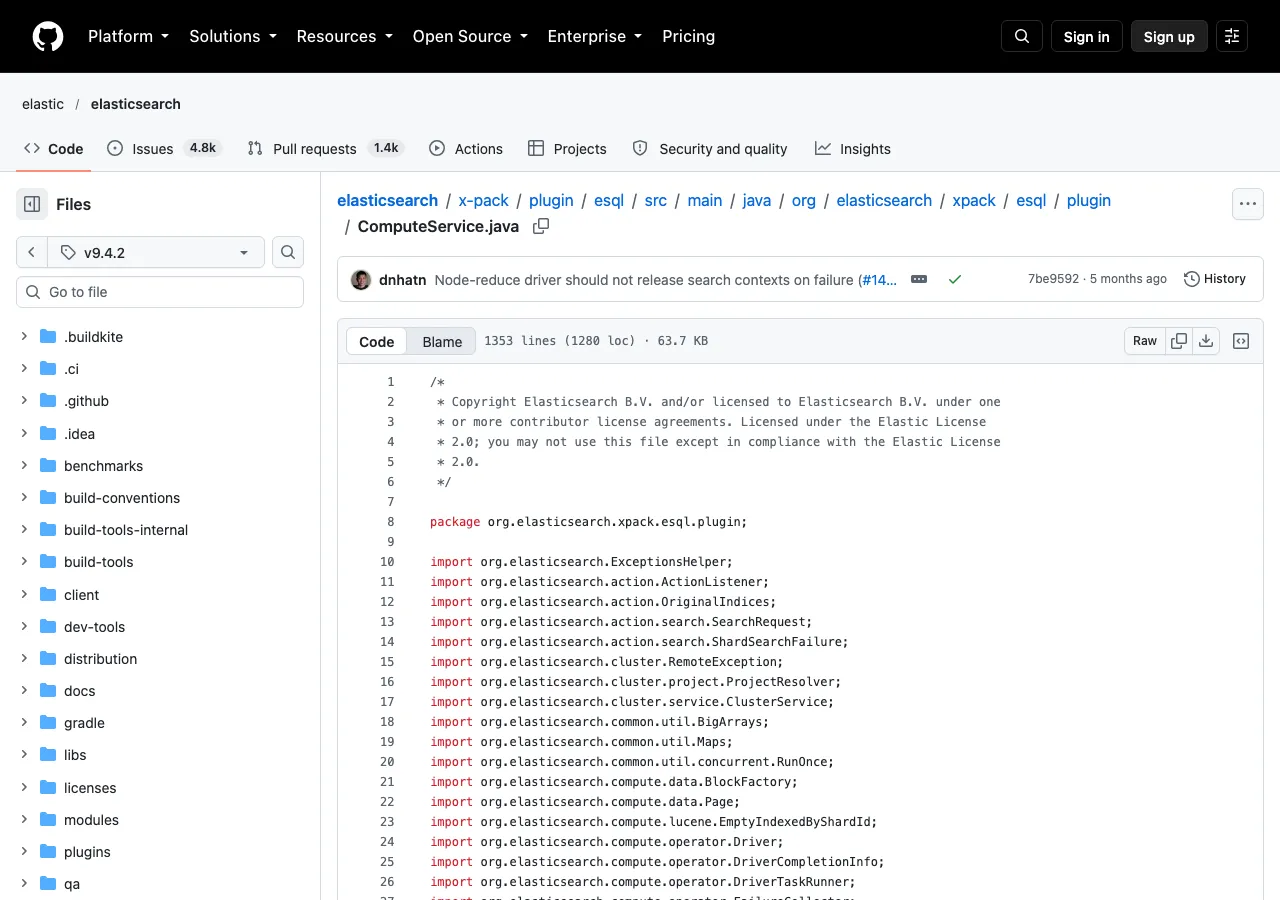
图 3:官方文件 ComputeService.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 ComputeService.java
为什么省得下来
关键在于取列是有成本的。
ES 里数据按列存(doc values),"取某一列的值"意味着读磁盘、解压、反序列化。一行有 20 个字段,取全部 20 列和只取 1 个排序列,成本差可能是一个数量级。
所以延迟物化的收益取决于一个比例:
[
\frac{\text{最终返回的行数}}{\text{参与排序的行数}}
]
这个比例越小,省得越多。 SORT ... | LIMIT 10 扫了 100 万行、只要 10 行,收益最大;如果 LIMIT 很接近总数,就没什么可省的了。
(说明:这个公式是对机制的理解,官方没给过性能数据,也未实测。)
"节点级"是什么意思
标题里有个限定词值得说清楚:Node level。
ES|QL 是分布式执行的,大致分两层:
- 数据节点:各自扫描本地分片,做本地计算,把结果发给协调节点;
- 协调节点:汇总各数据节点的结果,做最终归并。
"节点级延迟物化"发生在数据节点这一侧:每个数据节点自己做 TopN 时,就用延迟物化的方式——先只取排序键,本地排完取 Top N,再补齐这 N 行的其他列,然后才发给协调节点。
这一步优化的是节点间传输的数据量,不只是本地计算量。少取的列既不用读,也不用往网络上发。
它和数据库的"回表"是同一件事
延迟物化不是新做法,数据库领域用了很久。提这个是因为——理解它是个通用思路,比记住 ES|QL 的某个开关更有用。
最直观的对照是数据库的"回表"。二级索引里只有索引列和主键,先用索引找到符合条件的行,再拿主键回主键索引取完整行。先定位、后取数,跟这里是一样的。
再近一点的例子:分页查询的优化。不要用 OFFSET 10000 让数据库算出前 10000 行再扔掉——那和"先把所有列取出来再排序"是同一类浪费。
所以看到"延迟物化"这个词,可以立刻反应过来:它的对立面是"提前把数据备齐"。而后者在什么情况下浪费,是可以靠常识判断的——取了又没用上的,就是浪费。
源码里是怎么标的
ES|QL 有一套 capability(能力开关)机制,用于控制新特性。这条改动对应的是 EsqlCapabilities.java 第 2114–2116 行(源码 @ v9.4.2):
 * Enables late materialization on node reduce. See also QueryPragmas.NODE_LEVEL_REDUCTION
ENABLE_REDUCE_NODE_LATE_MATERIALIZATION,
注释里给了两个信息:
- 它作用于 node reduce 阶段(就是前面说的数据节点归并);
- 它和
NODE_LEVEL_REDUCTION有关联——后者是另一个开关。
所以准确的说法是:这条改动让 node reduce 这一步支持延迟物化。
执行路径上的分支
ComputeService.java 里能看到它怎么参与决策(第 1228–1238 行,源码 @ v9.4.2):
boolean runNodeLevelReduction,
boolean reduceNodeLateMaterialization,
...
if (reduceNodeLateMaterialization == false && runNodeLevelReduction == false) {

    return passThroughReduction;
}
这段代码的意思是:两个开关都关着的时候,走一条直通路径——不做任何归约优化,直接把数据往上游传。
只要有一个开着,才进入后面的归约计划构建。
提这段代码是说明一件事:它是执行计划里的一个分支,不是一个全局开关。开关状态参与的是"用哪个执行计划"的决策,而不是"要不要排序"这种语义层面的事。
这也印证了开头那句——它不改变结果,只改变怎么算。
什么时候能吃到这个优化
按理解,要满足几个条件:
- 有排序(
SORT)——没有 TopN 就谈不上"TopN 之后"; - 排序之后有截断(
LIMIT)——不截断的话全都要返回,省不了; - 返回的列不只是排序列——如果只 select 排序列,本来就不用取别的。
典型受益场景:宽表上做 SORT ... | LIMIT n,且最终返回的字段比较多。
反过来说,下面这些场景收益很小:
- 只返回排序列;
LIMIT很大,接近命中总数;- 数据量本来就小。
(这一段是根据机制推断的,官方没有给出具体的适用条件清单,不保证完整。)
对前面几条 ES|QL 优化做个归位
9.x 在 ES|QL 上做了不少执行层优化,前面写过几篇。放一起看能更清楚各自的定位:
| 篇 | 优化 | 作用阶段 |
|---|---|---|
| FORK 与 INLINE STATS | FORK / INLINE STATS |
查询语法层 |
| 节点级 TopN 后的延迟物化(本篇) | 节点级延迟物化 | 执行计划:数据节点归约 |
| doc_values skippers | doc values skippers | 存储层:过滤加速 |
| HNSW 早停默认开启 | HNSW 早停 | 向量检索层 |
层次各不相同。延迟物化属于"执行计划"这一层——它不动语法、不动存储,只改变计算步骤的顺序。
这类优化的特点是用户完全无感。你不需要改查询、不需要改 mapping、不需要配任何东西,升级之后某些查询就变快了。
无感是好事也是麻烦:好事是不用迁移;麻烦是你没法主动确认它生效了。想知道只能靠 PROFILE 看执行计划,或者对比升级前后的延迟。
这类"用户无感"的改动该怎么对待
9.x 的改动按"用户能否感知"可以分成两类,对待方式完全不同:
| 类型 | 例子 | 该怎么对待 |
|---|---|---|
| 改行为的 | _source mode 设置迁移 _source.mode 搬家、discovery-ec2 换 SDK v2 ec2 配置失效 |
要在升级前排查,因为它们会静默不生效 |
| 只改性能的 | 本篇、doc_values skippers skippers | 升级后观察即可,不用提前准备 |
判断标准很简单:这条改动会不会让"你以为的"和"实际发生的"不一致?
- 会 → 属于第一类,要在升级前动手;
- 不会,只是快慢变化 → 属于第二类,升级后看指标。
反复强调这个区分,是因为两类混在一起处理会两头不讨好:把性能优化项当 breaking 去排查,浪费时间;把静默失效项当性能优化放过去,迟早踩坑。
还有一点:第二类的风险不在"它有问题",而在你把性能变化归因错了。升级后延迟变好或变差,原因可能有很多条改动叠加——升级前后各留一次基线,比事后猜原因有用。
要不要主动验证
判断是多数团队不需要专门验证。
理由:这条改动不改变结果,只可能变快,不存在"升级后出问题"的风险。你要担心的是那些会改变行为的 breaking,不是它。
值得验证的情况只有一种:你在做性能敏感的容量规划。比如某条查询的延迟已经卡在 SLA 边缘,那就值得升级前后各测一次,看看有没有改善。
验证办法就是用 PROFILE 看执行计划里有没有对应的算子。但说实话,看延迟变化比看执行计划更直接——你关心的是快没快,不是用了哪种算法。
别为了吃优化而改查询
最后说一个看法。
知道"延迟物化对 SORT | LIMIT 有效"之后,一个自然的念头是:把查询都写成这个形式?
不建议。 理由:
- 查询应该表达你要什么,不是"怎么写更快"。执行计划优化是 ES 的事,不该由使用者操心;
- 今天有效的写法,明天可能就无效了——优化器会变,但你的查询语义不该跟着变;
- 为性能扭曲查询,会让后来读代码的人困惑。
正确的顺序是:先写对的查询,性能不够再优化。而优化的手段应该是改索引、改数据模型、或者升级版本,不是改查询的形状去迎合当前优化器的实现细节。
那什么情况下值得改查询
上面说"别为优化改查询",但不是绝对的。把边界说清楚,免得变成一句无用的口号。
值得改的情况:查询本身有语义层面的浪费。比如:
SELECT *但只用其中三列——这是真的多取了,改掉是修正而不是迎合优化器;- 先
SORT再在应用层截断——应该把LIMIT写进查询,让截断发生在服务端; - 排序键用了高基数的长字符串,而业务上按时间排序也满足需求——这是换了需求,不是换了写法。
这几种改动的共同点是:改完之后查询表达的还是同一件事,只是不再浪费。
不值得改的情况:查询已经准确表达了意图,只是为了"可能更快"去调整写法顺序、拆分或合并子句。这类改动看不到收益,还增加理解成本。
判断依据就一条:改完以后,这个查询是更好懂了,还是更难懂了? 更好懂 → 值得;更难懂 → 除非有实测收益,否则不值得。
写在最后
这条改动很小,也很典型:一个执行计划层面的优化,用户无感,只影响性能。
一,延迟物化 = 先排后取。 只用排序键排序,截断到 Top N,然后才取这 N 行的其余列。
二,收益取决于"返回行数 / 参与排序行数"。 这个比例越小省得越多。宽表 + 小 LIMIT 受益最大。
三,它在数据节点归约阶段生效,同时省下本地读取和节点间传输。
我的判断是:要不要为它调整查询写法,先看两条——表够不够宽、LIMIT 够不够小。两条都不满足时,省下的那点读取大概率看不出来。
另外诚实标注了三处未核实的:性能收益幅度(官方无数据、未实测);具体的适用条件(按机制推断,官方没给清单);这个 capability 的默认开启状态(看到有这个 capability,但未逐个确认它在 9.3 里默认是开还是关——要确认则查 EsqlCapabilities 里该枚举的 isEnabled() 实现)。
参考
- changelog 9.3.0:Late materialization after TopN (Node level)(第 39–42 行)@ v9.4.2
EsqlCapabilities.java:capability 定义与注释(第 2114–2116 行)@ v9.4.2ComputeService.java:执行计划分支判断(第 1228–1238 行)@ v9.4.2- PR 132962
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。性能收益幅度官方未提供数据、未实测;适用条件依据机制推断,官方未给清单;该 capability 的默认开启状态未逐个确认,已在正文标注。撰写时未启动集群、未运行测试。