本工具适用于社区版本为 5.x/6.x/7.x/8.x 的 elasticsearch,暂不支持其他社区版本
说明
- 本工具适用于社区版本为 5.x/6.x/7.x/8.x 的 elasticsearch,暂不支持其他社区版本
- 本工具会自动计算出最佳 max num segments 并执行 forcemerge,适用于解决集群各类索引存在大量零碎 segment 的问题
工具适用场景
- 时序日志场景,历史数据不再发生改变,一次性合并的需求
- 查询更新场景,定期合并存量数据的需求
风险
- 段合并会有一定io和cpu开销,一般建议避开业务进行
- 段合并会使索引size膨胀,一般是两倍。例如并发合并5个10G的索引,则集群在磁盘水位健康的前提下,至少需要有50g的空闲空间,否则会有磁盘超水位的风险
准备工作
- 服务器准备
准备一台可以访问到 ES 实例的服务器,其网络环境应该是互通的;
- ES 实例设置白名单
运行 MergeSegment 工具所在主机,需要对 ES 有访问权限,ES 白名单添加允许 MergeSegment 工具机访问。
执行方式
1. 下载工具并赋予执行权限
# 下载 ES_MergeSegment
wget https://bucket.example.com/elasticsearch/packages/merge_segment.zip
# 解压
unzip merge_segment.zip
# 赋予执行权限
cd merge_segment/merge_segment/linux
chmod +x merge_segment
# 查看help
./merge_segment --help
2. 参数说明
--user        default: elastic
--password    default: 默认读取环境变量 export password='***'
--ip          default: 没有默认值,必要参数,不允许为空
--port        default: 9200
--pattern     default: 索引匹配规则,默认为 '*',支持逗号分隔
--workers     default: 并发执行 forcemerge 的索引个数,默认为5
3. 执行示例
示例 1
ES 实例没有密码认证,端口为9200,且所有索引都需要进行 merge 优化,并发线程为5个
./merge_segment --ip 127.0.0.1
示例 2
直接执行,适用于测试。密码赋值和执行命令写成一条,中间无需分号
password='123456' ./merge_segment --ip 127.0.0.1 --port 9200 --user logUser --pattern 'logstash-*2023.04.18*' --workers 5
示例 3
nohup 执行,适用于脚本后台执行
export password='123456'
nohup ./merge_segment --ip 127.0.0.1 --user logUser --pattern '*2023.04.18*' --workers 5 > output.log 2>&1 &
示例 4
不安全,不推荐。这种参数传递方式可以在 ps -ef 中看到 --password 的明文密码
./merge_segment --ip 127.0.0.1 --user logUser --password '123456' --pattern 'logstash-*2023.04.18*' --workers 5
4. 运行日志输出说明
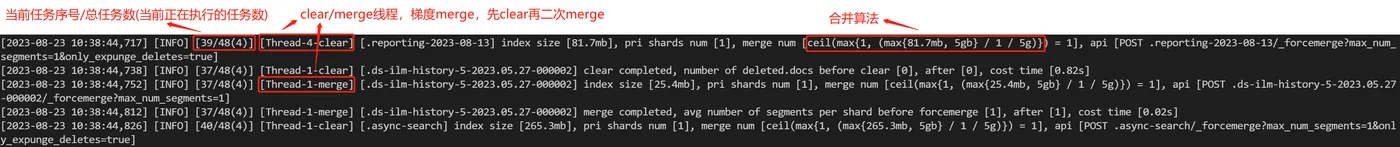
[2023-08-23 10:38:43,886] [INFO] [36/48(2)] [Thread-2-clear] [.kibana_7.14.2_001] index size [16mb], pri shards num [1], merge num [ceil(max{
   1, (max{
   16mb, 5gb} / 1 / 5g)}) = 1], api [POST .kibana_7.14.2_001/_forcemerge?max_num_segments=1&only_expunge_deletes=true]
[2023-08-23 10:38:43,906] [INFO] [32/48(4)] [Thread-1-merge] [.kibana_7.17.7_001] merge completed, avg number of segments per shard before forcemerge [1], after [1], cost time [0.03s]
[2023-08-23 10:38:43,919] [INFO] [37/48(4)] [Thread-1-clear] [.ds-ilm-history-5-2023.05.27-000002] index size [25.4mb], pri shards num [1], merge num [ceil(max{
   1, (max{
   25.4mb, 5gb} / 1 / 5g)}) = 1], api [POST .ds-ilm-history-5-2023.05.27-000002/_forcemerge?max_num_segments=1&only_expunge_deletes=true]
[2023-08-23 10:38:44,081] [INFO] [35/48(4)] [Thread-4-clear] [.kibana_7.14.2_new] clear completed, number of deleted.docs before clear [8512], after [8514], cost time [0.20s]
[2023-08-23 10:38:44,093] [INFO] [35/48(4)] [Thread-4-merge] [.kibana_7.14.2_new] index size [13.5mb], pri shards num [1], merge num [ceil(max{
   1, (max{
   13.5mb, 5gb} / 1 / 5g)}) = 1], api [POST .kibana_7.14.2_new/_forcemerge?max_num_segments=1]
输出说明:
[执行时间] [日志级别] [已经执行完成的索引数量/需要执行的索引总数量(当前集群有多少索引正在执行forcemerge)] [线程号] [索引名称] index size [索引主分片大小], pri shards num [主分片个数], merge num [max num segment计算公式], api [实际执行的API指令]
[执行时间] [日志级别] [已经执行完成的索引数量/需要执行的索引总数量(当前集群有多少索引正在执行forcemerge)] [线程号] [索引名称] merge completed, avg number of segments per shard before forcemerge [执行优化前平均每块分片的segment数量], after [优化后的segment数量], cost time [执行耗时]
常见问题
1. 执行输出日志里没有 pattern 指定的索引
解答:
为避免风险,--pattern 只支持匹配状态为 green 的索引,请检查索引状态是否为 green,亦或是 _close 状态。
2. merge 前后 segments count 为 0

解答:
索引可能处于冻结状态
索引如果处于冻结状态,其 segments.count 的值则为 0,可以通过以下API进行确认:
curl 127.0.0.1:9200/{
   index_name}/_settings?pretty | grep "frozen"
如果返回为 "frozen" : "true" 则说明索引已被冻结,可以通过以下API解冻:
POST {
   index_name}/_unfreeze
解冻成功后再次尝试执行 ES_MergeSegment
3. 索引 docs 为 0
索引如果没有数据,其 segments.count 的值则为 0,可以通过以下API进行确认:
curl 127.0.0.1:9200/{
   index_name}/_count?pretty
4. merge 后 segments count 变大

解答:
索引正在实时写入数据,期间 segments count 会存在变动,建议避开业务时间执行
5. 执行报错 Permission denied
-bash: ./merge_segment: Permission denied
解答:
需要赋予执行权限,赋权方式:
chmod +x merge_segment