
想解决的,是做笔记时的一点不方便
我平时在 Zotero 里读资料,看到值得记下来的内容就做个标注,再到 Obsidian 里整理。但是碰到扫描版 PDF 就有点不方便:页面上的字能看得见,却选不中,只能用 Zotero 框选批注的功能曲线救国。
这次拿来处理的是扫描版《爱因斯坦文集》。给测试样本做完 OCR 后,我就可以在 Zotero 中直接选中文字、做高亮了。我的目标很具体:让扫描资料也能方便地做阅读笔记。
把 OCR 放到云服务器上跑
| 组成 | 本次作用 |
|---|---|
| 阿里云 ECS | 运行 OCR 和并发实验,提供计算、内存及磁盘资源 |
| OCRmyPDF / Tesseract | 识别扫描页,为 PDF 增加文字层 |
| Python 程序 | 调度文件,记录耗时、处理状态和失败日志 |
| Zotero | 阅读处理后的 PDF,选取文字并添加批注 |
实例规格为 ecs.u2a-c1m2.xlarge,配备 4 vCPU、约 8 GB 内存,系统为 Ubuntu 24.04.5 LTS。软件版本分别为 OCRmyPDF 15.2.0+dfsg1、Tesseract 5.3.4、Ghostscript 10.02.1,识别语言使用简体中文和英文。
OCRmyPDF / Tesseract 用于“增加文字层”,就是把识别出来的文字放到原页面对应的位置。打开 PDF 时,看到的仍然是扫描图像,但现在可以选中文字,也可以搜索了。
部署和处理过程
服务器上安装 OCRmyPDF、中英文识别模型和 PDF 检查工具后,将样本与 Python 批处理程序上传到 /opt/cloud-pdf-ocr。程序编写、远程部署和实验执行由 AI 助手协助完成。
安装依赖使用的是:
sudo apt-get update
sudo apt-get install -y python3 ocrmypdf tesseract-ocr-chi-sim tesseract-ocr-eng poppler-utils
程序保留原文件,把生成的 PDF 放到新的结果目录,并记录每份文件的耗时、状态和错误日志。后面要复查某次结果时,可以找到对应的输入和参数,不用只凭终端里一闪而过的输出判断。
以单份 PDF 内部四页并发为例,在项目目录执行:
python3 batch_ocr.py input-single runs/test-single-4 --workers 1 --jobs-per-file 4
其中,--workers 1 表示同时只处理一份 PDF,--jobs-per-file 4 设置这份文件内部的页作业并发上限。每次运行需要换一个新的结果目录,避免覆盖已有记录。
并发处理能快多少?
原文件共 883 页,这次先从中抽取 20 页,分成四份 5 页 PDF,再将同样内容合成一份文件作补充测试。所有测试都在同一台阿里云 ECS 上进行,每种设置运行三次,取整批耗时的中位数。
测试保持语言、输出格式等参数一致,关闭图像优化,并固定 OMP_THREAD_LIMIT=1。计时不包含安装、上传下载、样本准备和输入哈希计算;计时前会读取文件计算哈希,因此结果不代表冷启动表现。
| 处理方式 | 耗时中位数 |
|---|---|
| 四份文件依次处理 | 42.51 秒 |
| 两份文件同时处理 | 22.16 秒 |
| 四份文件同时处理 | 15.65 秒 |
| 单份 PDF,内部逐页处理 | 41.47 秒 |
| 单份 PDF,内部四页并发 | 15.85 秒 |
四文件并发将整批耗时从 42.51 秒缩短到 15.65 秒,加速比约为 2.72,耗时减少约 63.2%;单文件内部四页并发也从 41.47 秒降到 15.85 秒,加速比约为 2.62。
两种四路并发的结果很接近,暂时不能判断谁稳定更快。之后处理整本书,我倾向于直接使用单文件内部页并发,省去拆分文件的步骤。这里的提速来自同一台服务器上的并发设置调整,不能据此判断云端比本地快多少,或某一代 CPU 比上一代快多少。
实际使用效果
处理后,可以直接选中文字并进行标注,下面是实际操作截图: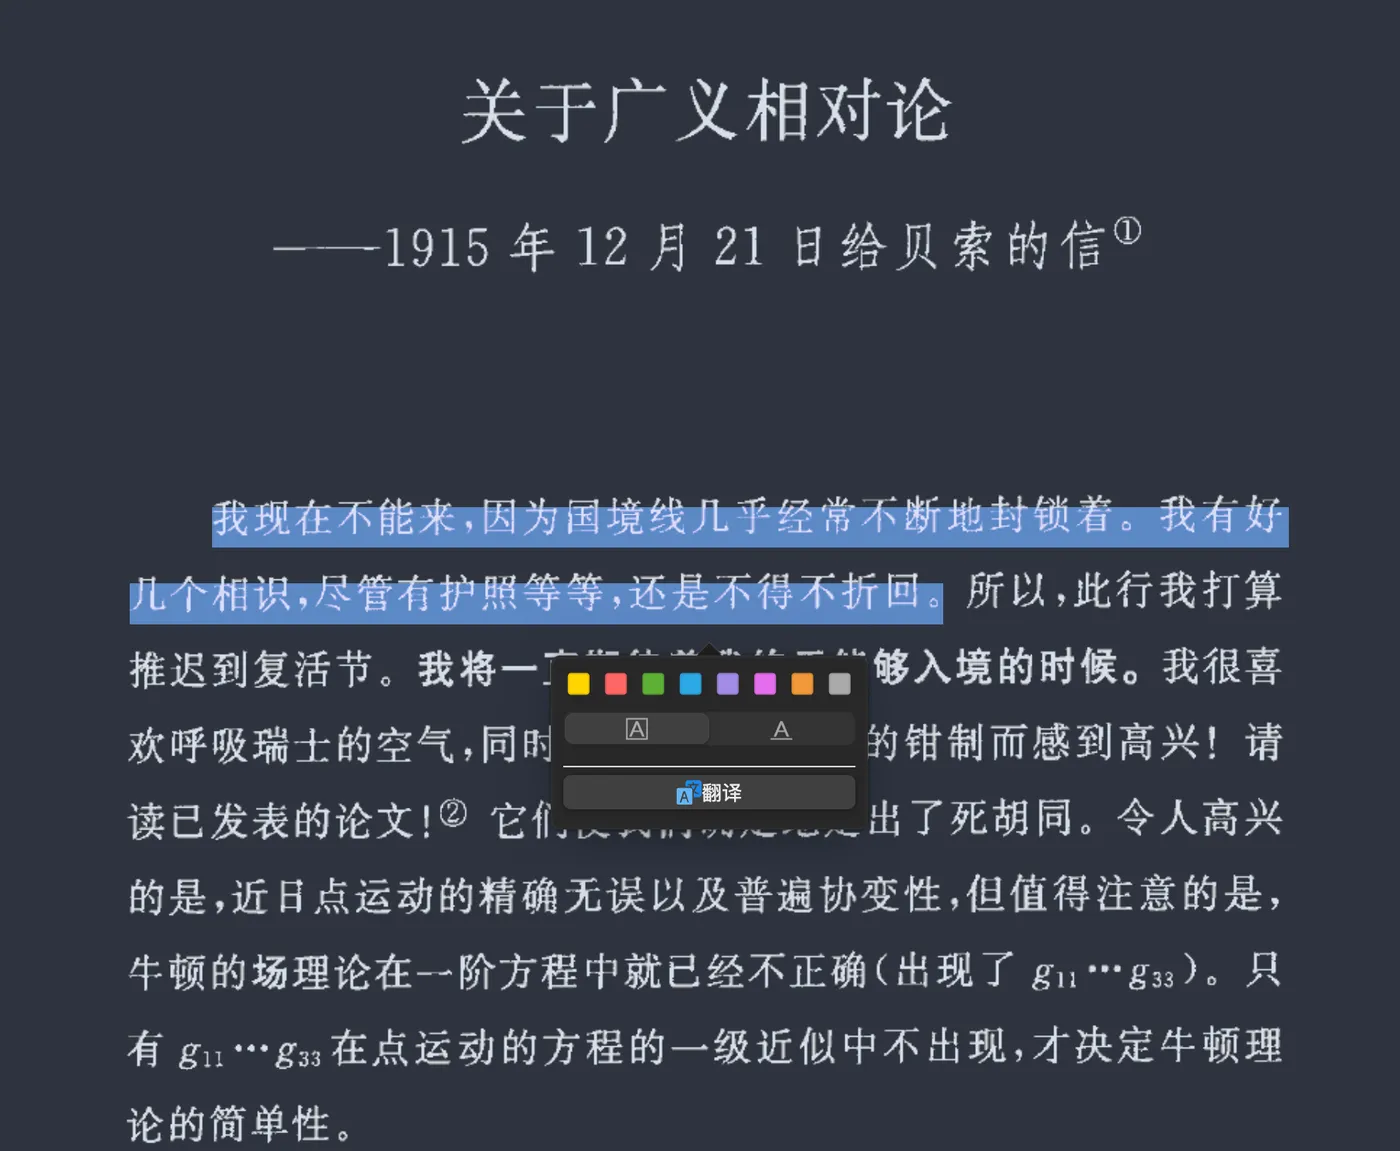
反思
两组共十五次正式测试都处理成功,每次输出的 20 页都有非空文字层。对首次输出和最终单文件四页并发输出进行逐页检查时,两批结果各自全部 20 页在最长边 800 像素的渲染条件下,都与原扫描页像素一致。
两组共十五次正式测试都处理成功,每次输出的 20 页都有非空文字层。对首次输出和最终单文件四页并发输出进行逐页检查时,两批结果各自全部 20 页在最长边 800 像素的渲染条件下,都与原扫描页像素一致。
文字识别仍有错误,比如“振动”被认成了“振功”,导出的文字里也有多余空格。但是对我来说,这些问题目前影响不大:我一般会读懂内容,再在 Obsidian 中用自己的话整理笔记,不会直接整段复制原文。


