导读:DataSet API 在 2.x 里被移除之后,「批」只剩一条路——DataStream API 的 BATCH 执行模式。但它不是「跑得慢一点的 STREAMING」:调度、数据交换、状态管理三处机制全被换掉,还带来一批行为差异和使用限制。这篇把 BATCH 模式讲透:怎么开、换掉了什么、哪些代码会悄悄变行为、哪些特性直接失效。
一、为什么是「执行模式」而不是「另一套 API」
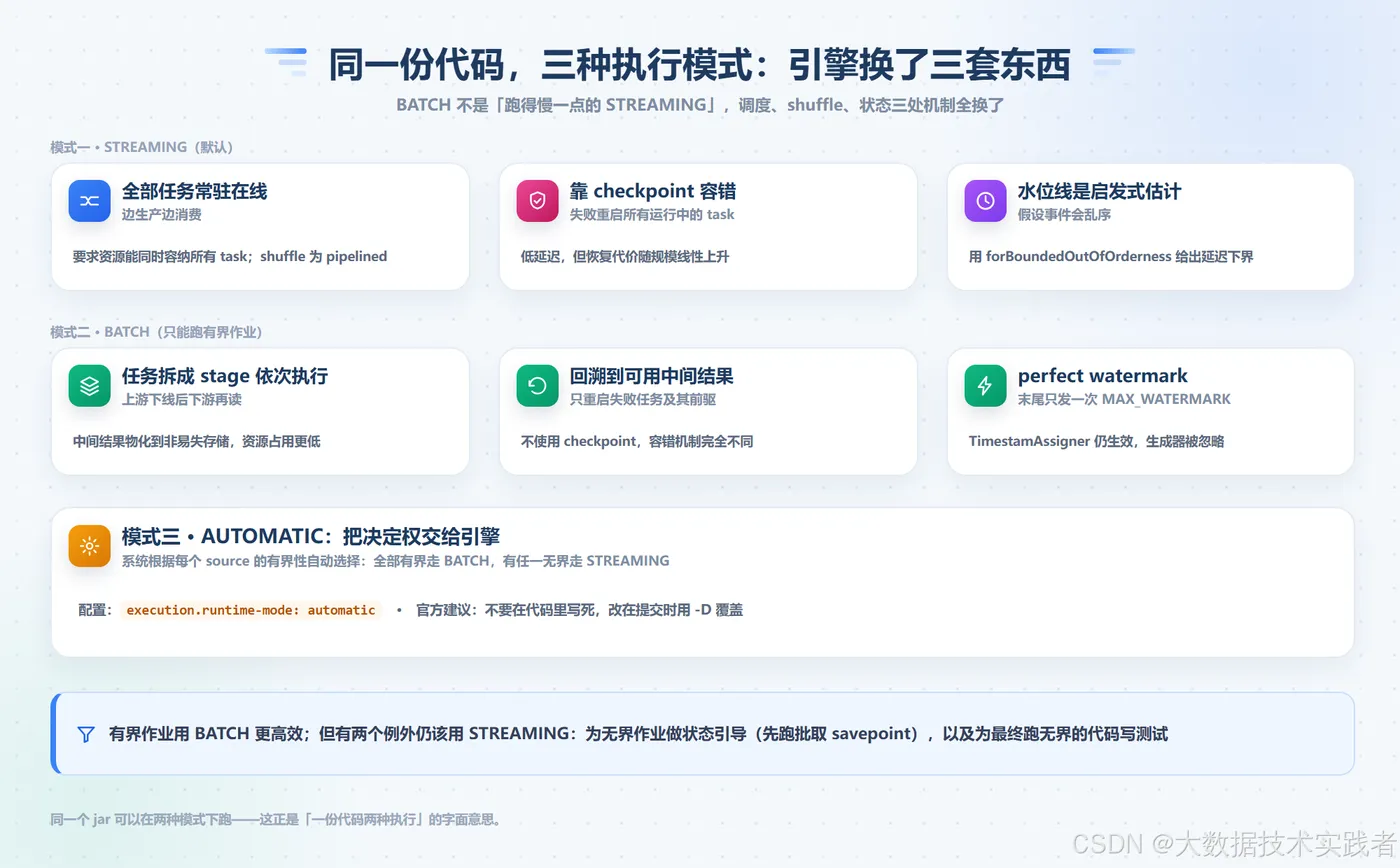
老版本 Flink 处理批数据要走 DataSet API,和 DataStream API 是两套平行的世界。2.x 里的答案是:批是一种执行模式,不是另一种 API。RuntimeExecutionMode 给出三个取值:
| 模式 | 语义 | 适用作业 |
|---|---|---|
STREAMING |
经典流执行,低延迟 | 无界作业(唯一选择),有界作业也可用 |
BATCH |
分阶段批执行,更高效 | 只能用于有界作业 |
AUTOMATIC |
系统按 source 有界性自动选择 | 有界走 BATCH,任一 source 无界则退回 STREAMING |
三种配置方式,官方明确推荐第一种——把模式留给部署时决定,代码保持配置无关:
# 推荐:提交时指定,同一份 jar 可以流批两跑
bin/flink run -Dexecution.runtime-mode=BATCH ./order-stat.jar
// 也可以写在代码里,但会失去上面这种灵活性
StreamExecutionEnvironment env =
        StreamExecutionEnvironment.getExecutionEnvironment();
env.setRuntimeMode(RuntimeExecutionMode.BATCH);
「有界」是 source 的属性:一个作业当且仅当所有 source 都有界时才是有界作业。Kafka 源通过 setBounded 声明,文件源默认有界:
KafkaSource<String> boundedKafka = KafkaSource.<String>builder()
        .setBootstrapServers("broker:9092")
        .setTopics("orders")
        .setGroupId("batch-job")
        .setStartingOffsets(OffsetsInitializer.earliest())
        .setBounded(OffsetsInitializer.latest())   // 读完最新位点即结束
        .setValueOnlyDeserializer(new SimpleStringSchema())
        .build();
二、BATCH 模式换掉了什么:三处机制级差异
同一个 DataStream 程序,切到 BATCH 模式后,底层换了三套机制。理解它们,才能理解后面的行为差异。
① 调度:从「全员常驻」到「分 stage 依次执行」。 STREAMING 要求所有 task 同时在线,资源必须装得下整个作业。BATCH 把作业按 shuffle 边界切成多个 stage,一个接一个执行——上游跑完、下线,下游再读中间结果,所以更少的 slot 就能跑更大的作业。
② 数据交换:从 pipelined 到 blocking。 流模式记录产生即发送;批模式必须把中间结果物化到非易失存储,代价是延迟,收益是故障时可回溯到仍有结果的 stage。
③ 状态:state backend 被直接忽略。 这是大多数人没预料到的一条。BATCH 模式下 keyed 操作的输入会按 key 排序,然后逐个 key 处理完所有记录再丢弃其状态——同一时刻内存里只有一个 key 的状态。TTL、RocksDB 调优这些在批模式下都无关紧要。
三、批模式下的时间:perfect watermark
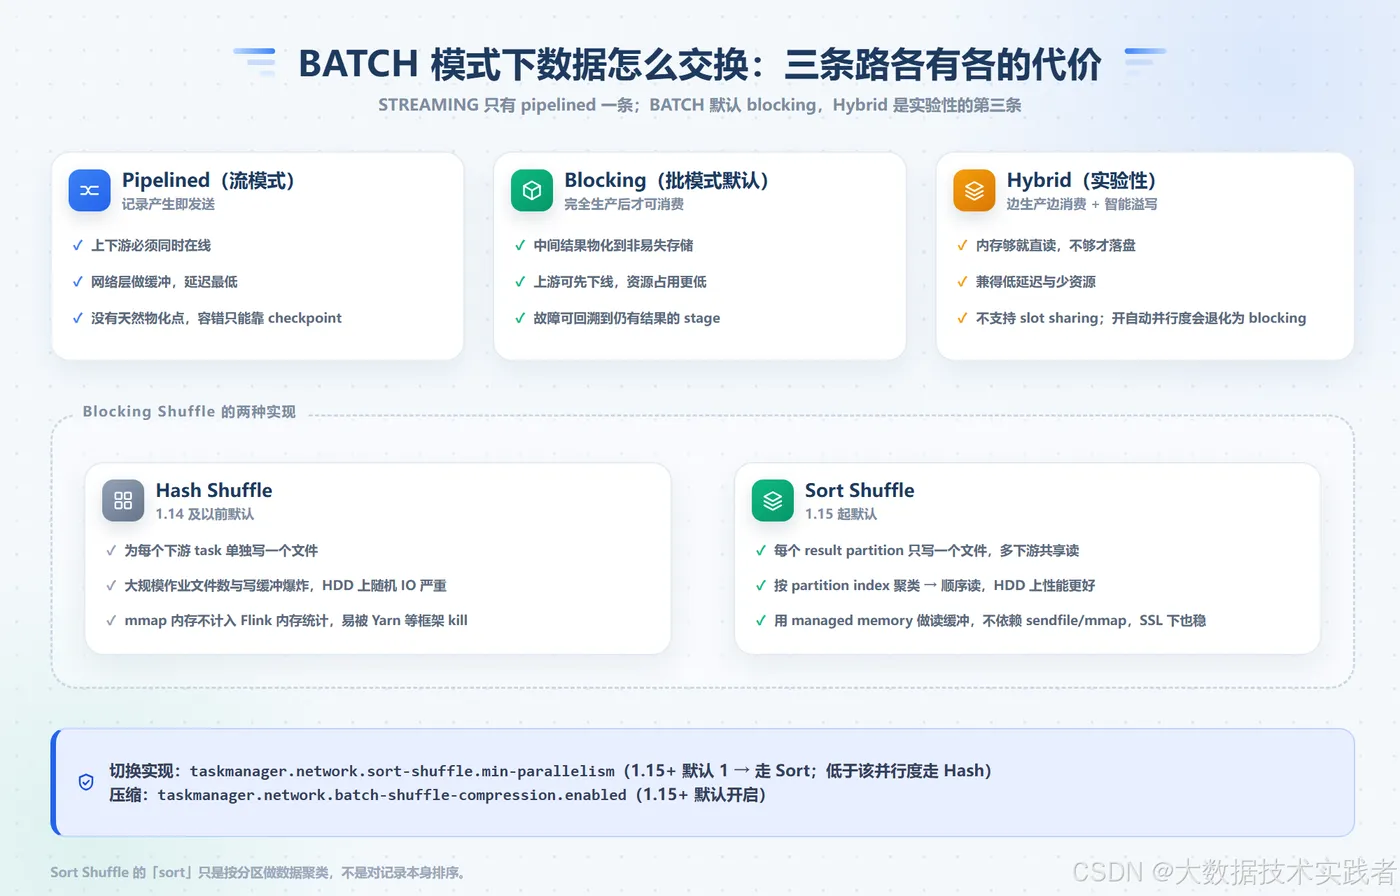
流模式的 watermark 是一种悲观启发式——系统不知道「乱序到哪算完」,只能用水位线做估计,容忍 30 秒乱序就要多等 30 秒。批模式没有这个问题:输入提前已知,元素可以按时间戳排序处理,相当于拿到了 perfect watermark。
具体行为有三条,每条都可能改变你的程序语义:
- 自定义 WatermarkGenerator 被完全忽略。
forBoundedOutOfOrderness里的乱序边界在批模式下不起任何作用。 - 只在每个 key 关联输入的末尾(非 keyed 流则在全局末尾)注入一次
MAX_WATERMARK,所有窗口在输入末尾统一关闭。 - 所有 timer 都在 end of time 触发——先按 key 顺序、再按时间戳顺序。事件时间和处理时间的 timer 一视同仁。
但 WatermarkStrategy 仍然要写:它的 TimestampAssigner 负责给记录打事件时间戳,漏了它,事件时间字段就是空的。
// 批模式下 strategy 里的乱序边界被忽略,但 timestamp assigner 必须有
WatermarkStrategy<Order> strategy = WatermarkStrategy
        .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
        .withTimestampAssigner((order, ts) -> order.getEventTime());
另一条高频踩坑:reduce、sum 这类「滚动」操作在流模式下逐条发出增量更新,在 BATCH 模式下只在最后发出一个最终结果。如果你的下游逻辑依赖「每来一条更一次」,切到批模式行为就变了。
四、批模式下失效的特性:一切依赖 checkpoint 的东西
BATCH 模式的容错不靠 checkpoint,靠回溯中间结果:故障时只重启失败任务及其前驱,而不是从快照拉起全部任务。代价是一批依赖 checkpoint 的特性直接失效:
// 这些在 BATCH 模式下都不能用:
// 1. CheckpointListener 回调
// 2. KafkaSink 的 EXACTLY_ONCE 模式(依赖 checkpoint 完成提交事务)
// 3. FileSink 的 OnCheckpointRollingPolicy
需要事务性 sink 时,必须使用 Unified Sink API(FLIP-143,即 sinkTo + Sink V2 接口),它的提交不依赖 checkpoint 机制。实践中更常见的做法是:批模式输出走幂等写(主键去重)或直接落文件,不做事务。
自定义算子还有一条隐藏规则:算子永远不绑定 key,而批模式逐 key 处理时,水位线会在 key 之间从 MAX_VALUE 直接切回 MIN_VALUE——任何「缓存上一个水位线」的假设在批模式下都是错的。
五、一个完整可跑的批作业
把上面的约束拼起来,一个 BATCH 模式作业的骨架长这样——和流作业唯一的区别是 source 有界 + 模式声明:
StreamExecutionEnvironment env =
        StreamExecutionEnvironment.getExecutionEnvironment();
env.setRuntimeMode(RuntimeExecutionMode.BATCH);

FileSource<String> source = FileSource
        .forRecordFileFormat(new CsvReaderFormat<Order>() {
   }, new Path("./orders/"))
        .build();

env.fromSource(source, WatermarkStrategy
                .<Order>forMonotonousTimestamps()
                .withTimestampAssigner((o, ts) -> o.getEventTime()), "orders")
   .keyBy(Order::getUserId)
   .window(TumblingEventTimeWindows.of(Time.days(1)))
   .aggregate(new OrderAgg())
   .sinkTo(FileSink
           .forRowFormat(new Path("./out/"), new SimpleStringEncoder<Stat>())
           .withRollingPolicy(DefaultRollingPolicy.builder().build())
           .build())
   .uid("sink-daily-stat");

env.execute("daily-stat-batch");
两点提醒:批模式下不需要配置 checkpoint 与状态后端(配了也被忽略);uid 仍然要写——虽然批作业没有 savepoint 恢复的强需求,但保持习惯统一,跨模式复用代码时少一个隐患。
六、什么时候不该用 BATCH 模式
BATCH 模式也不是万能的,两类场景要坚持 STREAMING:
- 要增量结果。大屏每秒刷新、指标逐条更新,这些语义依赖流模式的持续输出,批模式只有「一个最终结果」。
- 依赖事务性 sink。如果下游必须 exactly-once 且走 Kafka 事务,BATCH 模式下此路不通。
还有两个边界情况值得知道:为无界作业做状态引导(先用有界数据跑出初始状态取 savepoint),以及为最终跑无界的代码写测试,这两种情况即便输入有界也应保持 STREAMING 模式。
七、上线前检查清单
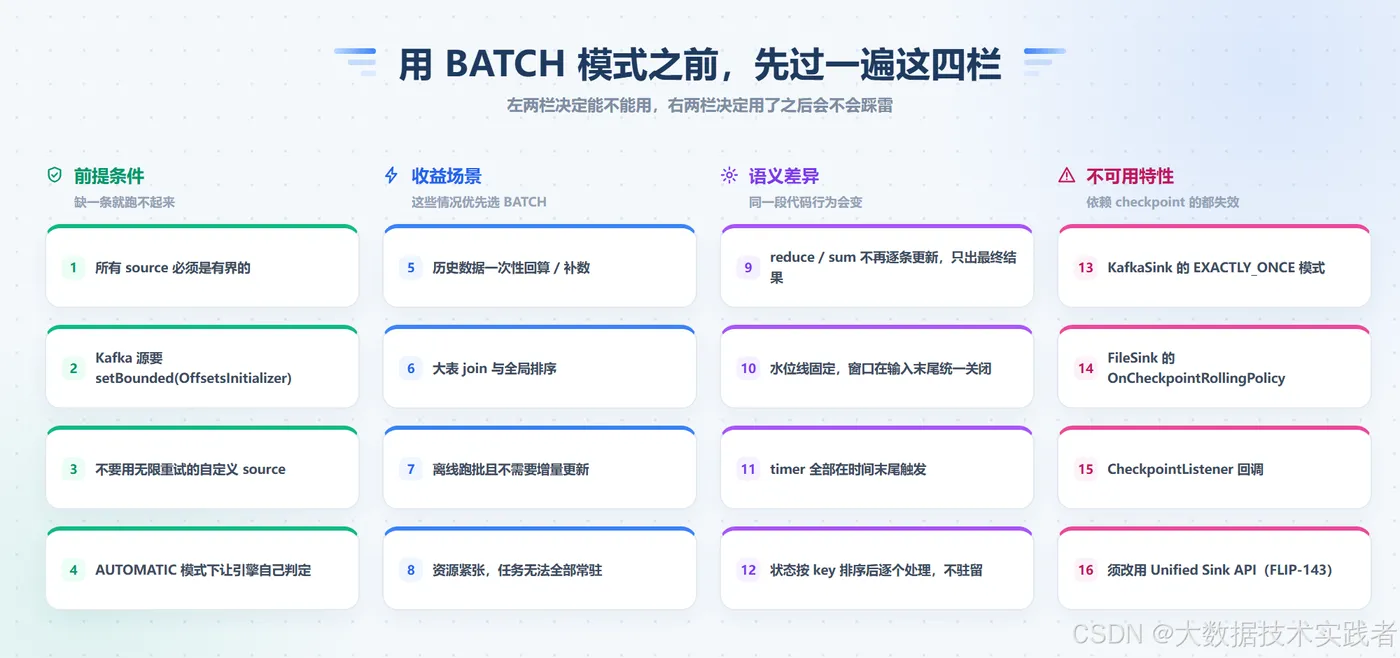
左两栏决定能不能用:所有 source 有界、资源允许分阶段执行。右两栏决定用了之后会不会踩雷:同一段代码的语义差异,以及所有依赖 checkpoint 的失效特性。变更评审时按这十六项过一遍,绝大多数批模式事故都能提前拦截。
结语
DataStream BATCH 模式是 Flink「流批一体」承诺的兑现处:同一套 API、同一份代码,模式只是部署时的一个开关。但兑现的前提是你理解引擎在开关两侧换掉的东西——调度从常驻变成分阶段,交换从 pipelined 变成 blocking,状态从驻留变成排序后逐个处理,时间从启发式变成 perfect watermark。