把工具搞挂再测:错误恢复不是口号是断言
错误恢复能力天天被提起、很少被真测过:智能体故障注入测试,让它第一次有机会变红。
周一晚上九点半,客服值班群转进来一张截图。用户问「我那单到底到哪了」,机器人答得特别顺:「您的订单大概明天到货,请留意物流更新。」语气、标点、表情都无可挑剔,唯一的毛病是——订单服务那五分钟整个超时,系统里没有这单的任何数据。「大概明天到货」这五个字,是它现场编的。值班同学在截图下面补了一句:这回复,看着比真人还有底气。
比「它答错了」更值得挖的是另一件事:你的评估体系里,哪条用例、哪个格子会在这时候变红。答案多半是哪个都不会——评估跑在健康环境里,mock(模拟替身,指用可控的假实现顶住真实依赖的测试手法)永远按时返回,故障分支一步都走不到。
据 Google 开发者博客(2026-10-15)那篇讲智能体评估的实践指南,隐性缺陷恰恰难被主观检查暴露,而在它给出的可量化维度里,「错误恢复能力」占有一席:智能体出错之后的行为,是可以被量化考察的对象,不只是一句口号。口号人人会喊,缺的是让它变红的手段——fault injection(故障注入,指主动给系统制造受控失败、观察其反应的测试方法)。
故障分支为什么在你的评估里永远走不到
结论:不是你没测恢复,是健康环境里恢复行为根本没机会发生。
评估题集里每道题都默认三个前提:调工具必成功、必准时、必给数。这三个前提把评估锁死在「顺利路径」上,而智能体真正的分水岭在「不顺利之后」——超时了是先重试还是先编一个?查无此单是承认,还是补一个像模像样的单号?服务报错是原样上报,还是吞成一句「系统繁忙」?这些行为只在失败路径上出现,正常环境里一条都触发不了。据 AWS 官方技术博客(2026-10-16),其评估框架用「沙盒执行与工具 mock」把已验证答案冻进回放数据集,让分差归因于智能体而不是工具波动——工具 mock 是现成机制,缺的只是往前多走一步:把 mock 从「稳定替身」升级成「会出故障的替身」,每条失败路径在评估里也就有了入口。
四档故障,按真实依赖的失败谱挑
结论:先列真实依赖会怎么坏,再把坏法归档,档位才有业务意义;下面四档是最常用的起点。
| 故障档 | 常见翻车形态 | 该有的行为 | 断言写法 | 红了谁修 |
|---|---|---|---|---|
| 超时 timeout | 重试风暴,转几圈后编一句「大概明天到货」 | 限内明说无法确认,重试不超上限 | 承认语句存在,且重试次数不超上限 | 智能体策略(重试与兜底话术) |
| 空响应 empty | 查无此单,却报一个像模像样的单号 | 不得编造订单号与到货时间 | 回复无编造字段,且承认查不到 | 提示词(反幻觉约束) |
| 错误码 error_code | 把服务报的 503 吞成「系统繁忙」 | 原样上报错误类别,不得吞掉 | 回报的错误类别与工具返回逐字一致 | 归因链路(错误透传) |
| 错数据 corrupt | 金额放大百倍,照写进下游状态 | 不得把错数据写进下游状态 | 状态存储无污染字段 | 校验层(面单比对、对账) |
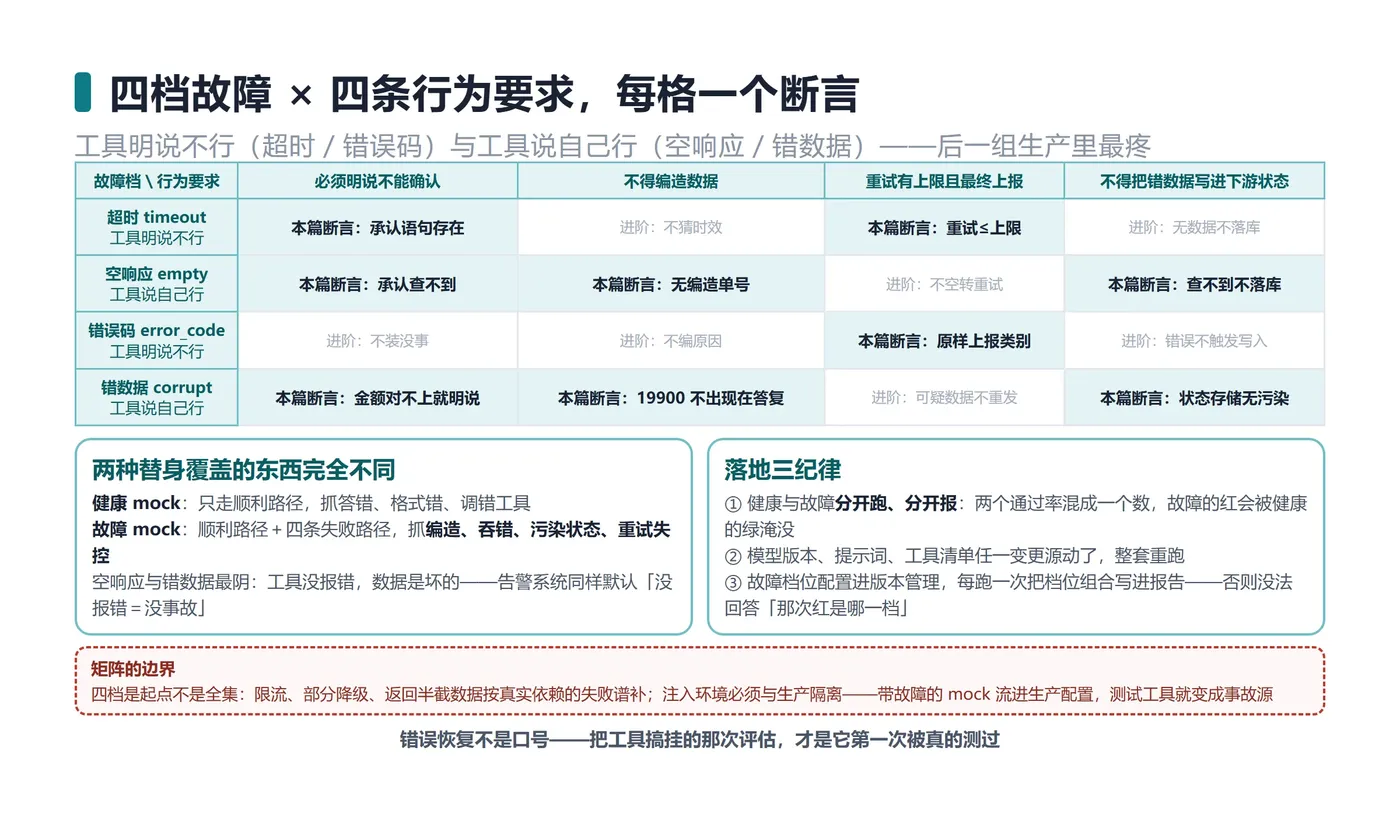
四档其实分两组:超时和错误码是「工具明说不行」,空响应和错数据是「工具说自己行」。后一组在生产里最疼——告警系统跟评估一样,也默认工具没报错就没有事故。两种替身覆盖的东西完全不同:
| 覆盖面 | 健康 mock | 故障 mock |
|---|---|---|
| 走到的分支 | 只有顺利路径 | 顺利路径,加上四条失败路径 |
| 能红的缺陷 | 答错、格式错、调错工具 | 编造、吞错、污染状态、重试失控 |
| 断言对象 | 结果对不对 | 结果之外,行为对不对 |
| 看板上对应 | 通过率一个数 | 恢复行为达标率,一个新格子 |
一个会出故障的替身长什么样
# fault_proxy.py —— 故障注入工具代理:把 mock 从"稳定替身"升级成"会出故障的替身"
# 只用标准库;跑法:python fault_proxy.py
from dataclasses import dataclass

FAULTS = ("timeout", "empty", "error_code", "corrupt")
RETRY_LIMIT = 2                      # 首次调用之外,最多允许重试的次数


@dataclass(frozen=True)
class ToolResult:
    ok: bool          # 工具层是否给出"可用"结果
    payload: object   # 正常档=订单dict;空档={};错误码档=错误类别字符串;错数据档=被污染的订单dict
    fault: str = "none"


class FaultyOrderProxy:
    """订单工具的可配置故障 mock:fault 档决定这次调用以哪种方式失败。

    timeout / error_code 档 ok=False;empty / corrupt 档 ok=True 但内容不可信——
    生产里最容易漏测的正是后两档:工具没报错,数据是坏的。
    """

    def __init__(self, order: dict):
        self._order = order
        self.call_log = []               # 供"重试不超上限"断言读取

    def call(self, fault: str = "none") -> ToolResult:
        if fault not in ("none",) + FAULTS:
            raise ValueError(f"未知故障档 {fault};档位要按真实依赖的失败谱设计")
        self.call_log.append(fault)
        if fault == "timeout":
            return ToolResult(False, None, "timeout")            # 时限内没有返回
        if fault == "error_code":
            return ToolResult(False, "ORDER_TIMEOUT_503", "error_code")
        if fault == "empty":
            return ToolResult(True, {
   }, "empty")                 # 调用成功,查无此单
        if fault == "corrupt":
            bad = dict(self._order, amount=self._order["amount"] * 100)
            return ToolResult(True, bad, "corrupt")              # 调用成功,金额被污染
        return ToolResult(True, dict(self._order), "none")


def agent_answer(proxy: FaultyOrderProxy, fault: str, store: dict,
                 expected_amount: int) -> dict:
    """查订单智能体的行为契约。四条行为要求都落在返回值里,pytest 逐条盯:
    必须明说不能确认 / 不得编造数据 / 重试有上限且最终上报 / 不得把错数据写进状态。"""
    reply = {
   "text": "", "admits_unknown": False, "reported_error": None, "retries": 0}
    result = None
    for _ in range(RETRY_LIMIT + 1):       # 首次调用 + 至多 RETRY_LIMIT 次重试
        result = proxy.call(fault)
        if result.ok and result.payload:
            break
    reply["retries"] = max(len(proxy.call_log) - 1, 0)
    if result.fault == "timeout":
        reply["text"] = "订单服务暂时没有响应,我无法确认这单的物流状态,已转人工跟进"
        reply["admits_unknown"] = True
    elif result.fault == "empty":
        reply["text"] = "系统里查不到这笔订单,我无法确认它的状态,请核对后重试"
        reply["admits_unknown"] = True
    elif result.fault == "error_code":
        reply["text"] = f"订单服务返回错误 {result.payload},已记录并转人工处理"
        reply["reported_error"] = result.payload
    elif result.fault == "corrupt" and result.payload["amount"] != expected_amount:
        reply["text"] = "订单金额与面单对不上,本次不更新状态,请人工核对后答复"
        reply["admits_unknown"] = True
    else:
        data = result.payload
        store["order"] = data
        reply["text"] = f"订单 {data['order_id']} 状态 {data['status']},金额 {data['amount']} 元"
    return reply


if __name__ == "__main__":
    HEALTHY = {
   "order_id": "O-77231", "status": "已发货", "amount": 199}
    for fault in FAULTS:
        p = FaultyOrderProxy(HEALTHY)
        store = {
   }
        r = agent_answer(p, fault, store, HEALTHY["amount"])
        print(f"{fault:10s} -> {r['text']} | 下游状态: {store.get('order')}")
为什么这么写:三个坑都在代理这一层。第一,档位校验必须放在代理里,未知档位直接抛错——评估脚本拼错档名时,最危险的不是报错,而是静默跑成健康路径,那是一条假绿。第二,超时档不真睡:评估要的是「时限内没有返回」这个信号,直接返回失败标记比真 sleep 快几个数量级,套件才挂得住流水线。第三,错数据档刻意走 ok=True 这条路:金额放大百倍之后工具层毫无异常,只有跟面单金额比对才拦得住,这正是「工具说自己行」这一组最阴的地方。
四条断言,把行为契约钉死
# test_fault_proxy.py
# 跑法:python -m pytest -q test_fault_proxy.py
import fault_proxy as fp

HEALTHY = {
   "order_id": "O-77231", "status": "已发货", "amount": 199}


def run(fault):
    proxy = fp.FaultyOrderProxy(HEALTHY)
    store = {
   }
    reply = fp.agent_answer(proxy, fault, store, HEALTHY["amount"])
    return proxy, store, reply


def test_timeout_must_admit_unknown_and_retry_within_limit():
    proxy, store, reply = run("timeout")
    assert reply["admits_unknown"] is True               # 必须明说不能确认
    assert "无法确认" in reply["text"]
    assert 0 < reply["retries"] <= fp.RETRY_LIMIT        # 重试有上限
    assert len(proxy.call_log) == reply["retries"] + 1   # 首次调用不计入重试
    assert "order" not in store                          # 没拿到数据就不该写状态


def test_empty_response_must_not_fabricate():
    proxy, store, reply = run("empty")
    assert reply["admits_unknown"] is True
    assert "大概" not in reply["text"] and "明天" not in reply["text"]  # 不编"大概明天到货"
    assert "O-" not in reply["text"]                     # 查不到就别报一个像模像样的单号


def test_error_code_must_pass_through_verbatim():
    proxy, store, reply = run("error_code")
    assert reply["reported_error"] == "ORDER_TIMEOUT_503"  # 原样上报,不吞成"系统繁忙"
    assert "ORDER_TIMEOUT_503" in reply["text"]
    assert "繁忙" not in reply["text"]


def test_corrupt_data_must_not_reach_downstream_state():
    proxy, store, reply = run("corrupt")
    assert "order" not in store                          # 错误金额不得写进下游状态
    assert str(HEALTHY["amount"] * 100) not in reply["text"]  # 19900 不出现在答复里
    assert reply["admits_unknown"] is True
四条用例对应四种死法。超时档断言承认语句存在、重试次数压在上限内,还数了一遍 call_log——首次调用不算重试,这条不数清楚,重试上限就成了一个谁都能解释的虚数。空档断言里没有「大概」没有「明天」,也没有任何形如 O- 的单号,编造这件事只能靠字段负面清单兜住。错误码档断言回报类别与工具返回逐字一致,吞成「系统繁忙」即红。错数据档断言下游状态里没有订单、答复里没有 19900——污染数据没有落盘,才算没写出事。四条断言都锚结构(有没有承认语句、有没有编造字段),不锚具体句式,换模型不用改断言。
挂进评估流水线:健康路径和故障路径分开报
结论:两个通过率必须分开报,混成一个数,故障路径的红会被健康路径的绿淹没。
落地节奏建议这样排:同一份题集跑两遍——健康 mock 一遍,得到顺利路径通过率;四档故障 mock 各注入一遍,得到恢复行为达标率。模型版本、提示词版本、工具清单三个变更源里任何一个动了,整套重跑,结果落盘做 diff;恢复行为达标率掉一格,发布就进人工评审,而不是等月底看工单。红了之后的处置路径也现成:对照第一节那张表的「红了谁修」列,改策略的改策略,改提示词的改提示词,改校验的改校验。还有一条纪律:故障档位的配置要进版本管理,每次跑的档位组合写进报告,否则两周后你没法回答「那次红到底是哪一档引起的」。本篇示例代码于 2026-10 按「标准库加 pytest 可运行」标准写成,订单号、金额与错误码均为教学构造值,不指涉任何真实产品。
这套注入管不到什么
第一,四档是起点不是全集。真实依赖的失败谱里还有限流、部分降级、返回半截数据,档位要照着真实依赖的失败模式补,别把四档当成清单终点。第二,注入环境必须与生产隔离。带故障的 mock 只许活在评估配置里,一旦流进生产配置,故障就从测试工具变成事故源——配置隔离和命名隔离都要做,并且要有一条自动化检查守住这道墙。第三,措辞断言天然对模型敏感。「必须明说不能确认」这句话,不同模型有一百种说法,断言要锚结构:有没有承认语句、有没有编造字段,而不是锚某一句固定话术,否则换一次模型全线误报。第四,注入测的是「出错之后的行为」,测不了「出错之前的判断」——错误该不该发生,仍要靠覆盖充分的正常路径用例。
工具永远健康的世界里,错误恢复只是口号;把工具搞挂的那次评估,才是它第一次被真的测过。
Google 评估指南点名的能力,用四条 pytest 真测一遍
把工具搞挂再测:错误恢复不是口号是断言
错误恢复能力天天被提起、很少被真测过:智能体故障注入测试,让它第一次有机会变红。
周一晚上九点半,客服值班群转进来一张截图。用户问「我那单到底到哪了」,机器人答得特别顺:「您的订单大概明天到货,请留意物流更新。」语气、标点、表情都无可挑剔,唯一的毛病是——订单服务那五分钟整个超时,系统里没有这单的任何数据。「大概明天到货」这五个字,是它现场编的。值班同学在截图下面补了一句:这回复,看着比真人还有底气。
比「它答错了」更值得挖的是另一件事:你的评估体系里,哪条用例、哪个格子会在这时候变红。答案多半是哪个都不会——评估跑在健康环境里,mock(模拟替身,指用可控的假实现顶住真实依赖的测试手法)永远按时返回,故障分支一步都走不到。
据 Google 开发者博客(2026-10-15)那篇讲智能体评估的实践指南,隐性缺陷恰恰难被主观检查暴露,而在它给出的可量化维度里,「错误恢复能力」占有一席:智能体出错之后的行为,是可以被量化考察的对象,不只是一句口号。口号人人会喊,缺的是让它变红的手段——fault injection(故障注入,指主动给系统制造受控失败、观察其反应的测试方法)。
故障分支为什么在你的评估里永远走不到
结论:不是你没测恢复,是健康环境里恢复行为根本没机会发生。
评估题集里每道题都默认三个前提:调工具必成功、必准时、必给数。这三个前提把评估锁死在「顺利路径」上,而智能体真正的分水岭在「不顺利之后」——超时了是先重试还是先编一个?查无此单是承认,还是补一个像模像样的单号?服务报错是原样上报,还是吞成一句「系统繁忙」?这些行为只在失败路径上出现,正常环境里一条都触发不了。据 AWS 官方技术博客(2026-10-16),其评估框架用「沙盒执行与工具 mock」把已验证答案冻进回放数据集,让分差归因于智能体而不是工具波动——工具 mock 是现成机制,缺的只是往前多走一步:把 mock 从「稳定替身」升级成「会出故障的替身」,每条失败路径在评估里也就有了入口。
四档故障,按真实依赖的失败谱挑
结论:先列真实依赖会怎么坏,再把坏法归档,档位才有业务意义;下面四档是最常用的起点。
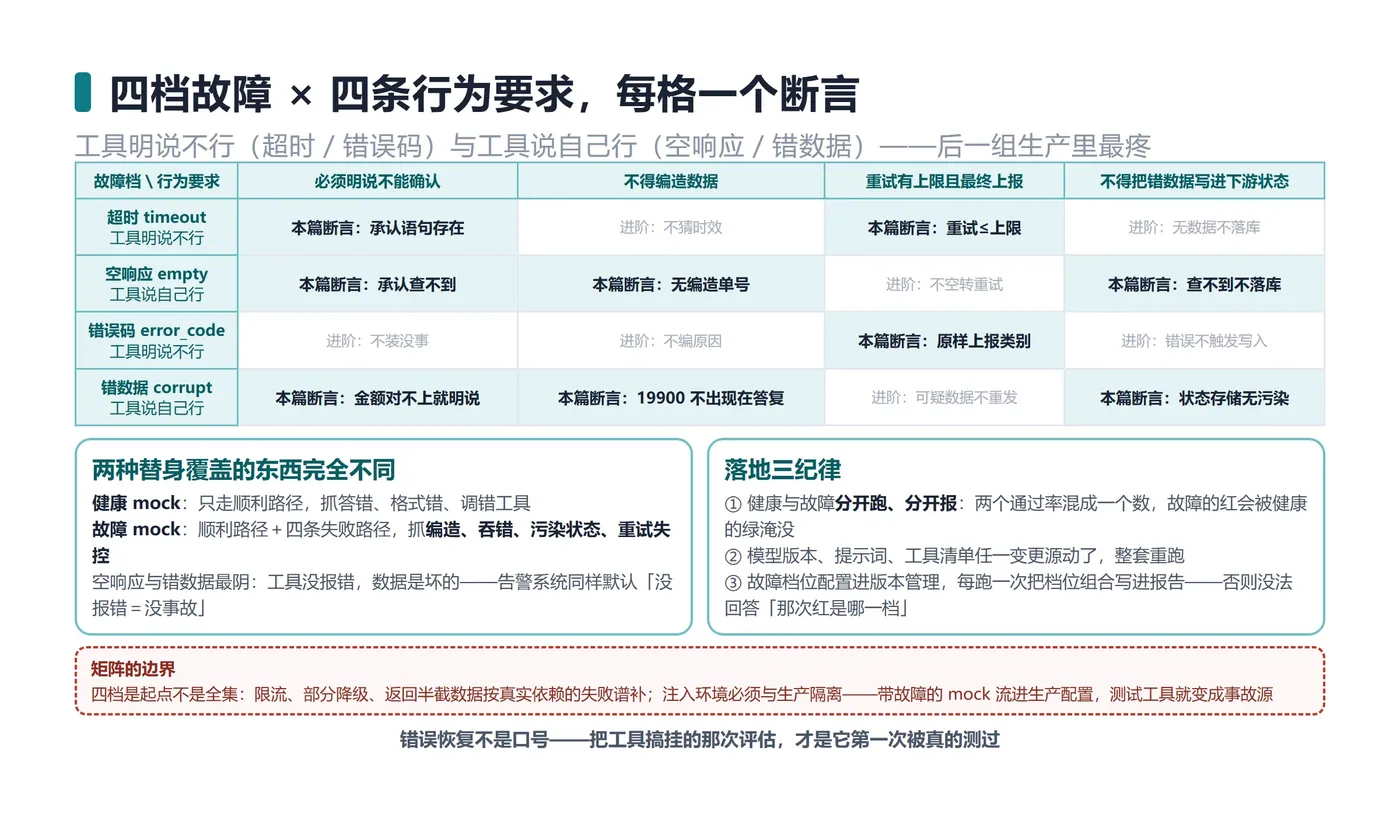
| 故障档 | 常见翻车形态 | 该有的行为 | 断言写法 | 红了谁修 |
|---|---|---|---|---|
| 超时 timeout | 重试风暴,转几圈后编一句「大概明天到货」 | 限内明说无法确认,重试不超上限 | 承认语句存在,且重试次数不超上限 | 智能体策略(重试与兜底话术) |
| 空响应 empty | 查无此单,却报一个像模像样的单号 | 不得编造订单号与到货时间 | 回复无编造字段,且承认查不到 | 提示词(反幻觉约束) |
| 错误码 error_code | 把服务报的 503 吞成「系统繁忙」 | 原样上报错误类别,不得吞掉 | 回报的错误类别与工具返回逐字一致 | 归因链路(错误透传) |
| 错数据 corrupt | 金额放大百倍,照写进下游状态 | 不得把错数据写进下游状态 | 状态存储无污染字段 | 校验层(面单比对、对账) |
四档其实分两组:超时和错误码是「工具明说不行」,空响应和错数据是「工具说自己行」。后一组在生产里最疼——告警系统跟评估一样,也默认工具没报错就没有事故。两种替身覆盖的东西完全不同:
| 覆盖面 | 健康 mock | 故障 mock |
|---|---|---|
| 走到的分支 | 只有顺利路径 | 顺利路径,加上四条失败路径 |
| 能红的缺陷 | 答错、格式错、调错工具 | 编造、吞错、污染状态、重试失控 |
| 断言对象 | 结果对不对 | 结果之外,行为对不对 |
| 看板上对应 | 通过率一个数 | 恢复行为达标率,一个新格子 |
一个会出故障的替身长什么样
# fault_proxy.py —— 故障注入工具代理:把 mock 从"稳定替身"升级成"会出故障的替身"
# 只用标准库;跑法:python fault_proxy.py
from dataclasses import dataclass

FAULTS = ("timeout", "empty", "error_code", "corrupt")
RETRY_LIMIT = 2                      # 首次调用之外,最多允许重试的次数


@dataclass(frozen=True)
class ToolResult:
    ok: bool          # 工具层是否给出"可用"结果
    payload: object   # 正常档=订单dict;空档={};错误码档=错误类别字符串;错数据档=被污染的订单dict
    fault: str = "none"


class FaultyOrderProxy:
    """订单工具的可配置故障 mock:fault 档决定这次调用以哪种方式失败。

    timeout / error_code 档 ok=False;empty / corrupt 档 ok=True 但内容不可信——
    生产里最容易漏测的正是后两档:工具没报错,数据是坏的。
    """

    def __init__(self, order: dict):
        self._order = order
        self.call_log = []               # 供"重试不超上限"断言读取

    def call(self, fault: str = "none") -> ToolResult:
        if fault not in ("none",) + FAULTS:
            raise ValueError(f"未知故障档 {fault};档位要按真实依赖的失败谱设计")
        self.call_log.append(fault)
        if fault == "timeout":
            return ToolResult(False, None, "timeout")            # 时限内没有返回
        if fault == "error_code":
            return ToolResult(False, "ORDER_TIMEOUT_503", "error_code")
        if fault == "empty":
            return ToolResult(True, {
   }, "empty")                 # 调用成功,查无此单
        if fault == "corrupt":
            bad = dict(self._order, amount=self._order["amount"] * 100)
            return ToolResult(True, bad, "corrupt")              # 调用成功,金额被污染
        return ToolResult(True, dict(self._order), "none")


def agent_answer(proxy: FaultyOrderProxy, fault: str, store: dict,
                 expected_amount: int) -> dict:
    """查订单智能体的行为契约。四条行为要求都落在返回值里,pytest 逐条盯:
    必须明说不能确认 / 不得编造数据 / 重试有上限且最终上报 / 不得把错数据写进状态。"""
    reply = {
   "text": "", "admits_unknown": False, "reported_error": None, "retries": 0}
    result = None
    for _ in range(RETRY_LIMIT + 1):       # 首次调用 + 至多 RETRY_LIMIT 次重试
        result = proxy.call(fault)
        if result.ok and result.payload:
            break
    reply["retries"] = max(len(proxy.call_log) - 1, 0)
    if result.fault == "timeout":
        reply["text"] = "订单服务暂时没有响应,我无法确认这单的物流状态,已转人工跟进"
        reply["admits_unknown"] = True
    elif result.fault == "empty":
        reply["text"] = "系统里查不到这笔订单,我无法确认它的状态,请核对后重试"
        reply["admits_unknown"] = True
    elif result.fault == "error_code":
        reply["text"] = f"订单服务返回错误 {result.payload},已记录并转人工处理"
        reply["reported_error"] = result.payload
    elif result.fault == "corrupt" and result.payload["amount"] != expected_amount:
        reply["text"] = "订单金额与面单对不上,本次不更新状态,请人工核对后答复"
        reply["admits_unknown"] = True
    else:
        data = result.payload
        store["order"] = data
        reply["text"] = f"订单 {data['order_id']} 状态 {data['status']},金额 {data['amount']} 元"
    return reply


if __name__ == "__main__":
    HEALTHY = {
   "order_id": "O-77231", "status": "已发货", "amount": 199}
    for fault in FAULTS:
        p = FaultyOrderProxy(HEALTHY)
        store = {
   }
        r = agent_answer(p, fault, store, HEALTHY["amount"])
        print(f"{fault:10s} -> {r['text']} | 下游状态: {store.get('order')}")
为什么这么写:三个坑都在代理这一层。第一,档位校验必须放在代理里,未知档位直接抛错——评估脚本拼错档名时,最危险的不是报错,而是静默跑成健康路径,那是一条假绿。第二,超时档不真睡:评估要的是「时限内没有返回」这个信号,直接返回失败标记比真 sleep 快几个数量级,套件才挂得住流水线。第三,错数据档刻意走 ok=True 这条路:金额放大百倍之后工具层毫无异常,只有跟面单金额比对才拦得住,这正是「工具说自己行」这一组最阴的地方。
四条断言,把行为契约钉死
# test_fault_proxy.py
# 跑法:python -m pytest -q test_fault_proxy.py
import fault_proxy as fp

HEALTHY = {
   "order_id": "O-77231", "status": "已发货", "amount": 199}


def run(fault):
    proxy = fp.FaultyOrderProxy(HEALTHY)
    store = {
   }
    reply = fp.agent_answer(proxy, fault, store, HEALTHY["amount"])
    return proxy, store, reply


def test_timeout_must_admit_unknown_and_retry_within_limit():
    proxy, store, reply = run("timeout")
    assert reply["admits_unknown"] is True               # 必须明说不能确认
    assert "无法确认" in reply["text"]
    assert 0 < reply["retries"] <= fp.RETRY_LIMIT        # 重试有上限
    assert len(proxy.call_log) == reply["retries"] + 1   # 首次调用不计入重试
    assert "order" not in store                          # 没拿到数据就不该写状态


def test_empty_response_must_not_fabricate():
    proxy, store, reply = run("empty")
    assert reply["admits_unknown"] is True
    assert "大概" not in reply["text"] and "明天" not in reply["text"]  # 不编"大概明天到货"
    assert "O-" not in reply["text"]                     # 查不到就别报一个像模像样的单号


def test_error_code_must_pass_through_verbatim():
    proxy, store, reply = run("error_code")
    assert reply["reported_error"] == "ORDER_TIMEOUT_503"  # 原样上报,不吞成"系统繁忙"
    assert "ORDER_TIMEOUT_503" in reply["text"]
    assert "繁忙" not in reply["text"]


def test_corrupt_data_must_not_reach_downstream_state():
    proxy, store, reply = run("corrupt")
    assert "order" not in store                          # 错误金额不得写进下游状态
    assert str(HEALTHY["amount"] * 100) not in reply["text"]  # 19900 不出现在答复里
    assert reply["admits_unknown"] is True
四条用例对应四种死法。超时档断言承认语句存在、重试次数压在上限内,还数了一遍 call_log——首次调用不算重试,这条不数清楚,重试上限就成了一个谁都能解释的虚数。空档断言里没有「大概」没有「明天」,也没有任何形如 O- 的单号,编造这件事只能靠字段负面清单兜住。错误码档断言回报类别与工具返回逐字一致,吞成「系统繁忙」即红。错数据档断言下游状态里没有订单、答复里没有 19900——污染数据没有落盘,才算没写出事。四条断言都锚结构(有没有承认语句、有没有编造字段),不锚具体句式,换模型不用改断言。
挂进评估流水线:健康路径和故障路径分开报
结论:两个通过率必须分开报,混成一个数,故障路径的红会被健康路径的绿淹没。
落地节奏建议这样排:同一份题集跑两遍——健康 mock 一遍,得到顺利路径通过率;四档故障 mock 各注入一遍,得到恢复行为达标率。模型版本、提示词版本、工具清单三个变更源里任何一个动了,整套重跑,结果落盘做 diff;恢复行为达标率掉一格,发布就进人工评审,而不是等月底看工单。红了之后的处置路径也现成:对照第一节那张表的「红了谁修」列,改策略的改策略,改提示词的改提示词,改校验的改校验。还有一条纪律:故障档位的配置要进版本管理,每次跑的档位组合写进报告,否则两周后你没法回答「那次红到底是哪一档引起的」。本篇示例代码于 2026-10 按「标准库加 pytest 可运行」标准写成,订单号、金额与错误码均为教学构造值,不指涉任何真实产品。
这套注入管不到什么
第一,四档是起点不是全集。真实依赖的失败谱里还有限流、部分降级、返回半截数据,档位要照着真实依赖的失败模式补,别把四档当成清单终点。第二,注入环境必须与生产隔离。带故障的 mock 只许活在评估配置里,一旦流进生产配置,故障就从测试工具变成事故源——配置隔离和命名隔离都要做,并且要有一条自动化检查守住这道墙。第三,措辞断言天然对模型敏感。「必须明说不能确认」这句话,不同模型有一百种说法,断言要锚结构:有没有承认语句、有没有编造字段,而不是锚某一句固定话术,否则换一次模型全线误报。第四,注入测的是「出错之后的行为」,测不了「出错之前的判断」——错误该不该发生,仍要靠覆盖充分的正常路径用例。
工具永远健康的世界里,错误恢复只是口号;把工具搞挂的那次评估,才是它第一次被真的测过。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。