
企业系统越建越多,最后几乎都会撞上同一个问题:数据散得到处都是。 ERP里有订单,CRM里有客户,MES里有生产数据,WMS里有库存,财务系统里有凭证;旁边可能还有MySQL、Oracle、SQL Server、Kafka、API、Excel……
系统一个接一个上线,真正做经营分析、数据仓库甚至AI应用时才发现:数据能不能用,首先取决于能不能稳定地汇到一起。 所以数据平台建设真正绕不开的第一层能力,就是数据集成。
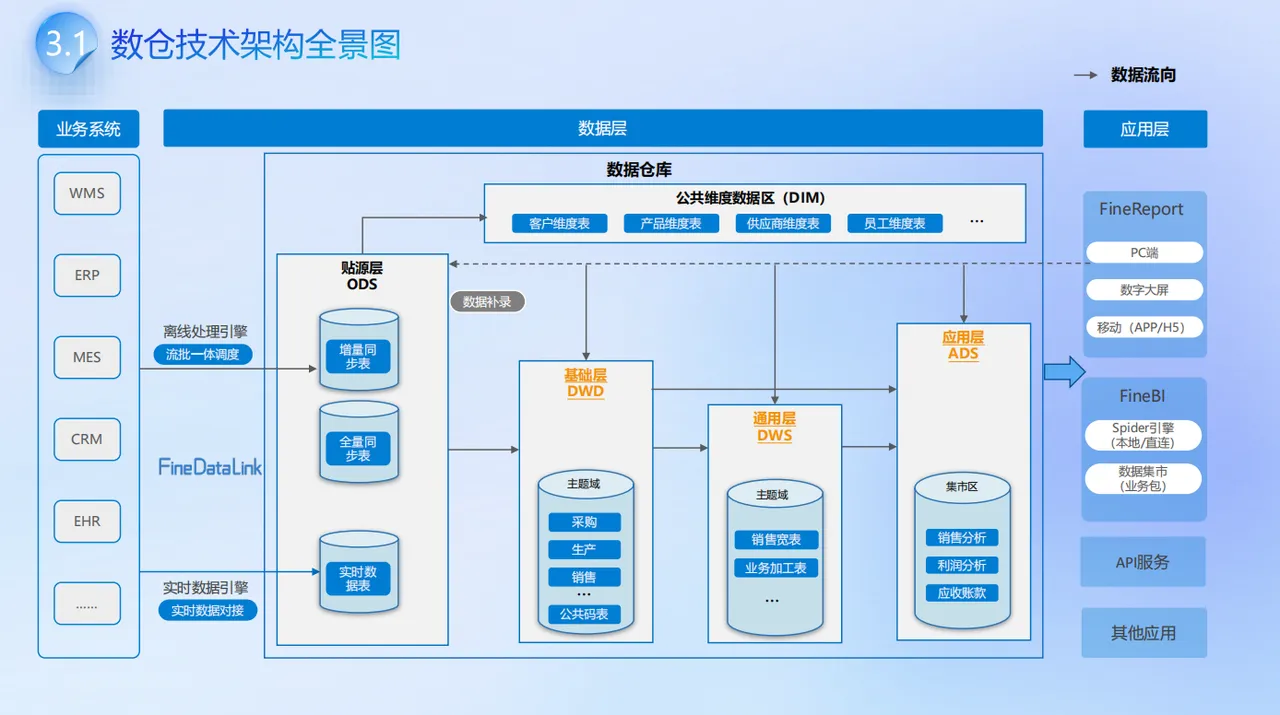
今天就把数据同步这件事一次拆透:ETL到底解决什么问题?CDC为什么越来越重要?实时同步和定时同步差在哪?企业真正需要的数据同步工具,又应该具备哪些能力?
一、数据同步真正难的,从来不是“把表搬过去”
刚接触数据同步时,很容易把它理解成:从数据库A读取一张表,再写进数据库B。 数据量小、系统少的时候,这种方式确实能工作。
但进入真实企业环境,很快就会发现事情没这么简单。比如ERP使用Oracle,CRM使用MySQL,MES使用SQL Server,数仓使用Doris,同时还存在API、Excel、Kafka等来源。
这时首先遇到的是异构问题。同一个客户,在CRM里可能叫customer_id,ERP里却叫cust_code;一个系统用数字表示订单状态,另一个系统保存中文;日期格式、金额精度、空值规则甚至编码方式都可能不同。
因此一条完整的数据链路实际上至少包含:连接 → 抽取 → 清洗 → 转换 → 映射 → 写入 → 调度 → 监控。 而且不同系统还可能需要完全不同的同步方式。
财务主数据每天一次即可,订单可能需要分钟级更新,库存可能要求秒级变化,设备数据则可能持续不断地产生。真正做到项目里,会发现数据源多本身还不是最麻烦的。更常见的问题是,不同数据最后变成了不同的接入方式。
Oracle写一套同步任务,API单独写程序,Kafka再维护一条消费链路,文件数据又靠定时脚本处理。系统少的时候还能记得住,等业务系统越来越多,后面想查一条数据到底从哪里来、经过了哪些处理,往往要顺着好几套任务一点点找。
所以数据集成做到一定规模以后,需要考虑的就不只是“能不能接”,还包括:这些不同来源的数据,能不能按照相对统一的方式组织起来。
数据库、API、文件以及消息类数据都可以作为不同的数据来源接进后续链路。实际搭建时,可以根据数据变化速度选择定时同步、实时同步等不同方式,后面的清洗、转换和写入也放在同一条任务链路里处理。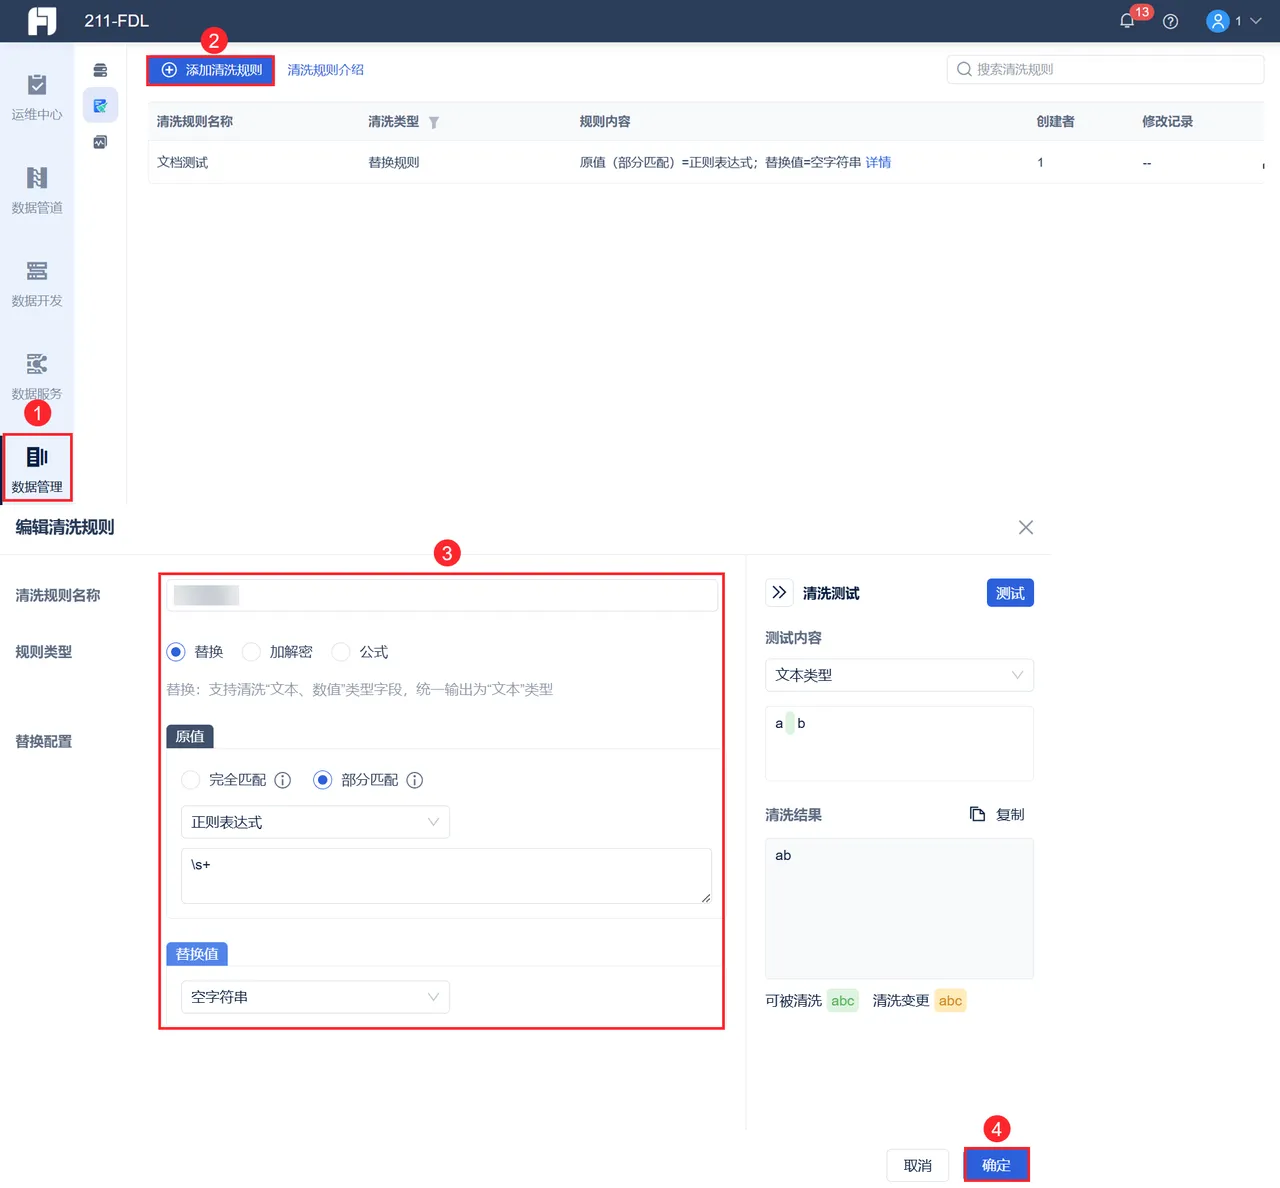
这样理解数据同步工具,就不会只盯着“支持多少数据源”。因为数据源数量只是入口,真正决定后期维护成本的,是:数据接进来以后,链路能不能持续管下去。
二、ETL不是“搬数据”,而是在建立统一的数据语言
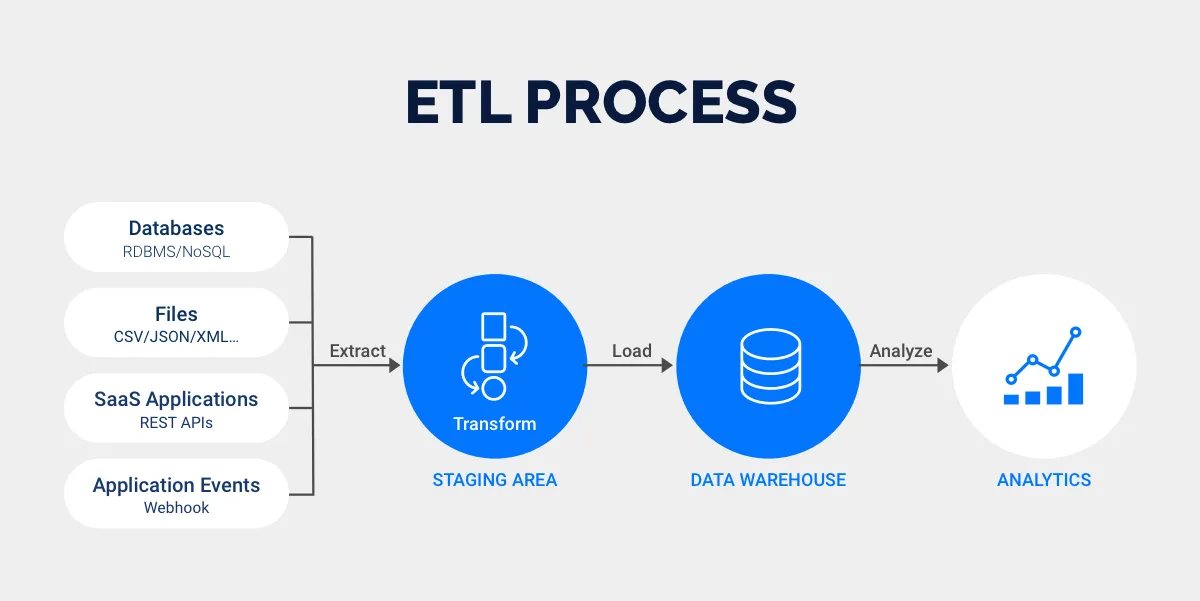
传统数据集成最经典的模式就是ETL:Extract → Transform → Load 也就是:抽取 → 转换 → 加载。
比如从ERP同步订单进入数仓。源系统里可能有100多个字段,但经营分析真正需要的只有订单编号、客户、商品、区域、数量、金额、成本、状态和时间。
进入数仓之前还可能需要处理:统一日期格式、过滤测试订单、转换状态编码、关联商品分类、补充组织信息、统一币种、处理空值,以及计算含税金额等。所以ETL的关键其实不在E和L,而往往在中间的:Transform。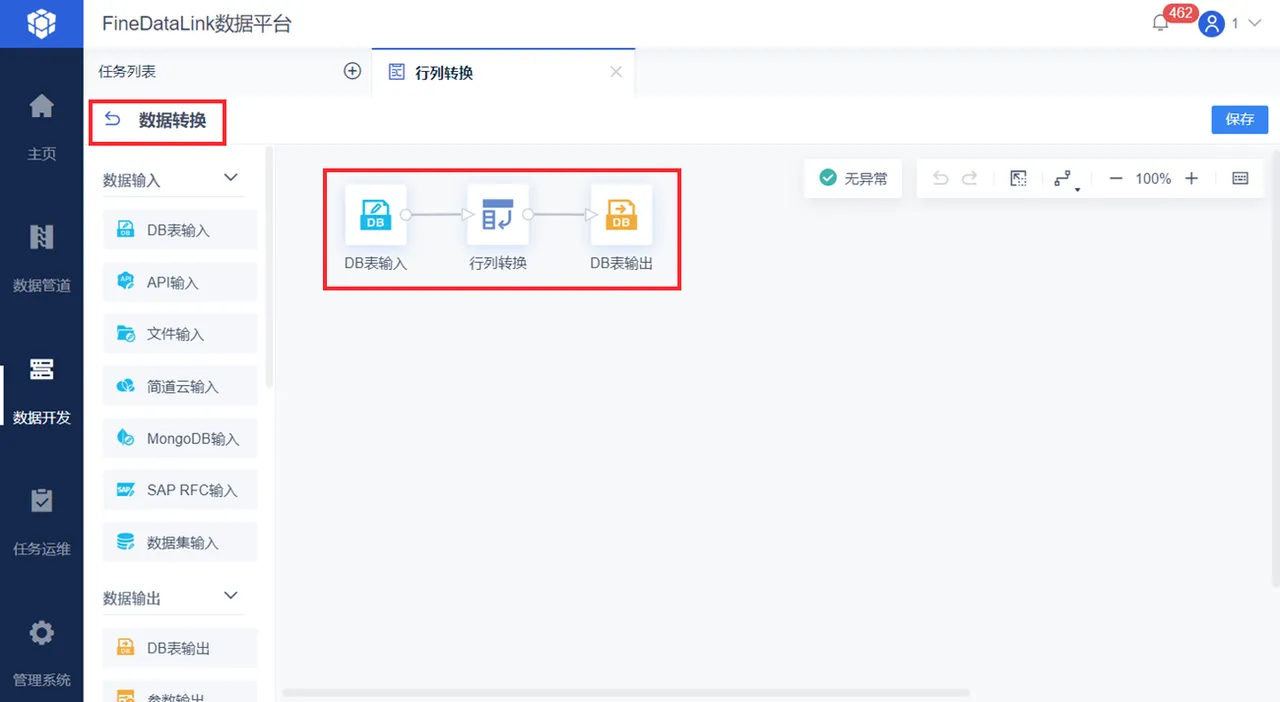
因为业务系统的数据,是为了支撑业务流程设计的;数仓里的数据,则是为了分析设计的。二者天然不是一种数据结构。这里还有一个特别容易踩的坑:什么逻辑都往ETL任务里塞。
一开始只有字段转换;后来加入客户分类;再后来加入收入确认规则、组织映射、绩效口径……最终一条同步任务里塞了几百行SQL。
这样做短期看任务少,长期却会导致业务逻辑和数据传输彻底耦合。更合理的做法应该是:同步解决数据怎么过来,清洗解决数据怎么变干净,建模解决业务关系怎么沉淀,指标层再解决最终怎么算。 数据集成不是替代数仓建模,而是给后面的建模建立稳定的数据入口。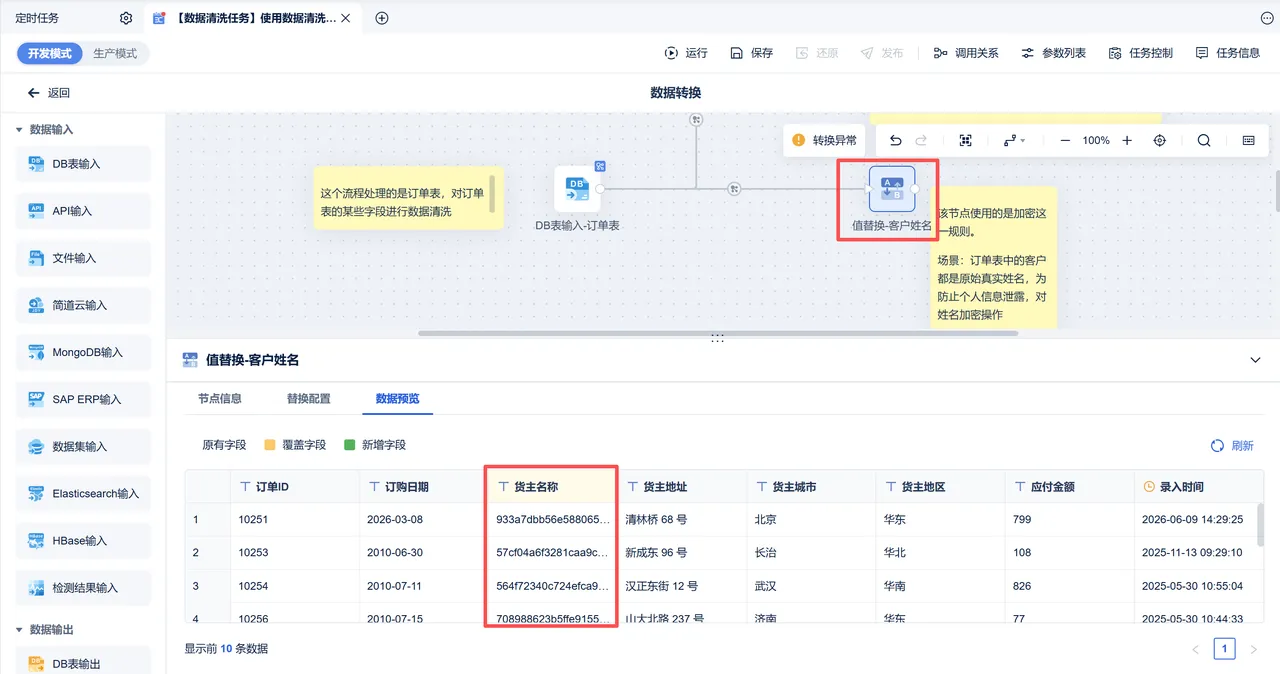
三、数据量一大,真正的问题就变成:怎么只同步“变化”
很多企业第一版数据同步都很直接:每天晚上把整张表重新抽一遍。 10万行没问题。100万行可能也能接受。但订单表如果达到3亿行,每10分钟重新扫描3亿行显然就不现实了。于是必须进入:增量同步。
最常见的方法,是根据update_time读取上一次同步之后发生变化的数据。但这种办法有一个前提:业务字段必须可靠。
如果某条数据修改后没有更新update_time,可能直接漏掉;如果数据库事务已经开始但晚于采集窗口才提交,也可能出现边界问题。这也是CDC越来越重要的原因。CDC,也就是Change Data Capture,变化数据捕获。
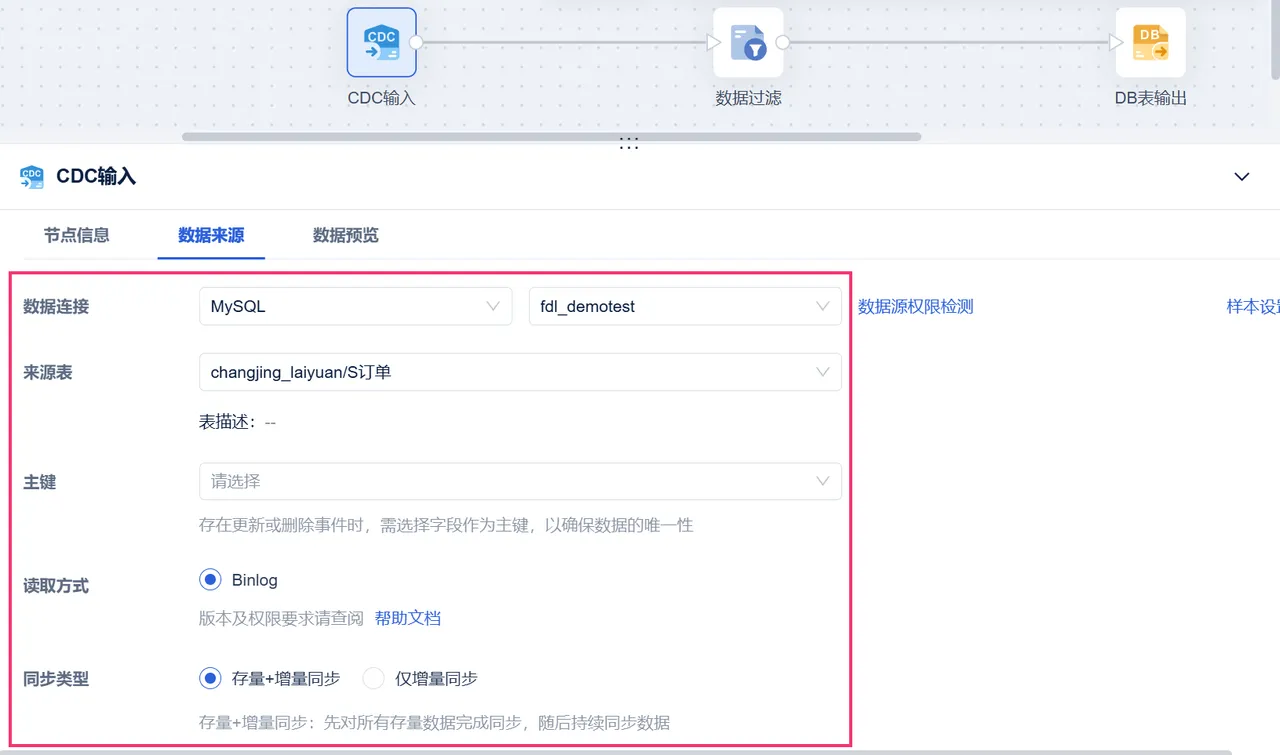
它不是不断询问数据库:“最近有没有数据变过?” 而是直接关注数据库真正发生的:新增、修改和删除。 例如MySQL可以围绕Binlog捕获变化,SQL Server可以使用CDC机制。实时管道也针对不同数据库提供对应的变化捕获方式。
在实际项目里,这意味着如果订单、库存、物流状态等表已经非常大,就不必为了找几千条变化记录反复扫描整张表。但这里一定要注意:CDC解决的是“怎么找到变化”,不是自动解决所有数据一致性问题。
比如:源表发生删除,目标端要不要物理删除?主键发生变化怎么办?同步程序短暂中断以后,从哪个日志位置恢复?目标端写入失败以后,重新消费会不会产生重复数据?
所以CDC真正进入生产环境以后,讨论的就不只是“实时”,而是:Offset、Checkpoint、幂等、重试和一致性。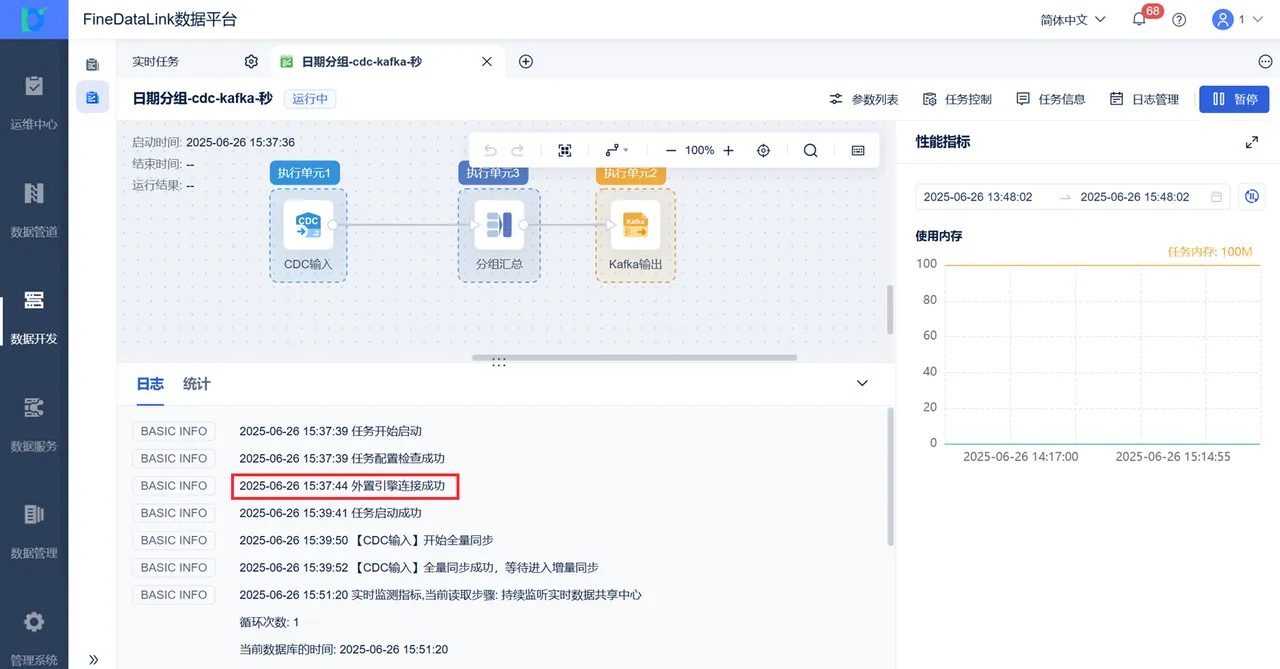
四、实时同步,也不是把“每天一次”改成“每分钟一次”
很多所谓的实时数仓,本质上只是:原来凌晨2点跑一次,现在每5分钟跑一次。这属于:高频批处理。
真正的实时处理,是数据变化产生以后,变化能够持续进入后续链路。假设一张订单表已经有1亿条记录,但每秒真正变化的只有几十条。
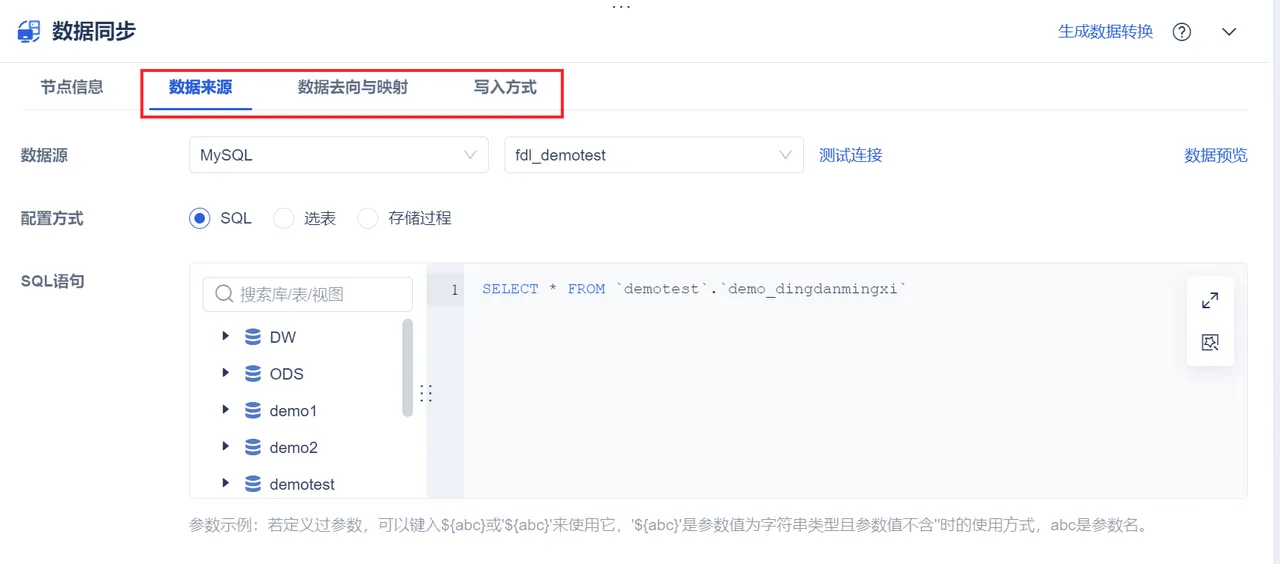
批处理的思路是:不断查哪些数据是新的。 流处理的思路则是:新的变化来了就处理。 数据规模越大,这两种架构的差异越明显。而且企业里的实时数据早就不只有数据库。
Kafka里的行为事件、MQTT里的设备数据、消息队列里的业务事件,本身就是不断产生的数据流。此时真正有价值的已经不是简单地把它们落库,而是在流动过程中完成一定加工。
比如:设备原始数据:设备A、14:01:01、温度85℃。 业务真正关心的可能却是:过去5分钟是否持续高温?是否已经构成异常事件? 也就是说,实时链路正在从:实时搬运 ,进一步走向:实时计算。
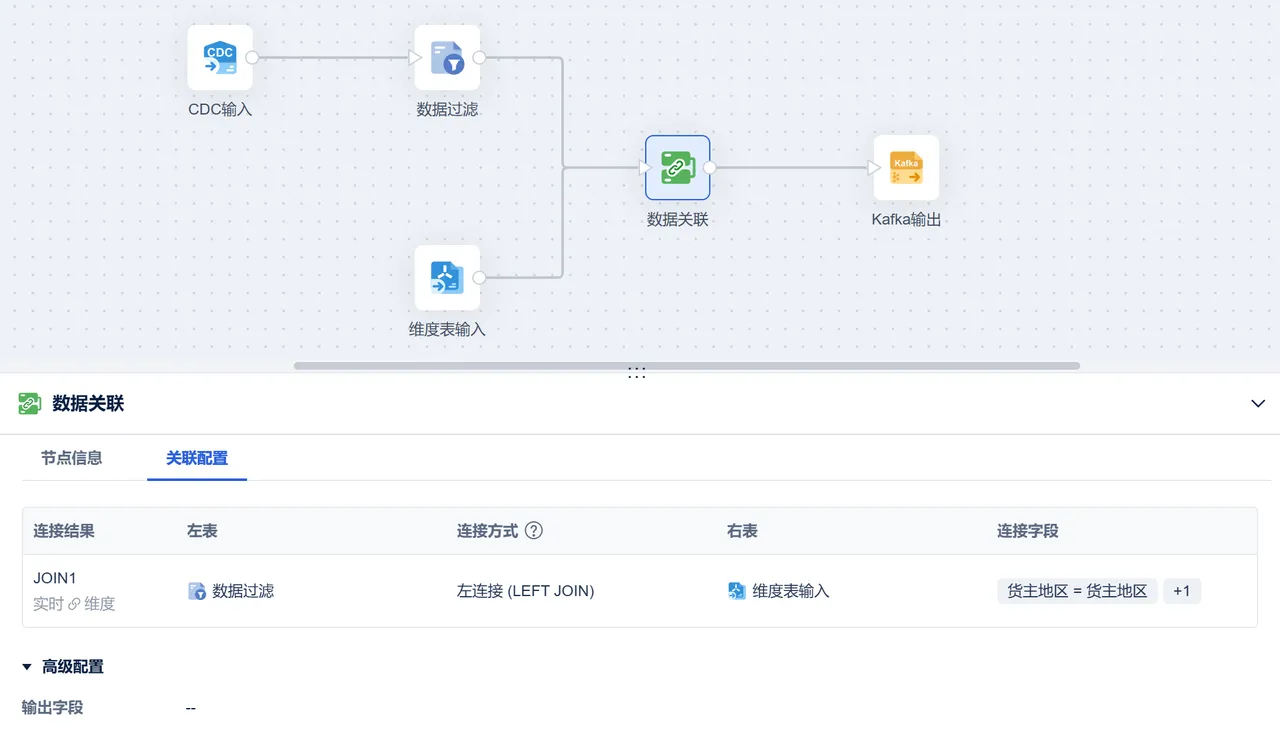
放到实际数仓里,可以让订单变化进入实时明细层以后继续做字段处理、数据分发,再服务实时看板或后续应用。因此判断一个系统是否真正具备实时能力,不能只看:“延迟是不是几秒。”
还要看:实时数据进来以后,能不能加工、能不能分发、失败以后能不能恢复,以及下游能不能正确消费这些变化。
五、真正容易出问题的,是“任务显示成功,数据却已经错了”
很多团队会监控:任务有没有失败。 但数据同步里最危险的情况,往往不是任务直接报错,而是:任务还在运行,数据已经不可信。
例如:源端新增100万条记录,目标端只写入99万条;任务显示运行中,但CDC已经积压两个小时;源表新增了一个字段,目标表没有同步;某批数据因为重试被写了两遍。
业务往往不会第一时间发现这些问题。可能直到财务发现今天收入少了、运营发现订单数不对,数据团队才开始倒查。
所以企业级同步链路至少要观察三层指标。第一层是:任务是否活着。 第二层是:数据是否及时。 第三层才是最容易被忽视的:源端和目标端到底是不是一致。
这也是为什么数据集成做到后期,重点一定会从“任务开发”转向“数据可靠性”。同步成功,只说明程序执行完成;数据正确,才说明这条链路真正完成了业务任务。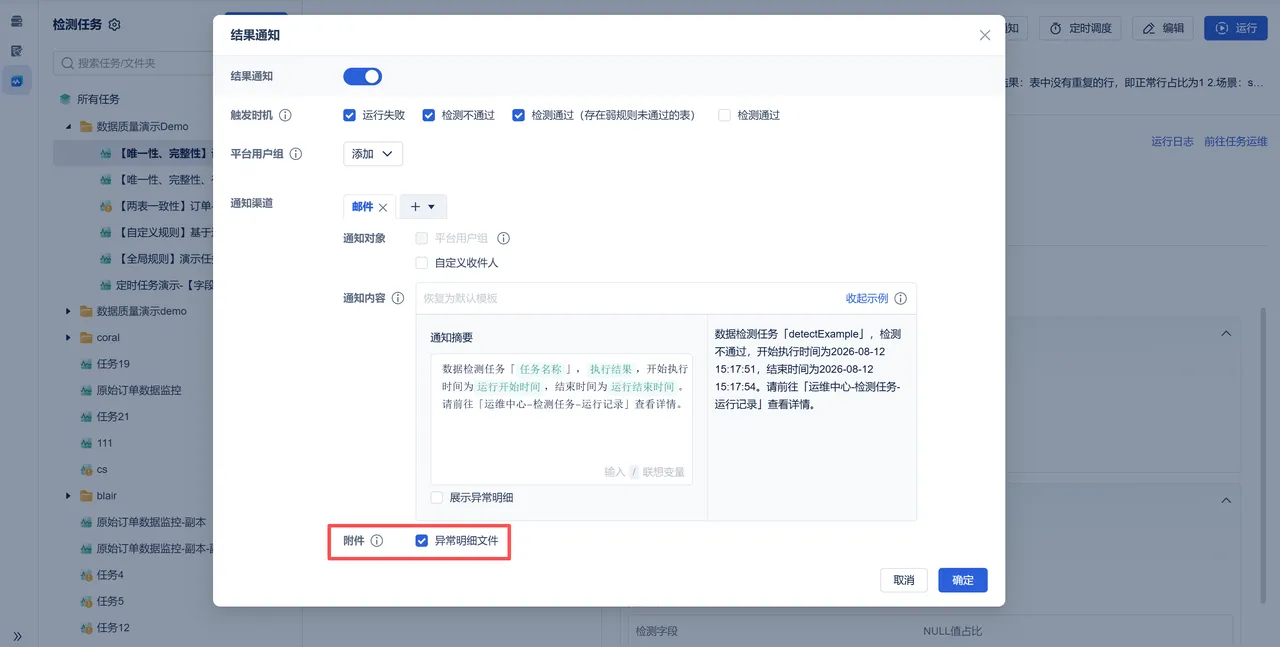
六、真正成熟的数据集成,最终一定会走向“批流协同”
企业不会因为有了实时技术,就把所有任务都改成实时。财务月结每天同步一次完全够用;员工组织信息可能几个小时一次;订单、库存可能要求分钟甚至秒级;设备状态则可能天然就是连续流。所以真正合理的架构不是:全部实时。 而是:该批的批,该实时的实时。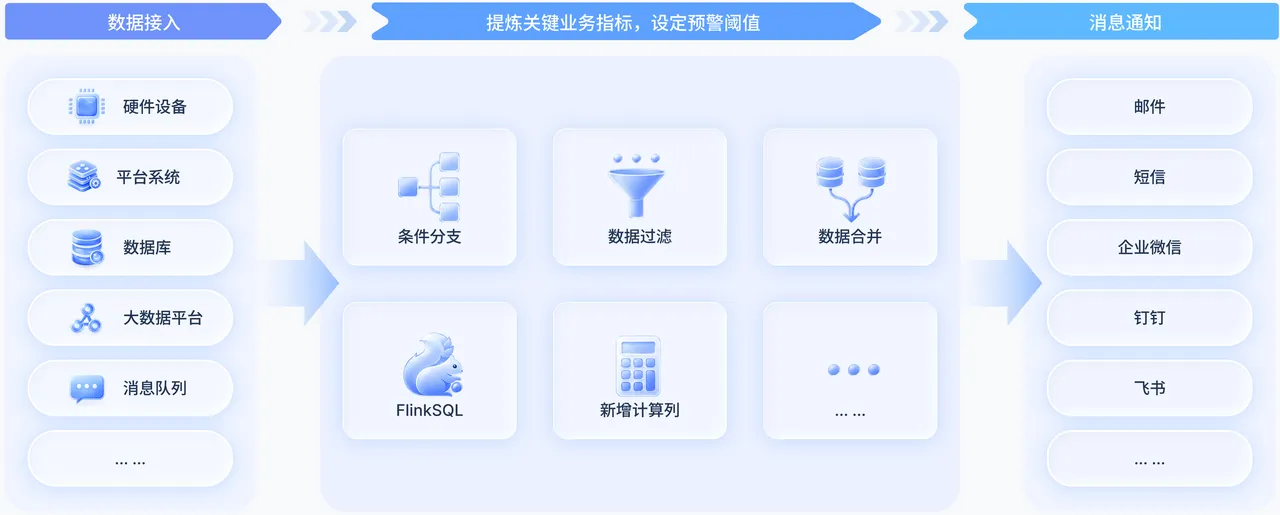
例如一套企业数据平台完全可能同时存在:财务数据每天凌晨跑批;商品主数据每小时增量同步;订单通过CDC进入实时数仓;设备数据从消息流持续进入分析平台。
而当任务数量真正达到几百甚至几千条以后,新的问题马上又会出现:今天到底哪些链路延迟了? 这时候数据集成能力的竞争重点已经从“能不能开发任务”,转向:任务依赖、异常告警、运行日志、数据一致性和故障恢复。
例如实时同步发生异常时,仅仅重启任务并不代表问题解决了。还要继续确认:断点之前的数据有没有重复?中断期间的数据有没有漏?目标端最终是否重新追平源端?
实时管道目前也已经提供部分场景下的数据一致性检测,可以定期检查来源端与目标端的数据状态,并在检测不通过时通知相关人员。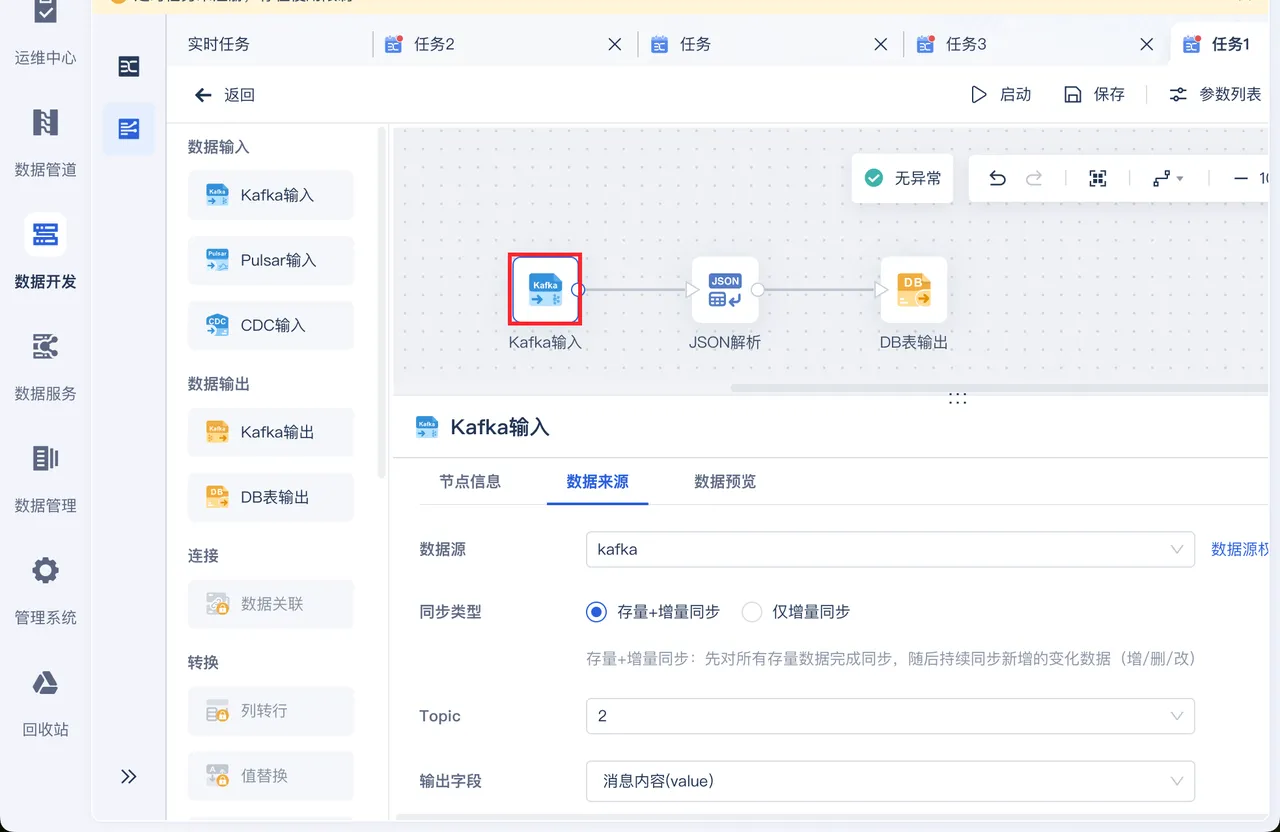
这背后其实代表数据集成正在发生一个非常重要的变化:以前关注的是:“数据有没有同步。” 现在更应该关注:“数据能不能持续、及时、正确地到达。”
七、最后:选数据同步工具,别只看“支持多少数据源”
很多数据集成产品最容易宣传的指标就是:支持多少数据源。 这个数字当然重要。因为企业里不可能只有MySQL。但如果真的要拿一款工具进入生产环境,只看连接器数量远远不够。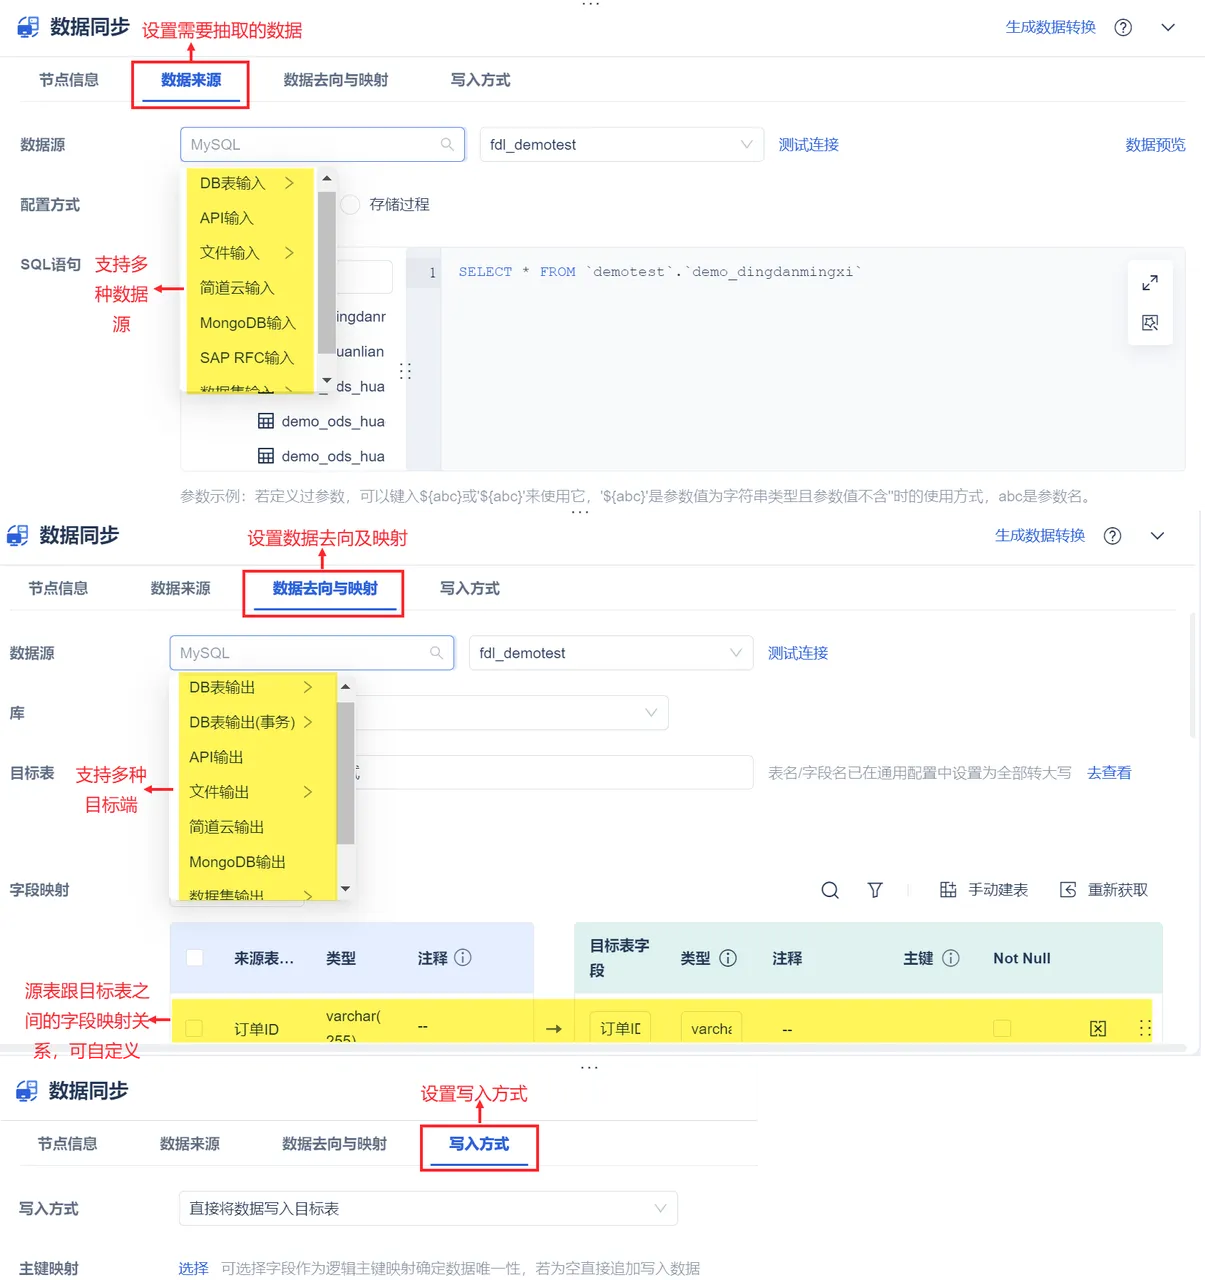
至少还要继续追问一轮:全量、增量、CDC分别怎么做?数据删除能不能正确传递?大表同步如何降低源库压力?任务中断后从哪里继续?
重试会不会产生重复数据?表结构新增字段后怎么办?实时数据能不能继续加工?数据延迟和积压能不能发现?源端、目标端最终如何校验一致?上千条任务以后怎么统一运维?
因为企业真正需要的,从来不是一个:“能把数据从A搬到B的软件。” 而是一套能够让数据长期流动的数据基础设施。
ETL解决:数据怎样被加工。 CDC解决:变化怎样被捕获。 实时同步解决:变化怎样持续传递。 监控、重试和一致性校验解决:这条链路怎样长期可信。 所以一套数据同步工具真正成熟的标志,不是第一次演示时五分钟就把任务跑通。
而是运行半年以后,业务系统增加了、数据量翻了几倍、数据库升级了、任务失败过很多次,团队依然能够清楚回答:数据从哪里来?经过了什么处理?现在流到了哪里?如果少了一条,怎么把它找回来?
做到这一步,数据同步才真正从一个“搬数据”的技术动作,变成企业数据架构里最底层、也最重要的一条生命线。
