
导读:同样是 Flink 作业,有的能稳定跑三年,有的一周就炸一次。差别通常不在算子用得熟不熟,而在那些「文档里一句话带过、线上要用一次事故来学」的编码细节。这篇把 Flink 2.3 里十类高频注意点,按提交期、运行期、运维期三个阶段讲透,每一条都给规避写法。
一、第一条边界:什么能跨过序列化边界
Flink 作业提交时,你写的函数会被序列化,然后分发到各个 TaskManager。序列化边界两侧是两个 JVM、两台机器——能跨过去的是数据,不能跨过去的是资源。
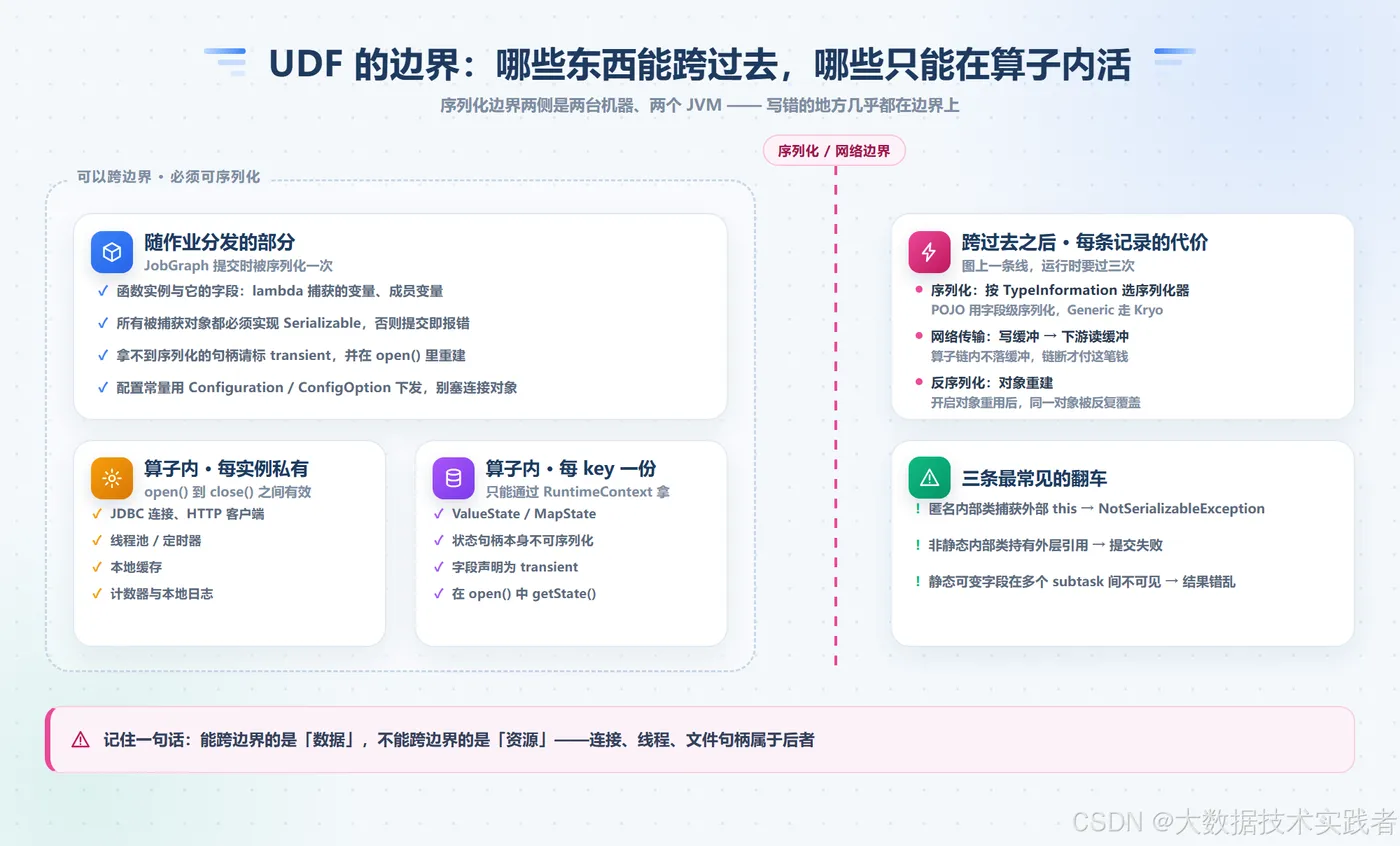
具体到代码,一个 Rich 函数里只有三类字段:
public class EnrichFunc extends RichMapFunction<Order, Order> {

    private transient DbClient client;         // 资源:连接、线程池,不序列化
    private transient ValueState<Long> total;  // 状态句柄:本身不可序列化
    private final Rule rule;                   // 数据:随作业分发,必须可序列化

    public EnrichFunc(Rule rule) {
    this.rule = rule; }

    @Override
    public void open(OpenContext ctx) throws Exception {
      // 2.x 起 open 入参是 OpenContext
        String url = getRuntimeContext().getGlobalJobParameters()
                       .toMap().get("db.url");             // 配置走全局参数,别塞连接对象
        client = new DbClient(url);
        total = getRuntimeContext().getState(
                new ValueStateDescriptor<>("total", Long.class));
    }

    @Override
    public void close() throws Exception {

        if (client != null) client.close();   // 资源必须归还,故障恢复时才会重建
    }
}
三条翻车规则,记住了能省掉大半提交期报错:
- 匿名内部类捕获外部
this→NotSerializableException。lambda 里引用了外部非序列化对象,同理。 - 非静态内部类天然持有外层引用,作为函数传入 Flink 必炸,改成静态内部类或顶层类。
- 静态可变字段在多个 subtask 之间互不可见,拿它当计数器结果一定是错的——计数请用状态或 Metrics。
二、类型识别:你的对象走了哪条序列化通路
Flink 不是拿到对象就无脑序列化,而是先做类型判定,判定结果直接决定性能与状态体积。
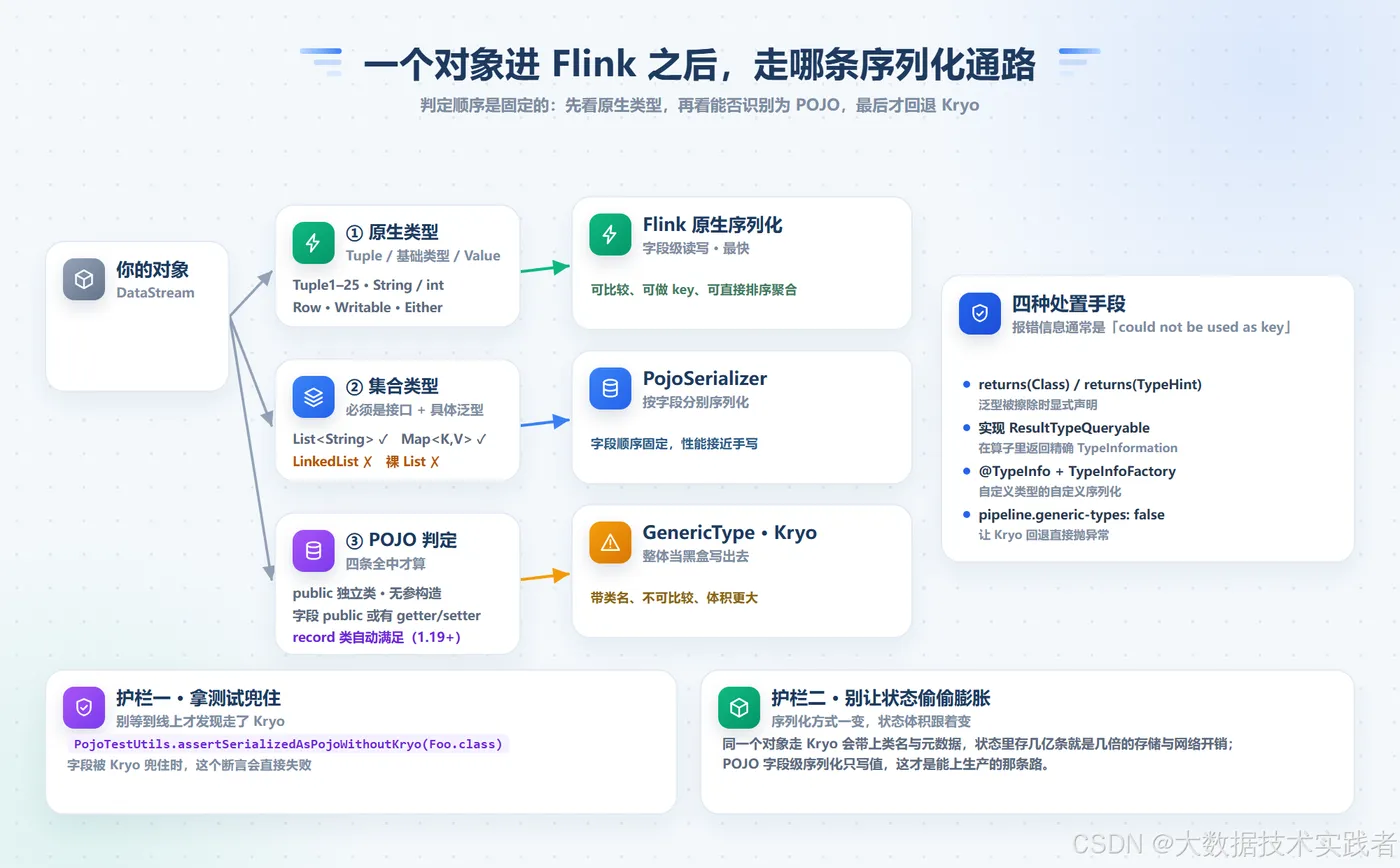
判定顺序固定:原生类型 → 能否识别为 POJO → 都不是则回退 Kryo。POJO 要同时满足四条:public 独立类、public 无参构造、字段 public 或有 getter/setter、字段类型可序列化。Java 17 的 record 从 1.19 起自动满足(免无参构造与 getter/setter)。
集合类型有个隐蔽约束:必须声明为接口 + 具体泛型参数。List<String> 可以,LinkedList<String> 不行——Flink 跨序列化后不保留实现类;裸 List(无泛型)也不行。
走 Kryo 的代价不只是慢:Kryo 会把类名和完整对象当黑盒写出去,同样的数据存进状态,体积可能翻几倍。两条兜底手段:
# config.yaml:让「本该走 POJO 却掉进 Kryo」直接报错,而不是悄悄变慢
pipeline:
  generic-types: false
// 单测里锁死:这个类永远不许被 Kryo 兜底
PojoTestUtils.assertSerializedAsPojoWithoutKryo(OrderEvent.class);
三、泛型擦除:lambda 之后的类型推断
Java 的泛型在编译后被擦除,lambda 场景下 Flink 经常推不出返回类型。运行时报错通常是 The return type of function ... could not be determined automatically。解法是显式声明:
DataStream<Tuple2<String, Long>> out = stream
    .map(v -> Tuple2.of(v.getKey(), 1L))
    .returns(Types.TUPLE(Types.STRING, Types.LONG));   // 或 returns(new TypeHint<>(){})
无法在算子处声明的自定义函数,实现 ResultTypeQueryable 接口返回 TypeInformation,是更通用的写法。
四、keyBy 的 key:确定了就不能变
keyed state 与窗口全部依赖 key 的分区路由,key 一旦在运行中出现随机性,同一逻辑 key 会被路由到不同 subtask,窗口永远等不齐。三个禁用项:
System.currentTimeMillis()、Math.random()参与的 key;- 可变对象的字段做 key,且该字段在 keyBy 之后被修改;
- 浮点数直接做 key(不同机器上的表示可能有差异)。
正确做法是用业务主键:订单 ID、设备 ID、用户 ID。复合 key 用 Flink Tuple 或 POJO 字段,别自己拼字符串再 hashCode。
五、状态必须设 TTL:不做,状态只增不减
有状态流处理最经典的死法:跑了几周,RocksDB 越来越大,Checkpoint 越来越慢,最后超时失败。原因就是没有状态过期策略。Flink 的答案叫 StateTtlConfig:
StateTtlConfig ttl = StateTtlConfig.newBuilder(Duration.ofHours(6))
        .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)   // 写入时刷新
        .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
        .cleanupInRocksdbCompactFilter(1000)   // 每 1000 条状态做一次 compaction 过滤
        .build();

ValueStateDescriptor<Profile> desc =
        new ValueStateDescriptor<>("profile", Profile.class);
desc.enableTimeToLive(ttl);
四个必须知道的细节:
- TTL 只支持 processing time,不支持事件时间。
- TTL 配置不会存进 checkpoint/savepoint,它只是运行时对状态的解释方式——恢复作业时这段代码还得在。
- RocksDB 后端每条状态要多存 8 字节时间戳,TTL 不是免费的。
NeverReturnExpired适合隐私数据;允许返回过期值用ReturnExpiredIfNotCleanedUp,清理有延迟但读性能更好。
六、ProcessFunction 与 Timer:低阶 API 的四个约定
需要「超过 N 分钟无更新就输出」这类逻辑时,KeyedProcessFunction 是标配,Timer 是它的灵魂。四个约定:
- Timer 按 key + 时间戳去重:同一 key 同一时间戳只会触发一次
onTimer。 - Timer 也是状态,随 checkpoint 一起持久化;故障恢复后到期的处理时间 Timer 会立即触发。
processElement与onTimer被 Flink 串行化调用,不需要自己加锁保护状态。- Timer 数量本身也是状态,量大就做合并——把精度降到秒即可:
// 精度从毫秒降到秒:同 key 同秒的定时器合并成一个
long t = ((ctx.timestamp() + timeout) / 1000) * 1000;
ctx.timerService().registerEventTimeTimer(t);
七、窗口与迟到数据:丢掉之前先给条活路
事件时间窗口靠 watermark 关窗,而 watermark 是对「乱序程度」的估计——估计错了,数据就迟到了。默认 allowedLateness = 0,迟到数据直接被丢弃,你甚至不会收到任何报错。生产作业必须显式处理:
OutputTag<Order> late = new OutputTag<Order>("late-orders") {
   };

SingleOutputStreamOperator<Stat> result = stream
    .keyBy(Order::getUserId)
    .window(TumblingEventTimeWindows.of(Duration.ofMinutes(5)))
    .allowedLateness(Duration.ofMinutes(1))   // 关窗后再宽限 1 分钟,期间触发 late firing
    .sideOutputLateData(late)                 // 宽限后仍迟到的进侧输出
    .aggregate(new StatAgg(), new StatWindow());

result.getSideOutput(late).sinkTo(lateSink);  // 迟到数据落盘补算,而不是静默消失
两个连带注意点:allowedLateness 会触发 late firing,下游会收到同一窗口的多次更新,要按业务去重;Evictor 会禁用窗口预聚合,窗口内所有元素都要缓存在状态里,能不用就不用。
八、Async I/O:别把异步写成同步
查外部维表是 Async I/O 的典型场景,但它有一个反直觉的核心约束:AsyncFunction 不是多线程调用——每个 subtask 只有一个实例,逐条顺序执行 asyncInvoke。异步能力完全依赖客户端的回调,如果你在 asyncInvoke 里写了 future.get(),整条流就退化成了同步阻塞。
DataStream<Enriched> out = AsyncDataStream.unorderedWait(
        stream, new AsyncDbRequest(),
        1000, TimeUnit.MILLISECONDS,   // timeout:含重试的总时限,防死请求
        100);                          // capacity:每 subtask 并发在途请求数
- capacity 不是越大越好:积压的请求都存在状态里,容量过大先撞 OOM; throughput 上不去时优先加并行度。
- 开重试要补容量:额外容量约等于
inputRate × 重试比例 × 平均重试耗时。 unorderedWait延迟最低;orderedWait要缓冲乱序结果,延迟和 checkpoint 开销都更大,非必要不用。
九、改代码之前:uid 决定状态找不找得回来
savepoint 本质是一张「Operator ID → State」的映射表。你不写 uid() 时,Flink 按拓扑结构哈希自动生成 ID——加一个 filter,整条链后面的 ID 全部漂移,恢复时状态全部失配。
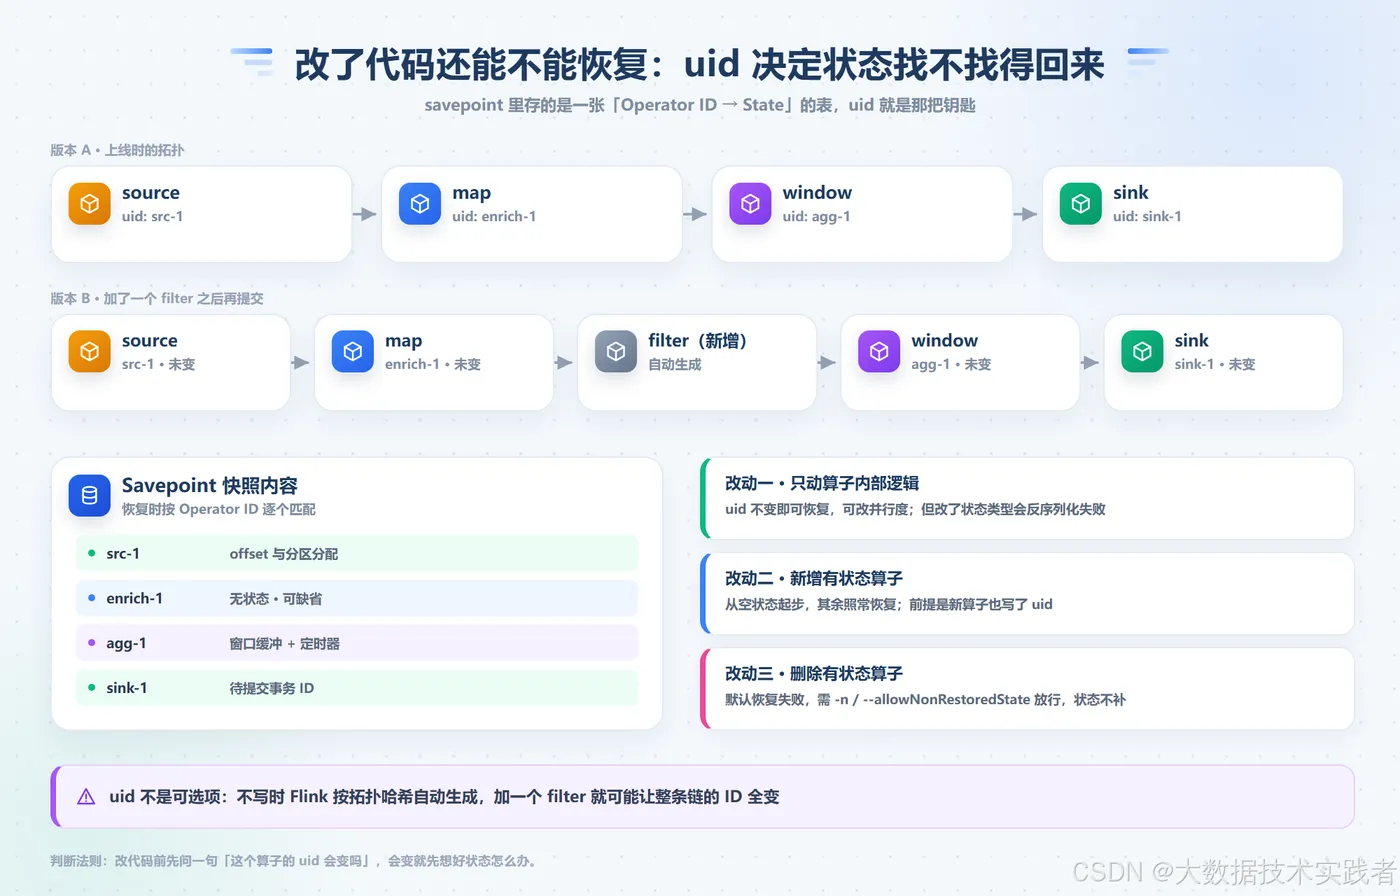
所以 uid 是必选项,而且所有有状态算子都要写,包括看起来无状态的 window、asyncWait、sinkTo:
env.fromSource(src, strategy, "kafka-src").uid("src-orders")
   .map(new EnrichFunc(rule)).uid("map-enrich")
   .keyBy(Order::getUserId)
   .window(TumblingEventTimeWindows.of(Duration.ofMinutes(5)))
   .aggregate(new StatAgg(), new StatWindow()).uid("win-5min")
   .sinkTo(paimonSink).uid("sink-paimon");
三条恢复规则配合记忆:
| 改动类型 | 结果 | 处理方式 |
|---|---|---|
| 只改算子内部逻辑 | uid 不变,正常恢复 | 直接从 savepoint 起作业,可改并行度 |
| 新增有状态算子 | 旧快照无记录 | 正常恢复,新算子空状态起步 |
| 删除有状态算子 | 默认恢复失败 | 加 -n / --allowNonRestoredState 放行,被删状态不迁移 |
顺带一条上线即不可逆的配置:setMaxParallelism 上线后不能改(改了状态映射就乱),起步时就要按未来两年规模设好,上限 2^15。
十、Checkpoint 存储:别把快照留在 JobManager 堆里
默认配置下 checkpoint 数据存在 JobManager 堆内存,作业一重启全部蒸发,等于没做容错。2.x 的生产配置必须落文件系统,且全部写在 config.yaml(flink-conf.yaml 已移除):
execution.checkpointing:
  interval: 30 s
  mode: EXACTLY_ONCE
  storage: filesystem
  dir: hdfs:///flink/ck/order-stat
  min-pause: 10 s
  timeout: 5 min
  externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
注意 RETAIN_ON_CANCELLATION 会在作业取消后保留元数据,需要定期清理目录,否则对象存储费用会悄悄上涨。
十一、十类注意点清单
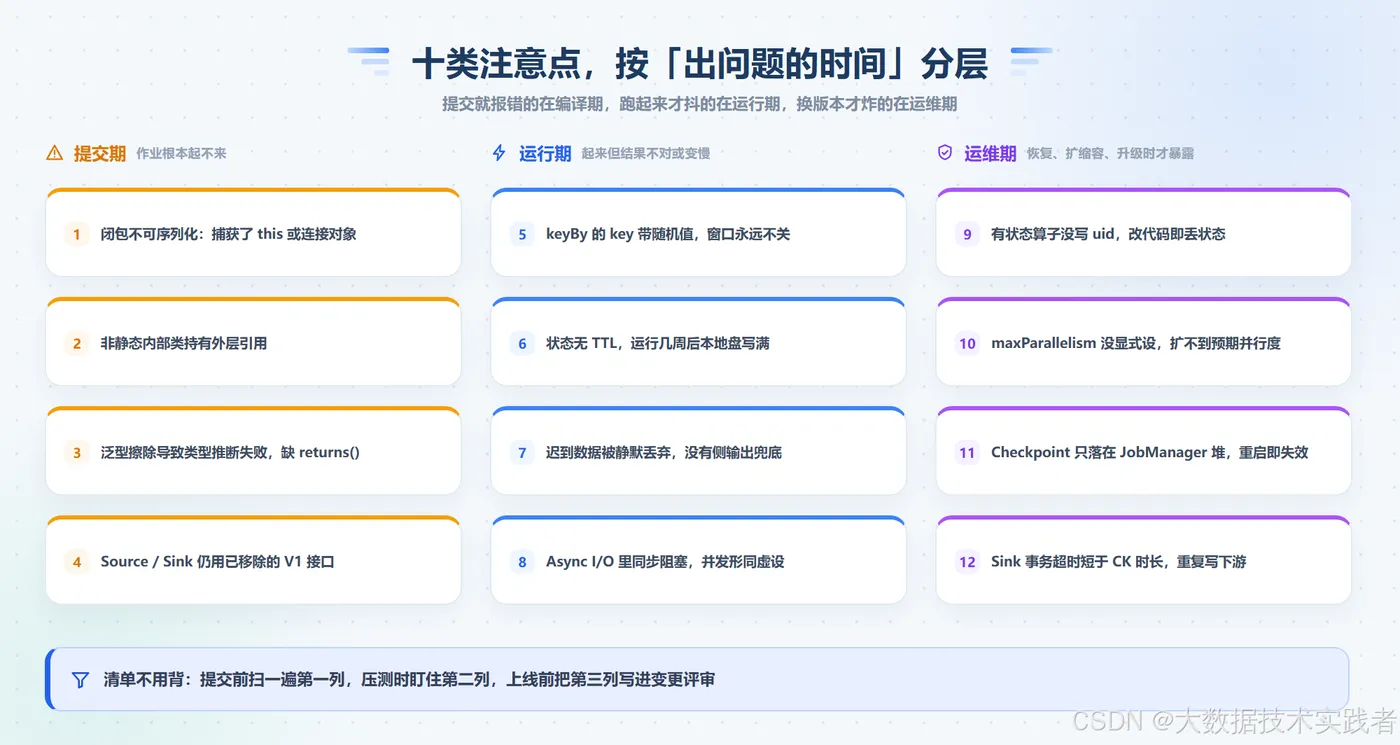
把全文收进一张图:提交期的四类在本地编译运行就能暴露,上线前全量扫一遍;运行期的四类要靠压测和监控盯出来;运维期的四类最隐蔽,等故障恢复时才炸,必须写进变更评审 checklist。
结语
Flink 的编码注意点有一个共同母题:你写的不是一段函数,而是一个会被序列化、并行化、快照化、再恢复的分布式系统组件。边界上(序列化、uid、maxParallelism)的决策几乎不可逆,运行中的决策(TTL、水位线、Timer 精度)决定成本,而所有这些加起来,才构成「能长期跑」的作业。
