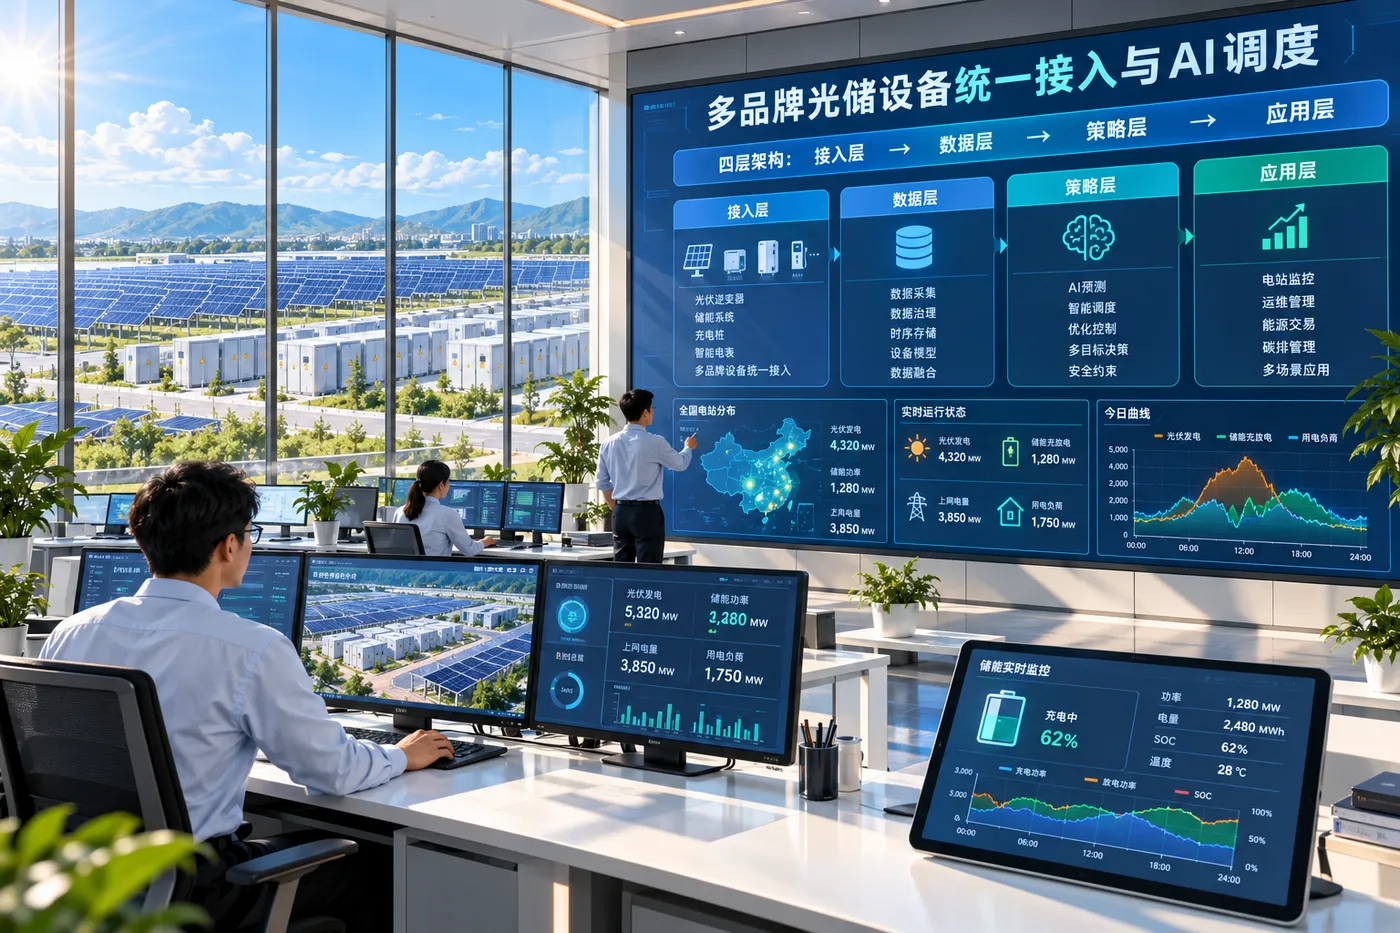
问题场景:一个典型的光储数据链路挑战
一个中型工商业光储项目的设备构成大致是这样:2-5 家厂商的光伏逆变器(Modbus TCP / DL/T645)、储能 BMS 与 PCS(Modbus RTU / 厂商私有协议)、智能电表(DL/T645)、若干环境传感器。数据采集频率 1-5 分钟不等,充放电控制指令要求秒级下发。同时,电力现货市场的电价信号每 15 分钟刷新一次,出力预测偏差会触发考核罚款。
把这条链路拉通,需要解决三个工程问题:异构协议的统一接入、高频遥测数据的高效存储与查询、预测模型的在线推理与策略下发。我们在一个能源数字化项目中完整经历了这个过程(鲸能云的工程实践),把踩过的坑和架构取舍记录如下。
一、边缘侧:协议转换与数据归一
多品牌设备接入的核心矛盾是协议异构。直接在云端为每个厂商写一套解析器不现实——设备固件升级后寄存器映射可能变化,维护成本随品牌数线性增长。
方案:边缘网关做协议归一,云端只收标准格式。
边缘侧部署轻量协议转换服务(Docker 容器,单核 512MB 即可跑 20-30 台设备),将 Modbus TCP/RTU、DL/T645 等协议解析后统一为 JSON Schema,通过 MQTT 上报。关键设计决策有三个:
- 设备模型抽象。 不管底层协议是什么,上报数据统一为
{device_id, metric, value, timestamp, quality}五元组。quality 字段标记数据可信度(原始值 / 清洗值 / 估算值),下游消费方按需过滤。 - 点表配置化。 每种设备型号的寄存器映射存为 YAML 配置文件,新增设备型号只需加一个配置文件,不需要改代码。实测接入一款新逆变器平均耗时从 2-3 天缩短到半天。
- 断网缓存。 边缘网关本地用 SQLite 做 WAL 缓存,断网时数据不丢,恢复后按时间序补传。云端消费侧做幂等去重(基于
device_id + timestamp做 upsert)。
这一步是整个数据链路的地基。地基歪了,上层的分析和 AI 全是空中楼阁。
二、云端接入:MQTT 消息总线与流式清洗
设备数据上报到云端后,需要做三件事:接收、清洗、分发。
消息接入。 选用 MQTT 作为设备侧协议(轻量、支持 QoS、生态成熟),云端部署 EMQX 集群做 Broker。EMQX 的规则引擎可以做第一层过滤——把明显异常的遥测值(如功率为负且超出设备额定范围)直接丢弃,避免脏数据污染下游。
流式清洗。 消息经 Kafka 分发到 Flink 作业做二次清洗:时间戳对齐(设备时钟漂移是常见问题)、缺失值插补(线性插值 / 前值填充,按数据类型选择)、异常值检测(3σ 或 IQR 规则)。清洗后的数据双写:一份进时序数据库供实时查询,一份进数据湖供离线模型训练。
时序存储。 选型时对比了 InfluxDB 和 TimescaleDB。InfluxDB 写入性能好但查询语言偏专用;TimescaleDB 基于 PostgreSQL,SQL 生态完整,与业务库(资产台账、项目信息)做 JOIN 更方便。最终选了 TimescaleDB,配合连续聚合(Continuous Aggregate)做分钟级 / 小时级预聚合,查询 30 天电站运行数据的 P99 延迟控制在 200ms 以内。
一个踩坑经验:不要在时序表里存业务标签。 最初把电站名称、设备型号等文本字段放在时序表里,写入量暴增后单表膨胀严重。后来拆成「时序数据表 + 设备维表」两层,时序表只存 device_id + metric + value + ts,业务标签在查询时 JOIN 维表,存储成本降了约 40%。
三、AI 策略层:模型训练与在线推理
电价预测和充放电策略生成是这条链路的最终出口。架构上分离线训练和在线推理两部分。
离线训练。 特征工程在数据湖(基于对象存储的 Parquet 文件)上完成:历史电价、气象数据(温度/辐照度/云量)、新能源出力、负荷曲线。模型选型上,电价预测用 LightGBM 做梯度提升(特征可解释性强、训练快),充放电策略用规则引擎 + 优化求解器(约束多且硬,纯 ML 端到端不可控)。
在线推理。 模型导出为 ONNX 格式,部署在容器化的推理服务里(单副本 2 核 4G,QPS 200+ 覆盖 2000 电站的策略计算)。推理服务按 15 分钟粒度定时触发,输出次日 24h 充放电计划。策略结果写入消息队列,由调度服务下发到边缘侧执行。
关键工程决策是 预测与决策分离:预测模型只输出价格信号,不直接生成控制指令。充放电策略由独立的规则引擎决定——它综合电价预测、设备约束(SOC 上下限、功率限值)、电网考核规则,输出最终执行计划。这样做的好处是可解释、可回溯、可人工覆写。当模型预测异常时(比如节假日电价数据缺失),规则引擎兜底不会产生危险指令。
四、部署拓扑与弹性伸缩
整套服务容器化部署在 Kubernetes 上。核心服务(MQTT Broker、Flink、TimescaleDB、推理服务)各自独立 Deployment,按负载水平扩展。
几个值得注意的点:
- EMQX 集群按连接数扩容。 2000+ 电站 × 平均 20 台设备 = 4 万+ MQTT 长连接。EMQX 单节点支撑 10 万连接没问题,但为容灾做了 3 节点集群。
- Flink 作业按数据量伸缩。 遥测数据高峰在早晚(设备上报集中),配置 HPA 根据 Kafka 消费延迟自动扩缩 TaskManager。
- TimescaleDB 做冷热分层。 最近 30 天数据存 SSD(热数据,查询频繁),30 天前的压缩归档到对象存储(冷数据,偶尔查)。压缩比约 10:1。
实施边界与经验
这套架构适用于 100+ 电站规模的光储数字化项目。对更小规模(单电站、少设备),直接用单体服务 + SQLite / PostgreSQL 就够了,上微服务和 Kafka 是过度设计。对更大规模(万级电站),需要引入数据分片(按区域 / 省份拆分 TimescaleDB 实例)和多级消息总线。
另一个经验是 不要过早引入 AI。 鲸能云团队在数据链路稳定运行 3 个月后才上线电价预测模型——这 3 个月积累的高质量历史数据直接决定了模型精度。跳过数据治理阶段直接上模型,效果往往不如预期。
小结
光储电站的智能化不是一步到位的:先解决协议异构和数据归一(边缘侧),再打通实时数据链路(云端接入与清洗),最后才谈 AI 策略(预测与决策)。每一层的技术选型都有明确的适用边界——MQTT + EMQX 适合 IoT 场景、TimescaleDB 适合高频时序查询、规则引擎 + 优化求解器适合约束密集的调度决策。把这三层做扎实,AI 才能真正发挥作用。
常见问题
多品牌 IoT 设备协议不通,云端怎么统一处理?
推荐边缘侧做协议归一:网关解析 Modbus/DL/T645 等协议后统一为标准 JSON Schema,通过 MQTT 上报。云端只消费标准格式,新增设备型号只需加配置文件,不需要改代码。
高频遥测数据用什么时序数据库?
InfluxDB 和 TimescaleDB 是主流选择。写入为主选 InfluxDB,需要与业务库做 SQL JOIN 选 TimescaleDB。建议把设备标签拆到维表,时序表只存 device_id + metric + value + ts,存储成本可降约 40%。
AI 预测模型怎么部署到线上?
离线训练后导出 ONNX 格式,部署为容器化推理服务。预测与决策分离:模型只输出价格信号,充放电计划由规则引擎综合约束后生成,保证可解释、可人工覆写。
小规模电站需要上完整 IoT 架构吗?
不需要。单电站、少设备场景用单体服务 + PostgreSQL 足够。只有当电站规模到 100+、设备数到数千台时,才需要 MQTT 集群、流处理和时序数据库的组合。