
一、为什么这个原型需要保留“做题过程”
Coding Atlas 要处理的问题,可以从项目里的订单汇总任务说起。任务要求修复一段 Python 程序,处理不规范的数据,并按照要求汇总金额。最后交上一份能够通过公开用例的代码,只能说明这份实现通过了这些检查。它还回答不了几个问题:作答者是否理解金额处理的要求,是否检查过异常输入,怎样判断 AI 给出的建议,以及需求变化后能否继续修改。
这些问题决定了系统不能只存最终提交。Coding Atlas 把代码快照、测试结果、AI 对话、补丁判断和文字解释放到同一次测评中,让评分者能够沿着具体记录查看判断依据。项目还设计了两位评分者独立评价,以及一周后的知识保持和迁移复测,希望进一步区分即时完成任务与后续独立完成任务的表现。这是当前研究方案的出发点,相关作用仍需要真实数据检验。
围绕这套流程,原型已经提供研究概览、实战测评、证据与评分、能力画像、研究配置和研究验证等页面。不过,界面能展示一条过程记录,与这条记录确实来自受限环境中的代码执行,是两件需要分别确认的事。
本地版本使用 SQLite,自动测试中的 AI 和执行成功路径使用 HTTP 协议桩。它们适合检查权限、状态流转、事件写入等逻辑;本机没有 Docker,无法据此确认 Linux 作业容器是否真的启动、限制是否生效、运行结束后是否清理。PostgreSQL 的持久化和备份恢复也需要到实际环境中检查。这次上云,就是为了补上这些工程环节。
迁移前,10 月 29 日的基线验证记录了 32 项 Python 测试通过,pytest 报告耗时 5.86 秒;前端 TypeScript 检查和生产构建通过,Vite 转换了 2179 个模块,构建耗时 7.79 秒。前端构建使用 --configLoader runner 处理本机依赖目录链接造成的临时配置写入问题,没有为通过构建而修改业务或测试代码。这些结果作为本地基线保留,云端执行另做验收。
二、2 GiB 内存,先把部署范围收住
本次复用一台位于华东 2(上海)的阿里云轻量应用服务器,规格是 2 vCPU、2 GiB 内存、40 GiB 系统盘。北京时间 10 月 29 日 10:59:27 的快照显示,系统识别的总内存约 1871 MiB,可用约 1439 MiB,系统盘剩余约 24 GiB,没有 swap;Docker 版本为 26.1.3,Compose 为 v2.27.0。主机原有服务监听 80 端口,部署前没有运行中的 Docker 容器。
这个配置适合回答一个范围明确的问题:现有资源能否承担原型的受控验证。当前还没有真实参与者,先把前端、业务服务、数据库和执行作业放在同一台主机上,便于核对调用关系和故障记录。代价也很直接:它们共享 CPU、内存和磁盘,执行任务会与业务服务竞争资源,不能把这次部署直接当作课堂规模的服务方案。
前端沿用 React、TypeScript、Vite 和随产物分发的 Monaco,在本地完成构建;云端负责构建 Python 运行镜像。这样把前端工具链留在本地,减少小实例上需要同时承担的构建工作。但它也要求部署包中包含对应的前端产物,不能只更新后端源码就认为版本已经完整更新。
服务通过独立 Compose 项目部署,PostgreSQL 使用本项目独占的持久卷。API、数据库和 runner 的内存上限分别设置为 384、256、192 MiB。这些是容器限额,不是实测占用;runner 创建的作业容器还会单独消耗资源,不能把三个数字相加就当作整套系统的内存预算。
访问范围同样收在本轮验证之内。API 只映射到宿主机 127.0.0.1:18000,数据库和 runner 不映射主机端口。这样无需占用已有的 80 端口,也无需为演示增加公网入口。其代价是本地浏览器需要通过 SSH 转发访问。已有记录确认临时隧道可用,并在 Chrome 中读取过云端历史执行记录;临时隧道随后关闭。新的页面提交及结果反馈尚未完成验收。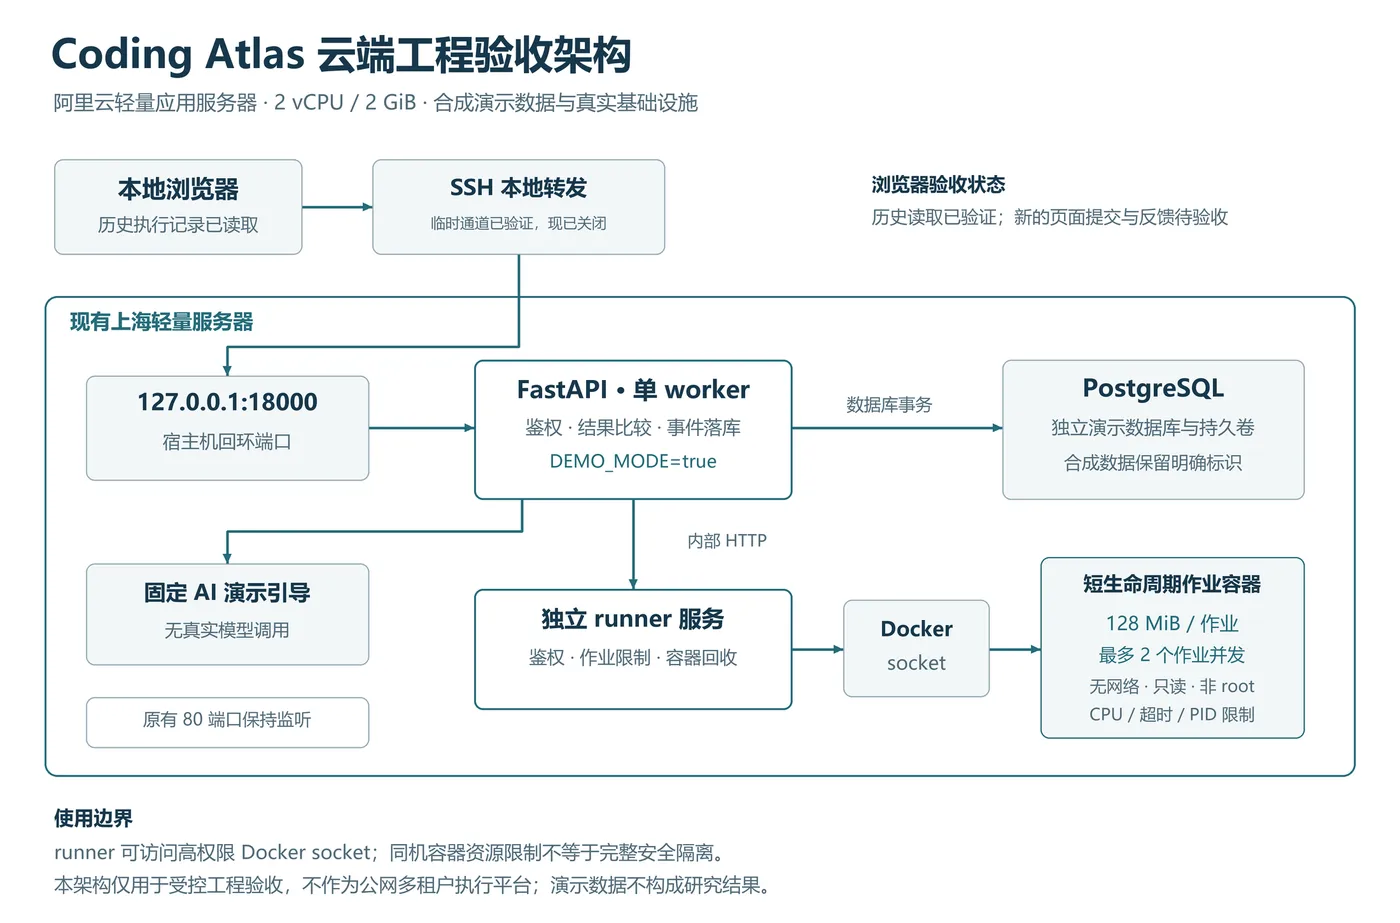
API 负责身份和阶段检查、比较执行结果、保存事件;runner 通过内部 HTTP 接收代码,创建短生命周期的 Linux 容器。只有 runner 挂载 Docker socket。这个拆分明确了职责,却仍受同一台主机约束,尤其是 Docker socket 具有很高权限。作业容器的资源限制有实际价值,但当前方案只用于受控工程验收,公开或多租户使用前需要重新设计执行隔离。API 和 runner 均保持单 worker,进程内锁和并发名额也没有被描述成跨进程协调方案。
三、构建通过以后,服务为什么还是起不来
部署记录中的第一个阻碍是 runner 镜像安装 docker.io 时下载缓慢。这次构建在 211 秒后被人工停止,退出码为 130。随后检查了宿主机已有的 Docker 客户端能否在所用 Python 基础镜像中运行;确认兼容后,服务器专用配置改为只读挂载 /usr/bin/docker 作为客户端,同时继续挂载 Docker socket,省去镜像内安装整套软件包的步骤。
这是对当前主机条件的利用。它省掉了这次镜像构建中的一个安装环节,也增加了对宿主机二进制的依赖。换主机或基础镜像时,必须重新检查动态库兼容性。因此,证据中同时记录了 Docker 版本和客户端 SHA-256,便于以后确认环境是否变化。
接下来,固定依赖的联网构建完成了,耗时 810 秒、退出码为 0,API 却没有正常启动。日志最后指向:
PermissionError: [Errno 13] Permission denied: '/app/backend/__init__.py'
错误已经落到应用源码文件上。检查打包权限后,backend/__init__.py 的 mode 是 600,而 API 镜像使用 uid 为 10001 的非 root 用户运行。文件被复制进镜像,并不意味着运行用户就能读取它。构建阶段与应用启动阶段使用的身份不同,前一个阶段成功,无法替后一个阶段作保证。
修复保留了非 root 用户,只补齐应用源码和前端产物的可读、可遍历权限:
RUN useradd --uid 10001 --create-home atlas \
    && mkdir /app/data \
    && chown atlas:atlas /app/data \
    && chmod -R a+rX /app/backend /app/frontend
USER atlas
打包规则也相应明确:目录使用 0755,普通源码和构建文件使用 0644;实际凭据文件继续采用受限权限,不纳入公开源码包。这里的 a+rX 让目录可遍历、普通源码可读取,没有把所有源码都改成可执行文件。
权限修复后的缓存重建耗时 1 秒,从 Compose 启动到 API 健康耗时 4 秒。这两个数字与之前的 211 秒中止、810 秒联网构建属于不同阶段,不能据此计算“构建提速多少倍”。这次故障更有价值的地方,是把部署验收分清了:镜像是否构建成功、进程是否启动、接口是否可用,以及业务执行是否真正完成,每一步都需要自己的证据。
四、一次测试,怎样留下可追查的执行记录
云端健康接口返回 demo_mode=true、database=postgresql 和 runner_configured=true。演示模式在这里表示数据和业务身份属于演示,并不排斥连接真实执行服务。本轮使用独立 PostgreSQL 演示库和真实 Docker runner;AI 对话仍是界面明确标注的固定引导,没有调用付费模型。
代码运行路径可以拆成四步:API 检查身份与测评阶段,保存本次代码快照;把代码、函数名和输入发送给 runner;runner 在受限容器内执行并返回输出;API 对照自己保留的期望值完成比较,再将结果、代码摘要和执行镜像 ID 写入事件。期望值不发送到执行容器,执行结果与判定依据由不同环节处理。
集成脚本通过正常 API 创建了带演示标识的新测评,随后分别提交正确实现和错误实现。正确实现通过 2 个公开用例,错误实现通过 0 个;两次返回都包含实际执行镜像 ID。重新查询事件,能够读到相应的代码快照、测试结果和摘要。包括重传与冲突检查在内,集成检查共 11 项,全部通过。
其中一个有用的区别是:错误实现仍然得到正常的 HTTP 响应,只是用例未通过。代码结果错误与执行服务不可用应当分别记录,否则研究者以后查看一次失败时,无法判断它反映的是作答表现,还是基础设施出了问题。
执行环境也留下了版本凭据。作业容器使用 Python 3.12.16,执行镜像 ID、digest,以及 PostgreSQL 18 镜像和 API、runner 的运行镜像 ID 都保存在清单中。以后复核结果,可以先确定运行的是哪一个构建,而不只依靠可能指向不同内容的镜像标签。
容器限制还需要实际触发。当前每个作业以非 root 身份运行,关闭网络,根文件系统只读,不挂载主机业务目录,移除 capabilities 并禁止新增权限;内存限制为 128 MiB、CPU 为 0.5、进程数为 32,同时设置超时和输出边界。本轮探针观察到的主要结果如下:
- 正常任务返回
42,主动抛出的异常返回ValueError;无限循环约 8.202 秒后返回TimeLimitExceeded。 - 过量内存分配和大量打印均返回
ExecutionTerminated;超长返回值触发OutputLimitExceeded。 - 网络连接探针得到
OSError、errno 101;向只读根目录写入得到 errno 30。 - 修改输入的任务被标记为
input_unchanged=false;无效鉴权得到 HTTP 401。
隔离检查共 20 项,包含健康、鉴权、9 类探针及各探针后的恢复任务。每个探针后的短任务都成功,最终作业容器列表为空。这说明本轮异常后仍能继续接收任务,并完成了所检查的容器回收;进程扩张等其他边界没有在本轮专项触发。
大量打印与超长返回值的错误类型不同,还暴露出一个需要继续处理的实现细节。当前执行包装程序用StringIO捕获打印内容,内容先积累在容器内存中;网关的有界读取则作用于容器向外输出的数据。因此,超长返回触发了输出限制,大量打印却只观察到执行终止。日志没有采集 OOM 事件,不能进一步确认其终止原因。后续应当在捕获环节限制累计打印量,并补充终止原因的诊断记录,避免只给出一个含义过宽的错误名称。五、停掉 runner,计时和记录还能否保持一致
对于有时间限制的测评,服务故障造成的等待会直接影响过程记录。验证因此没有止于正常运行,还主动停止 runner,检查业务状态如何变化。
runner 停止后,执行请求返回 HTTP 503,测评状态变成paused,故障事件写入数据库。间隔至少 2.2 秒的两次查询中,累计时间都保持为 2 秒。runner 恢复并由管理者接口显式恢复测评后,状态回到active、故障清除,正确代码再次通过 2 个公开用例。准备、故障和恢复三个阶段的检查分别为 6/6、7/7、9/9。
这条恢复路径保留了一个明确的管理动作:执行服务重新启动后,还要确认状态并恢复测评。源码同时显示,API 的运行路径只调用独立 runner,缺失配置或远端调用失败会进入故障处理,没有在 API 宿主机直接执行代码的回退分支。这个判断来自源码与故障记录的共同核对,不能只靠一次 503 响应得出。
请求重试也做了独立检查。同一请求编号携带相同代码再次提交时,接口返回原测试结果;复用编号却改变代码,返回 HTTP 409。事件上传遵循同样的规则:相同内容去重,不同内容冲突,查询只保留一条对应事件。对于后续按事件分析作答过程的系统,重复上传不应被误算成重复操作。本轮确认的是接口行为,真实浏览器断网后的重传仍需要单独验证。
持久化检查则分成重启和恢复两步。API 重启后 5 秒达到健康状态,目标合成会话的 8 条事件仍可读。随后,将 34,707 字节的备份恢复到独立测试库,没有覆盖原库。对重启前、重启后和恢复库的全部 11 张表进行规范化内容摘要比较,三者一致。
只比较表是否存在或行数是否相同,还不足以发现内容变化,所以摘要覆盖反射得到的全部表和列,并对 JSON、时间和行顺序采用确定的规范化方式。验证用临时登录 token 在计算前撤销,避免它成为额外差异;对外记录保留表名、行数和摘要,不导出原始账户行。这里确认的是这份快照经过重启和恢复后的一致性,尚未建立定时备份,也没有测量完整灾难恢复时长。六、并发 4 时,一半请求被拒绝
容量测试直接请求 runner 的执行接口,绕过测评业务 API,以便单独观察执行名额和拒绝行为。任务内部执行sleep(0.25),并发 1、2、4 各运行三轮,共 21 个请求。它是制造短时间占用的探针,没有模拟复杂学生程序或 CPU 密集任务。
并发 1 的 3 个请求全部成功;并发 2 的 6 个请求全部成功;并发 4 的 12 个请求中,6 个成功,6 个收到明确的容量拒绝,没有其他失败。这个结果与 runner 同时最多执行两个作业的实现相符。容量检查 10/10 通过,表示观察满足预设检查条件,其中包括允许并确认容量拒绝,不能把它写成 21 个请求全部执行成功。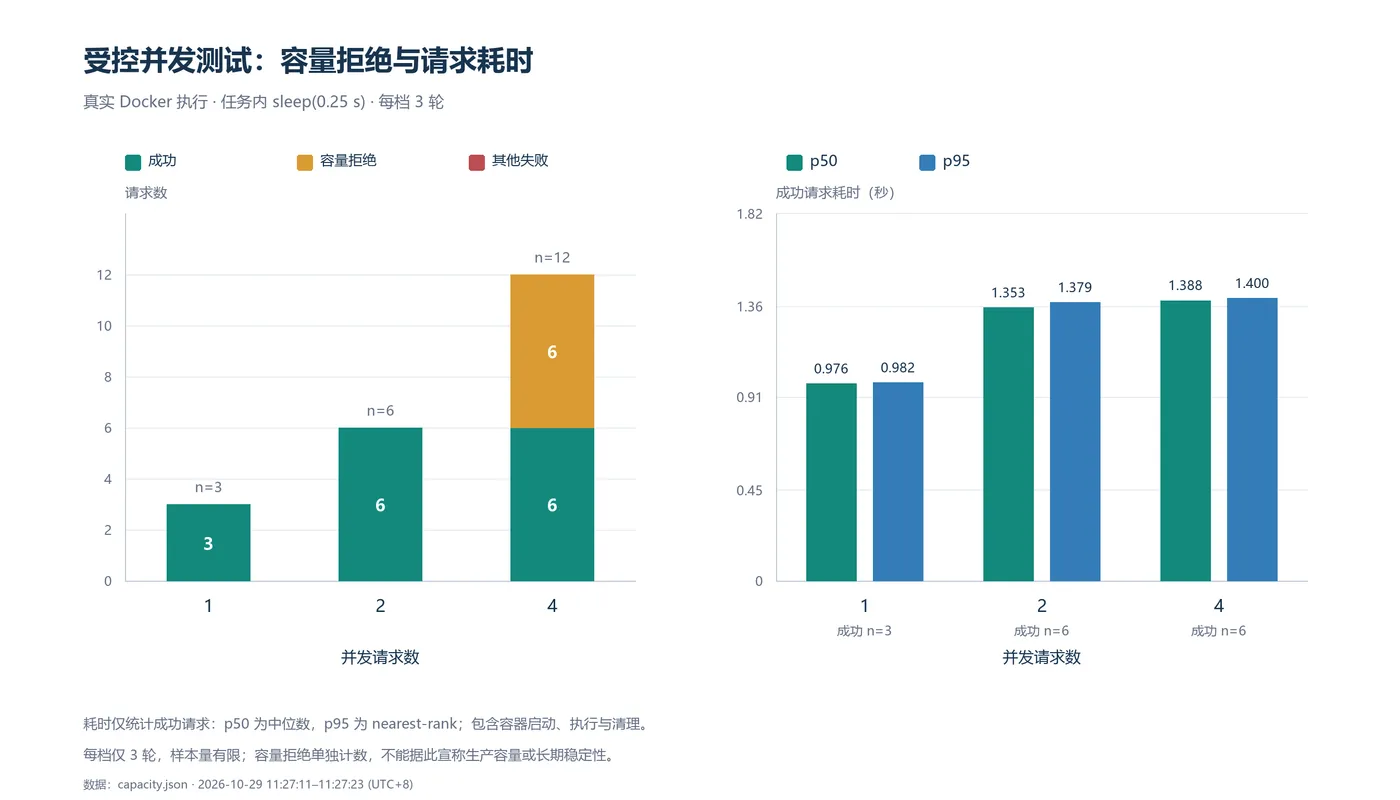
三个档位的成功请求 p50 依次约为 0.976、1.353、1.388 秒,p95 依次约为 0.982、1.379、1.400 秒。p50 使用中位数,p95 使用 nearest-rank;计时包含 HTTP、健康检查、容器启动、执行和清理,只对成功请求计算。拒绝请求单独计数,没有从统计中消失。每档只有三轮,尤其并发 1 只有三个成功样本,这些百分位只能描述本轮观察,不能用于服务等级承诺。
受理成功的请求耗时没有大幅增加,也不能单独解释为“并发能力很好”,因为并发 4 时已有一半请求被挡在执行入口之外。对实际使用者而言,能否得到执行机会、等待多久、失败后如何继续,同样属于体验的一部分。当前结果足以说明容量上限会触发,尚不足以说明它能够顺畅支持多人同时测评。
源码核对还发现了业务层需要补齐的地方:runner 用 HTTP 503 表示容量已满,而 API 的run_remote对非 200 响应统一按执行服务故障处理,随后暂停测评。也就是说,业务层目前尚未区分短暂容量不足和 runner 不可用。这是依据当前代码得出的判断,本轮直接访问 runner 的容量测试没有验证多测评并发时的完整业务表现。
因此,后续改进不能只把并发名额从 2 改成更大的数字。需要先区分容量拒绝与基础设施故障,再设计有界排队、等待提示、超时、取消和重试规则。对带计时的任务,还必须规定等待期间如何计时。这些规则会影响过程数据的解释,应当与前端反馈一起验收。
资源记录也支持继续谨慎设置容量。北京时间 11:26:46 至 11:27:50 的整个工程验收窗口,共留下 18 个采样点,其中 17 个 CPU 差分点有效,采样间隔中位数约 3.767 秒。主机聚合 CPU 的采样峰为 89.104%;按MemTotal−MemAvailable计算的主机内存占用采样峰为 731.410 MiB。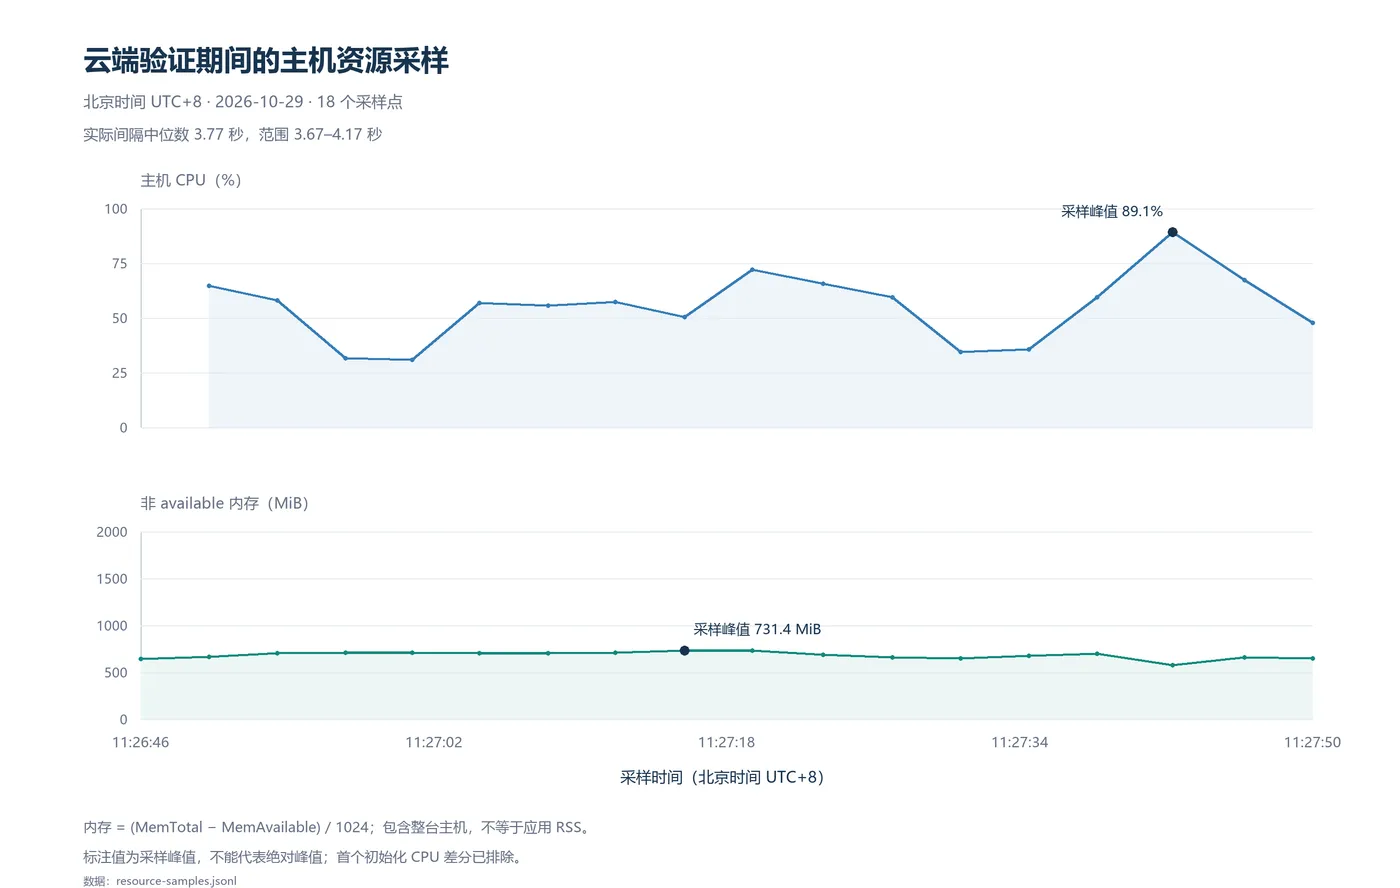
这段窗口包含集成、隔离、容量和可靠性操作,不能把其中的峰值全部归因于并发测试。内存数值覆盖整台主机,并非应用 RSS;采样间隔还包含命令开销,也可能错过更短的尖峰。目前能够据此判断的是:这台实例完成了本轮验收,执行期间出现过较高 CPU 占用。还不能据此推算长期余量或可支持的课堂人数。七、接下来先补哪一环
这次部署让原型的可用范围更清楚了。本地自动测试与云端实测各自回答不同问题:前者检查业务控制逻辑,后者确认真实容器执行、PostgreSQL 写入、故障暂停和快照恢复。权限故障则说明,跨环境交付时,归档权限与运行身份本身就是部署条件,不能等进程启动失败后才把它们当作附带问题。
当前最先要补的是新的浏览器提交及结果反馈验收。已有 SSH 访问和历史记录读取,可以确认访问路径与历史数据可见;还需要从页面发起一次新的运行,逐项核对提交代码、返回结果和事件记录,并观察错误时页面如何提示。接口链路已有证据,这一步将决定使用者能否在界面上完整走通它。
在引入真实参与者前,还需要处理容量拒绝的业务分类和等待规则。下一轮可以保持实例、镜像、短任务和并发档位不变,以多个独立测评会话补测业务 API,再与 runner 直接测试对照;如果加入队列,应分别记录等待、执行、拒绝和恢复,检查事件是否重复、计时是否符合规则。先把这一层行为说明白,才有依据判断是否需要把执行服务迁到独立主机。
费用也按已有记录表述:本次操作没有新增云资源购买,没有新增付费模型调用。已有服务器仍存在购买、续费和带宽等成本,本轮没有审计既有账单,因此不报告总成本为零,不计算单次执行成本或节省比例。本实例也没有被验证为活动推荐的 u2a 或 AMD Turin,文章不引用宣传页的性能提升数字。
最后,Coding Atlas 仍是研究原型。演示账号、评分和过程材料均为合成数据;这次验证没有真实专家、参与者或模型效果数据,也没有覆盖长期稳定性和全部对抗性隔离边界。正式研究仍需要专家检查、预试、知情安排和统一模型配置。当前这台 2 核 2 GiB 实例已经把一段原先依赖本地演示的执行流程变成了可核对的工程记录;下一步要解决的,是让这些运行记录与使用者实际经历的等待、故障和恢复过程对应起来。
本文依据 2026 年 10 月 29 日保存的项目与验收记录编写,文中时间均为北京时间。正文图表保留了实际样本量和统计口径;部署凭据、原始数据库与非公开研究材料未作为公开附件上传。



