
1.项目背景:为什么开发AI代码审查工具?
在参与GitHub开源项目的过程中,写代码变得越来越简单,提交代码只是其中一个环节,尤其是在vibecoding时代。如何判断代码修改是否合理、是否会引入新的问题,同样值得关注。尤其是在一些结构较为复杂的项目中,一次PR可能只修改了几行代码,但这些修改可能涉及其他模块的调用关系,单纯阅读代码差异不一定能发现潜在问题。目前,大模型已经具备一定的代码理解能力,可以辅助开发者分析修改内容,提出修改建议。不过,直接将代码差异交给大模型也存在局限:模型可能不了解项目的实际依赖和上下文,将正常的代码行为误判为缺陷。
基于这些考虑,我尝试开发了PRGuard AI,希望将GitHub PR信息获取、规则检查和大模型分析结合起来,为代码审查提供参考。同时,我也希望通过实际项目验证,大模型在代码审查场景中究竟能发挥多大作用,又存在哪些不足。
2. 技术方案:PRGuard AI 的功能与技术架构
本项目并非项目是训练一个专用代码审查模型,而是构建一个结合代码静态分析与大模型推理的辅助审查应用。用户只需要输入公开的PR链接,系统就会自动获取修改文件和代码差异,结合项目的上下文、静态规则检查与大模型分析,最终生成包含风险说明、代码位置和修改建议的审查报告。项目整体采用Python开发,使用Streamlit构建Web界面,避免了单独开发前后端带来的额外工作量。在代码分析方面,系统首先通过GitHub API获取PR信息,再根据修改内容读取部分关联源码和项目依赖信息,为模型提供更多上下文。随后,调用阿里云百炼平台的qwen模型进行分析,并对模型返回的文件路径、修改行号和代码引用进行校验,尽量减少缺乏代码依据的判断。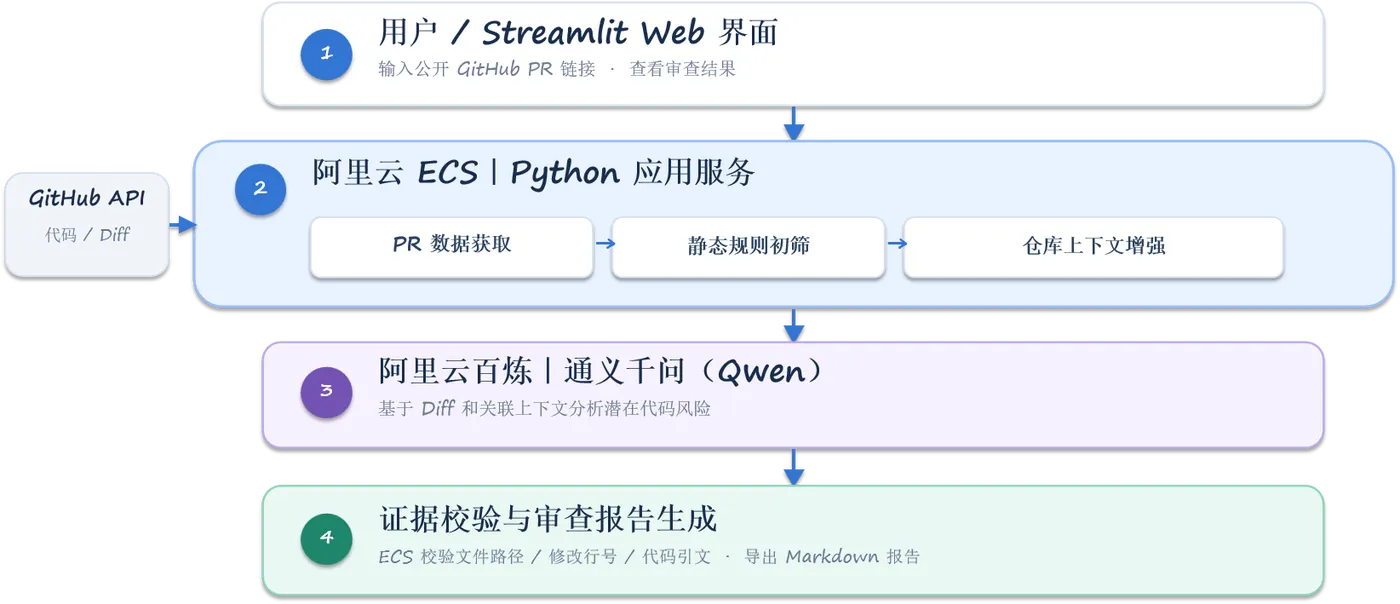
在云端部署方面,本项目使用阿里云ECS作为应用运行环境,通过Python虚拟环境管理依赖,并利用systemd管理后台服务。ECS主要负责运行应用和处理请求,模型计算则由百炼平台完成,整体架构相对简单,也更适合当前项目的开发与部署需求。
需要说明的是,PRGuard AI 的定位是辅助审查工具。它能够提供潜在问题及相关依据,但不能保证所有判断都正确,最终仍需要开发者结合实际代码进行确认。
3. 核心实现:从代码差异到证据约束审查
PRGuard的核心功能是对GitHub PR的代码修改进行分析,并生成相应的风险提示。实现过程中,我将整个审查流程划分为三个阶段:首先获取代码差异并进行规则检查,然后结合仓库上下文调用大模型分析,最后校验模型输出的代码依据,生成审查报告。
3.1 PR信息获取与规则初筛
系统通过 GitHub REST API 获取 PR 的基本信息和代码差异,包括修改文件、增删行数及具体修改内容,避免分析整个仓库。在获取数据后,程序先进行简单的静态规则检查,重点关注权限控制、依赖配置及潜在危险操作等修改。这些检查主要用于提示可能存在的风险,并不代表代码一定存在问题。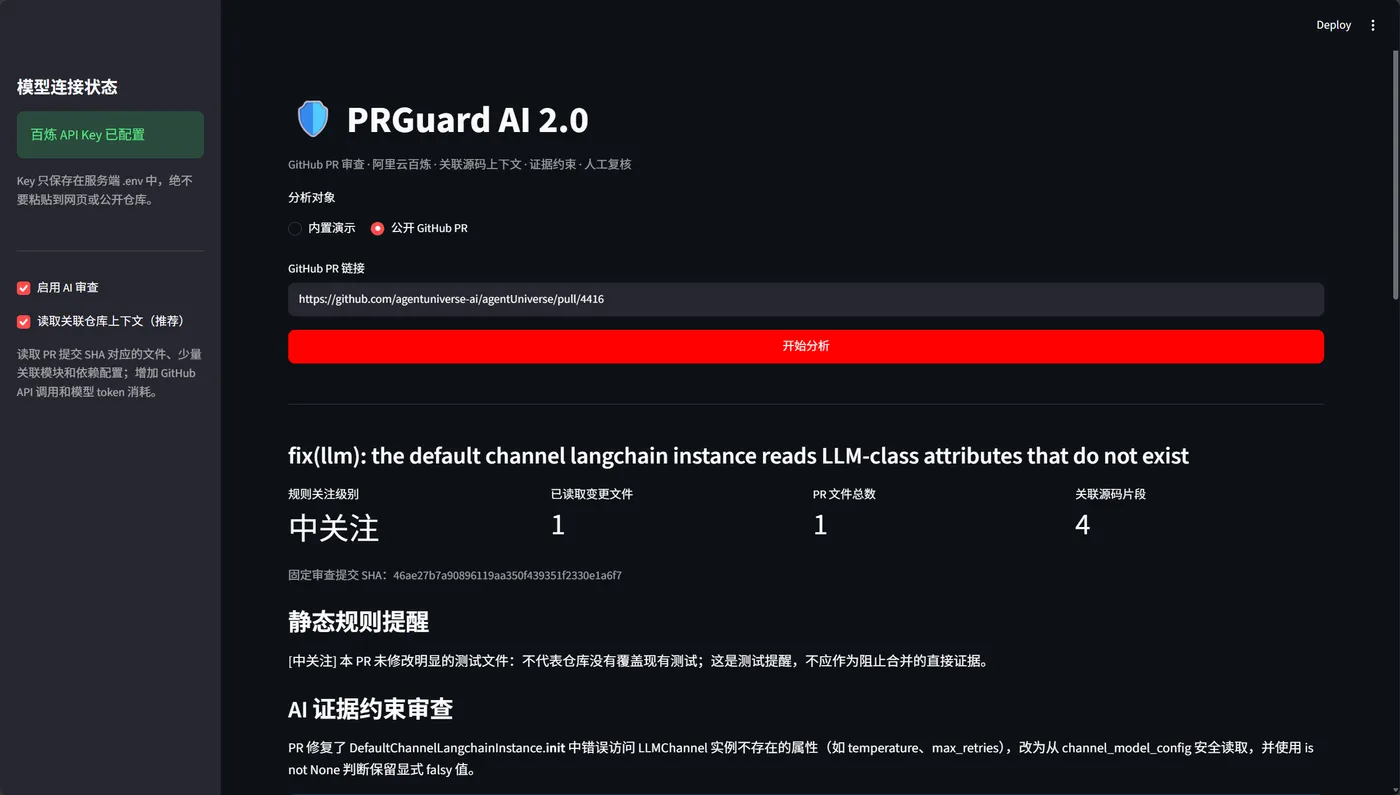
3.2 仓库上下文增强与百炼模型分析
v1的实现主要将PR的代码差异提交给大模型分析。但在实际测试中,我发现仅凭Diff有时难以判断修改是否合理。例如,一个参数传入None是否会引起异常,往往取决于它所调用的函数以及实际使用的依赖版本。
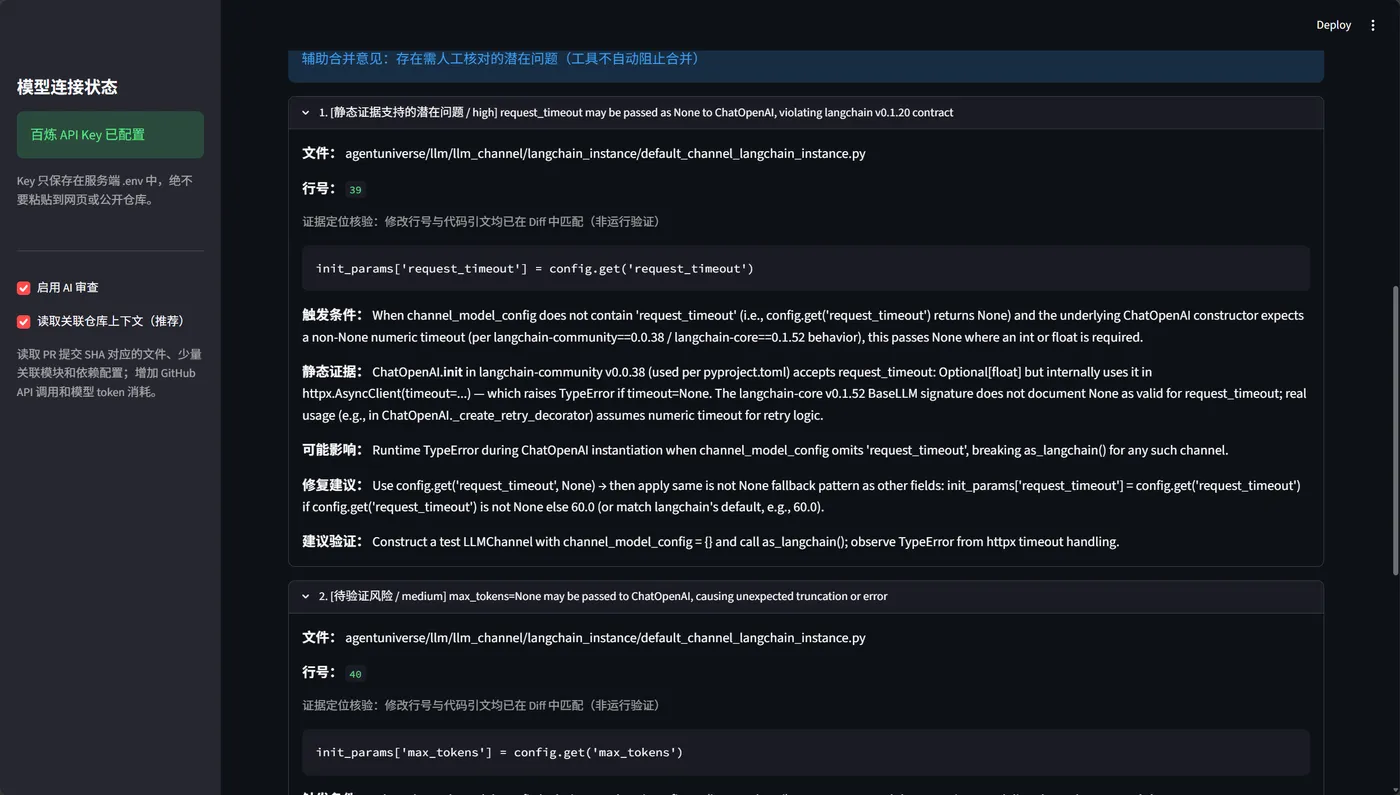
因此,在v2.0版本中,我增加了仓库上下文读取功能。程序使用PR对应的提交SHA获取修改后的相关源码,并尝试读取关联模块和pyproject.toml、requirements.txt等依赖配置文件。为了控制GitHub API请求量和模型输入长度,读取的文件数量及内容长度都设置了限制。随后,系统将代码差异、规则检查结果和获取到的上下文组织成模型输入,通过OpenAI兼容接口调用阿里云百炼提供的通义千问模型。与直接要求模型自由生成审查意见不同,这里要求模型以JSON格式返回结果,包括问题类型、风险等级、文件路径、修改行号、触发条件、代码依据和验证建议。对于缺少充分证据的问题,要求模型将其标记为待验证风险,而不是直接认定为 Bug。
3.3 证据校验与审查报告生成
由于大模型生成的分析结果可能存在偏差,系统会进一步校验其引用的文件路径、修改行号和代码内容是否与 PR的实际的Diff一致。对无法匹配的结果,系统会将其标记为“待验证风险”,避免直接认定为代码缺陷。
最后,系统将风险摘要、具体问题、代码依据和修改建议整理成可下载的.md文件。需要注意的是,静态校验只能确认代码引用是否准确,不能证明问题实际存在,最终仍需人工判断。
line_matched = line is not None and line in added_text

quote_matched = bool(
    line_matched
    and quote_text
    and quote_text in added_text[line]
)
4. 阿里云 ECS 部署实践
为了让PRGuard AI不再依赖本地电脑运行,我选择使用阿里云ECS部署项目。服务器采用Ubuntu 22.04 系统,主要负责运行Streamlit网页、处理GitHub PR数据以及调用阿里云百炼API。由于大模型推理在百炼平台完成,因此不需要额外配置GPU。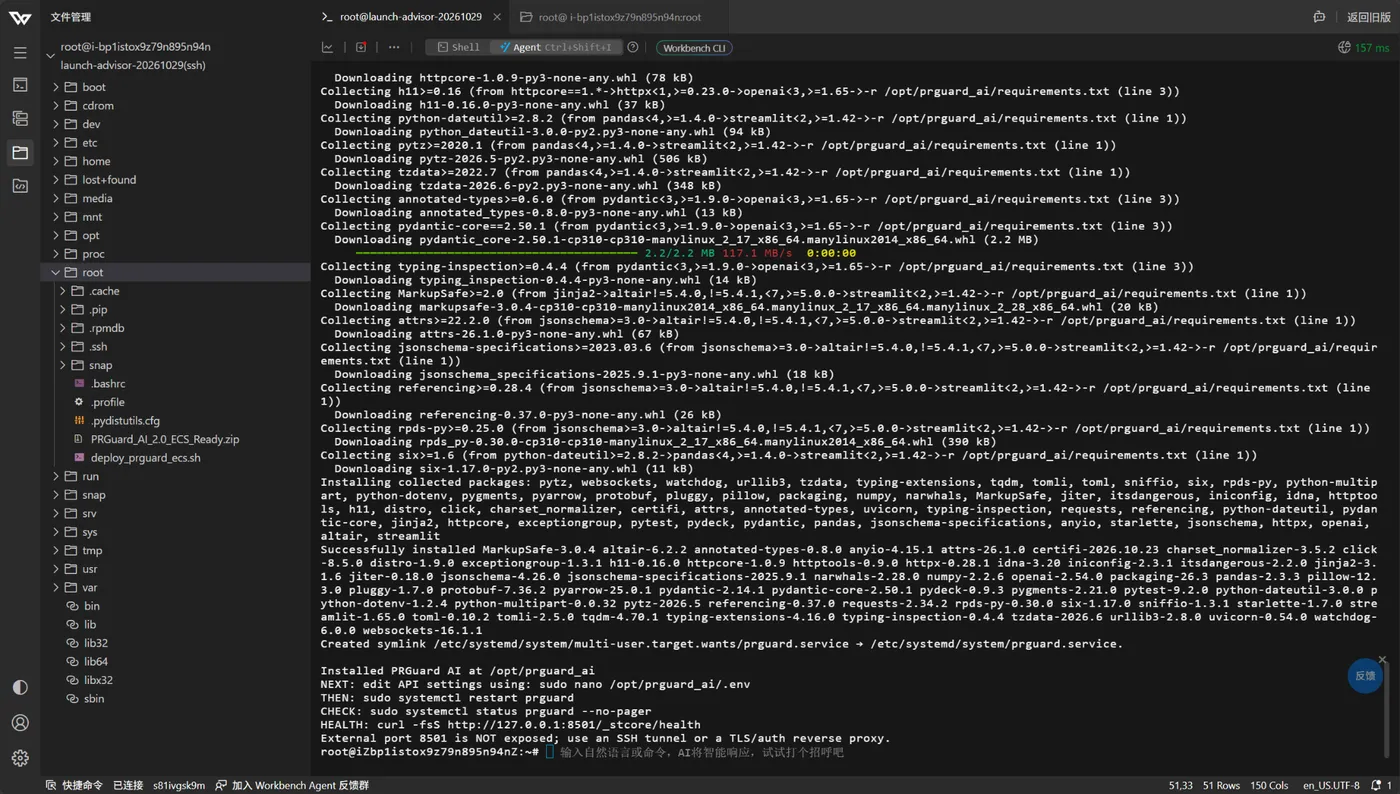
部署时,首先通过阿里云Workbench连接服务器,将项目源码和部署脚本上传至ECS。随后安装Python 环境及相关依赖,并将项目部署到/opt/prguard_ai目录。为了方便管理,使用systemd注册prguard.service,使应用能够作为后台服务运行。实际使用下来,我觉得阿里云ECS的部署过程比较方便。通过控制台提供的Workbench工具,可以直接在浏览器中连接服务器,无需额外安装远程管理软件。尤其是文件传输功能,可以通过可视化界面直接上传项目压缩包和部署脚本,不需要单独配置FTP服务,操作起来比较直观。整个过程与在普通Linux环境中运行Python项目基本一致,上手难度不高。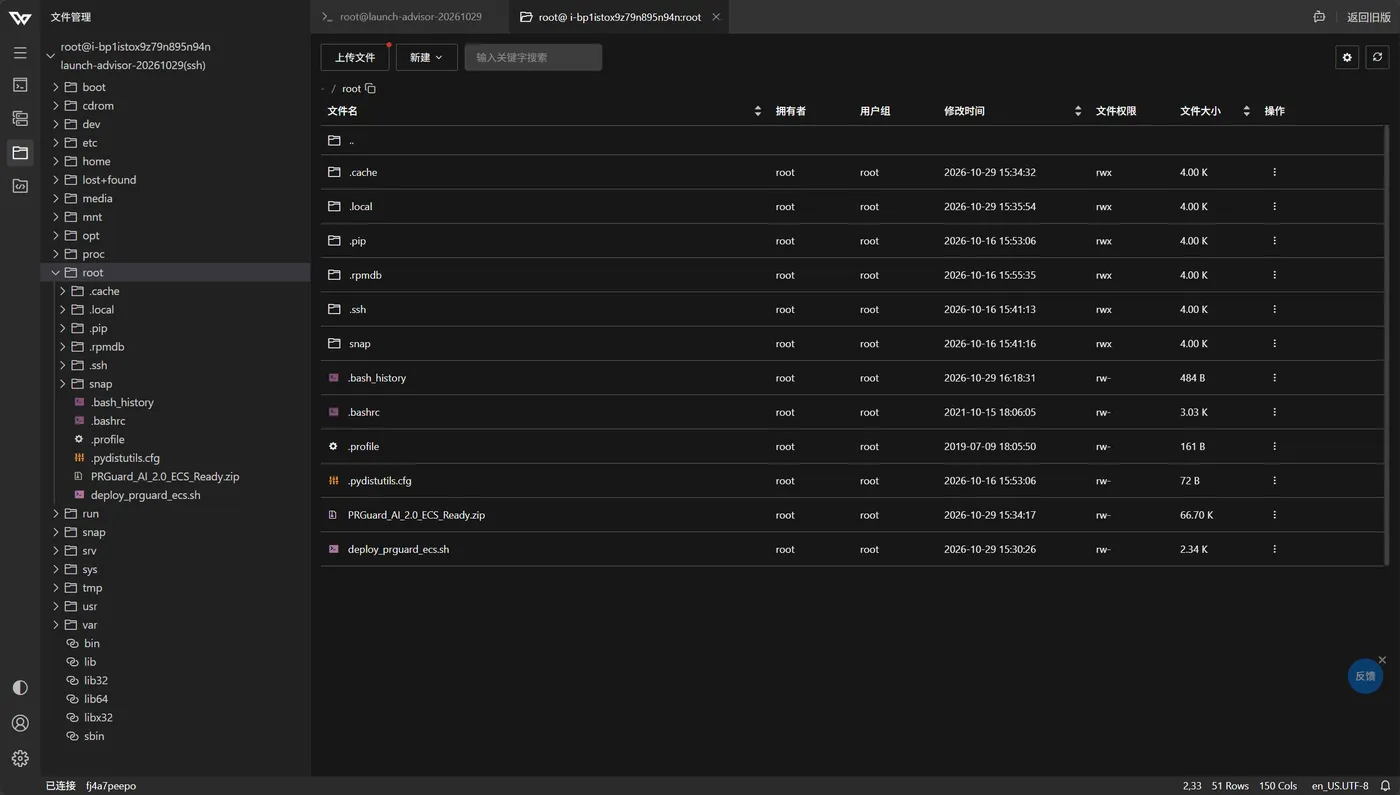
实际部署过程中也遇到了一些问题。第一次执行脚本时,由于ZIP压缩包的目录结构与脚本预期不一致,导致部署中断。检查报错并重新上传正确的项目压缩包后,成功完成依赖安装和服务注册。总体来说,还是比较顺利的。
总体而言,ECS提供了比较灵活的运行环境,Workbench也简化了远程管理和文件传输过程。对于PRGuard AI这样的轻量级的AI应用,将ECS与百炼大模型服务结合使用,既能满足应用运行需求,也避免了自行部署大模型带来的额外工作量。
5. 实际案例:agentUniverse PR#4416审查
为了验证PRGuard AI的实际效果,我选择了开源项目agentUniverse的PR #4416进行测试。该PR主要修复了LangChain适配过程中访问不存在属性的问题,同时调整了部分参数的默认值处理逻辑。
在v1.0版测试中,系统成功获取了PR的代码差异,并通过阿里云百炼生成审查报告。模型指出了request_timeout、max_tokens 等参数可能存在的兼容性风险,但部分判断缺乏充分依据,甚至给出了“不建议直接合并”的结论。这说明仅依靠代码差异进行分析,容易受到上下文不足的影响。
针对这一问题,我在v2.0版本中加入了仓库上下文读取和代码证据校验功能。再次分析同一个PR时,系统能够提供具体的文件路径、修改行号和代码引用,并将无法充分确认的问题标记为待验证风险,不再直接建议阻止合并。
以下是初版下载下来的md文件中ai审查结果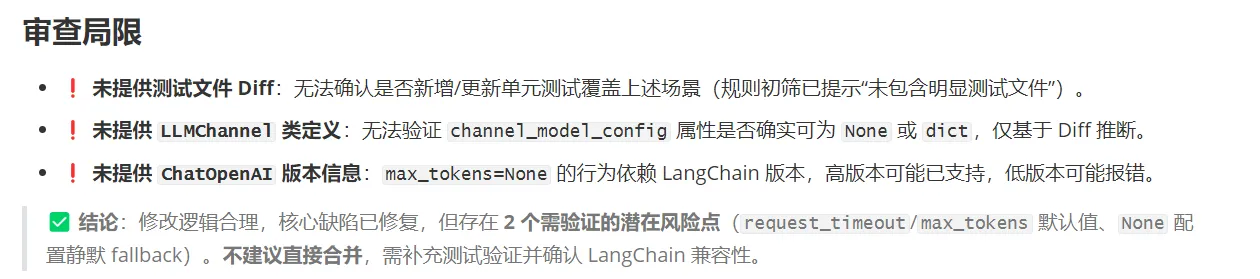
以下是v2版本中ai审查的结果。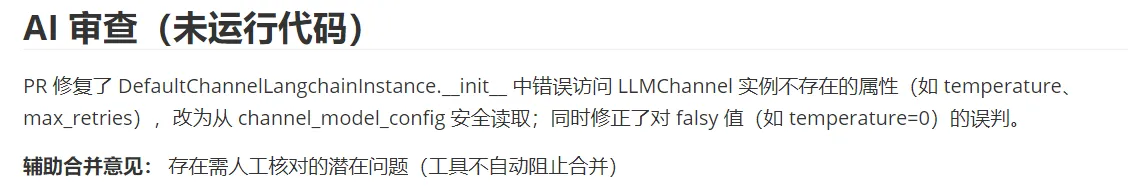
6. 实践结果与云产品价值
通过本次实践,PRGuard AI已经实现了GitHub PR信息获取、静态规则检查、大模型辅助分析以及审查报告生成等功能。在agentUniverse的真实PR测试中,系统能够定位代码修改位置,给出潜在风险及验证建议。虽然模型仍存在一定的误报问题,但基本完成了预期的辅助代码审查功能。
在云产品使用方面,阿里云ECS为项目提供了独立的Linux运行环境,Workbench的远程管理和文件传输功能也简化了部署操作。同时,借助阿里云百炼API,项目无需在服务器上部署大模型,就能够使用通义千问的代码分析能力。这种方式将应用运行与模型推理分离,降低了对服务器硬件配置的要求。
总体来看,ECS与百炼的结合为轻量级AI应用提供了一种相对简单的实现方案。不过,目前项目主要完成了功能验证,尚未开展大规模PR测试和性能评估,后续还需要进一步验证审查准确性、响应时间和实际使用成本。



