面试 HDFS 时,"三副本是怎么放的"几乎必问。很多人答得出"放三台机器",但答不出"为什么第一副本放本地、第二副本跨机架、第三副本又回到那个机架"。这个顺序不是随便排的,它是 HDFS 在机架故障域和集群网络带宽之间做的一次精确权衡。
这篇把 HDFS 默认副本放置策略(Replica Placement)讲透:每个副本落在哪、为什么这么落、机架感知怎么配、运维时又该怎么调。
30 秒心智模型
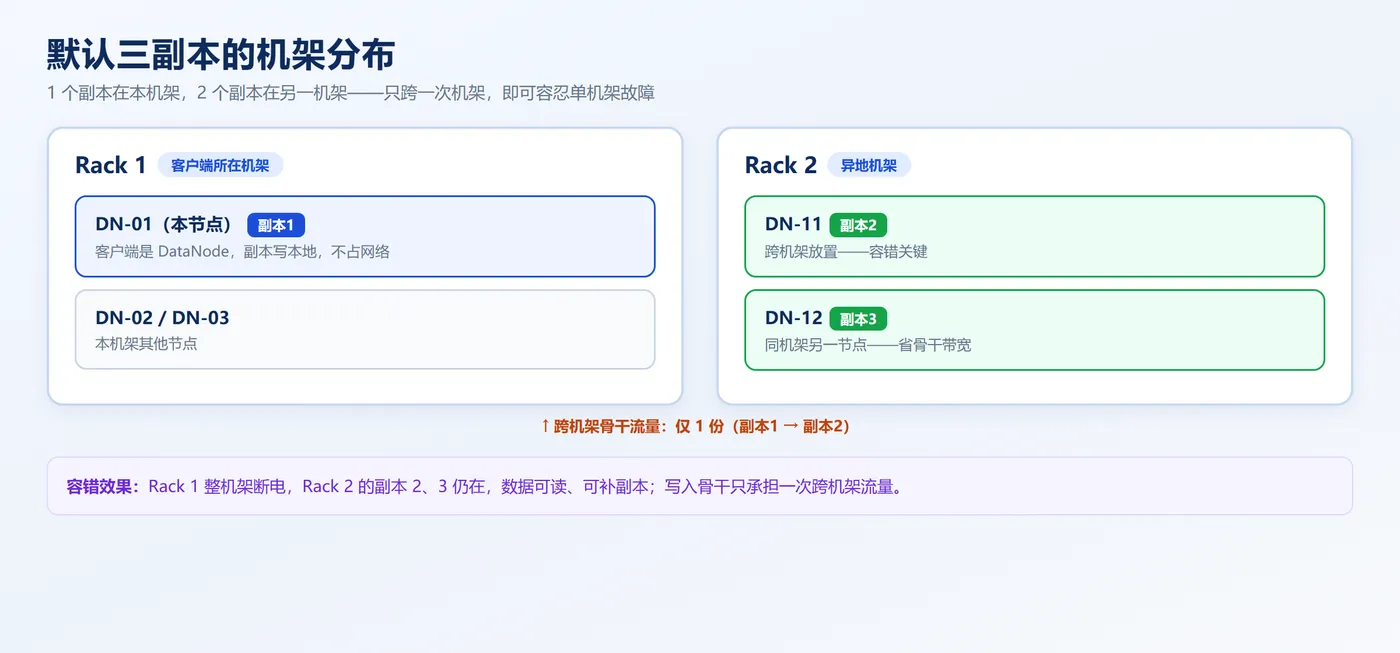
默认每个 Block 3 个副本(dfs.replication=3),放置规则一句话记:
- 第一副本:写数据的客户端所在 DataNode(集群外上传则挑一台磁盘不满、CPU 不忙的节点);
- 第二副本:放到与第一副本不同机架的某个节点;
- 第三副本:再放到与第二副本同一个机架的另一个节点;
- 超过 3 副本:随机挑节点,尽量分散。
最终形态是:1 个副本在本机架,2 个副本在另一个机架。既扛得住整个机架断电,又只付一次跨机架带宽。
一、为什么不把三个副本分散到三个机架
直觉上,三个副本各放一个机架,容错是不是最强?其实不是。
机架(Rack)是 HDFS 眼里最小的"故障域"。一个机架共享一台交换机、一路供电、一套网络,整机架掉电、交换机故障、网线被拔,都意味着这个机架上所有节点同时不可用。HDFS 要保证的是:任意一个机架整体故障,数据不能丢。
那三副本放三个机架行不行?技术上能扛住单机架故障,但代价是每个 Block 写入都要跨三次机架网络。机架之间的骨干带宽是整个集群最稀缺的资源,而机架内部带宽通常充裕得多。三副本跨三机架,等于每个块都要在骨干网上跑三份副本流量,写入吞吐直接被骨干网卡死。
HDFS 的取舍是:用两个副本压在另一个机架,只跨一次机架。
二、逐个副本拆解:每一步都在算账
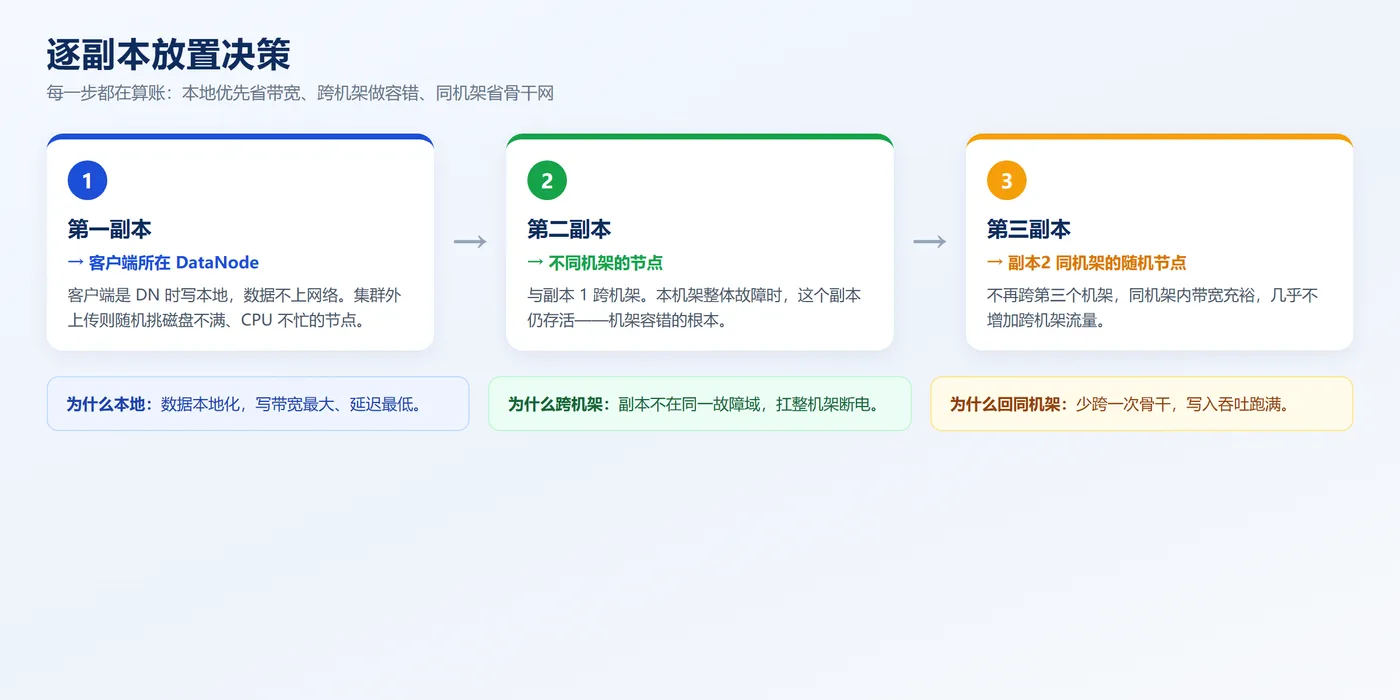
第一副本为什么放本地? 如果客户端本身就是一台 DataNode(生产上常见,计算节点和存储节点混部),把第一个副本写在本地,数据根本不用上网络,写带宽最大、延迟最低。这背后是 HDFS 一贯的"计算向数据移动"思路——既然要存,就尽量存在计算发生的地方。如果客户端不在集群内(比如从外网上传),就退而求其次,挑一台磁盘不太满、负载不太忙的节点,避免把热点压到某几台机器上。
第二副本为什么必须跨机架? 这是容错的关键。第一副本在本机架,万一这个机架整体挂了,本机架上其他副本也一起没。第二副本放到别的机架,就保证了"本机架全灭"时还有副本活着——这是 3 副本能容忍单机架故障的根本原因。
第三副本为什么回到第二副本那个机架? 这一步最反直觉。第二副本已经在另一个机架了,第三副本为什么不继续挑第三个机架?因为再跨一次机架就要多走一次骨干网。把第三副本放在第二副本同机架的另一台机器上,同机架内带宽充裕,几乎不增加跨机架流量;同时这个机架内有了 2 个副本,分布也足够散。
这个顺序在写入管线里是真实存在的:客户端写出的数据先到第一副本所在 DataNode,再由它把数据包沿管线转发给第二副本、第三副本,形成一条 DN1 → DN2 → DN3 的复制流。副本放得越远,这条管线里跨机架的"跳数"越多,每一跳都在吃骨干带宽。默认策略把跨机架跳数压到 1,写吞吐才能跑满。
三、机架感知:HDFS 怎么知道哪台机器在哪个机架
副本策略里反复出现"机架",那 NameNode 怎么知道 DataNode A 和 DataNode B 是不是同一个机架?这靠机架感知(Rack Awareness)配置。
生产集群通常在 hdfs-site.xml 指定一个拓扑脚本或配置文件,把每个 DataNode 的 IP/主机名映射成一个 rack 路径,形如 /rack1、/rack2:
<!-- 告诉 NameNode 如何解析节点所属机架 -->
<property>
  <name>net.topology.script.file.name</name>
  <value>/etc/hadoop/conf/rack-topology.sh</value>
</property>
脚本对每个 DataNode 返回类似 /rack1 的字符串。NameNode 据此维护一张"节点 → 机架"的映射,写副本时按上面的规则挑节点。如果不配机架感知,NameNode 会把所有节点都当成同一个机架——此时"跨机架副本"退化成"另一个节点",机架级容错形同虚设。这是很多小集群"副本放了 3 份却一断网全挂"的根因。
四、容错与带宽:这是一场刻意的妥协
把三副本策略放到一张权衡图上看就很清楚了:
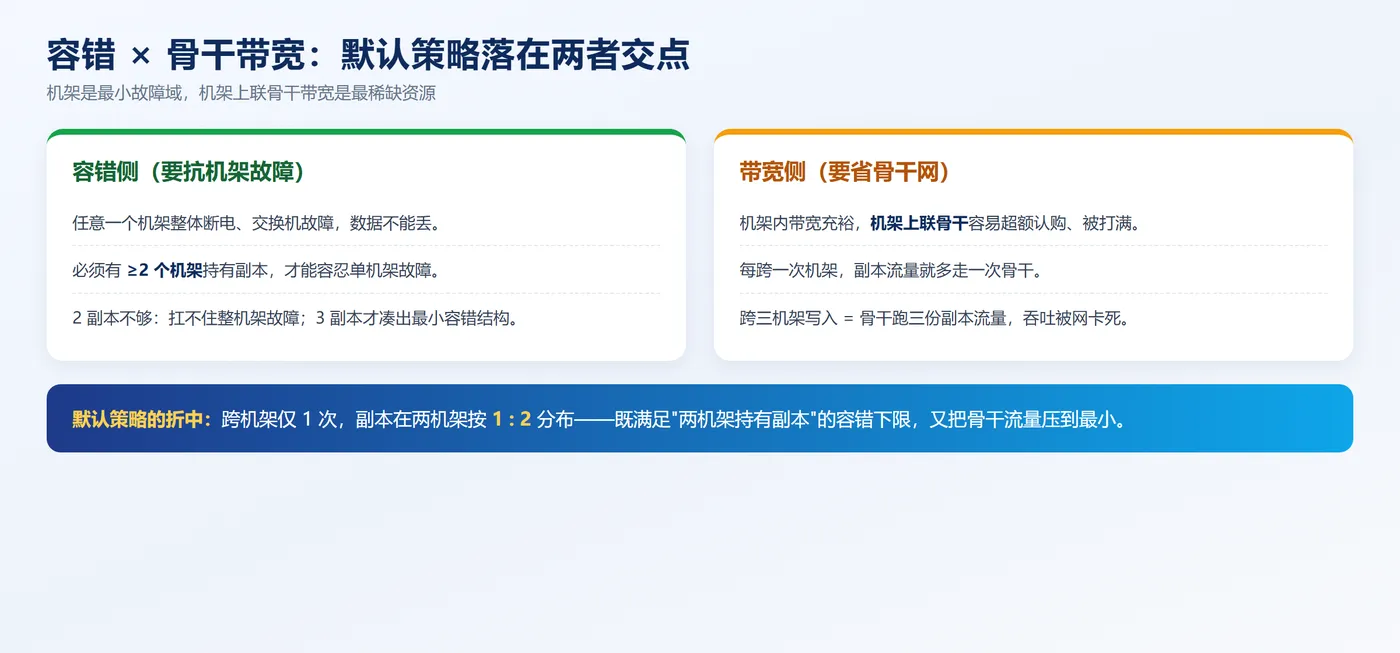
- 容错侧:必须有至少 2 个机架持有副本,才能扛住任意一个机架整体故障;
- 带宽侧:跨机架次数越少,骨干网压力越小,写入吞吐越高;
- 默认策略恰好落在两者交点:跨机架 1 次,两个机架各持副本数 1:2。
这也是为什么 HDFS 官方默认副本数是 3 而不是 2:2 个副本只能放一个机架(或跨机架 1 次但无冗余),扛不住机架故障;3 个副本才凑出"本机架 1 + 异地机架 2"的最小容错结构。
生产上还有个现实约束叫机架带宽超额认购(oversubscription):一个机架内部每台机器有万兆口,但整个机架上联到核心交换机的骨干带宽往往只有几十 G。机架内几十台机器同时往外传数据,骨干很容易打满。HDFS 默认把 2 个副本留在同一机架,就是尽量让副本之间的复制流量在机架内部消化,不挤占上联带宽。如果硬要三副本跨三机架,每个块都多走一次上联,骨干在大批量写入和补副本时会迅速成为瓶颈。
举个具体例子:一个 6 节点集群、两个机架各 3 台,默认策略下某个 Block 的 3 个副本落在「本机架 1 台 + 另一个机架 2 台」。即使本机架整机架断电,另一个机架上的 2 个副本仍在,数据可读、可补副本;而写入时这块只跨了一次机架,骨干只承担一份跨机架流量。
五、常见误区
- 误区一:三副本均匀分布在三个机架。 默认不是。默认是 1 个本机架 + 2 个另一机架,只为扛单机架故障。
- 误区二:配了
dfs.replication=3就有机架容错。 没有机架感知配置,所有节点被视为同一机架,跨机架规则失效。 - 误区三:副本放哪是固定不变的。 写入时按策略选;节点宕机后 NameNode 会在剩余节点上自动补副本, placement 会动态调整。
- 误区四:客户端永远是 DataNode。 集群外上传时第一副本随机选低负载节点,不存在"本地"一说。
查看某文件各副本的实际机架与节点:
# 列出文件的 block、所在 DataNode 与机架信息
hdfs fsck /path/to/file -files -blocks -locations
调整副本数(只影响后续复制,不改老块的放置规则):
hdfs dfs -setrep -w 3 /path/to/file
写在最后
HDFS 的三副本放置策略,本质上是把"机架"这个物理故障域变成了调度输入:第一副本本地是为了省带宽、提写速,第二副本跨机架是为了容错,第三副本回到该机架是为了在容错和骨干网之间踩下刹车。它不是一组死板的规则,而是一条可以推导出来的工程结论——你把"故障域在哪、带宽贵在哪"想清楚,这套放置顺序自己就长出来了。
运维时记住一件事:副本数决定"存几份",机架感知决定"放得对不对"。只调副本数不配 rack 拓扑,三副本也只是三份堆在一个机架里的数据。