9.1 给推理端点加了
none分块策略,作用是关掉自动分块。这条改动本身很小——枚举里多一个值;但它回答了一个此前没有标准答案的问题:如果文本本来就不该切,怎么办?
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.1.0.yml、semantic-text.md、ChunkingStrategy.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
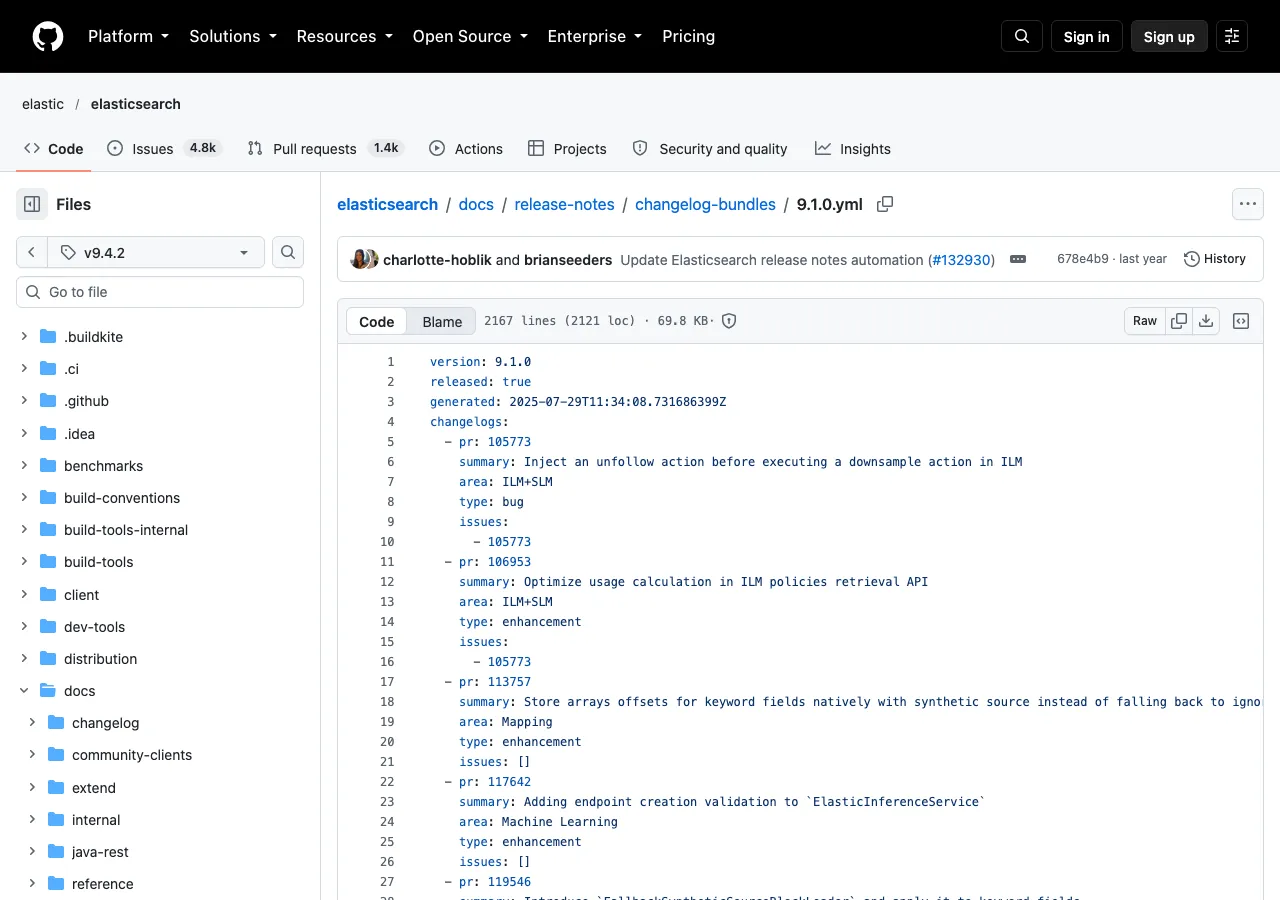
图 1:官方文件 9.1.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.1.0.yml
官方条目
9.1 的 changelog 标为 feature(9.1.0.yml 第 1837–1840 行 @ v9.4.2),area: Machine Learning,PR 129150。
照例只有一行 summary,没有 details。所以本文的实质内容来自文档和源码。
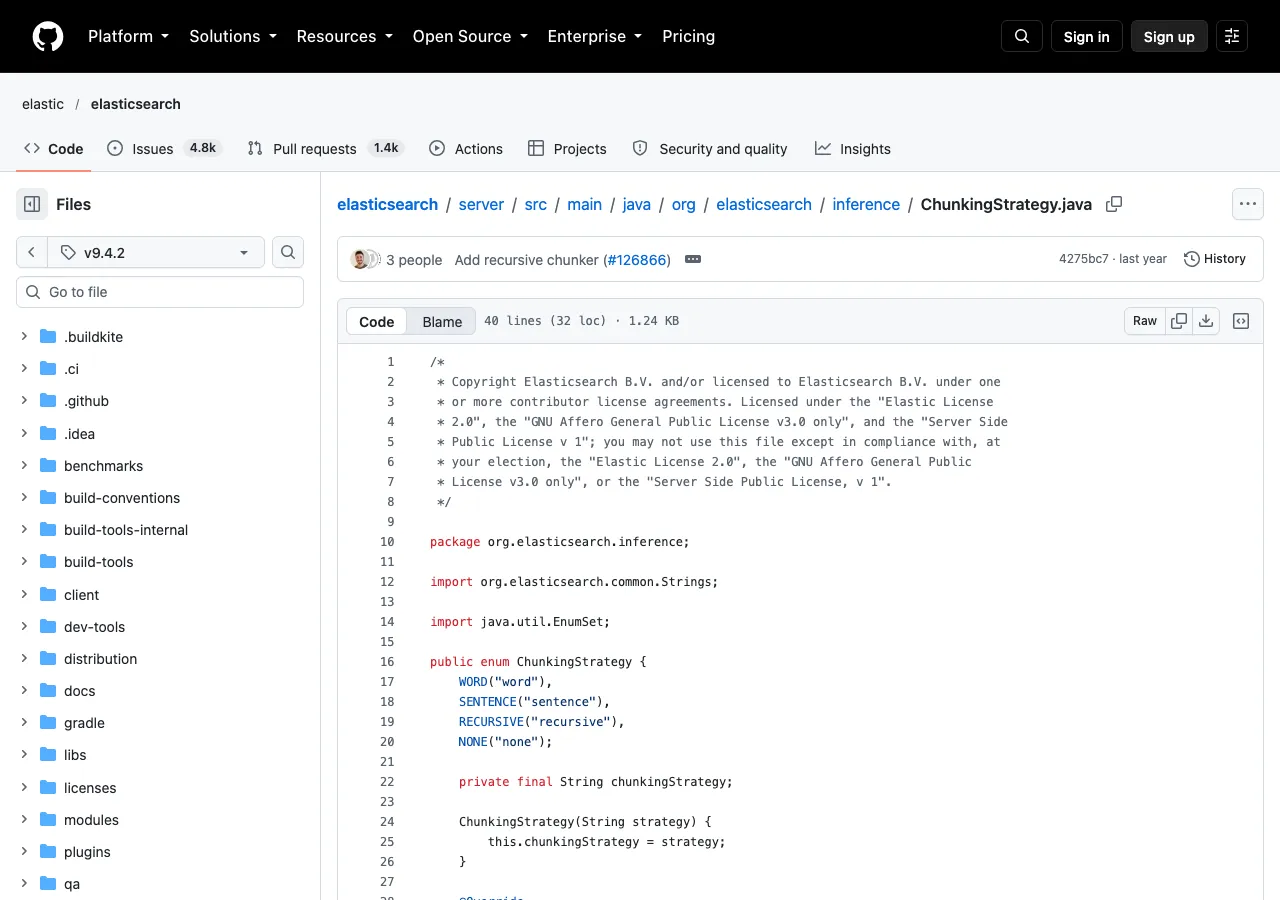
图 2:官方文件 ChunkingStrategy.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 ChunkingStrategy.java
先说分块是什么
semantic_text 字段有个自动化行为(semantic-text.md @ v9.4.2):
Handles chunking: Automatically chunks long text documents during indexing.
长文本在写入时会被自动切成若干块,每块分别生成向量。
为什么要切:嵌入模型有输入长度上限。一篇文章几万字,超出模型的上下文窗口,不切块直接输入会被截断,导致后面的内容完全没被表示。切块之后每块都在限制内,各自有向量,检索时按块匹配。
官方文档里给的分块配置示例长这样:
"chunking_settings": {

  "strategy": "word",
  "max_chunk_size": 120,
  "overlap": 40
}
三个参数:策略(按词切)、每块上限(120 词)、重叠(40 词)。
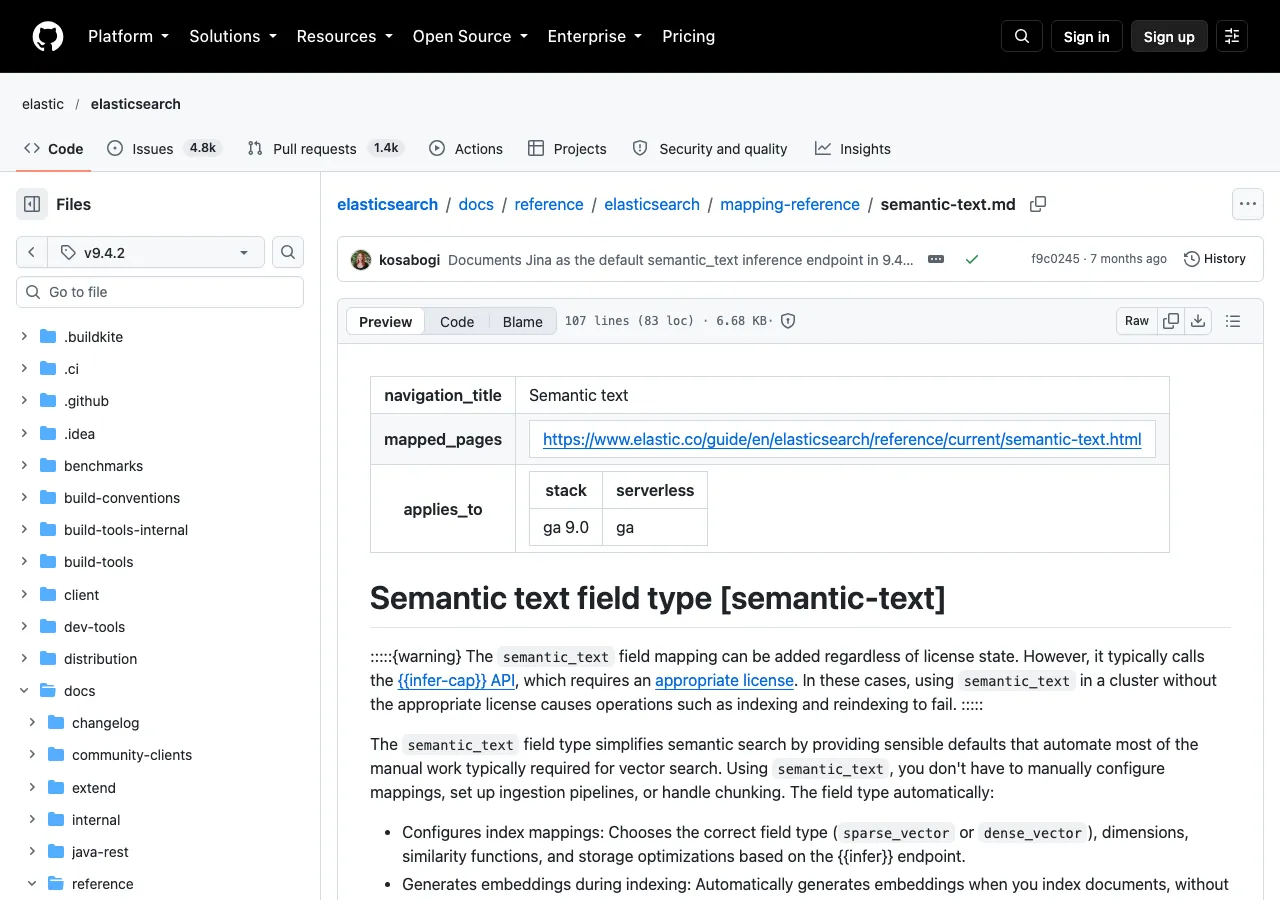
图 3:官方文件 semantic-text.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 semantic-text.md
none 是什么
9.1 之后,策略枚举变成四个(ChunkingStrategy.java 第 17–20 行 @ v9.4.2):
public enum ChunkingStrategy {

    WORD("word"),
    SENTENCE("sentence"),
    RECURSIVE("recursive"),
    NONE("none");
none 就是不切。整段文本作为一个整体送进模型。
为什么要能关掉
看源码时觉得这个设计挺直接的:自动分块是个默认假设,但假设总有反例。
适合关掉的情况,能想到三类:
一,文本本来就短。 商品标题、人名、标签、短问答——这些本来就在模型限制内,切了反而有害。强行切会把"一个完整语义单元"拆成几块,每块的向量都只表达了部分含义。
二,文本有结构且你不希望切开。 比如一段代码、一条 SQL、一个 JSON。按词或按句切会破坏语法结构,切出来的块本身没有意义。
三,你上游已经分好了。 有些场景文档在写入前就按业务规则切过了(按章节、按段落),每个文档已经是一个合适的粒度。这时再让 ES 自动切一次,等于在已经合理的切分上又切了一刀。
第三类是实际中最常见的——分块的责任在谁那里,应该只有一个。
none 的实现细节
NoneChunkingSettings 这个类很短,但有几处写得很明确(NoneChunkingSettings.java @ v9.4.2)。
只认一个键
第 30 行:
private static final Set<String> VALID_KEYS = Set.of(ChunkingSettingsOptions.STRATEGY.toString());
none 策略下,chunking_settings 里只接受 strategy 一个键。 其他任何键都会报错,文案在第 76 行:
When chunking is disabled (none), settings can not have the following: ...
这条报错很实在。因为「关掉分块」和「配置分块参数」是互斥的——你既然说不切,那 max_chunk_size、overlap 就没有意义了。ES 选择直接拒绝而不是忽略。
这个选择合理。前面写 _source mode 设置迁移(_source.mode)、discovery-ec2 换 SDK v2(discovery.ec2.protocol)时都说过一类问题:配置被静默忽略。这里 ES 没有走那条路——配错了立刻告诉你,不留隐患。
maxChunkSize() 返回 null
第 42 行开始:
@Override
public Integer maxChunkSize() {

    return null;
}
没有块大小,因为根本没有块。这说明 maxChunkSize 的返回类型是 Integer 而不是 int——为的就是能表达"不存在"。类型设计上留了口子。
序列化是空的
第 62 行:
@Override
public void writeTo(StreamOutput out) throws IOException {
   }
空实现,什么都不写。 因为没有需要传输的配置内容——只有一个策略名已经在外层处理了。
有 transport version 限制
第 32 行:
private static final TransportVersion NONE_CHUNKING_STRATEGY = TransportVersion.fromName("none_chunking_strategy");
配合第 55 行左右的 supportsVersion,意思是只有支持这个 transport version 的节点才认得 none。
这条的实操含义:混合版本集群里,如果还有老节点不认识 none,配置传过去会有问题。所以我的建议是:滚动升级期间不要急着切换策略,等全集群升完再用。
怎么配
按文档里的 chunking_settings 结构,none 的写法就是只给策略:
"chunking_settings": {

  "strategy": "none"
}
注意不要带 max_chunk_size 或 overlap —— 前面说了,带了会直接报错。
切了会怎样
这里要分清两件事:关掉分块不解决超长文本的问题。
如果文本超过模型输入上限,且你设了 none,会发生什么?源码层面看不出来,文档也没写,所以不猜——但逻辑上有两种可能:
- 模型侧截断(后面的内容丢失,但不报错);
- ES 侧报错。
这点未实测,也不打算推测。 如果你要关分块,前提应该是确认自己的文本不会超限。这也是为什么前面把"文本本来就短"列为最适合的场景——那种情况下根本不用担心。
如果你不确定文本长度分布,建议先统计一下再决定。这个检查很便宜,比事后排查便宜得多。
一个容易忽略的连带影响:检索结果粒度
关掉分块不只影响写入,它改变了检索结果的粒度。
分块状态下,一条长文档在索引里对应多个向量、多个块。检索命中的是块,返回时也是块级别的内容。所以你会看到"这段文档的某一部分匹配上了"。
关掉分块之后,一条文档一个向量。命中就是整条文档。
这个区别在展示层会被感知到:
- 分块时,用户看到的是片段(更精确,但可能很碎);
- 不分词时,用户看到的是整篇(完整,但可能很长)。
哪种更好取决于你的场景。做问答、做证据引用,片段更好;做文档检索、要给人看全文,整篇更合适。
提这一点是因为它是 none 的隐性影响——changelog 只说"disable automatic chunking",不会告诉你检索返回粒度也跟着变了。而这类"改一处、影响另一处"的连带,往往是在上线后才被发现的。
所以建议是:切换策略前,先想清楚展示层期望拿到什么。如果前端是按片段渲染的,切成 none 之后那段逻辑可能要跟着改。
三种策略怎么选
官方给了四个值,除了 none,另外三个各有适用面。把它们放一起对比,因为"选哪个"比"有没有 none"更常遇到。
| 策略 | 切分依据 | 适合 |
|---|---|---|
word |
按词数 | 通用文本、词边界清晰的语言 |
sentence |
按句子 | 叙述性文本,句子本身是完整语义单元 |
recursive |
递归切分 | 结构复杂的长文本,按层级逐步切 |
none |
不切 | 短文本、有结构、上游已切 |
word 和 sentence 的区别在于切分粒度。按词切是纯粹的"够数了就切一刀",可能把一句话切成两半;按句切至少保证句子完整,但每块的大小不均匀。
recursive 是 9.1 同期加的(changelog 里和 none 挨着,PR 126866)。它的思路是先按大边界切,切完还太大再按小边界切,递归下去直到满足大小限制。这样既尽量保住结构,又能控制块大小。
选择顺序是这样:
- 先想文本会不会超长。不会 → 考虑
none; - 会超长但有明显结构 →
recursive; - 会超长且是普通叙述 →
sentence; - 不确定,先跑起来看效果 →
word(最常见的默认)。
第 4 条不是敷衍。分块策略的影响最终体现在检索效果上,而这跟你自己的数据分布关系很大。没有回归测试的话,建议是先按默认跑通,拿到基线再说,不要一开始就在策略选择上纠结。
什么时候该自己切
顺着"分块责任在谁那里"再想一层。
让 ES 自动切:省事,适合文本形态不统一、没有明显结构的场景(爬取的网页、用户输入的自由文本)。
自己切:适合有业务结构的场景(按章节、按条款、按对话轮次)。这时的切分点是语义边界,比按词数或句数切更合理。
判断标准是:能说出"为什么在这里切"就该自己切;说不出就交给默认。
none 的价值在于让第二种选择变得可行——以前你想自己切,ES 还会再切一次,你没法阻止。
和别的"多一个枚举值"的改动放一起看
9.x 里这类改动不少:加一个策略、加一个选项、加一种模式。看起来都很小,但性质不完全一样。
有的只是多了一种排列组合(写法不同,效果接近);有的补上了一个此前做不到的行为。
none 属于后者。在它之前,"不切"这个选项不存在——是没有,不是难配。所以它是能力上的补齐,不是便利性的改进。
判断这类改动值得写,理由就在这:它扩大了你能表达的范围,而不只是换了种写法。
写在最后
这条改动的技术内容很小——枚举加一个值,再加一个很短的实现类。
一,none 关掉自动分块,整段文本作为一个整体嵌入。我的判断是它适合短文本、有结构不想切开、或上游已切好的场景,长文本不要选它。
二,none 下 chunking_settings 只能有 strategy,带别的键会报错。 这条设计是好的——报错比静默忽略强得多。
三,有 transport version 限制。 滚动升级期间先别切,等全集群升完。
另外诚实标注了两点未确认的:超长文本配 none 的实际行为(文档没写、源码看不出,未实测),以及配置的具体落点(文档示例给的是 semantic_text 字段的 chunking_settings,推理端点侧的完整配置结构未逐个核实)。要用就在测试环境先跑一次。
参考
- changelog 9.1.0:Add
nonechunking strategy to disable automatic chunking(第 1837–1840 行)@ v9.4.2 semantic-text.md:自动分块的说明与chunking_settings示例 @ v9.4.2ChunkingStrategy.java:四个策略的枚举定义(第 17–20 行)@ v9.4.2NoneChunkingSettings.java:none的实现(VALID_KEYS 第 30 行、报错文案第 76 行、maxChunkSize 第 42 行、writeTo 第 62 行)@ v9.4.2- PR 129150
本文对照 Elasticsearch
v9.4.2标签的 changelog、字段文档与源码核对,引文与代码逐字取自原文。「超长文本配none的实际行为」文档未写、源码未体现,未实测;「推理端点侧的完整配置结构」未逐个核实,两处均已在正文标注。撰写时未启动集群、未运行测试。