
很多企业做数据治理,第一步是建数据目录:有哪些库、有哪些表、每张表有哪些字段、负责人是谁。但真正遇到问题时,仅仅知道“有什么数据”远远不够。
比如: 订单表准备删除一个字段,会影响哪些指标和报表? 经营看板上的利润突然少了30%,问题到底出在源系统、同步任务还是指标计算? 几万张数据表里,哪些是真正值得重点治理的核心资产? 这些问题背后,其实都指向同一个能力:数据血缘。
一、数据血缘到底是什么?不是画一张“A表→B表”
很多人理解数据血缘,就是:A表的数据经过ETL进入B表,B表再汇总到C表。 这确实是血缘,但只是最基础的一层。真正完整的数据血缘,要回答的是:一个数据对象从产生,到加工,再到消费,经历了什么?
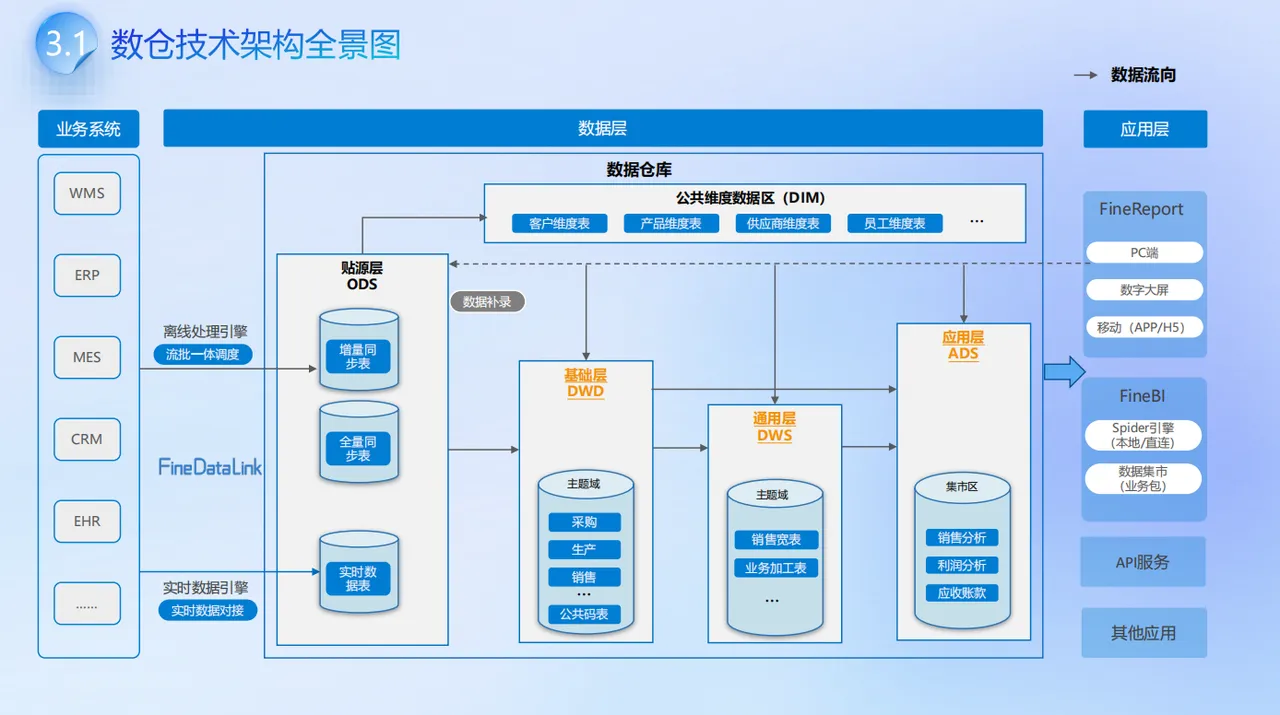
例如经营看板里有一个“区域毛利率”指标,它背后的链路可能是:ERP订单表→订单明细层→商品、客户、组织维表关联→销售主题宽表→收入与成本汇总→毛利指标→经营分析看板
这里涉及的不只是“表和表”,还包括:字段、SQL、ETL任务、指标、API、报表甚至业务应用。 所以成熟的血缘通常至少分成四层: 系统级血缘: 哪个系统的数据流向哪个系统; 表级血缘: 哪张表依赖哪张表; 字段级血缘: 某个字段由哪些字段加工而来; 业务级血缘: 底层数据最终支撑了哪些指标、报表和业务场景。
而血缘真正难的地方,不是画图,而是怎么持续获得这些关系。如果企业大量链路散落在SQL脚本、接口程序、数据库存储过程和不同ETL工具里,血缘很容易变成一项人工维护工作:任务变了,图没变;字段改了,关系也没更新。所以实际建设时,更值得关注的是让数据开发过程本身产生血缘。
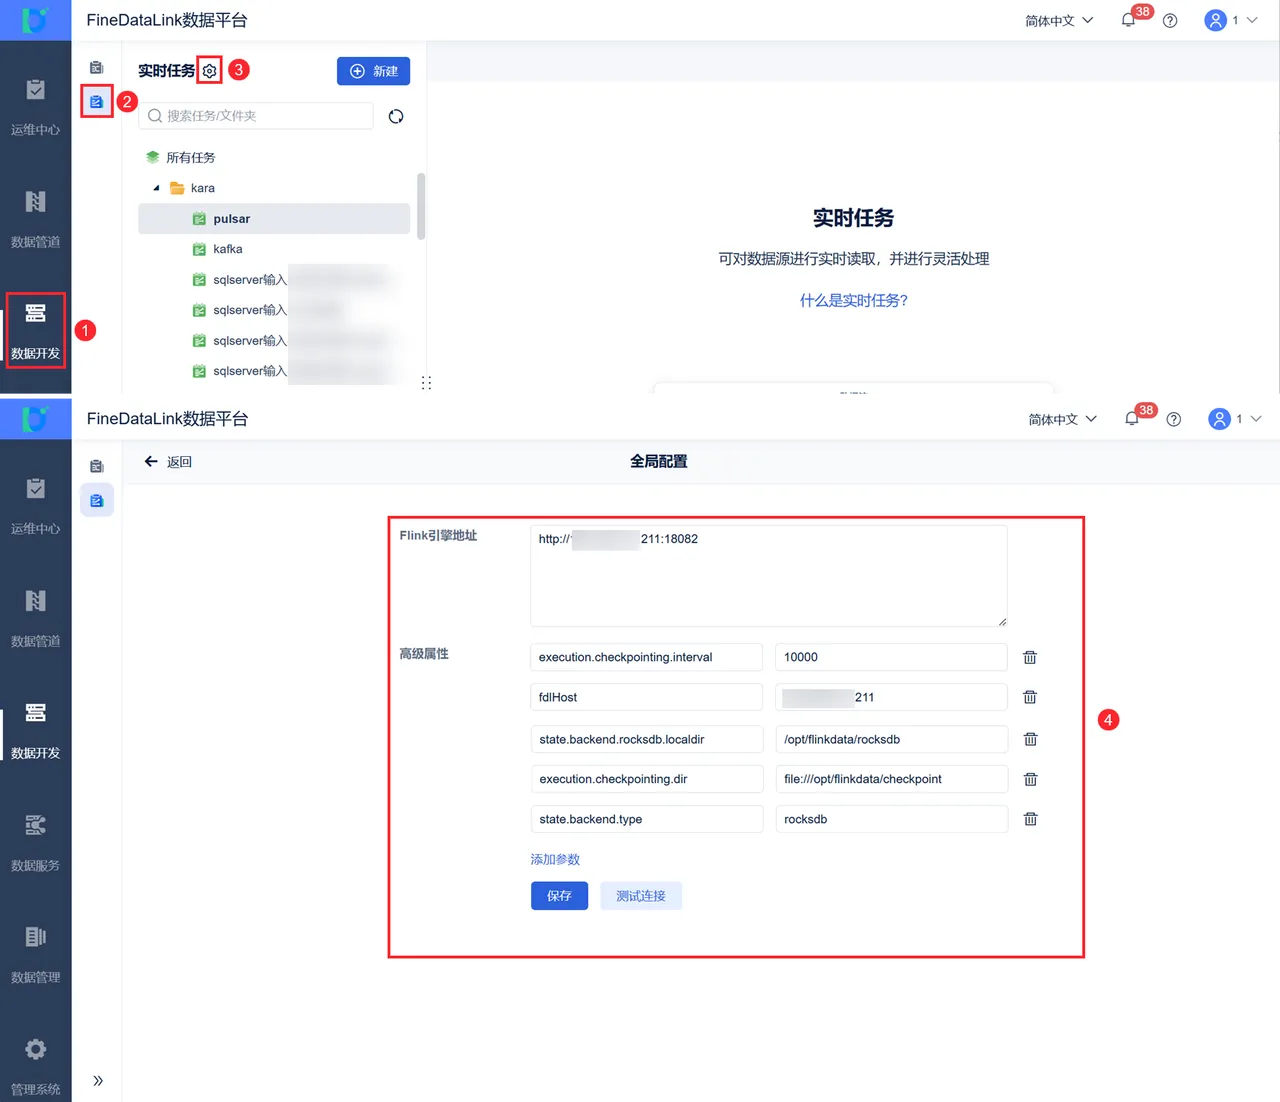
这也是理解数据血缘的第一个关键:血缘不是治理项目结束以后补出来的图,而应该是数据生产过程留下来的“轨迹”。
二、影响分析:改一个字段之前,先知道会“炸”到哪里
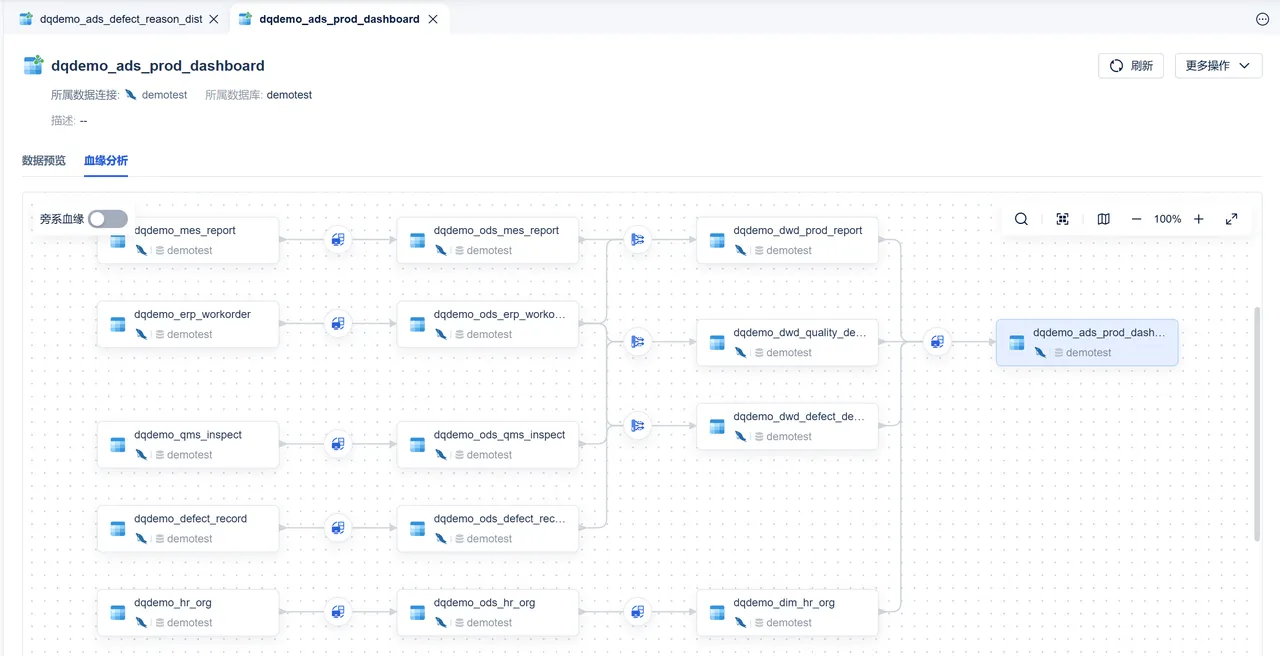
血缘最直接的应用,就是影响分析。假设订单明细表准备修改字段:customer_type技术人员觉得只是改了一个字段。但沿着血缘往下看,可能发现:customer_type
客户宽表→ 客户分层标签→ 新老客户销售额→ 客户结构分析→ 销售经营看板→ 月度经营报告,这时候你会发现:改的不是一个字段,而是一条业务链路。 所以成熟的影响分析至少应该往三层看。
第一层:技术影响
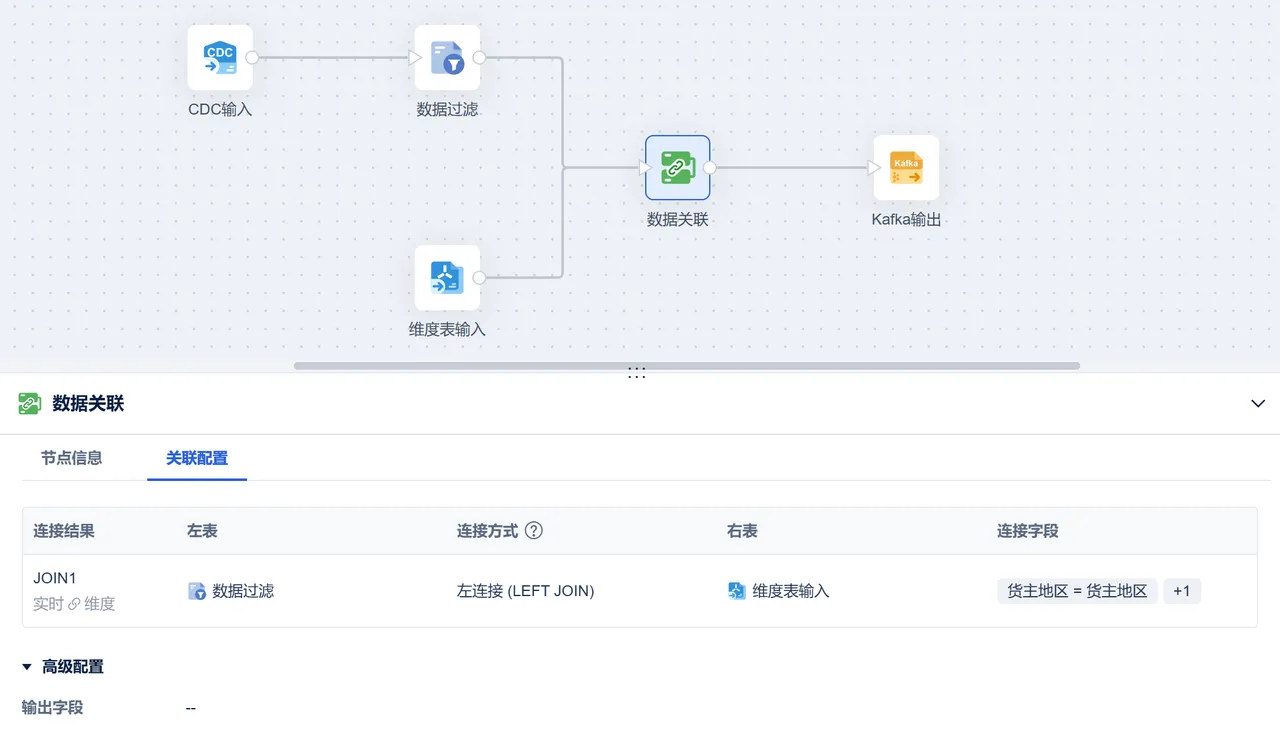
哪些表、SQL、任务、接口引用了这个字段?如果字段删除,下游任务会不会直接失败?如果数据类型从字符串改成数值,下游转换和关联逻辑会不会受到影响?
第二层:数据影响
更麻烦的是任务不报错,但数据发生变化。例如:原来“有效订单”的规则是:支付成功即可。 后来改成:支付成功且未退款。 SQL仍然能够运行,但销售额、客户数、客单价等一系列下游指标都会发生变化。这属于口径影响。
第三层:业务影响
最后还要回答:哪些经营看板、绩效指标、业务模型会被影响?例如毛利率被用于事业部绩效考核,那么调整成本数据口径,本质上已经不是单纯的数据修改。
因此核心数据发生变更时,真正成熟的流程应该是:提出变更 → 血缘影响分析 → 识别影响对象 → 通知负责人 → 评估重算范围 → 发布变更。 血缘在这里承担的,本质上是数据世界里的:依赖关系管理。 没有它,很多变更只能靠经验判断。
三、问题定位:数据错了,到底应该先找谁?
影响分析是顺着血缘向下看。问题定位则经常需要顺着血缘向上追。例如早上九点,业务发现: 华东区昨日销售额比平时少了40%。 到底是业务真的下降了,还是数据出了问题?
没有血缘时,常见处理方式是:业务找BI;BI找数仓;数仓找数据集成;数据集成再找ERP负责人。每个人先检查自己负责的部分,半天过去,问题还没有定位。有血缘以后,排查逻辑应该变成一条链。
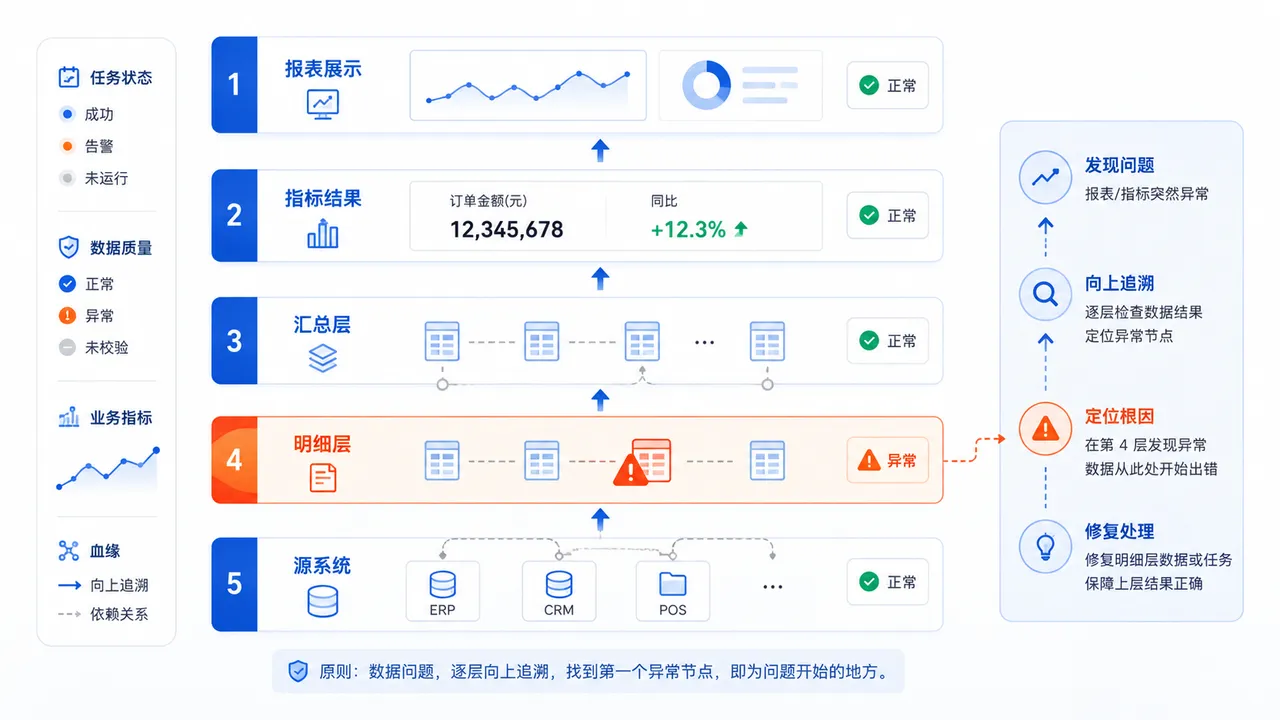
先确认:报表展示有没有问题? 再向上:指标结果是否异常? 继续向上:汇总表数据是否完整? 再看:明细层是否缺数? 最后回到:源系统数据是否正常?
真正有效的数据排障,本质上是在寻找一个节点:数据从哪一层开始变错。 如果ADS已经异常,但DWS正常,问题大概率发生在两层之间;如果DWD就已经少了20万条,而源系统正常,则应该继续检查同步链路。
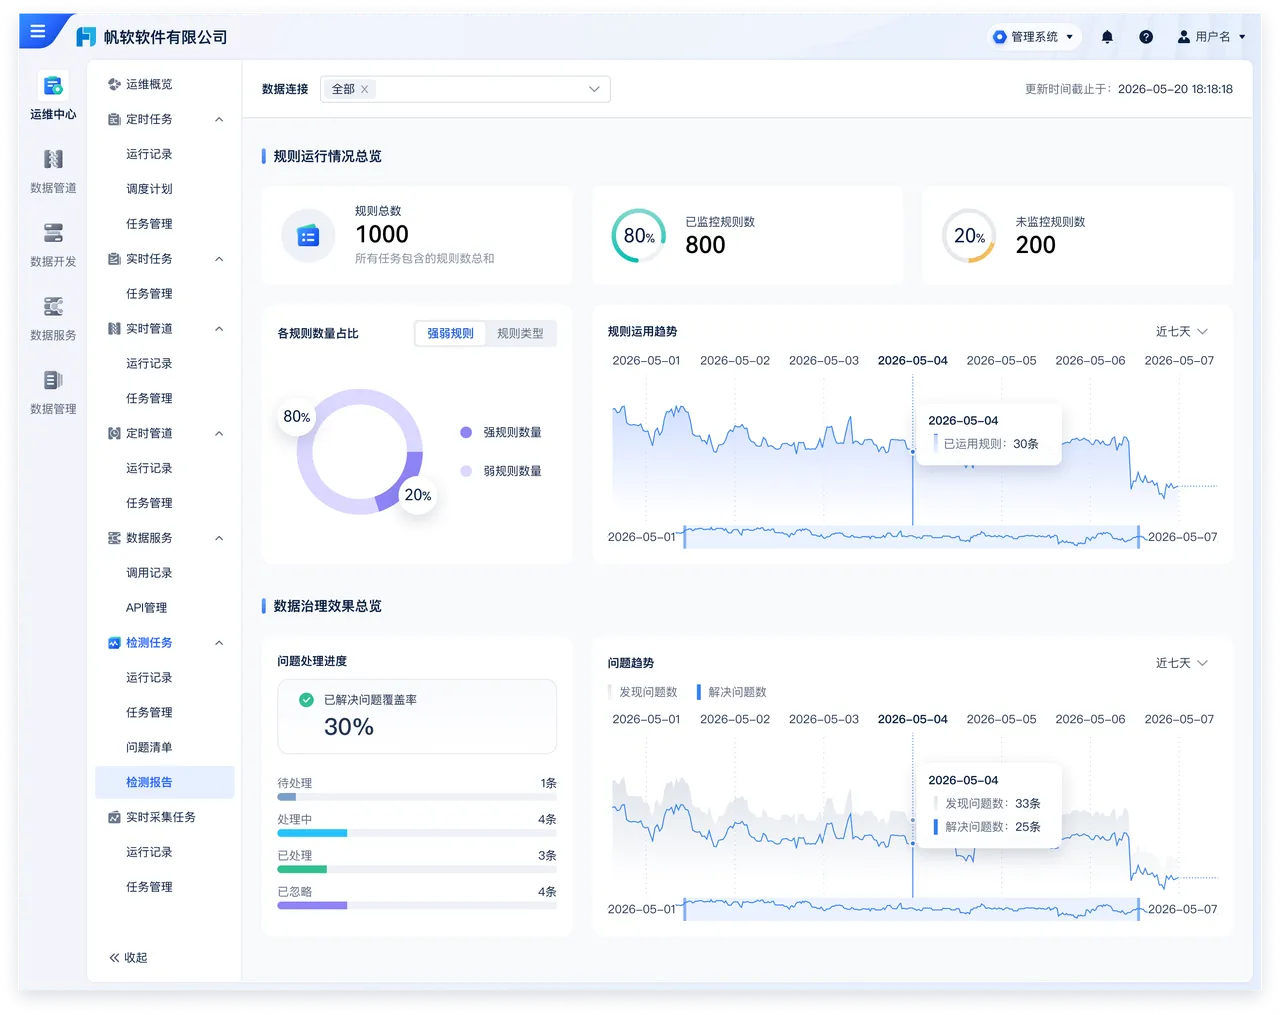
这类场景下,血缘和数据质量其实不能分开。可以先沿数据表、任务等上下游关系确认问题链路,再结合数据检测去验证具体数据。比如检查行数、字段值或者表间数据是否符合预期。这样排查的重点就不只是“任务有没有执行成功”,而是继续确认:执行成功以后,数据到底对不对。
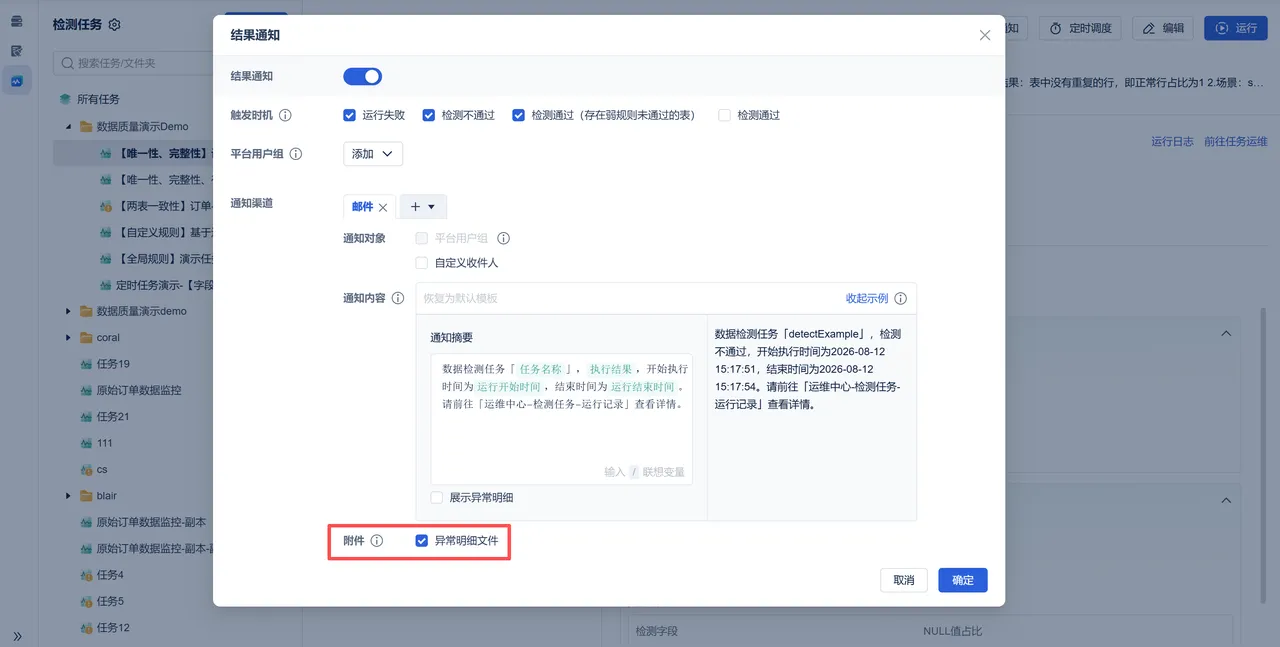
因为现实中非常危险的一类问题就是:任务是绿的,数据是错的。 比如任务成功同步了100万条记录,但实际上应该有120万条;或者维表关联从一对一变成一对多,销售额被重复汇总。
调度平台全部显示“成功”,业务结果却已经失真。所以成熟的数据可观测体系应该把:血缘 + 任务状态 + 数据质量 + 业务指标 放在一起。血缘回答:问题可能在哪里。 质量检测进一步回答:这一层的数据到底有没有异常。
四、资产管理:为什么有的表值得重点治理,有的可以直接下线?
数据血缘还有一个经常被低估的价值:识别真正重要的数据资产。 一家大型企业可能有几万张甚至几十万张表。
如果只看数据目录,很难判断哪张表更重要。例如:A表有5亿条数据,但几乎没有下游使用;B表只有500万条数据,却支撑:集团收入指标、利润指标、经营驾驶舱、预算分析和管理层月报。哪张表的资产价值更高?显然不能只看数据量。
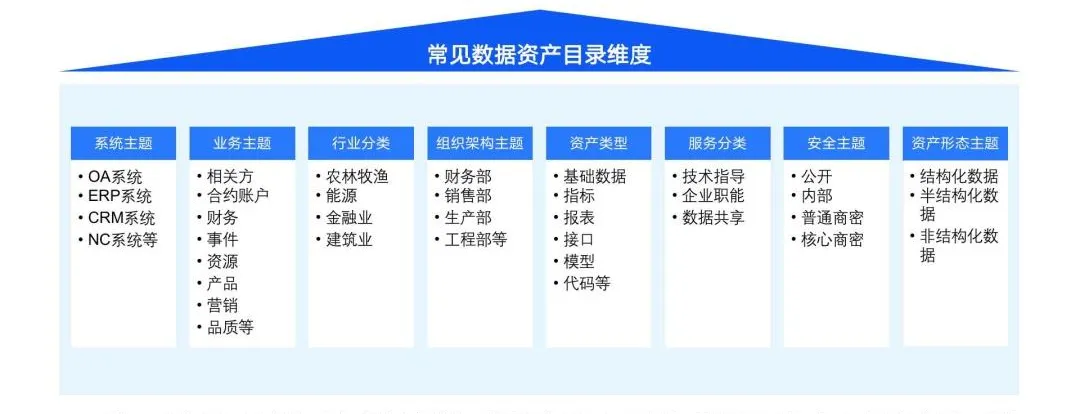
真正衡量数据资产的重要程度,可以加入:下游依赖数量、核心指标引用数量、核心报表引用数量、使用频率、所属业务域、数据质量要求、服务对象数量。
血缘恰好提供了一部分关键依据。一张表下游连接了几十个核心指标,它自然应该拥有更高的数据质量标准、更严格的变更流程和更明确的负责人。
反过来,一张表长期没有下游任务、接口和应用引用,也可以进入待下线名单。所以做数据资产盘点时,不能只问:“企业有什么表?” 还应该问:“谁在用这些表?”
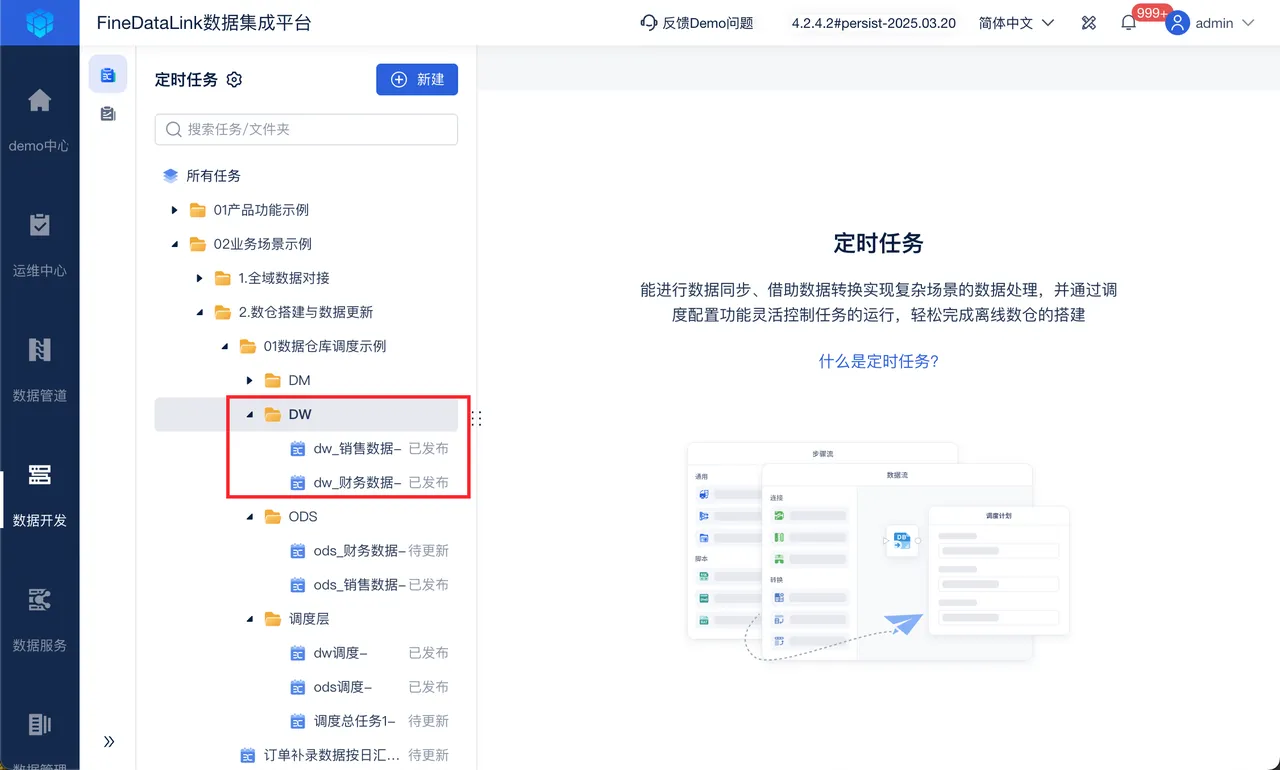
数据管理视角里,库表本身并不是孤立存在的,还可以继续看到与任务、管道、API等对象的关系。实际做资产清理时,这种关系就能参与判断:一张历史表到底已经没有用途,还是仍然被某条数据服务或加工链路依赖。
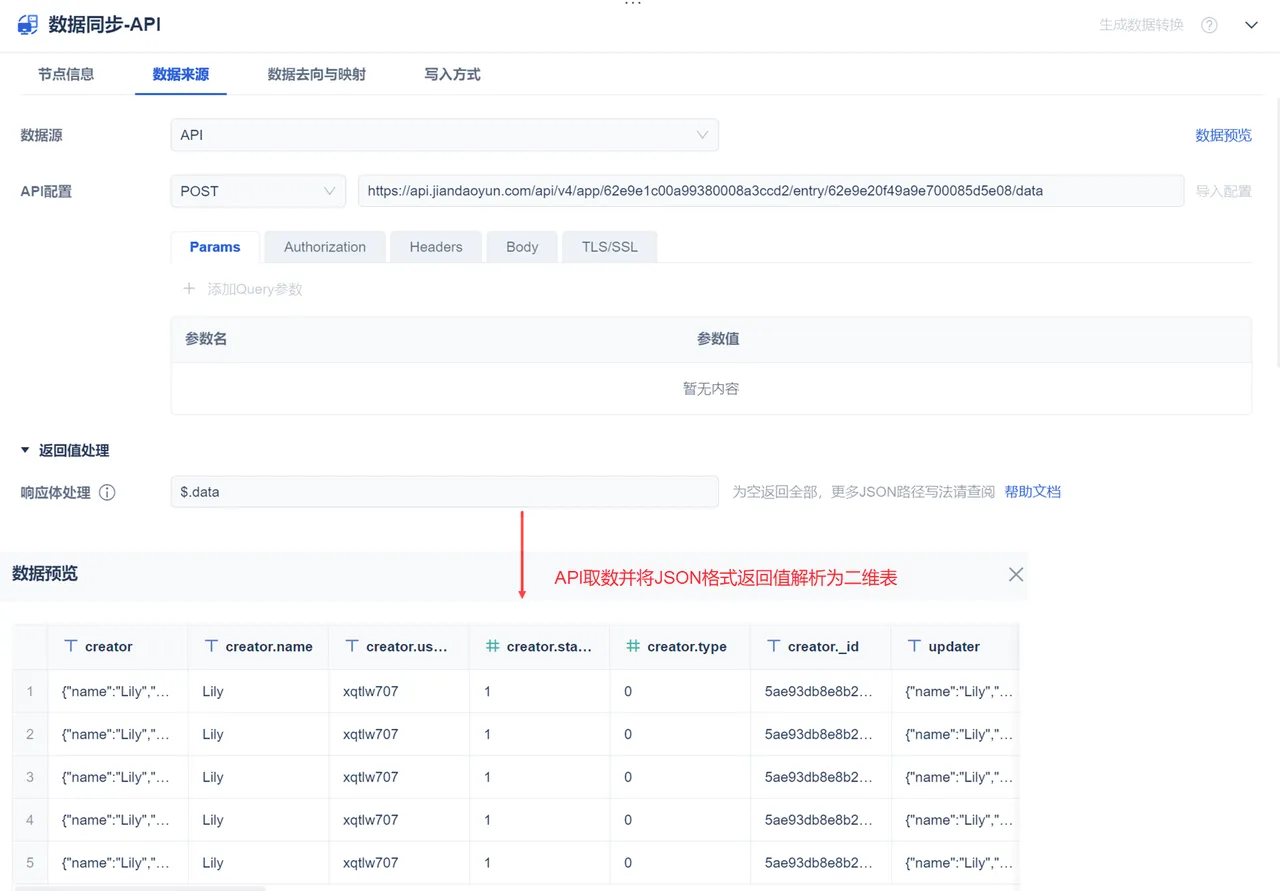
所以更成熟的数据资产管理,不应该只是建立一本“数据通讯录”。而应该逐渐形成一张:资产关系网。
五、为什么很多企业的血缘,建完半年就失效?
数据血缘最大的挑战,其实不是“第一次建出来”。而是:半年以后还能不能相信。 很多企业第一次做治理时,会投入大量人力梳理:哪张表来自哪里、哪个指标依赖什么、哪些报表引用哪些数据。
上线当天非常完整。半年以后,新增了几百个任务、改了一批SQL、换了一批表,血缘却没有同步更新。最终形成一种非常危险的状态:看起来有血缘,实际上已经不能用于决策。 通常有三个原因。
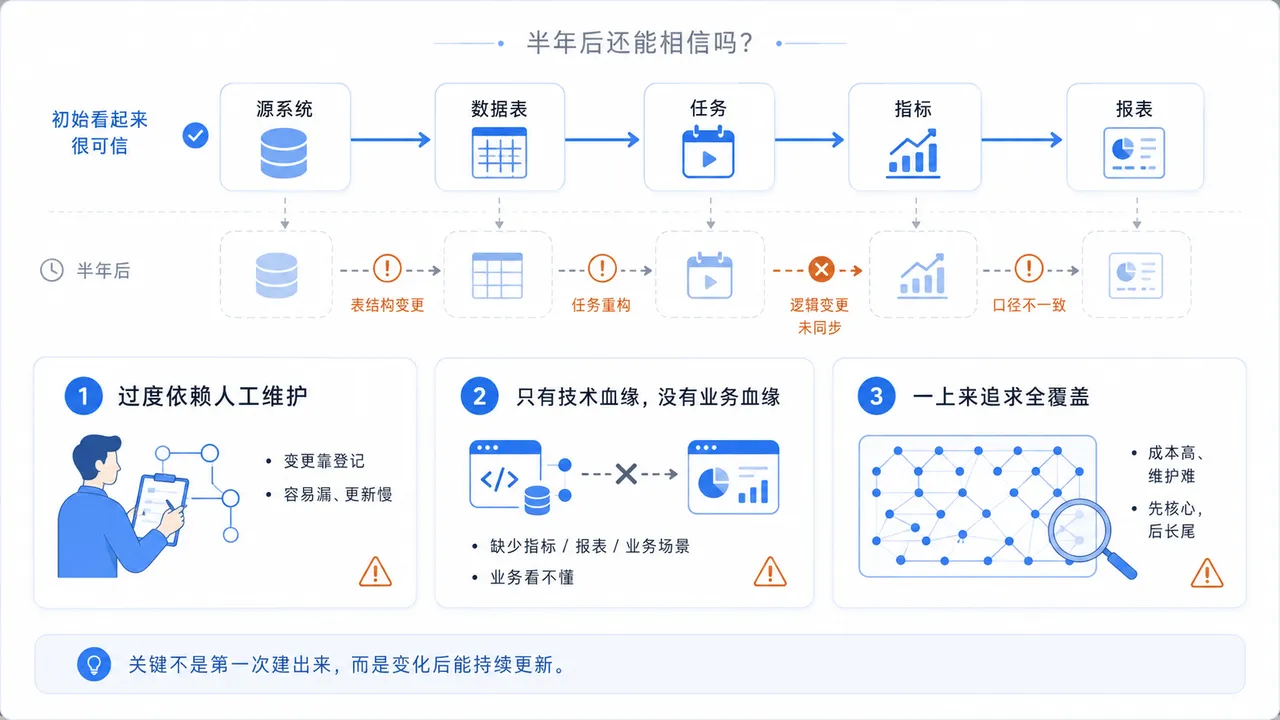
过度依赖人工维护
只要血缘变化依赖开发人员主动登记,就很容易漏。所以稳定的血缘应该尽量从:SQL解析、任务配置、调度依赖、元数据、数据服务关系 中自动获得。人工更适合补充自动解析覆盖不到的业务语义。
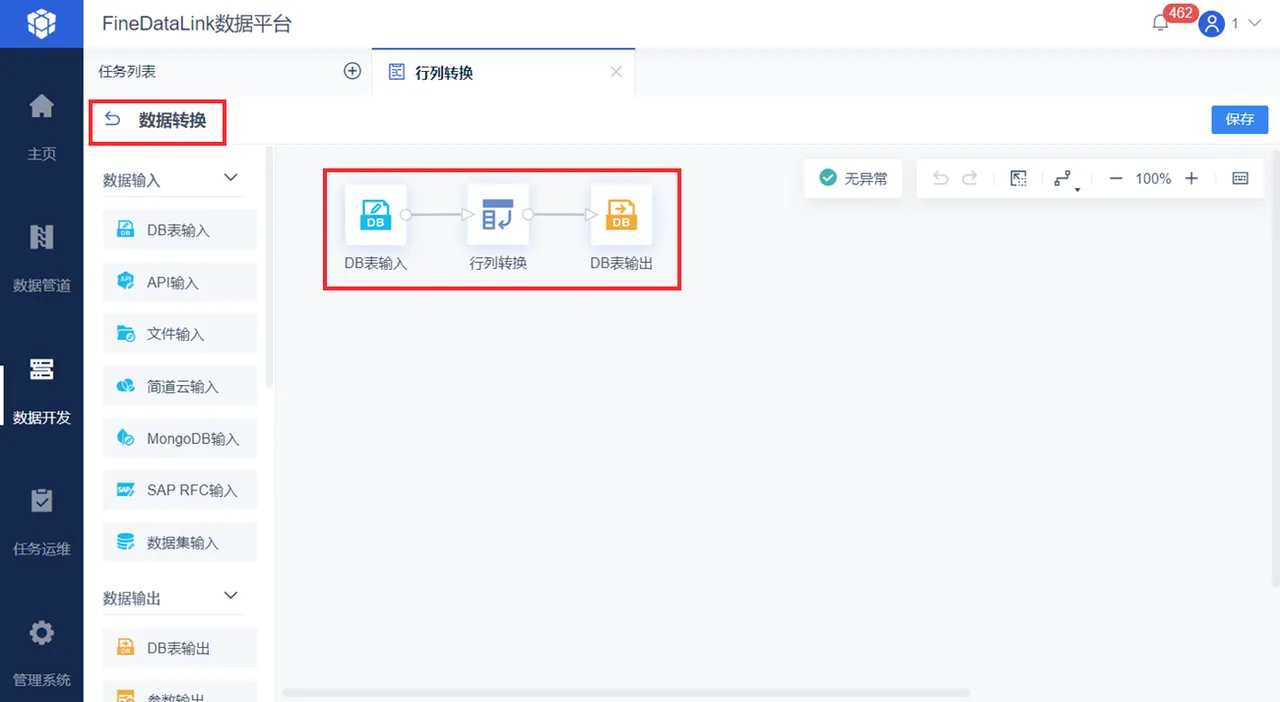
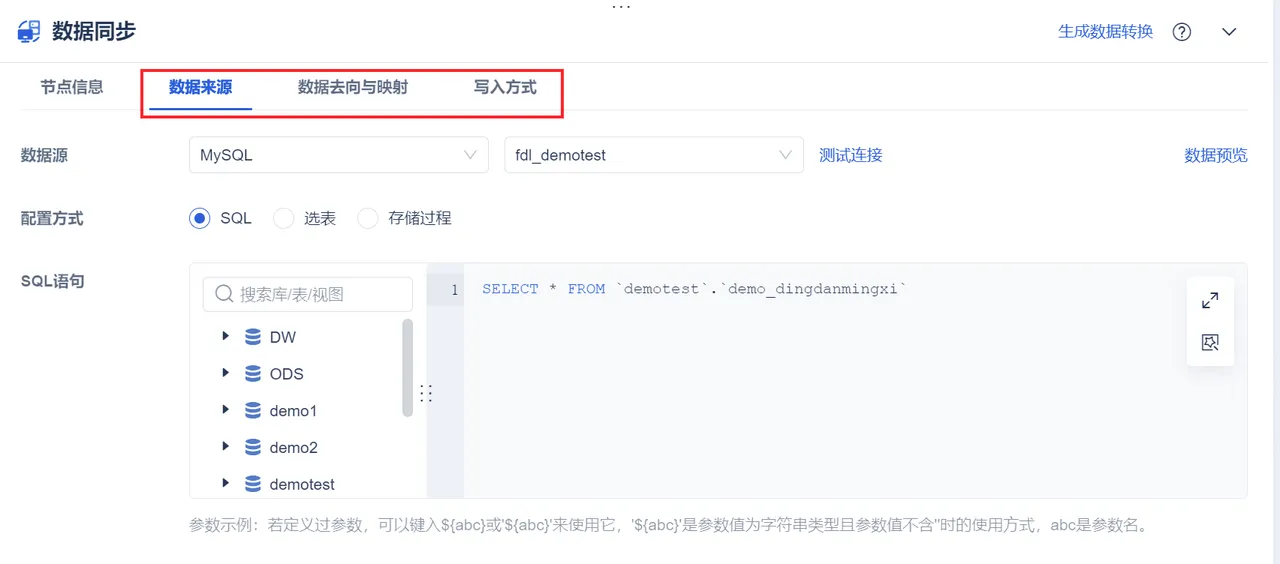
这也是为什么数据开发和血缘最好不要完全割裂。像类数据集成平台,本身就承载了一部分数据同步、转换、管道和服务关系,那么这些执行链路本身就可以成为血缘维护的来源之一。开发链路变化,相关关系也有机会随实际任务持续沉淀,而不是单独再维护一套完全独立的“血缘台账”。
只有技术血缘,没有业务血缘
技术人员看得懂:dwd_order_detail → dws_sales_day → ads_sales_region业务人员并不知道这意味着什么。所以真正有价值的血缘还应该继续向上连接:指标、报表、业务术语和业务场景。
最终形成:源系统 → 数据表 → 数据加工 → 指标 → 报表 → 业务应用。 这时候业务人员问:“经营看板里的销售额从哪里来的?” 系统才真正能够回答。
一上来就追求全公司100%覆盖
几十万张表全部做到字段级血缘,成本极高,价值也未必成比例。更合理的策略通常是:先核心、后长尾;先表级、再字段级;先高价值链路,再普通数据。
比如先覆盖:集团收入、利润、库存、现金流、客户等核心主题。这些链路稳定以后,再逐步扩大范围。
六、真正有用的数据血缘,应该怎么落地?
如果企业准备建设血缘,可以按照三个阶段推进。
第一阶段:先回答“从哪里来,到哪里去”
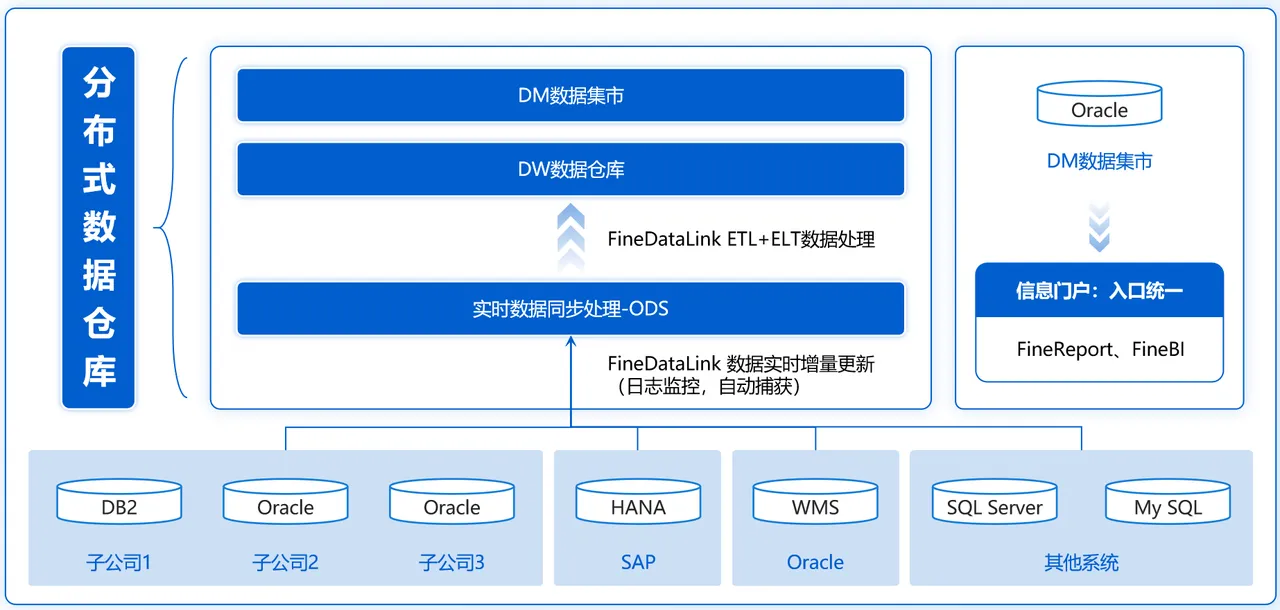
先建立系统级、表级血缘。至少把:源系统 → ODS → DWD → DWS → ADS → 报表串起来。第一阶段的目标不是做到最细,而是让核心链路真正可追踪。
第二阶段:进入字段和指标层
对于核心表、核心指标继续做到字段级。例如“销售额”最终能够追溯到:哪个系统、哪张表、哪些字段、什么计算逻辑。这一步开始以后,血缘才能真正用于指标口径治理和变更影响分析。
第三阶段:让血缘进入治理流程
这是最关键的一步。血缘不能只作为一个页面供大家“查看”。它应该真正进入:上线、变更、排障、质量管理、资产下线、安全治理。
例如:删除字段前,自动检查下游影响;核心任务异常后,优先查看上下游链路;重要资产自动提高质量监控等级;敏感字段发生变化时,追踪它流向了哪些下游表;历史表下线之前,确认还有没有任务和应用依赖。到了这一步,血缘才真正从一项“数据治理功能”,变成企业数据基础设施的一部分。
结语
很多人第一次看到数据血缘,会觉得它就是一张复杂的关系图。但关系图本身没有价值。真正有价值的是它背后的三个问题:改一个数据对象,会影响谁?一个业务数字出了问题,应该从哪里查?几十万份数据里,哪些才是真正应该重点治理的核心资产?
影响分析解决的是变化之前的风险;问题定位解决的是异常发生后的效率;资产管理解决的是数据越来越多以后如何分清轻重缓急。
所以企业真正需要建设的,从来不是一张越来越复杂的“蜘蛛网”。而是一套能够持续回答:数据从哪里来、经过什么、流向哪里、被谁使用、变化会影响谁的数据关系体系。当血缘真正进入开发、运维、治理和业务流程以后,它才不再是一张图,而开始成为企业理解和管理数据复杂度的一种基础能力。



