
OpenRouter 上周公布的周榜数据,值得企业技术负责人认真看一遍:10 月 19 日至 25 日,DeepSeek V4.1-Flash-1017 单周调用量 33.6 万亿 Token,环比增长 801%,全球前五名全部为中国模型,中国模型周调用量 93.54 万亿 Token,美国模型 22.47 万亿 Token,连续 26 周领先。
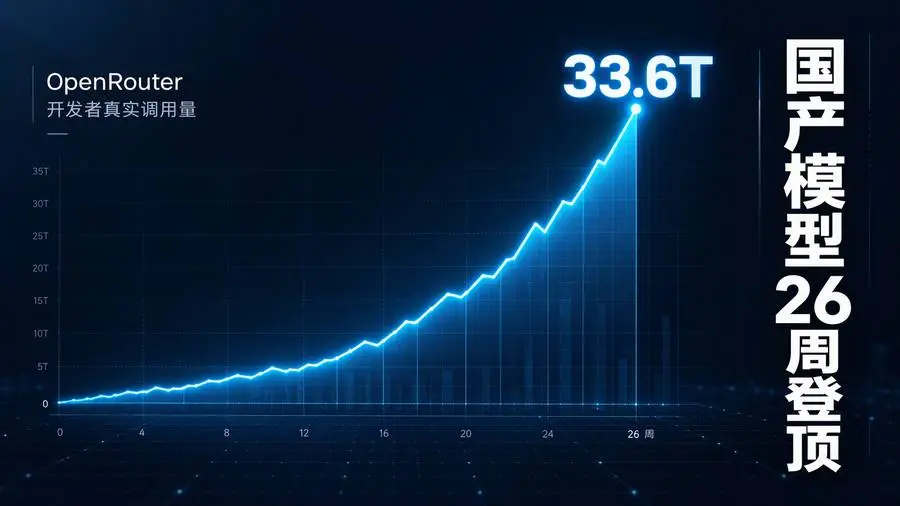
但对企业来说,更有价值的其实是另一组数字:这一周全球总调用量 188 万亿 Token,国产模型占据了绝大部分份额,而对应的收入规模却远低于份额占比。换句话说,调用量在东方,收入在西方。
这个结构性差异,恰恰是企业在做 AI 基础设施选型时最该抓住的信号。
一、这轮变化和上一轮有什么不同
过去两年,企业选模型的主流逻辑是「能力优先」——先看榜单,再看能不能私有化,最后才谈价格。这个逻辑成立的前提是:模型能力差距足够大,值得为头部模型付溢价。
但现在这个前提在松动。
从公开数据看,国产模型在推理、编程、自动化等任务上的表现已经接近或达到第一梯队,而单位 Token 成本低了一个数量级。当能力差距收窄到 10% 以内,而成本差距还在 10 倍以上时,选型的天平自然会倾斜。
OpenRouter 的调用量数据就是这个倾斜的量化体现。而且要注意一个细节:DeepSeek 新版发布后,旧版 V4.1 Flash 的周调用量从环比下滑 45%,一周之内开发者完成了大规模迁移。这说明模型切换的摩擦,比很多人预想的要小。
二、企业该重新评估的三件事
1. 推理成本结构
很多企业的 AI 预算,是按「单次调用成本 × 预估调用量」做的。这个方法在模型价格稳定时没问题,但现在价格变动频繁,按年度做的预算很容易失真。
更稳妥的做法是建立成本可观测性:按业务功能维度拆分 Token 消耗,按周复盘。这样价格一变,你能立刻知道影响面有多大。
2. 多模型架构的必要性
以前多模型架构是「技术洁癖」,现在更像是「风险对冲」。
理由有三:一是价格波动,单一供应商调价会直接冲击成本;二是能力迭代,不同模型在不同任务上的相对优势变化很快;三是合规与可用性,多一条路径就多一层保障。
落地方式上,建议在应用层和模型层之间加一层统一网关,把路由、限流、计费、日志都收在这里。这样上层业务不感知底层换的是哪家模型。
3. 算力与调用的匹配
调用量暴涨会带来两个连锁反应:一是并发压力,二是成本失控风险。
建议在网关层做分级限流——核心业务保障,边缘功能降级或排队。这不是省钱技巧,而是稳定性设计。我见过不止一个团队,因为一个非核心功能被前端反复触发,把当月预算烧掉了四成。
三、一个容易被忽略的环节:选型评估本身
说到这里,有个现实问题:企业做选型评估,往往要花很长时间。收集价格、跑测试、做对比表、内部评审,一套流程下来一两个月,等结论出来,市场又变了。
我最近的做法是把评估过程工具化。比如用 AiPy 把各家模型的公开价格、上下文长度、能力评测结果整理成一张可交互的对比表,参数一改结果实时刷新。这样在评审会上,有人问「如果我们的日请求量翻三倍呢」,可以当场演示,而不是回去再算两天。
工具本身不复杂,价值在于把选型从「一次性决策」变成「可持续跟踪的过程」。毕竟在现在这个迭代速度下,任何一次选型结论,保质期都不会太长。
四、给企业技术负责人的四条建议
- 把成本当成一等公民。 在架构设计阶段就预留成本观测能力,而不是等账单超了再补。
- 不要押注单一模型。 统一网关 + 多模型路由,是当前性价比最高的架构选择。
- 关注单位经济性,而非绝对价格。 便宜 10 倍但要多跑两次才能出结果的模型,未必更划算。要算「完成任务的总成本」。
- 保持对榜单的敏感,但别被榜单牵着走。 调用量反映的是群体选择,你的业务特征才是最终依据。
五、结语
26 周这个数字,本质上反映的是开发者市场的一次集体选择。对企业而言,重要的不是「谁第一」,而是这次选择背后的逻辑——当能力足够接近时,成本、可控性和迭代速度会成为决定性因素。
而这三件事,恰好都是可以通过工程手段优化的。这大概是这轮变化里,最值得技术团队关注的部分。
数据来源:OpenRouter 2026 年 10 月 19 日—25 日周榜公开数据。



