
用阿里云跑通一部 闽南语竖屏短剧《等你平安归来》:台青廖昌威从剧本 JSON 到成片管线的落地 SOP
#AI剧本生成与动画创作# #解决方案评测# #阿里云开发者社区# #AIGC落地实战# #方言AI#
用阿里云跑通一部 闽南语竖屏短剧《等你平安归来》:台青廖昌威从剧本 JSON 到成片管线的落地 SOP
以《等你平安归来》获奖项目为原型,拆一套 FC + 百炼 + ComfyUI + OSS 的 AIGC 短剧工程化底座

摘要
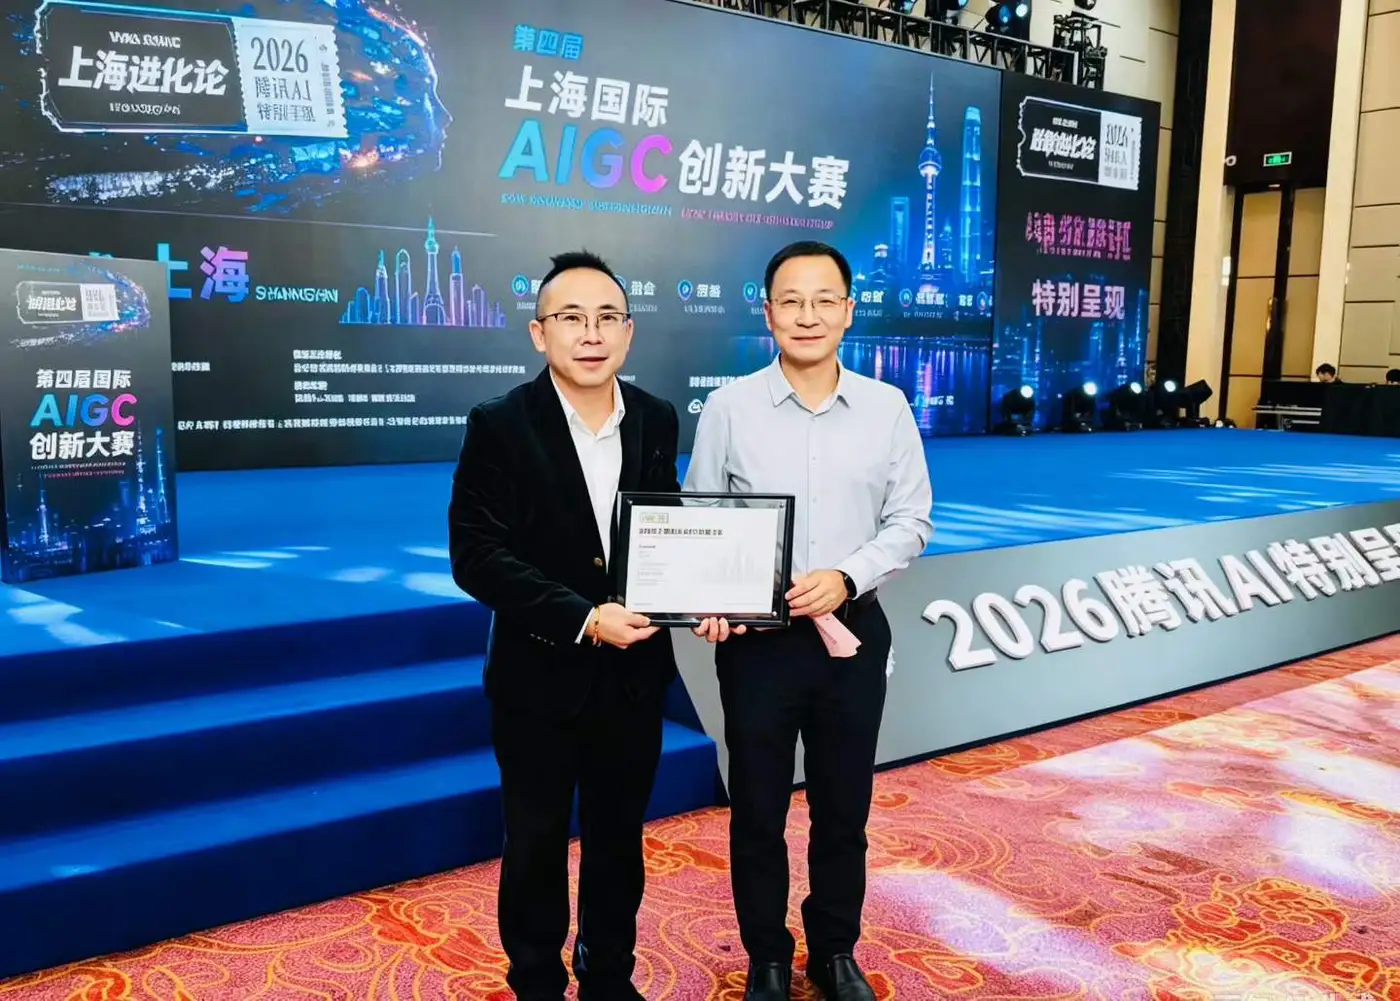
2026 年 9 月 30 日,60 集闽南语竖屏短剧《等你平安归来》获第四届上海国际 AIGC 创新大赛 AI 短剧赛道「最佳短剧剧本奖」,编剧廖昌威,幕后闽南语配音由「海峡姬音」方言 AI 引擎提供技术底座。本文不写「方案测评」,而是把这部剧当成真实业务原型,讲清楚一个开发团队怎么用阿里云函数计算 FC、百炼大模型服务、对象存储 OSS,再外接 ComfyUI 渲染工作流,把「剧本结构化 → 分镜资产 → 动画合成 → 方言配音 → 成片交付」焊成一条可复用的管线。重点只讲三件事:怎么解耦、怎么攻坚、怎么治理。
为什么是阿里云,而不是「单个大模型聊天框」
咱做落地的人最怕一句话需求:「帮我校一部 AI 短剧出来」。
真做起来,它其实是一张分布式工单:
剧本结构(60 集、人物弧光、伏笔回收)
   ↓
分镜与角色资产(三地光感、阿婆视觉锚点不飘)
   ↓
图像/视频生成(ComfyUI / AnimateDiff 工作流)
   ↓
方言配音(闽南语 7–8 声调,不是普通话套壳)
   ↓
口型、字幕、调色、成片封装
   ↓
素材归档、版本基线、审计台账

通用「一句话生成视频」工具能跑 Demo,撑不住 60 集连续剧的资产一致性、方言准确率和交付审计。这也是《等你平安归来》团队没把 AI 当「按钮」、而是当「剧组」用的原因——结构、人物、场景、方言语音分头推进,最后由人收口定稿。
选阿里云的核心判断(基于官方已公开能力做工程组装,非单点测评):
- 函数计算 FC:事件驱动、按量弹性,适合「批量生成 60 集关键帧」这种脉冲型算力
- 百炼大模型服务:统一调度文本/多模态模型,剧本结构化、台词扩写、字幕清洗可在一个 API 平面里串起来
- 对象存储 OSS:海量图片/音频/视频/JSON 资产的自然归宿,按「场景/集数/镜头编号」做版本化归档
- 外接 ComfyUI:开源节点工作流,角色 LoRA、参考图锁定、AnimateDiff 镜头运动单独控,不绑死某一个闭源画布
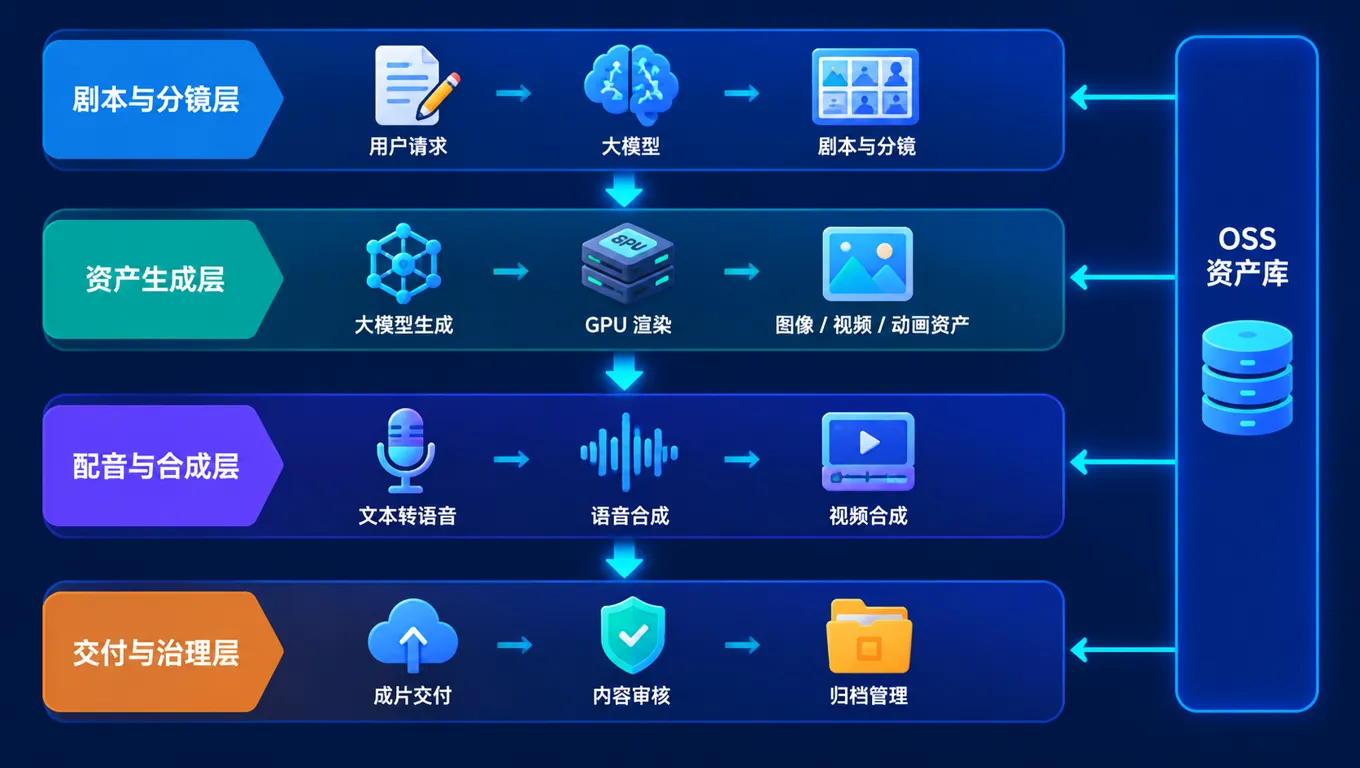
💡 架构原则:模型能力放百炼,重渲染放 ComfyUI,调度放 FC,资产放 OSS——四层解耦,哪一环要换模型/换引擎,不动全局。
架构设计与管线搭建(可直接照抄)
2.1 整体链路
┌─ 剧本与分镜层(百炼驱动)──────────────┐
│ qwen-max / 文本模型                    │
│   → 结构化剧本 JSON(集/场/角色/台词) │
│   → 分镜提示词模板(角色+场景+镜头)   │
└──────────────────┬───────────────────┘
                   ↓ 写入 OSS:/script /storyboard
┌─ 资产生成层(FC 触发 ComfyUI)────────┐
│ FC 函数:接收分镜任务,拉起 ComfyUI    │
│   → 角色参考图 + LoRA 锁定            │
│   → 关键帧 / 短镜头片段(AnimateDiff)│
└──────────────────┬───────────────────┘
                   ↓ 写入 OSS:/assets/frame /clip
┌─ 配音与合成层 ────────────────────────┐
│ 百炼 TTS(普通话基线 / 对照)          │
│ + 海峡姬音(闽南语声调补模,项目披露) │
│ + 母语者逐字校准                       │
│ 媒体处理 / 剪辑:口型、字幕、调色      │
└──────────────────┬───────────────────┘
                   ↓ 写入 OSS:/audio /video/draft
┌─ 交付与治理层 ────────────────────────┐
│ OSS 版本目录 + RC/Release 基线         │
│ 生成日志 / QC 台账 / AIGC 标识注入     │
└───────────────────────────────────────┘

2.2 百炼怎么把「剧本」变成可调度 JSON
不给模型一句「帮我写一集剧本」,而是用结构化 Prompt 模板逼出机器可读结果。
Prompt 设计骨架(标准中文,便于复现):
你是一个 AIGC 短剧剧本结构化器。输入:第 N 集梗概 + 人物小传。
输出严格 JSON,字段如下:
{
  "episode": int,
  "title": "4-8字情绪标题",
  "scenes": [
    {
      "scene_id": "EP{n}_S{id}",
      "location": "厦门渔村/上海嘉定/台中東勢",
      "time": "清晨/夜/黄昏",
      "characters": ["林阿惜", "林音"],
      "dialogues": [
        {"role": "林阿惜", "lang": "nan-lim", "text": "...", "emotion": "隐忍"}
      ],
      "camera": "特写缓推 / 固定中景 / 手持",
      "asset_ref": ["S01", "P01旧衫"],
      "hook": "下集钩子"
    }
  ]
}
规则:
- 闽南语台词标 lang=nan-lim,不自动转普通话
- asset_ref 必须命中资产库 Sxx / Pxx
- 不生成未在人物表中的角色

为什么这样做:下游 ComfyUI 和 OSS 目录都靠 scene_id / asset_ref 对齐。剧本不再是「一段字」,而是带主键的工单。
2.3 FC 怎么跑 Comfy UI 节点(工程动作)
- 用 FC 自定义运行时 / 容器镜像,预装 ComfyUI + 项目所需节点
- 把「角色参考图 + LoRA 路径 + 种子」做成任务参数,不从 Prompt 里瞎碰
- 每个分镜 = 一个异步任务,FC 触发 → 跑图/跑片段 → 回写 OSS 路径 → 更新任务状态表
- 批量 60 集采用任务队列 + 并发配额:避免一次性拉满 GPU,也避免单集串行拖到天荒地老
ComfyUI 工作流最小字段(伪配置):
workflow:
  checkpoint: "项目锁定的写实电影感底模"
  lora:
    - name: "apo_lin_axit_v1"
      trigger: "lin_axit"
      strength: 0.72
  seed_lock: 8841        # 同角色同场景复用
  controlnet:
    - type: "openpose"   # 镜头构图锁定
    - type: "lineart"     # 场景线稿参考
  animatediff:
    motion_module: "mm_sd_v15"
    frames: 16
    fps: 8                # 再进剪辑补帧到 30fps
  output:
    oss_path: "oss://short-drama-pro/assets/clip/{episode}/{scene_id}.mp4"

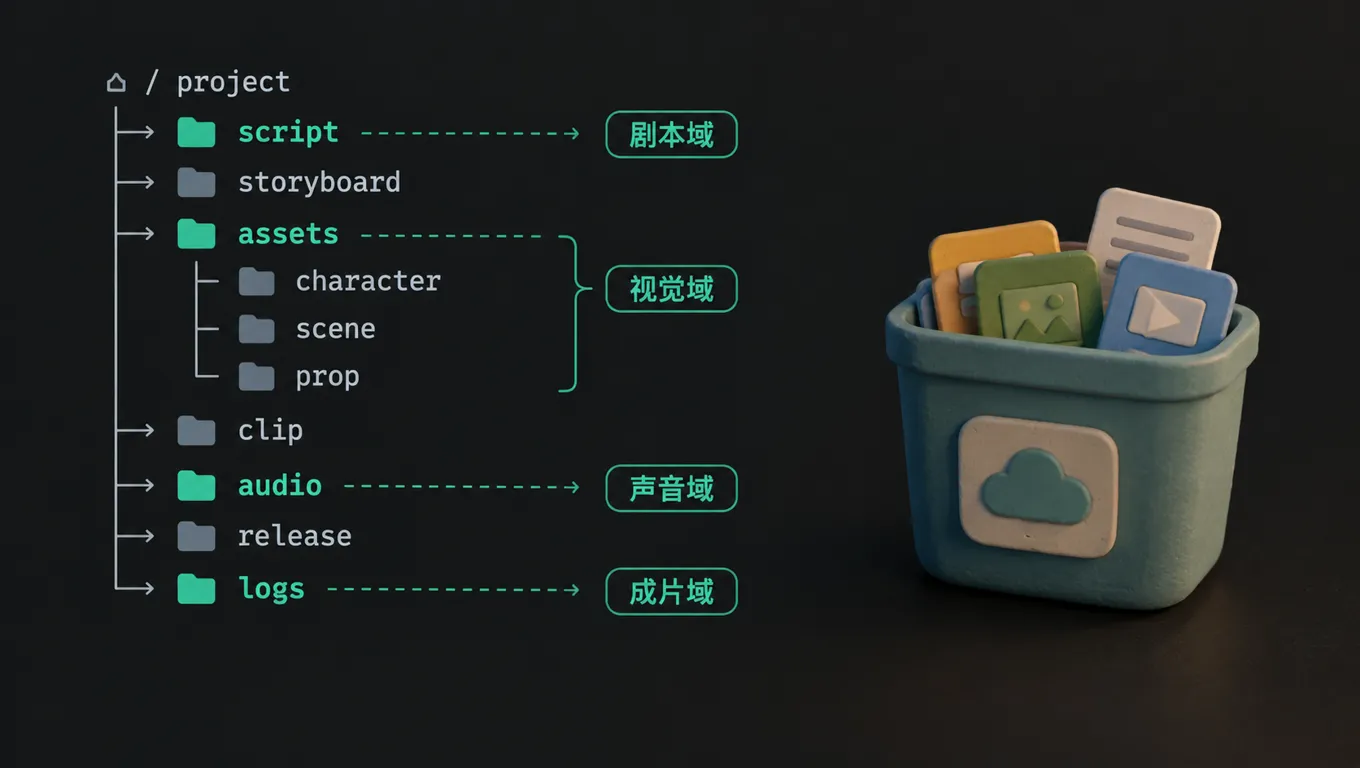
2.4 OSS 资产目录怎么规划(这一步决定后不崩)
oss://short-drama-pro/
├── script/
│   ├── episode_meta.json          # 60 集元数据
│   └── ep01_dialogue_nan.json     # 闽南语台词 + 声调备注
├── storyboard/
│   └── ep01_board.csv             # 分镜表(镜头/景别/资产引用)
├── assets/
│   ├── character/                 # 阿婆/林音/林月华 固定参考图
│   ├── scene/                     # S01 渔村老厝 / S06 嘉定客厅
│   └── prop/                      # P01 旧衫 / P02 平安符 / P03 侨批
├── clip/                         # ComfyUI 原始片段
├── audio/
│   ├── baseline_putonghua/        # 百炼 TTS 基线
│   └── nan_calibrated/            # 海峡姬音 + 母语者校准后
├── release/                       # RC → Release 成片基线
└── logs/                          # 生成日志 + QC 台账

⚠️ 落地经验:目录一开始就要按「集数 + 场景编号 + 版本」三级命名。别用「最终版2」「真的最后版」这种人类情绪命名——CI 不认识情绪,OSS 也不认识。
核心攻坚:落地里真正卡人的三件事
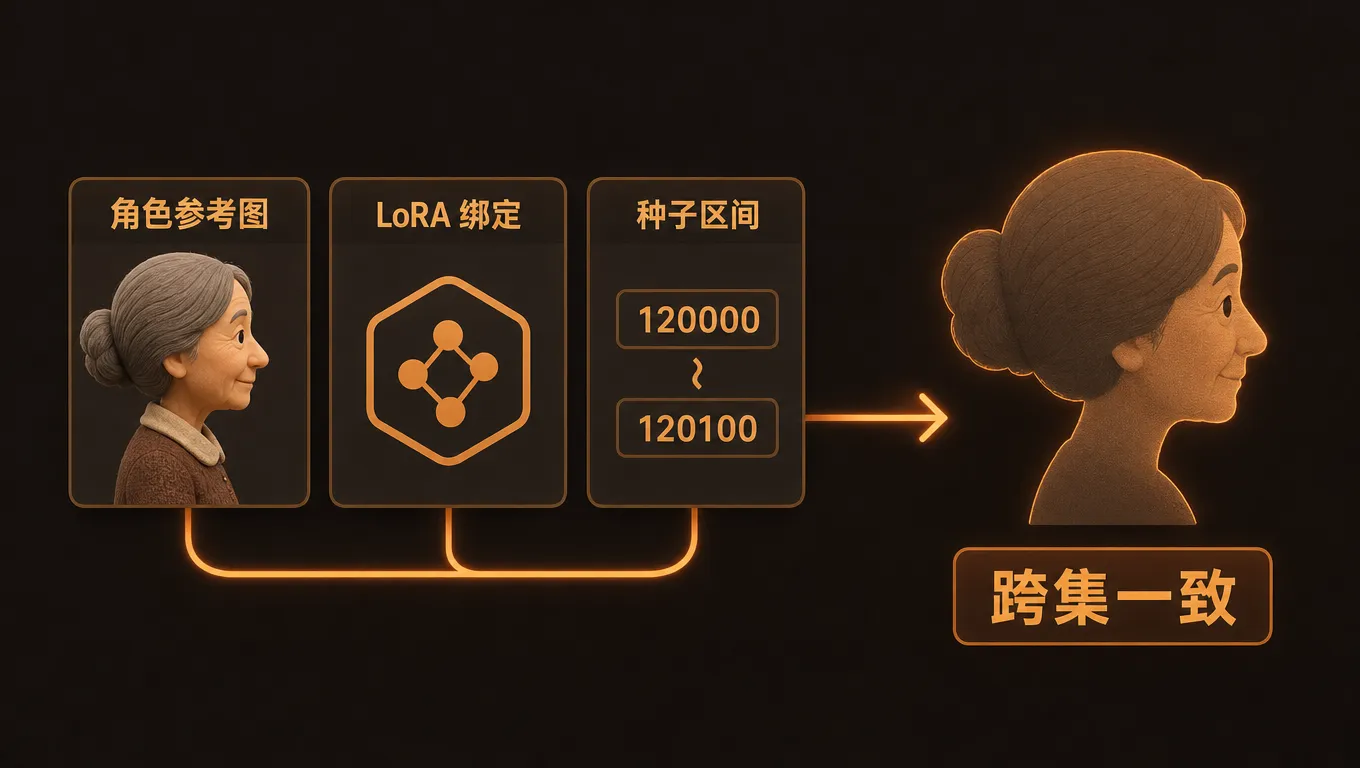
3.1 跨集角色一致性漂移:阿婆变成两个阿婆
卡点:前 5 集阿婆是「银发、簪花围红头巾、旧布鞋鞋尖朝海」;跑到第 30 集和解戏,ComfyUI 重新 roll,出来一张「年轻了十岁、头巾颜色偏掉」的脸。
解法(项目采用的工程策略):
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 手段 | 做法 | 作用 |
| 角色参考图固定 | 锁 3–5 张「阿婆基准图」进每次生成 | 视觉锚点不漂 |
| LoRA 绑定 | 训角色 LoRA,trigger word + strength 固定 | 跨集复用同一张「脸的潜空间」 |
| 种子分区 | 同角色同场景用同一 seed 区间,不全局随机 | 避免每次换脸 |
| ControlNet 双控 | OpenPose(构图)+ Lineart(场景线稿) | 镜头动,但人和场景不散 |
| 人工甄选门槛 | 每集角色图过「相似度 ≥ 90%」才进资产库 | 把漂移挡在剪辑前 |
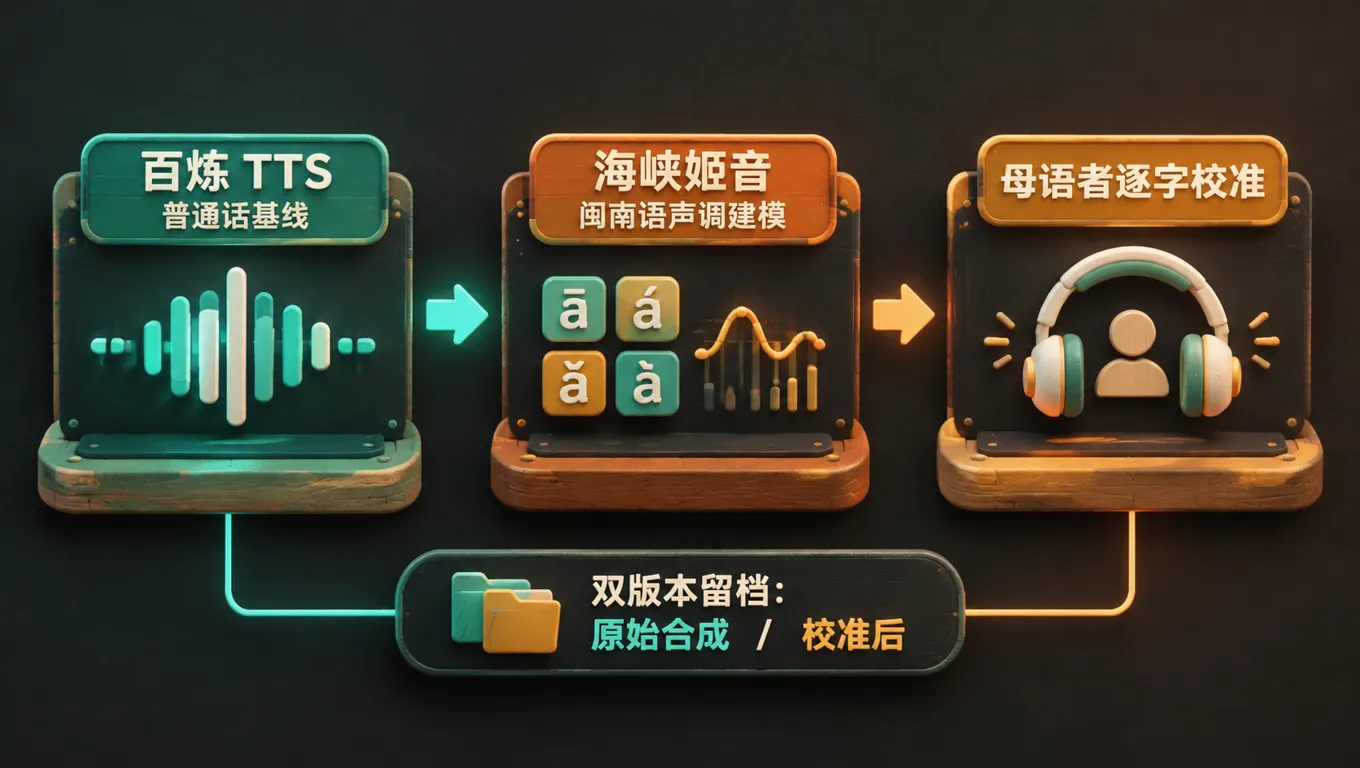
3.2 通用 TTS 念不对闽南语声调:字对、调错
卡点:闽南语常见 7–8 个声调,声调直接承词义。通用中文 TTS 跑「平安」两个字,字出来了,但调不对——整段情绪塌掉。
分层解法:
第一层:百炼 TTS(普通话基线)
   → 先跑普通话对照音轨,校验台词文本、断句、情绪标记对不对
第二层:海峡姬音(垂直方言引擎,项目披露口径)
→ 从音素层为闽南语声调单独建模
→ 项目方披露:5–10 分钟母语者音频可做声纹适配
→ 参数标注(项目自述,待独立核验):
· 方言识别准确率 ≥92%
· 音素转写 97.82%
· 语音克隆 MOS ≥4.3
第三层:母语者逐字校准(人工必留)
→ AI 合成完,母语者逐字听、逐字改
→ 这一刀不进自动化流水线,写进交付 SOP

📌 诚实边界:上面 ≥92% / 97.82% / MOS≥4.3 是项目方技术披露,不是第三方盲测结论。落地时别直接当「行业基准」,要拿你自己的闽南语测试集算 CER。
3.3 GPU 批量渲染成本控不住:弹性 + 队列
卡点:60 集 × 多镜头,全量并发跑 ComfyUI + AnimateDiff,账单会教你做人。
解法:
- 任务队列化:FC 接收分镜任务 → 进消息队列 → Worker 按并发配额消费
- 弹性伸缩:空闲缩到 0,批量生成时段拉起 GPU 实例
- 重 roll 次数上限:单镜头重 roll ≤ 5 次,名场面才放行实拍兜底
- 缓存命中:同场景背景图、道具图生成一次、跨集复用
- 成本可视:每次生成写
gen_log,字段含「模型 / 分辨率 / 帧数 / 耗时 / 实例类型」
3.3.1 60 集渲染成本估算对比
咱把三种跑法摆做伙看,毋是比「谁便宜」,是看钱花伫佗位。下表按 60 集、每集约 20 个分镜、单镜头 16 帧 AnimateDiff 片段的量级做相对量级估算(以「全量并发无队列」为 100% 基准,实际绝对值随实例规格与地域单价浮动,落地请用自家 gen_log 回算):
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 策略 | GPU 实例时长 | 重 roll 次数 | 预估费用量级 | 主要浪费点 |
| 全量并发无队列 | 峰值拉满,空闲时段仍占实例,约 100% | 无上限,单镜头可 roll 十几次,约 100% | 基准 100%(最高) | 空转实例 + 无效重 roll + 重复生成同场景背景 |
| FC 队列 + 弹性缩容 | 按并发配额消费,空闲缩到 0,约 55%–65% | 仍无硬上限,约 80% | 约 60%–70% | 重 roll 失控 + 同场景资产重复生成 |
| 队列 + 缓存复用 + 重 roll 上限 | 队列 + 缩容 + 缓存命中,约 40%–50% | 单镜头 ≤5 次,约 45%–55% | 约 35%–45%(最低) | 仅剩名场面人工兜底与母语者校准的人力成本 |
⚠️ 读表姿势:上表是相对量级,不是报价单。真实费用 = 实例单价 × 有效 GPU 秒数 + 存储/流量。真正能省下来的,是「空转」和「无效重 roll」这两块,不是把模型换小。
3.3.2 用 gen_log 做成本归因
成本控不住,多半是看不见。所以每次生成都往 OSS /logs/gen_log 落一条结构化记录,字段至少包含:
{
  "task_id": "EP12_S03_shot02",
  "episode": 12,
  "scene_id": "EP12_S03",
  "model": "写实电影感底模_v3",
  "lora": "apo_lin_axit_v1",
  "seed": 8841,
  "resolution": "1080x1920",
  "frames": 16,
  "instance_type": "GPU 实例规格",
  "gpu_seconds": 42.6,
  "retry_index": 2,
  "cache_hit": false,
  "oss_path": "oss://short-drama-pro/clip/ep12/EP12_S03_shot02.mp4",
  "ts": "2026-09-18T14:22:31+08:00"
}

有了这张表,成本归因就是几条聚合查询的事:
- 按集数聚合
gpu_seconds:哪几集烧得凶,通常是重 roll 多的名场面集 - 按
retry_index分组:第 1 次生成 vs 第 2–5 次重 roll 各占多少 GPU 秒,直接量化「重 roll 上限」省了多少 - 按
cache_hit分组:命中率低于 30% 说明场景/道具复用没做起来,缓存策略要回头改 - 按
model+resolution分组:验证「降分辨率试跑、定稿再上高清」到底省不省 - 按
instance_type分组:对比不同 GPU 规格的「每秒有效产出」,别只看单价
咱的做法是每周跑一次归因脚本,把结果写进 /logs/cost_report/,跟 QC 台账放做伙。哪一集的成本异常,回头就能定位到具体镜头、具体 seed、具体重 roll 次数——成本不是月底看账单才知道,是每次生成就记落来。
资产治理:60 集不乱,靠的是「工程纪律」
4.1 资产四域分类
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 域 | 内容 | 治理重点 |
| 剧本域 | 剧本 JSON、分集梗概、台词(含闽南语字段) | 文本唯一源,改一集全链同步 |
| 视觉域 | 角色参考图、场景基设、分镜、关键帧 | 角色/场景/道具 ID 锁定 |
| 声音域 | 百炼基线音轨、海峡姬音方言轨、母语者校准轨 | 保留「原始合成」和「校准后」双版本 |
| 成片域 | 粗剪、调色、字幕、Release 成片 | RC → Release 基线,可回滚 |
4.2 版本基线(RC / Release)
RC1    → 单集可看,角色可能有漂移,进内部评审
RC2    → 角色一致性过检、方言校准补完
v1.0   → Release:过 QC、加 AI 辅助制作标识、可投流/参赛
hotfix → 只改字幕错字/口型帧,不动剧本结构

4.3 交付审计台账
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 台账 | 字段 |
| 生成日志 | 集数、模型、LoRA、seed、分辨率、耗时、OSS 路径 |
| QC 报告 | 角色一致 ✅/❌、方言准确 ✅/❌、口型 ✅/❌、字幕错字计数 |
| AIGC 标识 | 片头「AI 辅助制作」+ 生成工具清单 + 人工收口署名 |
| 授权归档 | 原创剧本声明、配音授权、音乐商用授权凭证 |
商业闭环:一套底座,多语演化
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 场景 | 复用方式 | 方言/多语演化 |
| 政企文旅短剧 | 同套 FC+OSS 管线,换剧本 JSON 和场景资产 | 普通话基线 + 当地方言引擎外接 |
| 博物馆展陈动画 | 文物角色 LoRA 锁定,生成讲解短片 | 可接地方戏曲/少数民族语言 |
| 两岸/侨乡文化内容 | 妈祖信俗、侨批叙事模板化 | 闽南语/客家话/东南亚华语分支 |
| 银发情感科普 | 把「记忆消逝」叙事转成公益短片 | 方言配音 + 字幕双轨 |
给开发团队的直接 SOP(复制带走)
1. 剧本结构化:百炼输出「集/场/角色/台词/资产引用」JSON,闽南语标 lang 字段
2. 资产建库:OSS 建 character/scene/prop 三张表,角色参考图先锁 3–5 张
3. 分镜生成:FC 触发 ComfyUI,LoRA + seed + ControlNet 三锁,单镜头重 roll ≤5
4. 方言配音:百炼 TTS 跑普通话基线 → 海峡姬音补闽南语声调 → 母语者逐字校准
5. 合成封装:口型(正脸近景必做)、字幕(每行≤12字)、三地色温曲线统一
6. 版本治理:RC1 → RC2 → Release,生成日志 + QC 台账写进 OSS /logs
7. 合规收口:片头标「AI 辅助制作」,方言/民俗内容过顾问审核
8. 复用演化:换剧本 JSON + 换场景资产 + 换方言引擎,底座不动

咱兜的最后一句
做 AIGC 短剧,顶毋是「生成」两个字。
生成是容易的,收口才是工程——角色毋通漂、声调毋通错、资产毋通乱、版本毋通找无。阿里云这套栈伫咱手里,毋是魔法棒,是「把导演的判断、母语者的耳朵、开发者的纪律」焊做一条不断掉的底。
《等你平安归来》里阿婆等六十年,等的是一个「平安转来」;咱做落地的人等的,是每一次重 roll 之后,阿婆犹是彼个阿婆。
📚 参考与来源(EEAT 归档)
- 上海嘉定官方通报:《33项单项奖揭晓,53位创作者达成入驻意向!第四届上海国际AIGC创新大赛在嘉定落幕》,2026-09-30
- 《竖屏短剧〈等你平安歸來〉》:60 集规格、制作周期约 35 天、AIGC 辅助比例、海峡姬音幕后配音定位
- 阿里云「AI 剧本生成与动画创作」解决方案页(FC / 百炼 / OSS / 图像视频生成能力说明)|AI 剧本生成与动画创作-阿里云技术解决方案
- 阿里云函数计算 FC 官方文档:事件驱动、自定义运行时、弹性实例|https://help.aliyun.com/products/509384.html
- 阿里云百炼大模型服务官方文档:模型调用、应用编排、TTS 语音合成|全链路模型服务应用构建-大模型服务平台百炼-阿里云_大模型服务平台百炼(Model Studio)-大模型服务平台百炼(Model Studio)-阿里云帮助中心
- 阿里云对象存储 OSS 官方文档:目录规范、版本化、事件通知|https://help.aliyun.com/products/31815.html
- ComfyUI 官方开源仓库:节点式扩散模型工作流|GitHub - Comfy-Org/ComfyUI: The most powerful and modular diffusion model GUI, api and backend with a graph/nodes interface. The fastest local inference engine in the world. · GitHub
- AnimateDiff 官方开源仓库:文生视频运动模块|GitHub - guoyww/AnimateDiff: Official implementation of AnimateDiff. · GitHub
- 「海峡姬音」项目方技术披露(MoE / IPA / 声纹适配 5–10 分钟):项目自述口径,标待独立核验
- 清华 × 巨人网络 DiaMoE-TTS:IPA 前端 + 方言感知 MoE + 低资源适配,2025-10

☕ 关于作者
白天调模型,晚上调乡音,中间靠一杯茶续命。
圈里叫我辣董:技术里最懂剧本的,剧组里最会写代码的。
教 AI 说方言,比哄娃吃饭还费劲,但咱干工程的:毋通光说不练!
想用技术留住乡音的朋友,评论区呷杯茶,慢慢唠🍵
🏷️ #AI底层架构师 #方言AI敲门者 #AIGC实战派 #爱写代码也爱看剧本 #台青创业者