面试 Hadoop,十有八九会被问一句:「HDFS 的 Block 为什么默认是 128M,不是 64M,也不是 256M?」很多人背得出「因为寻址时间是传输时间的 1%」,但追问一句「这个 1% 是怎么来的、100M 为什么最后落成了 128M、生产上又该怎么调」,就容易卡壳。
这篇把 Block 大小背后的工程账算清楚:它不是拍脑袋定的数字,而是磁盘寻址时间、传输速率和 NameNode 内存三者之间权衡出来的结果。
30 秒建立心智模型
先记住三句话:
- HDFS 把文件按固定大小切成 Block 存储,Hadoop 1.x 默认 64M,2.x/3.x 默认 128M,由参数
dfs.blocksize决定。 - Block 大小的本质矛盾:太小,Block 数量多,NameNode 内存撑不住、寻址开销占比高;太大,单个 Block 从磁盘读出来的传输时间远大于寻址时间,吞吐被拖慢。
- 128M 的来历:寻址时间约 10ms,工程上希望寻址时间只占传输时间的 1%,算出传输时间约 1 秒;按当时磁盘 100MB/s 的速率,1 秒传约 100MB,再对齐到二进制幂次,就取了 128M。
一、先纠正一个常见误解:Block 不预留整块磁盘空间
很多人以为「上传一个 1KB 的小文件,HDFS 会给它占满一个 128M 的 Block」。恰恰相反。
Block 是 HDFS 逻辑上的分片上限,不是物理预留。一个 1KB 的文件上传后,逻辑上确实对应 1 个 Block,但这个 Block 在 DataNode 磁盘上实际只占 1KB 的真实数据,不会把剩下的 127M 填满。真正占磁盘的是数据本身,Block 大小只决定「一个文件最多切成多大的片」。
一个 200MB 的文件:
  block_1 = 128MB(满块)
  block_2 =  72MB(尾块,实际只占 72MB 磁盘)

一个 1KB 的文件:
  block_1 = 1KB(尾块,实际只占 1KB 磁盘)
这个误解之所以重要,是因为它引出了 Block 大小真正影响的地方——NameNode 的内存。每个 Block 的元数据(属于哪个文件、副本在哪几个 DataNode)都常驻 NameNode 内存。Block 越小,同样的数据被切得越碎,Block 数量越多,NameNode 要维护的元数据条目就越多。
二、Block 太小会怎样:寻址开销和 NameNode 内存
HDFS 的设计目标是高吞吐,而不是低延迟随机读写。一个 Block 的读取过程分两步:
- 寻址(seek):磁头找到 Block 的起始位置,机械盘大约要 10ms;
- 传输(transfer):把 Block 数据从磁盘读出来通过网络传给客户端。
如果 Block 设得很小,比如 1M,那么读一个 100G 的文件就要切出约 10 万个 Block。客户端读每个 Block 都要先向 NameNode 问一次位置、再连一次 DataNode,10 万次寻址每次 10ms,光找位置就要花掉上千秒,真正传数据的时间反而被淹没在寻址里。这就像翻一本 10 万页的书,每页只印一句话——时间全花在翻页上。
同时,这 10 万个 Block 的元数据都要 NameNode 记在内存里。经验值是每个 Block(含文件副本信息)大约占 NameNode 内存 150 字节左右。Block 数量每翻一倍,NameNode 内存就近似翻一倍——这也是 HDFS 「小文件问题」的根源。
算一笔账:如果存的是 1 亿个 1KB 的小文件,就会有 1 亿个 Block,光 Block 元数据就要吃掉 NameNode 十几个 GB 内存,还没算目录树、权限等其他开销。而同样这批数据如果合并成几个大文件、每个切成 128M 的 Block,Block 数量可能只有几百个,NameNode 内存压力瞬间降几个数量级。这就是为什么 HDFS 天生为大文件、一次写入多次读取设计,而不是为海量小文件设计。
还有一个容易被忽略的代价:Block 数量直接决定了上层计算的并行度。MapReduce 里一个 InputSplit 默认近似对应一个 Block,Block 切得越碎,Map 任务越多;可任务调度本身有开销,几百个碎块对应的调度、启动、数据混洗成本,往往比真正读数据还高。
三、Block 太大会怎样:传输时间反客为主
那 Block 设大一点行不行?比如设成 1G。问题反过来了:寻址时间固定在 10ms 左右,可单个 Block 的数据传输时间变长了。
读一个 1G 的 Block,按 100MB/s 要传 10 秒。这 10 秒里,磁头真正「找位置」只花了 10ms,剩下 99.9% 的时间都在等数据从磁盘搬出来。单看一个 Block 似乎没什么,但 HDFS 是多 Block 并行读的:Block 太大、数量太少,MapReduce 这类任务的 Map 并行度就上不去,作业的启动和调度开销占比升高,整个集群的吞吐和并发度反而下降。
所以 Block 大小是一个两头都不能极端的折中:
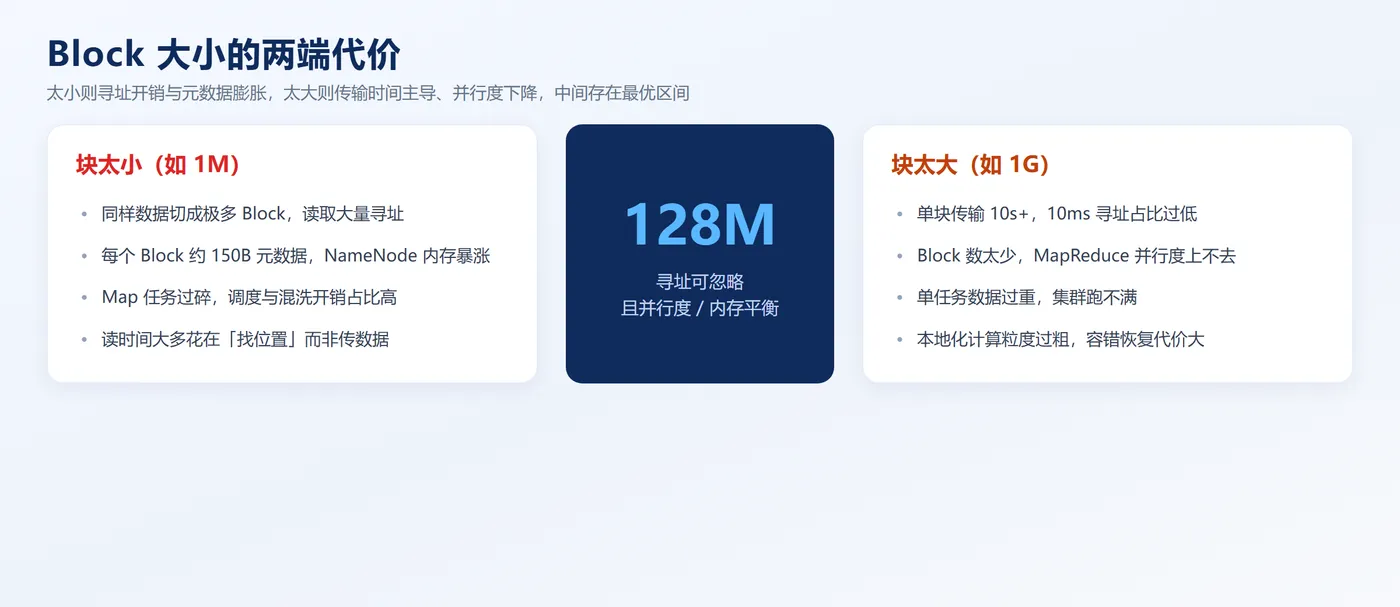
这里还有一个深层原因:HDFS 的设计哲学是「计算向数据移动」(data locality)。理想状态下,计算任务尽量调度到 Block 所在的 DataNode 本地执行,避免把数据搬过网络。一个 Block 就是一次本地化计算的基本单位——Block 太小,本地化的机会被切碎、调度次数暴涨;Block 太大,单台机器一次要处理的数据量过重、任务数太少,集群又跑不满。128M 正是让「每个 Map 读一个块、做一批本地计算」这个粒度最舒服的尺寸。
四、128M 这个数是怎么算出来的
Hadoop 早期在设计默认值时,做了一个很朴素的工程假设:让寻址时间在整个读取时间里占比尽量小,实践中取 1% 时机器性能最佳。推导过程是这样的:
平均寻址时间(seek)        ≈ 10ms
希望寻址时间 / 传输时间     ≈ 1%(即 0.01)
=> 传输时间 ≈ 10ms / 0.01 = 1000ms = 1s
当时磁盘普遍传输速率         ≈ 100MB/s
=> 最优 Block 大小 ≈ 100MB/s × 1s = 100MB
算出来是 100MB,为什么最终落在 128M 而不是 100M?因为计算机用二进制,磁盘容量和内存都是按 2 的幂次划分的,对齐到 2 的幂(64、128、256、512)在寻址和实现上更整齐高效。比 100M 大、且最接近的 2 的幂就是 128M(2 的 7 次方),于是默认 Block 就定成了 128M。
这里也能看出 Hadoop 的一个风格:它不追求理论上的「最优 100M」,而是选一个工程上最好实现、最不容易出错的整齐值。这种「对齐到二进制幂」的取舍在 HDFS 里随处可见——块大小、缓冲区、packet 大小都是 2 的幂,底层按扇区和页对齐时能少做很多边界判断。
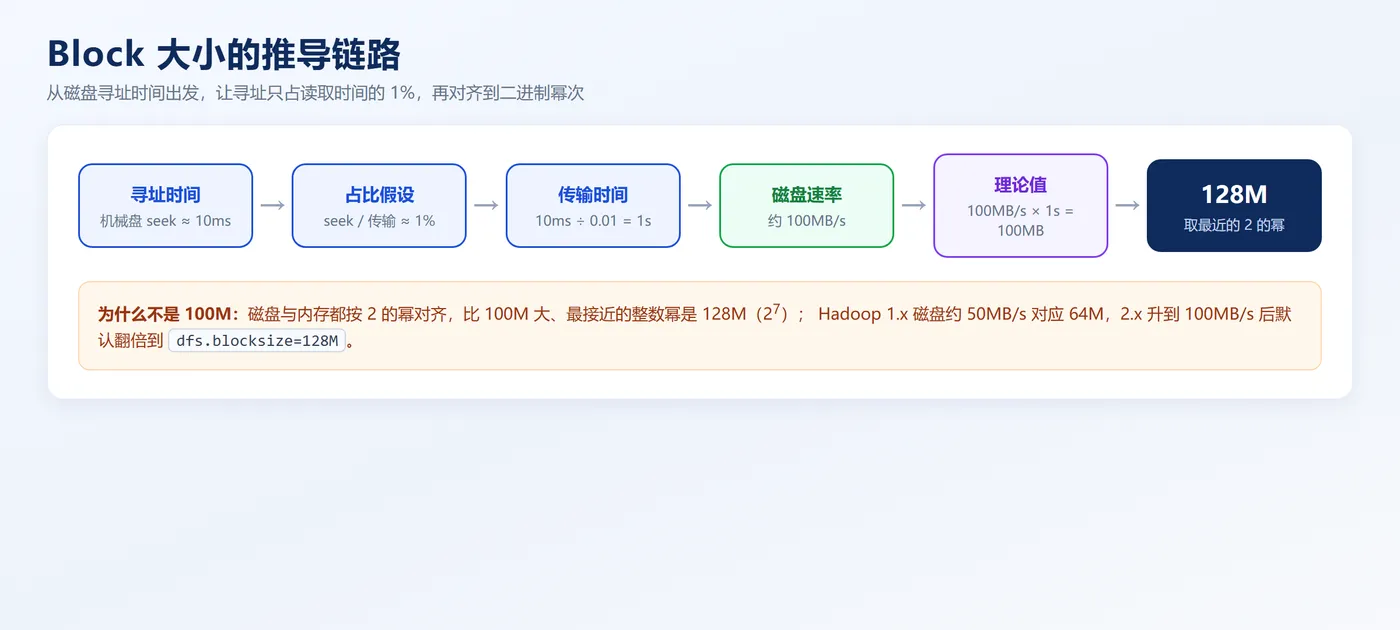
这个推导也解释了另一个面试点:Hadoop 1.x 为什么是 64M。那年代磁盘传输速率更慢,约 50MB/s 量级,按同样方法算出的最优值更接近 64M;等到 2.x 时代磁盘升到 100MB/s,默认值也随之翻倍到 128M。
五、生产环境到底该设多大
dfs.blocksize 不是只能用默认值,它跟磁盘传输速率强相关。Notion 笔记里给的经验值很直接:
<!-- hdfs-site.xml:按磁盘传输速率调整 -->
<property>
  <name>dfs.blocksize</name>
  <!-- 单位字节:128M=134217728,256M=268435456,512M=536870912 -->
  <value>134217728</value>
  <description>单个 Block 的大小,按磁盘传输速率权衡</description>
</property>
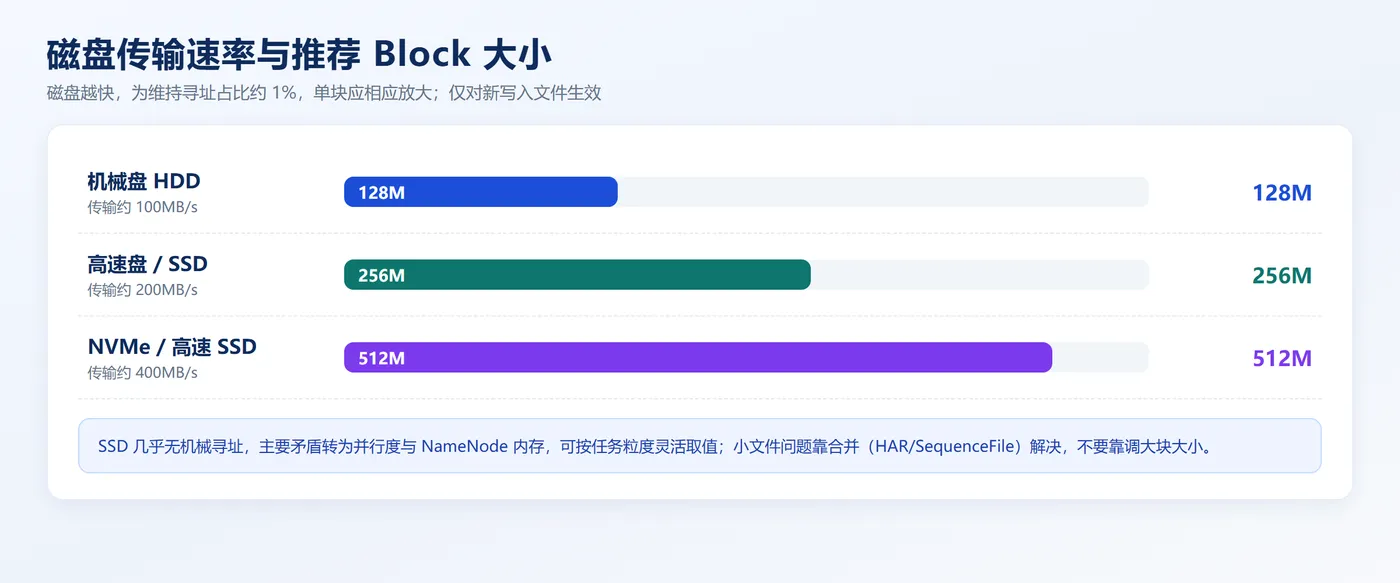
- 普通机械盘、传输速率约 100MB/s:保持默认 128M;
- SSD 或高速盘、传输速率约 200MB/s:可调到 256M;
- 高速盘、传输速率约 400MB/s:可调到 512M。
需要强调两点:
- Block 大小只影响新写入的文件。修改
dfs.blocksize后,已经存在于 HDFS 上的老文件不会被重新切分,只有之后新上传的文件才按新块大小切分。 - 别盲目调大。如果你的业务有大量小文件,问题不在 Block 大小,而在文件数量本身——调大 Block 既救不了 NameNode 内存,也让小文件更碎,应该走 HAR、SequenceFile 或者合并小文件的路子。
算一个直观的量级:一个 1TB 的文件,按 128M 切大约是 8192 个 Block,按 64M 切就是约 16384 个 Block。Block 数翻倍,意味着 MapReduce 的 Map 任务数近似翻倍、NameNode 要维护的元数据条目也翻倍。磁盘越快,传输同样数据花的时间越短,为了让「寻址占比仍维持在 1%」,Block 就该相应放大——这正是 200MB/s 盘用 256M、400MB/s 盘用 512M 的原因。
这里要多说一句:10ms 寻址时间是机械硬盘(HDD)的经验值。SSD 几乎没有机械寻道,随机读延迟降到几十微秒量级,寻址这一项基本可以忽略,此时 Block 大小的主要矛盾就从「摊薄寻址」变成了「控制并行度和 NameNode 内存」。所以在全 SSD 的新集群上,Block 不必死守 128M,可以结合任务并行度和单盘带宽更灵活地取值——这也是为什么今天很多新集群会直接上 256M 甚至 512M。
六、几个高频误区
- 误区一:1KB 文件会占满 128M。 不会,Block 是逻辑分片上限,尾块实际占多少就是多少。
- 误区二:Block 越大越好、越快。 太大让传输时间占比过高、并行度下降,反而拖慢任务。
- 误区三:改了
dfs.blocksize老文件就生效。 不生效,只对新写入的文件有效。 - 误区四:Block 默认 128M 是全集群写死的。 它是客户端写文件时按当时配置切的,可以按目录或按上传时的配置灵活设置。
- 误区五:把 Block 当成写入时的数据包大小。 不是。写管线里在 Client 和 DataNode 之间流动的是约 64KB 的 packet,那是传输单元;128M 的 Block 是落盘和元数据管理单元,两者不在一个层级上。
查看一个文件实际被切成了哪些 Block:
# 查看文件的 Block 信息与位置
hdfs fsck /path/to/file -files -blocks -locations
写在最后
Block 为什么是 128M,本质上不是一个「存储」问题,而是一个「时间」问题——HDFS 用固定块大小在和磁盘的物理特性做博弈:块要大到让寻址时间可以忽略,又要小到让 NameNode 内存扛得住、让计算任务有足够的并行度。128M 只是 2010 年前后那块 100MB/s 磁盘上的最优解,放到今天的 SSD、放到 TB 级单文件场景,这个数字本来就该随硬件一起演化。
真正值得记住的是背后那条工程原则:任何默认值都是特定年代硬件的最优折中,换了硬件就该重新算一遍。 下次调 Block 之前,先看看你集群磁盘的实际传输速率,再决定是 128、256 还是 512,而不是照抄模板。