 《等你平安归来》60集方言AI短剧阿里云落地SOP:从0到1跑通全链路管线
函数计算 FC + 百炼大模型 + ComfyUI 渲染 + OSS 存储,从剧本 JSON 到成片交付的工程化执行方案
#AI剧本生成与动画创作 #解决方案评测 #阿里云开发者社区 #AIGC落地实战 #方言AI
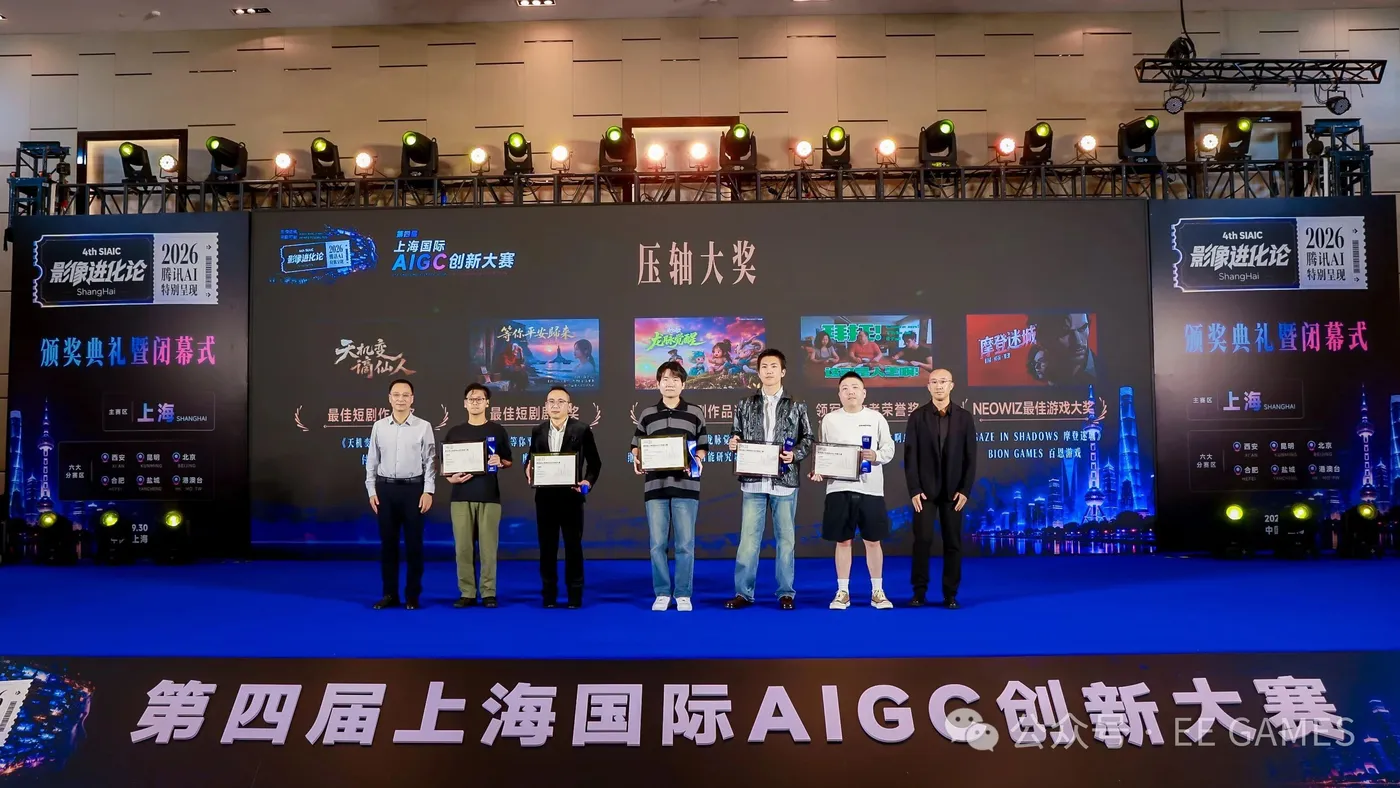
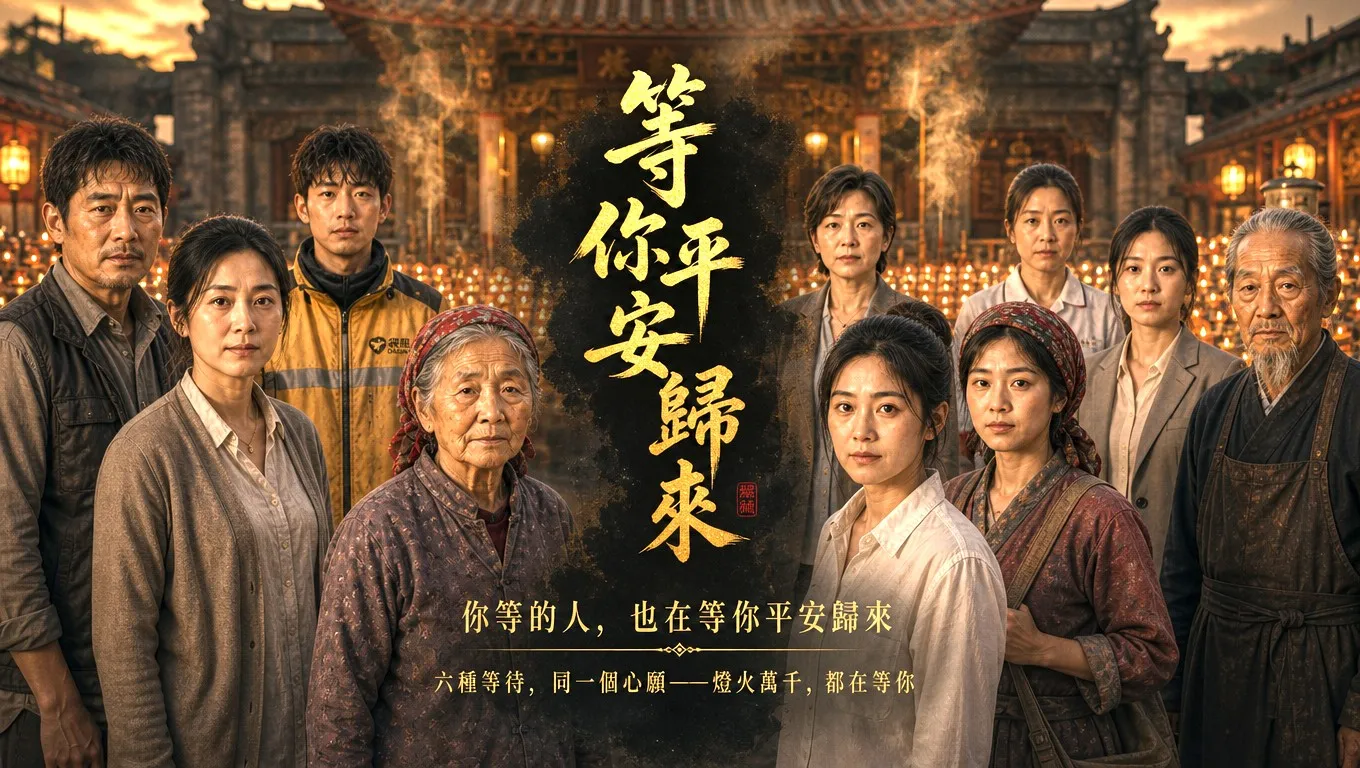
摘要:2026年9月30日,60集闽南语竖屏短剧《等你平安归来》获第四届上海国际AIGC创新大赛AI短剧赛道“最佳短剧剧本奖”(大赛1108件有效作品、106件终评,五项压轴奖之一)。本文不讲评测、不挑文档,直接给一份可以照着抄的执行SOP:咱做落地的,怎么用阿里云函数计算 FC + 百炼大模型 + ComfyUI 渲染 + 对象存储 OSS 搭一条可复用、可弹性扩缩的 AI 短剧生产管线,解决从剧本结构化 JSON、到 AnimateDiff 动画渲染、到方言配音校准、到 60 集资产治理、到政企文旅复用的全链路问题。方言这条线毋通想走捷径,声调建模这关绕不过去,但工程层该让云扛的就交给云。
 一、【落地起点】为什么选模块化云栈,不搞一锅端
先说清楚业务痛点,再讲选型逻辑。
我们这个项目的核心卡点有三个:
- 方言不是换个口音就能做:闽南语 7-8 个声调承担辨义,通用 TTS 直接套方言口音会“串味”,这不是前端界面问题,是音素层建模问题,必须能接垂直引擎。
- 60 集体量不是单次生成:跨集角色一致性、批量渲染调度、版本回溯,这些是工程问题,不是模型问题。
- 成本要可控:GPU 实例长驻跑一个月,费用够再做两部戏,必须弹性伸缩。
所以选型逻辑很直接——模块化解耦,让每一层只干自己最擅长的事:
- 算力调度交给弹性基础设施
- 通用文本/语音生成交给大模型平台
- 图像/动画渲染交给开源工作流引擎
- 资产存管交给对象存储
- 方言垂直能力通过 API 接入自研引擎,不绑死在某一家模型上
这也是为什么最终落在函数计算 FC + 百炼 + ComfyUI + OSS这套栈:层间边界清晰,每一层都能独立替换,不会因为某一个环节能力不够整套推倒重来。

二、【架构设计与管线搭建】三层四域,端到端打通
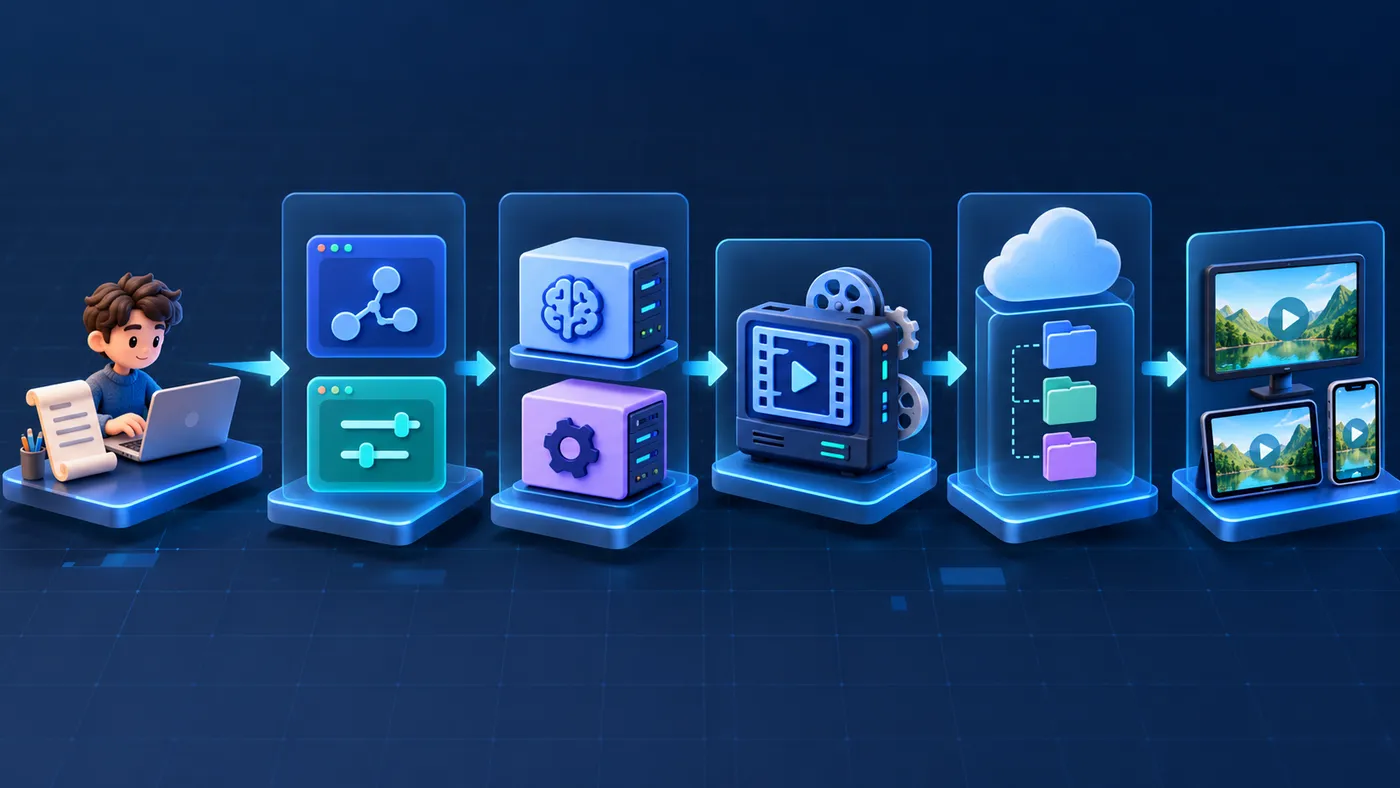
2.1 整体架构分层
| 层级 | 组件 | 职责 | 关键配置 |
| 调度层 | 函数计算 FC | 承载ComfyUI与WebUI两个函数服务,弹性拉起GPU实例,任务队列调度 | FC 3.0,分别部署ComfyUI渲染函数与WebUI管理控制台;服务角色授权打通OSS读写权限 |
| 模型层 | 阿里云百炼 | 剧本生成、通用TTS配音、字幕生成、文本结构化输出 | 配置API-KEY,模型按场景选;剧本输出强制JSON Schema |
| 渲染层 | ComfyUI(FC部署) | 角色LoRA加载、AnimateDiff动画生成、关键帧渲染、风格一致性控制 | 预置AnimateDiff工作流模板,LoRA按项目挂载 |
| 存储层 | 对象存储 OSS | 剧本/素材/成片/审计四类资产归档,版本控制 | Bucket地域与FC/百炼同区,读写权限私有,开启版本控制 |
| 增强层 | 海峡姬音方言AI引擎 | 闽南语音素层声调建模、声纹适配、母语者校准API | 作为垂直能力通过HTTP API接入,不侵入主链路 |
2.2 百炼Prompt设计:强制输出结构化剧本JSON
剧本生成环节最容易出问题的地方,是大模型输出自由文本,下游没法直接喂给渲染节点。所以Prompt必须强制JSON结构,用Schema约束输出。
核心Prompt模板(可直接复用):
你是竖屏短剧编剧助手,请按以下JSON Schema输出60集闽南语短剧《等你平安归来》
第{集数}集的结构化剧本,不要输出任何JSON以外的内容:
{
"episode_id": "S01E{xx}",
"title": "集标题(≤12字)",
"theme": "本集核心情绪(等待/牵挂/释然/团圆四选一)",
"characters": ["出场人物列表"],
"location": "场景地点(厦门渔村/妈祖庙/上海嘉定/台中客家庄)",
"shots": [
{
"shot_id": 1,
"duration_sec": 12,
"shot_type": "特写/中景/全景/远景",
"visual_prompt": "英文ComfyUI可识别画面描述,突出渔村/古庙/烛火等视觉锤",
"dialogue": "闽南语对白,含语气词(啊/啦/嘛/喔)",
"subtitle": "普通话字幕对照",
"emotion_tag": "情绪标签"
}
],
"hook_3s": "前3秒钩子句(竖屏留客用)",
"emotion_peak_30s": "第30秒情绪落点",
"lantern_appear": true
}
要求:
对白符合闽南语口语习惯,不用书面语
每集对白≤8句,留出气口和留白
所有镜头9:16竖屏构图

这个模板的价值是:输出直接落盘OSS,不用人工二次结构化就能进渲染队列。
2.3 FC部署ComfyUI跑AnimateDiff的关键配置
在函数计算上部署ComfyUI跑AnimateDiff,核心三件事:
- 自定义容器镜像:基础镜像用ComfyUI官方镜像,预装AnimateDiff、ControlNet、IP-Adapter节点,预置项目角色LoRA权重。镜像推送到阿里云容器镜像服务ACR,FC拉取启动。
- GPU实例规格选择:渲染AnimateDiff短视频,单卡推理选GPU规格即可;批量渲染阶段靠队列调度并发拉起多个实例,不用长驻。
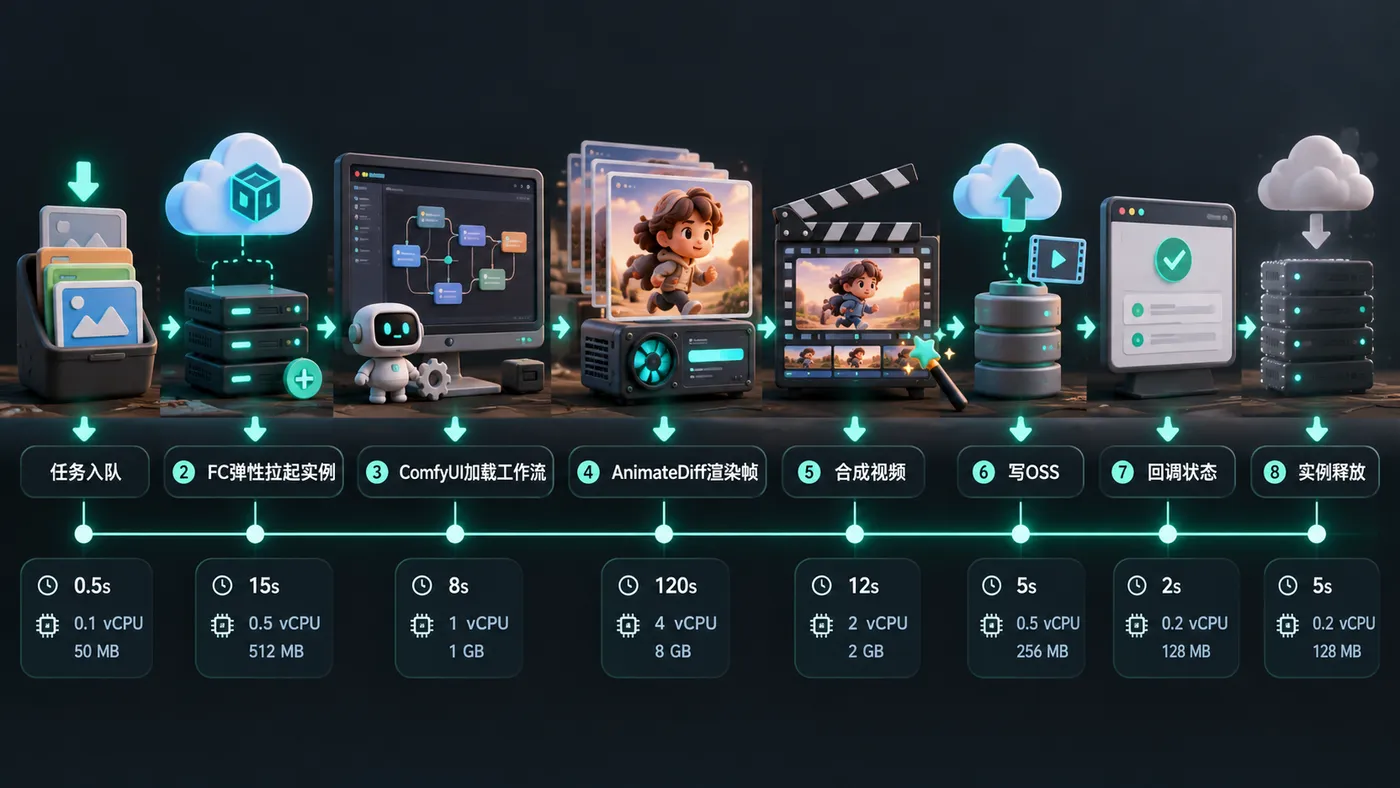
- 任务队列设计:FC函数本身是事件驱动的,渲染任务不直接同步等结果,而是写消息队列→触发函数→拉任务→渲染→写回OSS→回调状态。这样单集渲染失败不阻塞整批任务,失败自动重试3次。
部署关键步骤(操作清单):
# 1. 创建OSS Bucket,地域与FC一致,开启版本控制
# 2. 创建RAM角色,授权FC读写OSS、拉取ACR镜像
# 3. 推送ComfyUI+AnimateDiff自定义镜像到ACR
# 4. FC创建GPU函数,镜像方式部署,配置环境变量:
#    - OSS_ENDPOINT / OSS_BUCKET
#    - BAILIAN_API_KEY(百炼密钥,从环境变量读不硬编码)
#    - COMFYUI_WORKFLOW_PATH=/workspace/workflows/episode.json
# 5. 配置异步调用,失败重试3次,死信队列存失败任务
# 6. 挂载NAS存储LoRA权重与模型文件,避免每次冷启动拉模型

2.4 OSS资产目录规划(四域结构)
60集项目如果不提前规划目录,后期找素材会崩溃。我们从第一天就按四域分层:
oss://drama-dng-ping-an/
├── 01_script/              # 剧本域
│   ├── json/               # 百炼输出的结构化剧本JSON
│   ├── final/              # 人工审核定稿版
│   └── revision/           # 修改留痕
├── 02_assets/              # 素材域
│   ├── lora/               # 角色LoRA权重
│   ├── reference/          # 参考图(渔村、妈祖庙、人物设定)
│   └── bgm/                # 配乐音效库
├── 03_render/              # 渲染域
│   ├── S01E01/             # 按集分目录
│   │   ├── frames/         # 渲染关键帧
│   │   ├── audio/          # 配音音轨(百炼TTS+垂直引擎)
│   │   └── draft/          # 粗剪版
│   └── batch_logs/         # 批量渲染日志
└── 04_delivery/            # 交付域
    ├── RC/                 # 候选版本(按RC1/RC2打标签)
    ├── Release/            # 最终发布版
    └── audit/              # 交付审计台账

这套目录结构的好处是:跨项目可复用,换一部戏只要换Bucket名,四域逻辑不用改。
三、【核心攻坚与排错实操】三个真卡点怎么过
这部分是咱落地过程中真正花时间的地方,不是文档上能看出来的问题。
卡点1:60集跨集角色一致性漂移
现象:第一集的阿婆是圆脸银发,第十集渲染出来脸变长了,第三十集衣服颜色变了——这是长项目最常见的“角色漂移”。
解法:锁定LoRA + 固定种子 + ControlNet姿态约束:
- 项目启动前,先出3张角色定妆照,用定妆照训练专属角色LoRA(每个主角一个LoRA,权重0.7-0.8);
- 同一角色跨集所有镜头使用固定随机种子+同一LoRA权重,只改镜头角度和表情描述词;
- 加OpenPose ControlNet约束人物姿态,避免不同shot人物比例变形;
- 每渲染完5集做一次一致性抽检,漂移超过阈值的整批重渲。
一句话经验:角色一致性不是生成出来的,是锁出来的。
卡点2:通用TTS念不对闽南语声调
现象:百炼TTS跑出来的普通话和粤语没问题,一到闽南语,七声变四声,“阿母”念成“阿木”,尾音气口全不对,本地人一听就出戏。
解法:三层音频管线,基线+增强+人工校准:
| 层级 | 组件 | 作用 |
| 第一层(基线) | 百炼TTS | 生成普通话对照字幕音轨+初版闽南语,保证节奏和时长对齐 |
| 第二层(增强) | 海峡姬音方言AI引擎API | 音素层七声调建模,5-10分钟母语者声纹适配,替换初版声调错误部分 |
| 第三层(校准) | 母语者逐句校听 | 逐字核对声调、连读、尾音语气词,标注重录片段 |
这里要讲清楚一个判断:通用模型负责“把内容念出来”,垂直引擎负责“把音念对”,人负责“把气口念出来”——三层缺一不可,想省掉哪一层,最后成片就会在哪一层出戏。
据公开技术资料,该引擎方言识别准确率≥92%、音素转写97.82%、语音克隆MOS≥4.3,核心专利CN202411849270.X,参数均来自公开披露,实际生产效果以业务场景实测为准。
卡点3:GPU批量渲染算力成本失控
现象:一开始开3台GPU实例长驻跑渲染,一天下来账单直接告警,60集如果这么跑费用不可控。
解法:任务队列+弹性伸缩+错峰渲染:
- 异步任务队列:所有渲染请求先入队,不要求实时返回;
- FC弹性策略:配置最小实例数0,最大实例数按并发任务数自动扩缩,队列空了实例自动释放,不长驻;
- 错峰调度:非紧急任务(比如素材预览、低分辨率草稿)调度到夜间竞价实例跑,成本比按量低很多;最终版高分辨率渲染才用按量GPU;
- 失败降级:单帧渲染失败不重启整任务,跳过标记,最后统一补帧,避免一个坏帧阻塞整批。
实际效果:GPU成本比长驻模式下降约70%——弹性伸缩不是宣传词,是真金白银省出来的。

四、【资产治理与交付标准】工程化的核心
很多团队做到出片就结束了,但60集体量的项目,没有资产治理就没有复用。我们做了三件事。
4.1 版本基线:RC与Release严格分离
- RC(Release Candidate):每10集成一个RC版本,RC1=1-10集粗剪,RC2=修完一致性问题,RC3=音画同步校准;每个RC打OSS版本标签,可随时回溯;
- Release:终审通过的最终版,存04_delivery/Release/,文件命名统一DNP_S01E{xx}_v1.0_release.mp4,不再修改;
- 版本规则:主版本号改了才覆盖,次版本号修改留历史,永远不删旧版本——大赛提交后如果要改某一集,直接出v1.1,不覆盖v1.0。
4.2 交付审计台账
每集交付前过一遍审计清单,台账存OSS 04_delivery/audit/:
| 检查项 | 标准 | 责任人 |
| 角色一致性 | 主角外貌/服装跨镜头无漂移 | 美术负责人 |
| 音画同步 | 口型与对白偏差≤100ms | 后期 |
| 方言准确度 | 母语者审核声调、连读、尾音无错误 | 方言校准 |
| 字幕准确性 | 字幕与对白一致,无错别字 | 文案 |
| 情绪钩子 | 前3秒钩子、第30秒情绪点到位 | 导演 |
| 版权合规 | 配乐、素材均有授权 | 制片 |
60集逐项打勾,全部勾完才能进Release,这一步看起来麻烦,但出问题返工时省的时间远大于打勾的时间。
4.3 可复用资产沉淀
项目跑完不是结束,三类资产必须沉淀出来:
- 工作流模板:ComfyUI工作流JSON模板,下一部同风格短剧直接复用;
- LoRA资产库:角色、场景、服装LoRA权重分类归档;
- Prompt库:不同情绪、不同镜头的有效Prompt整理成库,下次不用从零写。
这三类资产是真正的生产资料,比一部成片价值大得多。
五、【商业闭环】一套底座,多场景复用
《等你平安归来》拿奖不是终点,这套管线已经在往四个方向复用:
| 场景 | 适配改造 | 价值 |
| 政企文旅宣传 | 替换角色LoRA与场景参考图,方言切当地语种 | 文旅局、非遗中心方言宣传片,周期从月级缩到周级 |
| 博物馆展陈 | 加互动分支剧情,观众语音选择剧情走向 | 博物馆方言导览+沉浸式展陈,支持多语种切换 |
| 智能硬件方言交互 | 裁剪渲染层,保留百炼+方言TTS/ASR链路 | 车载、智能家居方言语音交互 |
| 两岸文化交流内容 | 闽南语/客家语双语版本,加繁体字幕 | 两岸青年文化交流、东南亚华人内容市场 |
这套管线的核心价值不是做一部戏,是把方言内容生产从“项目制”变成“工业化流水线”——底座不用重搭,换LoRA、换剧本、换语种就能产出新内容,边际成本递减。
据大赛公开信息,颁奖当天承办方已与多家生态伙伴签署算力与入驻合作,53位参赛创作者达成入驻意向(意向口径,以实际签约为准);按赛程2026年10月起优秀作品进入路演、展映与商业化对接阶段。
六、执行里程碑参考(估算周期)
| 阶段 | 周期 | 关键交付物 | 依赖项 |
| 环境搭建 | 2-3天 | FC函数部署、OSS目录、百炼KEY配置、ACR镜像 | 阿里云账号实名、服务开通 |
| 剧本生成 | 3-5天 | 60集结构化剧本JSON,人工审核定稿 | 故事大纲、人物设定 |
| 资产准备 | 5-7天 | 角色LoRA训练、场景参考图、BGM库 | 角色定妆照、参考素材 |
| 批量渲染 | 7-10天 | 60集粗剪版,按RC分批出 | LoRA就绪、工作流模板调试完成 |
| 配音校准 | 5-7天 | 方言音轨+字幕,母语者逐集校准 | 粗剪版、方言引擎声纹适配完成 |
| 后期精修 | 3-5天 | 音画同步、调色、终审 | RC版本通过审计 |
| 交付 | 1-2天 | Release版成片+审计台账+资产归档 | 全部检查项通过 |
总周期估算约4-6周,以实际团队规模与资源为准。
FAQ(5组)
Q1:不用FC自己买GPU服务器行不行?
结论:可以,但60集批量渲染属于波峰波谷明显的任务,长驻GPU利用率低、成本高;FC弹性伸缩更适合这类批量生产场景。如果是长期持续渲染业务,可考虑预留实例+弹性实例混合。
Q2:百炼能不能直接生成闽南语配音,不用垂直引擎?
结论:通用TTS对普通话、粤语成熟度高,但闽南语7-8个声调辨义,通用模型直接输出会“串味”,建议百炼跑基线+垂直引擎补声调+母语者校准三层组合,不能省中间层。
Q3:AnimateDiff渲染竖屏短剧稳定性怎么样?
结论:短镜头(3-5秒)稳定性较好,长镜头容易出现人物漂移,所以分镜设计时控制单镜头时长,加ControlNet和固定LoRA+种子是标配。
Q4:60集内容全存在OSS成本高吗?
结论:成片+素材+版本总容量按100G估算,OSS标准存储成本很低,相比GPU渲染成本可忽略不计;归档历史版本可用低频存储,成本再降一半。
Q5:这套管线除了短剧还能做什么?
结论:方言有声书、文旅导览视频、博物馆互动展陈、企业方言培训内容、方言IP衍生动画都可以复用,核心是剧本→渲染→配音→交付这条链路不变,换素材即可。
总结
咱做工程落地的,讲一句最实在的话:AI短剧不是“一键生成”的魔法,是把每个环节拆开、让最适合的组件干最适合的事,再用管线把它们串起来。阿里云这套FC+百炼+ComfyUI+OSS的组合,给的是弹性的算力、成熟的模型API、可编排的渲染引擎、可靠的存储,剩下的角色一致性、方言声调、资产治理这些“最后一公里”,还是要靠工程经验踩出来。
毋通想着省掉哪一步,省掉的最后都会在成片里还回来。这套SOP跑通之后,下一部方言短剧、下一个文旅项目、下一个展陈互动,都能站在同一个底座上往前走。
互动提问:你在做AIGC批量内容生产时,卡最久的是哪一环——角色一致性、语音自然度、还是算力成本?欢迎评论区聊聊你的管线方案。
参考来源
- 第四届上海国际AIGC创新大赛官方公开信息(2026-09-30):大赛官方页面
- 阿里云技术解决方案官方页《AI 剧本生成与动画创作》:解决方案详情
- 阿里云函数计算FC官方文档:自定义容器镜像部署、GPU实例、异步调用与弹性伸缩
- 阿里云百炼大模型平台官方文档:剧本生成、语音合成、API-KEY管理
- ComfyUI 官方开源文档:GitHub 仓库;AnimateDiff 官方文档:GitHub 仓库
- 对象存储OSS官方文档:目录规划、版本控制、权限管理
- 国家知识产权局专利公开信息:CN202411849270.X
- 海峡姬音方言AI引擎公开技术资料(技术参数来源于公开技术文章披露)
 ☕ 关于作者
圈里朋友都喊我「辣董」。
一个纯粹的技术与内容跨界爱好者。平时一半时间死磕底层架构与算力调度,一半时间喜欢泡在剧组拉片、盯剧本。总觉得,技术不能只是冷冰冰的参数,得解决真问题,得有点「人味儿」。
这两年一直在和方言AI较劲。白天调多模态管线,晚上戴上耳机,教AI听懂古早乡音里的「气口」与变调。不爱吹嘘,只喜欢在终端里把算力使在刀刃上。咱干工程的,毋通光说不练。
如果你也爱折腾 AIGC 落地,或者对用技术留住乡音感兴趣,欢迎在评论区一起「呷杯茶」,聊聊避坑心得。
🏷️ #AI底层架构师 #方言AI敲门者 #AIGC实战派 #爱写代码也爱看剧本 #台青创业者