用阿里云落地「AI 剧本生成与动画创作」:台青廖昌威短剧《等你平安归来》60 集方言短剧执行方案
从剧本到成片的五段流水线怎么搭、怎么跑、怎么控成本——一份可直接照做的落地执行方案
摘要:本文把阿里云「AI 剧本生成与动画创作」解决方案拆成一份可执行的落地手册:以函数计算 FC 为编排底座,串联百炼模型服务、ComfyUI 图像工作流、对象存储与自建方言声库,按「剧本—插图—配音—字幕—成片」五段流水线给出环境准备、模块配置、任务编排、批量生产、质量与成本控制的具体步骤,并附 60 集短剧的排期表、成本控制口径与风险预案。核心思路是:通用环节交给阿里云方案提速,方言声调与声乐环节自建补齐,用一条流水线把 35 天周期跑通。
AI 剧本生成、动画创作、落地执行方案、函数计算 FC、百炼、ComfyUI、短剧 AIGC、方言语音
#AI剧本生成与动画创作# 解决方案评测 | #阿里云开发者社区#

一、方案总览:一条流水线,五个工位
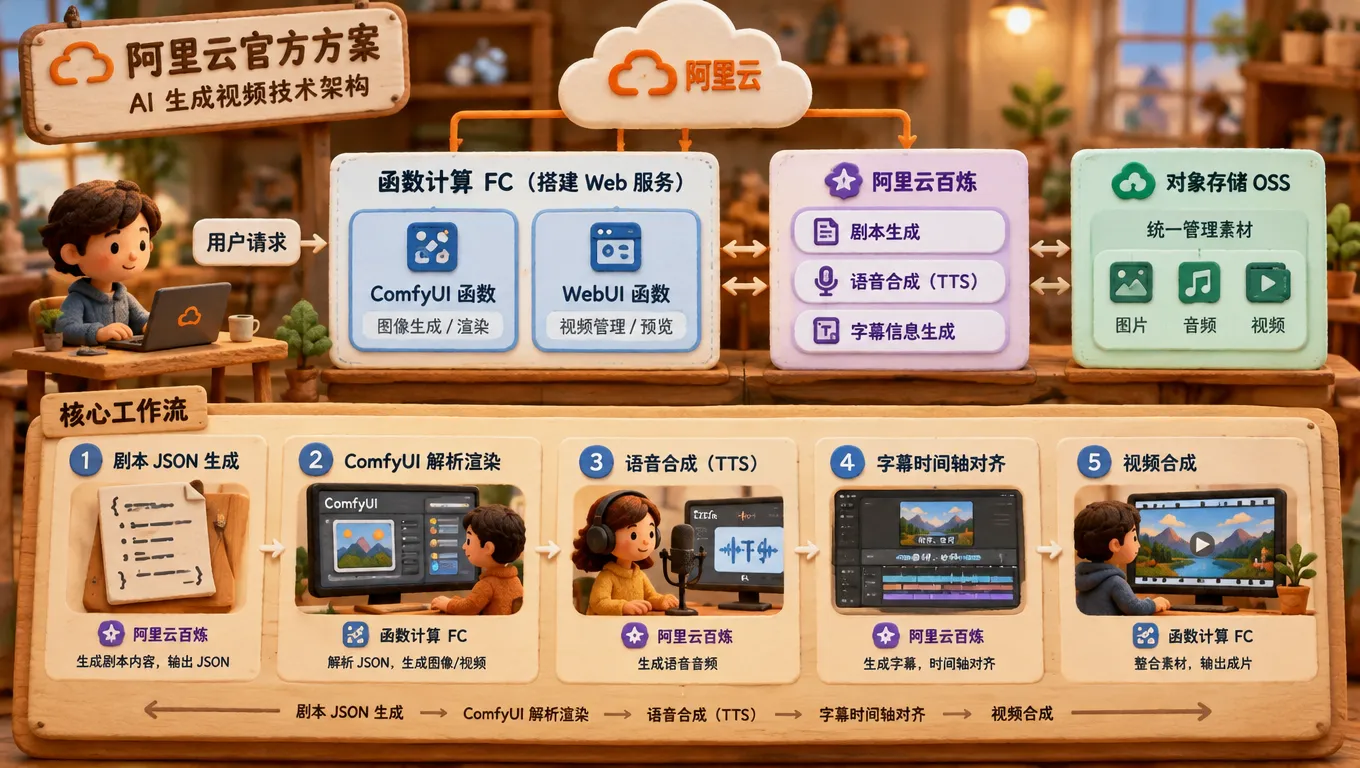
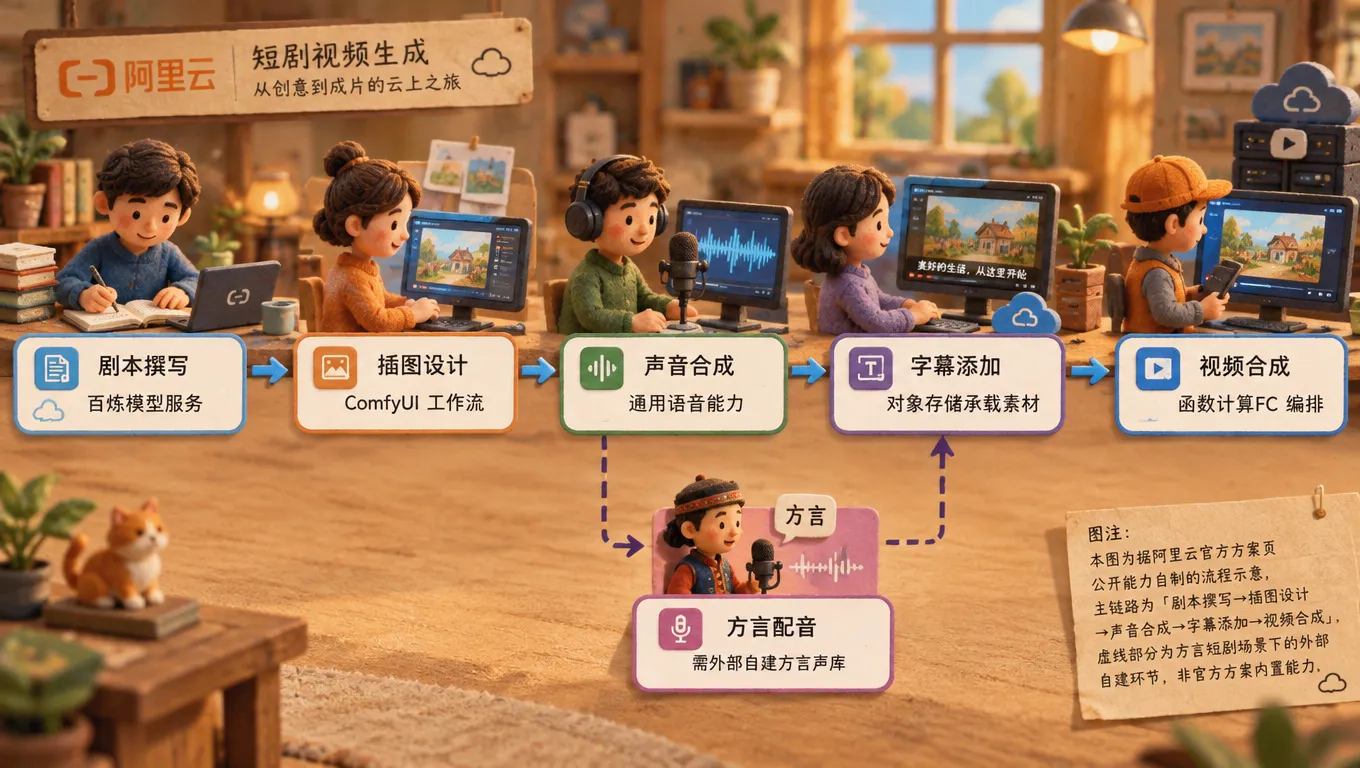
先把结论摆出来:这套方案落地的本质,是把短剧生产拆成五个可独立交付的工位,每个工位绑定一个云产品或自建能力,再用函数计算 FC 把它们串成一条可重跑的流水线。工位之间只通过对象存储交换产物,任何一个工位出问题都可以单独重跑,不影响上下游。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 工位 | 承担能力 | 落地方式 | 输入 → 输出 |
| ① 剧本工位 | 大纲、分场、对白生成与续写 | 百炼模型服务(API 调用) | 题材设定 → 分集剧本 JSON |
| ② 插图工位 | 分镜插图、角色与场景一致性 | ComfyUI 工作流(部署于 FC) | 分镜提示词 → 插图 PNG |
| ③ 配音工位 | 对白合成、方言声调 | 通用语音能力 + 自建方言声库 | 对白文本 → 音频 WAV |
| ④ 字幕工位 | 识别、校对、双语对照 | 语音识别 + 规则校对 | 音频 → SRT 字幕 |
| ⑤ 成片工位 | 合成、转码、竖屏裁切 | 函数计算 FC 编排 + 对象存储 | 图+音+字幕 → MP4 |
flowchart LR
    A["① 剧本工位 / 百炼"] --> B["② 插图工位 / ComfyUI"]
    A --> C["③ 配音工位 / 通用语音 + 自建方言声库"]
    C --> D["④ 字幕工位 / 识别 + 校对"]
    B --> E["⑤ 成片工位 / FC 编排"]
    D --> E
    E --> F["对象存储 / 产物归档"]
    F -.重跑.-> A

图注:五个工位通过对象存储解耦,FC 只负责调度与状态管理,不承载重计算;虚线为重跑链路,单集返工不影响其他集。

二、落地前置:账号、资源与目录规范
2.1 环境准备清单
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 序号 | 准备项 | 具体动作 | 验收标准 |
| 1 | 账号实名认证 | 完成阿里云账号实名认证 | 控制台可开通 FC、百炼、OSS |
| 2 | 开通百炼 | 开通大模型服务平台,创建 API Key | API Key 可成功调用一次对话接口 |
| 3 | 开通函数计算 FC | 创建服务与函数,配置触发器 | HTTP 触发器可返回 200 |
| 4 | 开通对象存储 OSS | 创建 Bucket,按工位建目录 | 五个工位目录可读写 |
| 5 | 部署 ComfyUI | 按官方部署教程在 FC 上部署 | 工作流可跑通一张测试图 |
| 6 | 接入自建方言声库 | 以独立服务形式部署,暴露 HTTP 接口 | 输入一句闽南语文本可返回音频 |
2.2 对象存储目录规范(先定规范,再跑生产)
目录规范是批量生产的地基。建议按「项目/集数/工位」三级建目录,产物文件名带版本号,返工只新增版本不覆盖旧文件,方便回溯与对比。
oss://short-drama/
├── project-a/
│   ├── ep001/
│   │   ├── script/      ep001_script_v3.json
│   │   ├── image/       ep001_shot01_v2.png
│   │   ├── audio/       ep001_line01_v1.wav
│   │   ├── subtitle/    ep001_v1.srt
│   │   └── final/       ep001_final_v1.mp4
│   └── ep002/ ...
└── _shared/
    ├── character/       角色参考图与 LoRA
    ├── style/           三地光线规范与提示词模板
    └── voice/           方言声库音色配置

三、工位一:剧本生产怎么落地
剧本工位的目标不是「让模型写一部剧」,而是把创作意图固化成结构化模板,让模型按模板批量产出可被下游消费的 JSON。落地分三步。
3.1 第一步:把创作规范写成系统提示词
把剧集设定、人物关系、方言用词规范、情感节点全部写进系统提示词,作为每次调用的固定前缀。这样模型输出的对白风格才能跨 60 集保持一致。
import json
from openai import OpenAI
client = OpenAI(
api_key="<你的百炼 API Key>",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
SYSTEM_PROMPT = """你是闽南语竖屏短剧的编剧助手。
硬性约束:
每集时长 2-2.5 分钟,对白 18-24 句;
对白使用闽南语口语,附普通话释义;
情感节点必须落在指定集数,不得提前或延后;
输出严格为 JSON,字段:episode, title, scenes[], lines[]。
"""def gen_episode(episode_no: int, outline: str) -> dict:
resp = client.chat.completions.create(
model="qwen-plus",
messages=[
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": f"第 {episode_no} 集大纲:{outline}"},
],
response_format={"type": "json_object"},
temperature=0.7,
)
return json.loads(resp.choices[0].message.content)

3.2 第二步:分集批量生成与人工卡点
不要一次性生成 60 集。建议按「10 集一批」推进,每批生成后由编剧做一次人工卡点,确认情感节点与方言用词,再进入下一批。这样返工成本可控,也避免风格漂移累积。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 批次 | 集数范围 | 人工卡点重点 | 预计耗时(我方口径) |
| 第 1 批 | 1月10日 | 人物设定、方言用词基线 | 2 天 |
| 第 2 批 | 11月30日 | 第 20 集走失节点、情绪递进 | 3 天 |
| 第 3 批 | 31-50 | 第 30 集和解、第 45 集转折 | 3 天 |
| 第 4 批 | 51-60 | 第 60 集平安落点、收尾一致性 | 2 天 |
3.3 第三步:产物落库与下游对接
每集剧本生成后写入 OSS 的 script/ 目录,同时把分镜提示词拆出来写入 image/ 目录的待处理队列。下游插图工位只读队列,不直接调剧本接口,保证工位解耦。
四、工位二:插图与动画怎么落地
4.1 ComfyUI 工作流的三层结构
插图工位最容易失控的地方是「角色不一致」。落地做法是把工作流拆成三层:基础模型层、角色一致性层、场景风格层,每层用固定参数固化,只让提示词在场景层变化。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 层级 | 固化内容 | 可变内容 |
| 基础模型层 | 底模、采样器、步数、分辨率(竖屏 9:16) | 无 |
| 角色一致性层 | 角色 LoRA、参考图、ControlNet 姿态 | 表情、动作 |
| 场景风格层 | 三地光线规范提示词模板 | 具体场景描述 |
4.2 三地光线规范写成提示词模板
把视觉规范固化成可复用的提示词片段,避免每张图重新描述光线,这是保证 60 集画面统一的关键。
LIGHT_PRESETS = {
    "xiamen": "blue-grey morning mist, soft diffused light, seaside, muted cool tones",
    "jiading": "cold neon glow, warm window light contrast, urban night, cinematic",
    "taizhong": "golden-red dusk, warm rim light, nostalgic tone, film grain",
}
def build_prompt(scene: dict) -> str:
light = LIGHT_PRESETS[scene["location"]]
return f"{scene['character']}, {scene['action']}, {light}, vertical 9:16, consistent character design"

4.3 批量出图与废片率控制
按我方经验,插图环节按 1.5 倍出图量预留(每集约 40 张有效图,实际调用约 60 次),废片主要来自角色走形与手部畸变。落地时在 FC 函数里加一道自动质检:用图像相似度比对角色参考图,低于阈值自动重绘,最多重试 2 次,避免人工逐张筛。
五、工位三:方言配音怎么落地
这是整套方案里唯一不能完全交给通用能力的一环,也是落地成败的关键。执行上分两条腿走。
5.1 通用语音能力负责什么
通用语音合成负责旁白、环境音提示、普通话对照音轨,以及方言声库未覆盖的次要角色。这部分直接调阿里云语音合成接口,按调用次数计费,接入成本低。
5.2 自建方言声库负责什么
主角对白、情感高潮段落必须走自建方言声库。落地方式是把声库封装成独立 HTTP 服务,与 FC 编排层对接,接口协议与通用语音保持一致,这样编排层不需要区分调用来源。
import requests
def synthesize(line: dict) -> bytes:
"""按角色路由到不同语音后端,接口协议统一。"""if line["role"] in ("grandma", "agiang"):
# 主角对白走自建方言声库
resp = requests.post(
"https://voice.internal/synth",
json={"text": line["dialect"], "voice": line["role"], "emotion": line["emotion"]},
timeout=30,
)
else:
# 次要角色走通用语音能力
resp = requests.post(
"https://dashscope.aliyuncs.com/api/v1/tts",
json={"text": line["mandarin"], "voice": "general"},
timeout=30,
)
resp.raise_for_status()
return resp.content

5.3 配音质量卡点
- 声调校验:每集抽检 20% 对白,人工听辨声调是否准确,错误率超阈值整集重合成。
- 情感对齐:情感高潮段落(第 45 集转折、第 60 集收尾)必须人工全量听辨。
- 音画同步:音频时长与分镜时长偏差超过 0.5 秒的,回退调整对白长度而非拉伸音频。
六、工位四与工位五:字幕与成片怎么落地
6.1 字幕:识别 + 规则校对双保险
方言字幕的难点是同音字误写。落地做法是识别后加一层规则校对:用闽南语常用词表做匹配替换,再输出「方言原文 + 普通话释义」双语 SRT。
DIALECT_FIX = {
    "阮": "我们", "逐家": "大家", "代志": "事情",
    "佮": "和", "拢": "都", "踮": "在",
}
def proofread(srt_text: str) -> str:
for dialect, mandarin in DIALECT_FIX.items():
srt_text = srt_text.replace(dialect, f"{dialect}({mandarin})")
return srt_text

6.2 成片:FC 编排的状态机
成片工位不写业务逻辑,只做状态机调度:检查五个工位产物是否齐全 → 调用合成 → 转码竖屏 → 写回 OSS → 更新集数状态。任何一步失败,状态标记为待重跑,不阻塞其他集。
STAGES = ["script", "image", "audio", "subtitle", "final"]
def run_episode(ep: str) -> dict:
status = {}
for stage in STAGES:
if not exists(f"oss://short-drama/project-a/{ep}/{stage}/"):
status[stage] = "missing"return status  # 缺料即停,等待上游补齐
status[stage] = "ok"
compose(ep)          # 合成
transcode_vertical(ep)  # 竖屏转码
status["final"] = "done"return status

七、批量生产排期:35 天怎么排
把五个工位映射到 35 天排期,关键是让工位并行而不是串行等待。剧本先行 10 天,插图与配音在剧本批次产出后立即启动,成片在单集五料齐全后即可合成。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 阶段 | 天数 | 并行工位 | 交付物 |
| 剧本创作 | 第 1-10 天 | 剧本工位(4 批次) | 60 集剧本 JSON |
| 资产准备 | 第 6-10 天 | 角色 LoRA、光线模板、声库配置 | 共享资产库 |
| 生成与剪辑 | 第 11-25 天 | 插图、配音、字幕、成片四工位并行 | 60 集成片初版 |
| 审核修改 | 第 26-30 天 | 内容审核、返工重跑 | 合规成片 |
| 缓冲 | 第 31-35 天 | 全片复检、字幕终校 | 交付母版 |
八、成本与资源怎么控
落地阶段最需要盯的不是 tokens,而是插图、配音、合成这三段的调用次数。按 60 集、每集 2.5 分钟估算,调用量级如下。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 环节 | 单集调用 | 60 集总量 | 控本手段 |
| 剧本生成 | 约 6000 tokens | 约 36 万 tokens | 落在百炼新用户每模型 100 万免费 tokens 内,优先用免费额度 |
| 插图设计 | 约 60 次出图 | 约 3600 次 | 自动质检前置,减少无效重绘;低优先级镜头降分辨率 |
| 配音合成 | 约 3 次 | 约 180 次 | 批量合成、复用已通过段落,避免整集重合成 |
| 字幕处理 | 约 2 次 | 约 120 次 | 规则校对本地化,减少重复识别调用 |
| 成片合成 | 约 1.5 次 | 约 90 次 | FC 按量弹性,非生产时段缩容到零 |
成本口径说明:以上为按官方口径与我方生产参数推算的调用量模型,非实测账单;试用点 3 点起/小时、建议试用 1 小时为官方体验口径,量产时长需按实际生产小时数换算,精确成本以实际账单为准。
在配音环节,通用云能力与自建方言声库并非二选一,而是按环节分工。两者的成本与效果对比如下。
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 对比维度 | 通用云能力(阿里云语音合成) | 自建方言声库 |
| 单集调用成本口径 | 按调用次数计费,单集约 3 次调用,成本随集数线性增长,无前期投入 | 前期需投入声库训练与部署(一次性),单集边际成本接近零,仅计自建服务算力 |
| 方言声调准确率 | 普通话与通用音色稳定,闽南语声调与连读变调覆盖有限,需人工抽检兜底 | 方言识别 ≥92%、音素转写 97.82%,声调与情感表达可控,适合主角对白 |
| 接入复杂度 | 低,开通即用,API Key 调用,半天可跑通 | 高,需语料采集、训练、封装 HTTP 服务并对齐接口协议 |
| 可扩展性 | 音色与语种随官方更新,但方言定制空间小 | 可增补发音词典与音色,随项目积累持续优化 |
| 适用环节 | 旁白、环境音提示、普通话对照音轨、次要角色 | 主角对白、情感高潮段落、方言声乐片段 |
选型结论:通用云能力负责旁白与次要角色,用低接入成本快速起量;自建方言声库只覆盖主角对白与情感高潮,用一次性投入换取声调准确率。两者按角色路由、协议统一,才能在 60 集规模下兼顾成本与方言质感。
九、风险与预案
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 风险点 | 触发信号 | 预案 |
| 角色一致性漂移 | 相似度质检连续 2 次不达标 | 回退到角色参考图重绘,必要时人工介入调 LoRA 权重 |
| 方言声调错误 | 抽检错误率超阈值 | 整集重合成,同步更新声库发音词典 |
| FC 并发打满 | 函数超时率上升 | 按集数分批提交,非高峰时段跑批量任务 |
| 成本超预算 | 单集调用次数超预估 30% | 暂停该集,先排查废片原因再重跑 |
| 审核不通过 | 内容审核退回 | 审核前置到剧本阶段,避免成片后返工 |

十、上线检查清单
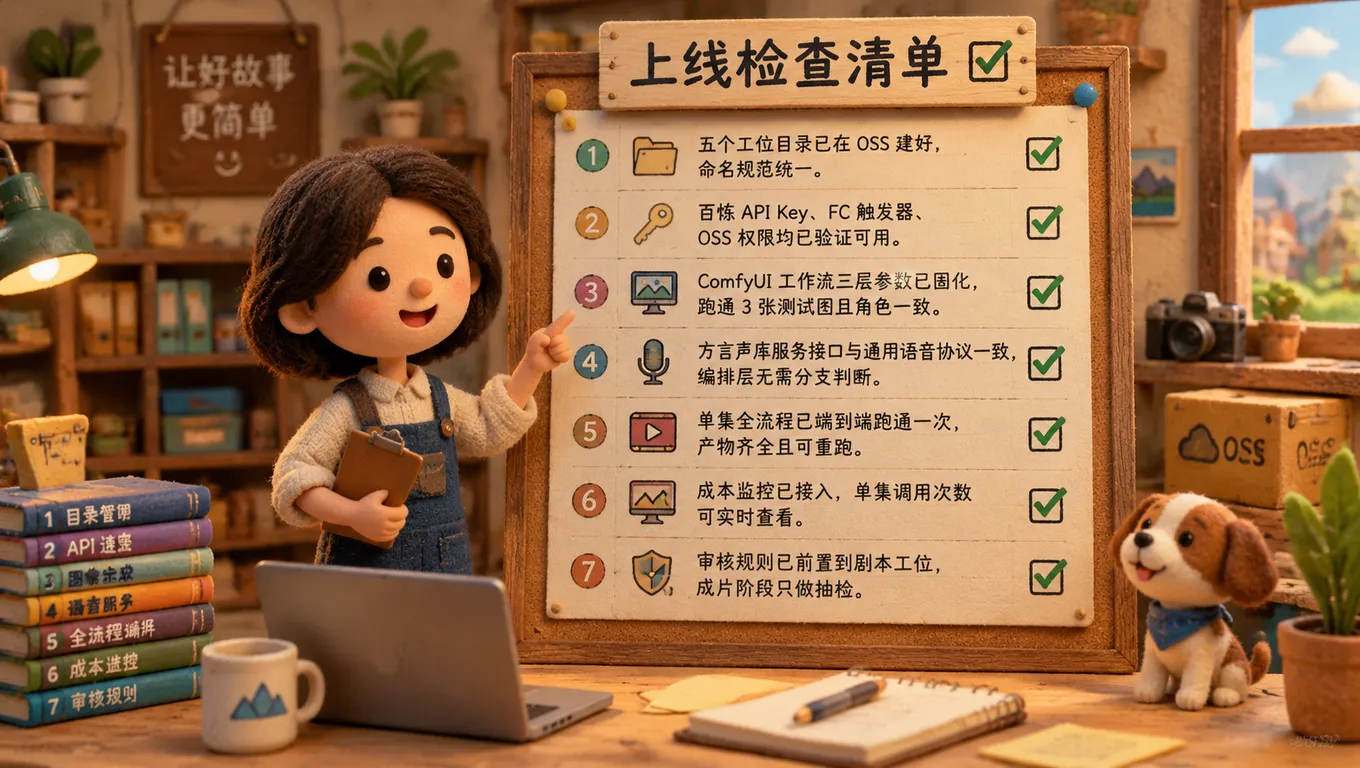
- 五个工位目录已在 OSS 建好,命名规范统一。
- 百炼 API Key、FC 触发器、OSS 权限均已验证可用。
- ComfyUI 工作流三层参数已固化,跑通 3 张测试图且角色一致。
- 方言声库服务接口与通用语音协议一致,编排层无需分支判断。
- 单集全流程已端到端跑通一次,产物齐全且可重跑。
- 成本监控已接入,单集调用次数可实时查看。
- 审核规则已前置到剧本工位,成片阶段只做抽检。
十一、总结
这套执行方案的核心不是「用了多少 AI」,而是把一条 60 集的生产线拆成五个可独立重跑的工位,用对象存储解耦、用 FC 编排、用自建声库补齐方言短板。通用环节交给阿里云方案提速,方言声调与声乐环节自建保质,两者组合才能把 35 天周期真正跑通。方案中标注「待实测」的环节,建议在首批 10 集跑完后回填真实数据,再据此调整排期与预算。
十二、参考来源
<!--br {mso-data-placement:same-cell;}--> td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 级别 | 来源 | 引用内容 |
| E1 | 阿里云官方方案页「AI 剧本生成与动画创作」 | 架构组成(函数计算 FC、百炼、ComfyUI、对象存储)、能力模块、试用点与免费 tokens 口径 |
| E1 | 阿里云开发者社区技术博文创作与发布规范 | 平台发文规范、原创与合规要求 |
| E2 | 《竖屏短剧〈等你平安归来〉》项目申报文档 | 60 集规格、每集 2-2.5 分钟、竖屏 9:16、35 天周期拆分、三地光线规范 |
| E2 | 我方方言 AI 技术材料 | 方言识别 ≥92%、音素转写 97.82%、语音克隆 MOS ≥4.3 |

- AI 剧本生成|动画创作|落地执行方案|函数计算 FC|百炼|ComfyUI|短剧 AIGC
- #AI剧本生成与动画创作#|#解决方案评测#|#阿里云开发者社区#|#AIGC#|#短剧创作#|#云原生AI#