
上个月帮朋友看一个运营后台。他那个页面是这样的:点「订单列表」,转圈,转圈,转到你以为网断了,第八秒,「唰」一下全出来了。
朋友的原话是:「服务器是不是该升配了?我看 CPU 老是打满。」
我先没动服务器。先看了眼他的库:MongoDB,五百万条订单,副本集两节点,配置不算寒酸。真正的问题在一条查询上,那条查询连索引都没走,全表扫,扫完还要在内存里排一遍序。CPU 打满不是因为它忙,是因为它在用最笨的办法干活。
改完之后,同样的查询 40 毫秒。这次我把整个排查过程和踩过的坑摊开写一遍,看完你大概能省下一次无脑升配的钱。
先说结论:慢查询九成不是服务器不行,是查询没走索引
判断这件事只需要一条命令,不用装任何工具,在 mongo shell 或者 DMS 里直接跑:
db.orders.find({
    status: "paid", createdAt: {
    $gte: ISODate("2026-09-01") } })
         .sort({
    createdAt: -1 })
         .limit(20)
         .explain("executionStats")
然后盯着这几个字段看,别的都可以先不管:
winningPlan.stage:出现COLLSCAN就是全表扫,IXSCAN才是走了索引,中间可能还夹一层FETCH(回表取完整文档)。totalKeysExamined:扫了多少个索引键。totalDocsExamined:扫了多少个文档。nReturned:最终返回几条。
理想状态下,这三个数应该接近。nReturned 是 20,totalDocsExamined 是 480 万,这就不是「稍慢」,这是拿卡车运一封信。
我那朋友的原查询,totalDocsExamined 是 483 万,nReturned 是 20。中间差了二十四万倍。这个比例一出来,服务器是完全无辜的。
坑一:复合索引的字段顺序,不是想怎么写就怎么写
朋友其实建了索引,{ status: 1, createdAt: -1 },看着挺对。问题是他另一条查询是这样的:
db.orders.find({
    createdAt: {
    $gte: ISODate("2026-09-01") }, status: {
    $nin: ["cancelled"] } })
复合索引有个铁律,一般记成三个字母:ESR——等值(Equality)在前、排序(Sort)在中、范围(Range)在后。索引是按字段顺序一层层往下找的,第一个字段范围一放开,后面的字段基本就失去了定位能力。所以字段顺序一旦和查询顺序反着来,索引就在那儿摆着,但用不上,查询优化器宁可去全表扫。
我的处理办法很土:把线上真实跑过的查询按 explain 结果拉一遍,按访问模式重排字段。这个后台只有三种查询模式,最后合成两个索引就够了,{ status: 1, createdAt: -1 } 留给「按状态筛 + 按时间倒序」,另一个 { userId: 1, createdAt: -1 } 留给「某用户的订单列表」。多一个字段都没建。
顺带说一句,索引不是越多越好。每多一个索引,每次写入就要多维护一棵 B 树,写放大会直接体现在插入延迟上。见过一个集合挂了十一个索引,读是快了,写入慢到业务方以为数据库挂了。
坑二:正则里一个 ^ 的差别,就是走索引和不走索引的差别
这是最容易被忽略的一类。MongoDB 的普通索引是有序的,只能从左往右匹配前缀:
// 走索引,因为有明确前缀
db.users.find({
    nickname: /^小吴/ })

// 不走索引,中间匹配只能全扫
db.users.find({
    nickname: /小吴/ })

// 也不走索引,普通索引区分大小写,加了 i 就用不上
db.users.find({
    nickname: /^xiaowu/i })
如果业务真需要「模糊搜中间」,那就别硬扛,换思路:要么上 Atlas Search 那类全文检索(阿里云这边是走 Elasticsearch 或者开放搜索另搭),要么把搜索字段拆成可前缀匹配的形式存一份。索引救不了它。
坑三:$ne、$nin、跨字段 $or,都是索引的隐形杀手
$ne 和 $nin 本质上是「排除」,排除类条件没法用索引快速定位,因为数据库得先确认哪些命中了才能排除。$or 更微妙——它可以用索引,但要求每个分支都能各自走索引,只要有一个分支走不了,整个 $or 就退化成全扫。
正确的做法是拆:
// 原来的写法,第二个条件走不了索引,整体退化成 COLLSCAN
db.orders.find({
    $or: [ {
    orderNo: "20260928001" }, {
    extNo: "X-9981" } ] })

// 改成分两次查再合并(业务上完全等价)
const a = db.orders.find({
    orderNo: "20260928001" }).toArray();
const b = db.orders.find({
    extNo: "X-9981" }).toArray();
如果两个字段都必须能查、数据量又大,那就老老实实给两个字段各自建索引,$or 才会真的走两条索引路径去合并。
坑四:聚合管道里,$match 放错位置等于白写
这条我自认为踩得最冤。当时为了让代码「看起来清晰」,我是这么写的:
db.orders.aggregate([
  {
    $project: {
    orderNo: 1, status: 1, amount: 1, day: {
    $dateToString: {
    date: "$createdAt", format: "%Y-%m-%d" } } } },
  {
    $match: {
    status: "paid" } },
  {
    $group: {
    _id: "$day", total: {
    $sum: "$amount" } } }
])
结果很稳定:很慢。原因是 $project 一旦重新造了文档,原来 createdAt 上那个索引就没法用了,后面的 $match 只能对着临时结果集做过滤。
聚合管道是流式的,前面的阶段决定了后面的数据量。所以顺序基本是固定的:能过滤的先过滤($match 放最前)→ 能提前排序的提前排($sort 紧跟在 $match 后面,这样能吃上索引)→ $group 聚合 → $lookup 关联放到最后。$lookup 尤其要放后面,因为它是逐条去另一个集合查,前面数据量没压下来,它就是灾难。
改完之后那条聚合从 6 秒掉到 300 毫秒左右,代码反而更短了。
坑五:索引该放哪儿、要不要 TTL,得看数据的「寿命」
有一个细节:索引是要占内存的。WiredTiger 的缓存有限,索引一多,热数据就被挤出内存,然后开始疯狂读盘——这时候你会看到 CPU 里 iowait 飙高,一查全是磁盘读。
我自己的经验是,索引总量尽量控制在「热数据 + 索引」能装进实例内存的范围内。超过这个范围,加配置比加索引划算。
另外,日志类的集合(操作日志、埋点、会话)别用普通索引硬撑,直接上 TTL 索引,让数据库自己清:
db.audit_logs.createIndex({
    createdAt: 1 }, {
    expireAfterSeconds: 60 * 60 * 24 * 30 })
TTL 索引只能建在日期类型字段上,后台有个定时线程每隔一小段时间扫一遍过期文档,不会特别精准,但对你「日志留 30 天」的需求已经足够。
三处改动,最后落在哪
回头看,这位朋友的问题总共就改了三处:
- 按 ESR 原则重建了两个复合索引,删掉三个用不上的;
- 把聚合管道里的
$project从最前面挪到最后,$match提到第一位; - 把一条
$or查询拆成两个单字段查询。
代价是零。没升配,没加机器,没动代码逻辑。
顺便说一句选型:什么时候该上分片
很多人一遇到慢就想着「上分片集群」,其实分片解决的是「数据量和写入吞吐装不下」的问题,不是「查询没走索引」的问题。索引没搞对,上了分片一样慢,还多了一层路由开销。
判断标准大概是这样:
| 症状 | 该动的地方 |
|---|---|
单条查询慢,explain 是 COLLSCAN |
索引,不是机器 |
| 单条查询快但并发一多就排队 | 读请求分流到副本集的只读节点 |
| 单分片已经接近 IOPS 或容量上限 | 考虑分片集群 |
| 写入量持续飙升、单机写不动 | 分片集群,按分片键打散 |
官方给的参考量级是:单个分片最大 72000 IOPS、最大 3TB 存储、单分片最大承载 15 万 QPS(读写比 95:5 的场景)。到这个量级再谈分片,之前谈都是浪费钱。
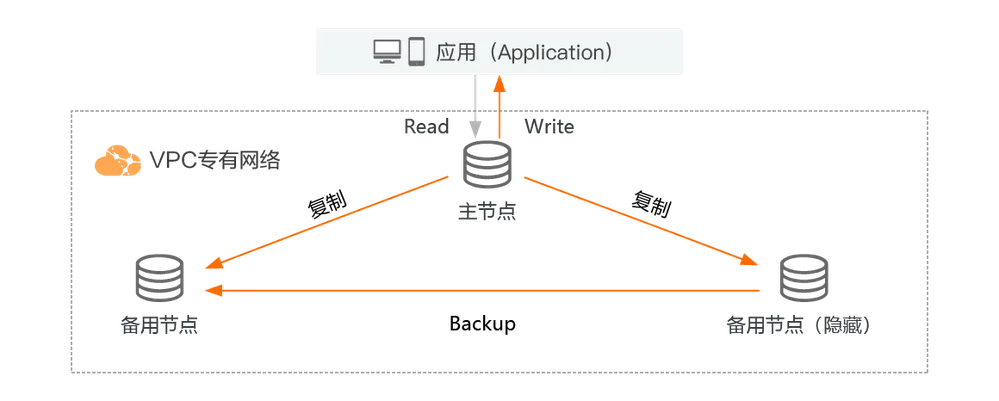
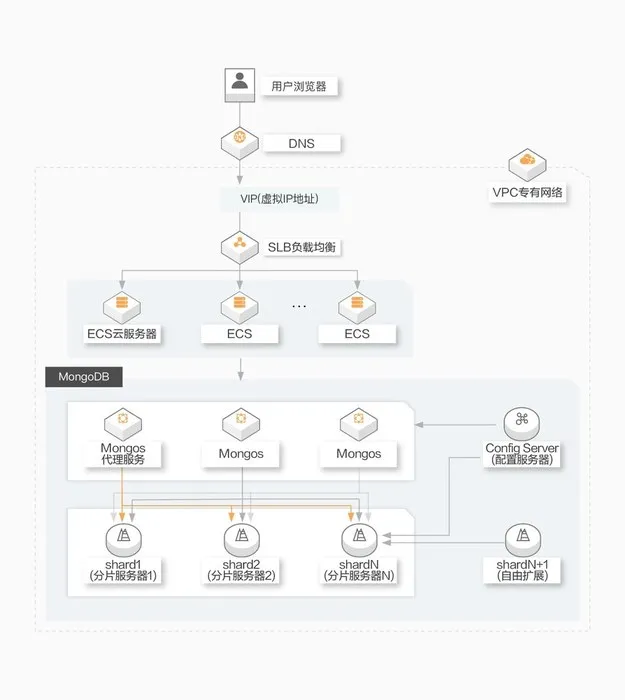
至于架构选择,阿里云这边是单节点、副本集、分片集群三种:单节点便宜但不是为容错设计的,适合测试和内部系统;副本集是 Primary + Secondary + Hidden 加上可选的只读节点,主节点挂了自动选举,Hidden 顶上;分片集群是 mongos 加 shard 加 configserver,容量和吞吐都能水平扩。
另外两个常被忽略的运维细节,我觉得比「多加一个节点」更值钱:
- 备份:官方默认每天自动备份,免费支持 7 天内的任意时间点恢复。删库这种事,有没有这个能力,是两种人生。
- CloudDBA 的索引分析:它会直接把「哪些查询没走索引、建议加什么索引」列出来。懒人的救命功能,但别全信,它不知道你的写入压力,建议加之前自己算一遍代价。
新用户首购那个优惠(699 元 3 个月 / 全系 6 折每年,限一次)也还在,具体规格和价格我一直建议看官方页面,因为活动会变,我就不在这儿抄数字了。
选型、规格、计费方式这些,官方页面写得比我清楚,有需要的自己去看:云数据库 MongoDB 版产品页。
最后给一条朴素的建议
数据库慢这件事,八成以上的答案藏在 explain 的输出里,而不是在「要不要升配」这个选项里。
下次再遇到转圈八秒的页面,别急着点升级配置。先跑一遍 explain("executionStats"),看 totalDocsExamined 和 nReturned 差了多少倍。差得离谱,就是索引问题,跟机器一点关系都没有。
省下来的那笔钱,够请团队吃好几顿火锅了。


