2026年10月,阿里云和清华大学联合完成的“大规模智算中心高性能网络关键技术及应用”项目,获得中国计算机学会(CCF)科技进步一等奖。鉴定委员会的措辞是“在基于以太网的智算中心网络取得了创造性成果”,“达到国际领先水平”。
对于不直接参与大模型训练的人来说,“智算网络”听起来像一个基础设施的细节。但这个“细节”,恰恰是AI从“能演示”走向“能干活”的过程中,最容易被低估的那道坎。
一、瓶颈不在卡上,在连接卡的网上
大模型的发展,早已不是“单卡算力”的竞赛。训练一个千亿参数级别的模型,需要成千上万张GPU同时工作,频繁交换梯度、参数、中间结果。如果网络跟不上,GPU就会闲置,算力就在空转。
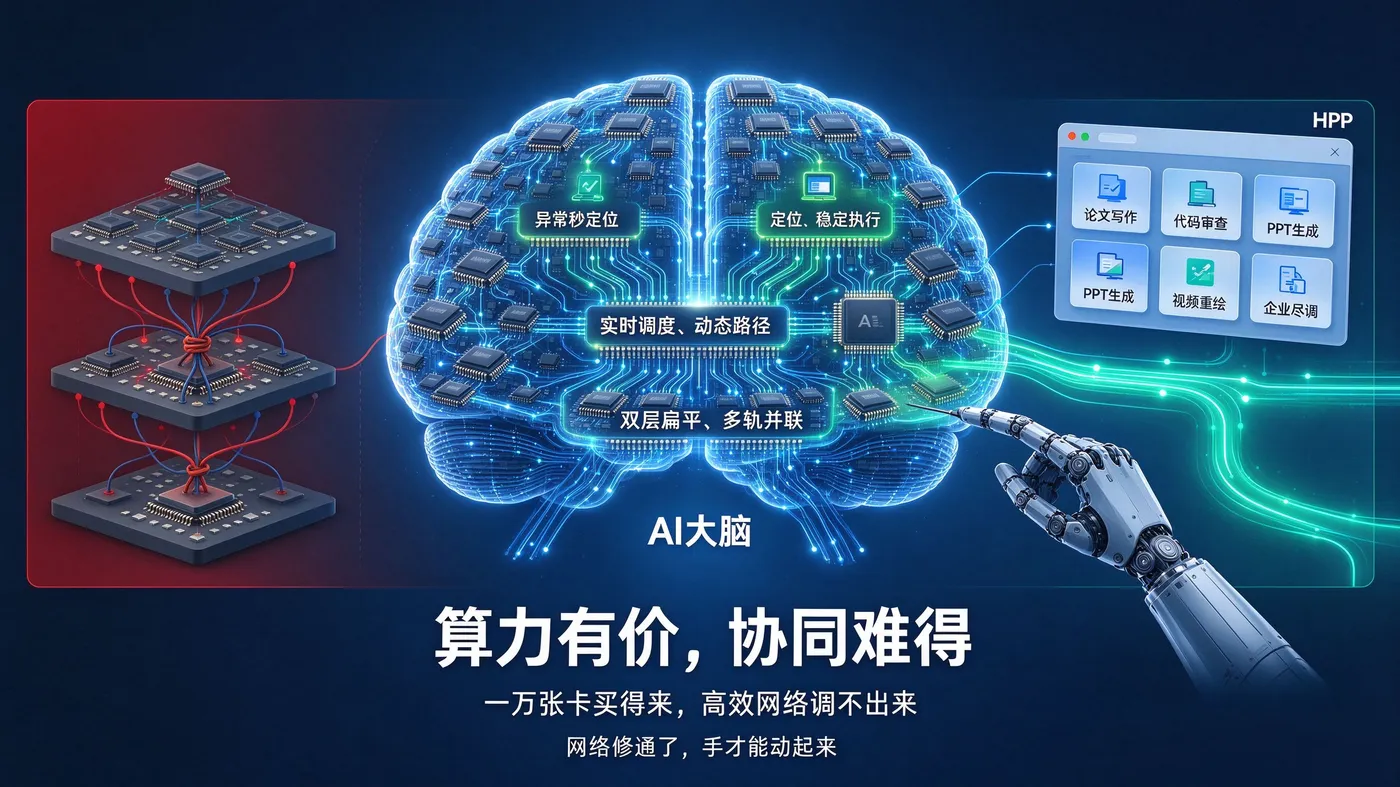
阿里云HPN要解决的,是智算中心网络的三个经典难题:带宽供给、流量调度、异常定位。
传统数据中心网络是“三层堆叠、单通道级联”,数据跨层转发造成的带宽损耗,在万卡集群的规模下会直接吃掉有效算力。HPN采用“双层扁平、多轨并联”,把三层压缩成两层,第三方测试显示万卡集群有效带宽较传统架构提升近30%。
流量调度方面,大模型训练的数据流不是均匀分布的。HPN让服务器和网络设备实时交换任务需求和链路状态,动态调整路径,测试中带宽利用率达到97%。
异常定位方面,一张卡出问题可能拖慢整个训练任务。HPN把根因定位缩短到秒级,故障导致的GPU闲置时间平均降低97%。
这三个问题的共同点是:它们都不是“模型”的问题,但每一个都在直接决定模型能不能训出来、训得多快、训得多贵。 当Agent开始承担长任务、多步骤、高并发的“干活”需求时,底层网络的稳定性和效率,从“锦上添花”变成了“有没有饭吃”。
二、比网络更“前台”的变化:AI正在从“对话”变成“交办”
基础设施的进步,最终要体现在应用层能不能长出东西。
阿里云百炼平台一周内新增65款应用和11款MCP服务,覆盖科研、工程仿真、医学、法务、营销等垂直场景,支持论文写作、代码审查、PPT生成、视频重绘、企业尽调等专业任务,定位是让用户“一句话交办AI”。
“一句话交办”和“问答”是两种完全不同的需求。问答需要的是理解和生成。交办需要的是理解任务、拆解步骤、调用工具、校验结果、处理异常。一个“投稿前论文自查”应用,要读得懂学术文本、判断得了论证逻辑、输出得了可执行的修改建议。它背后依赖的,不是更大的语言模型,是一整套能够稳定执行多步骤任务的工程体系。
模型能力的竞争,正在从“谁更会说话”转向“谁更能办事”。而“办事”对基础设施的要求,比“说话”苛刻得多。
三、从“买卡”到“买协同”
过去两年,企业讨论AI基础设施,核心问题是“有多少张卡”。卡是稀缺资源,有卡就有算力。
但当集群从百卡、千卡走向万卡的时候,问题变了。卡与卡之间的协同效率,开始比卡本身的数量更能决定产出。 一张利用率50%的卡,和一张利用率97%的卡,在实际产出上的差距,比“多买一倍卡”更大。
HPN获奖的意义,不在于它拿了奖。在于它标志着智算基础设施的竞争,正在从“堆硬件”进入“拼系统”的阶段。谁能把网络、计算、存储、调度整合成一个高效的整体,谁就能让同样的卡跑出更多的活。对于正在把Agent推向生产环境的企业来说,这是一个比“模型又涨了几个点”更实际的信号。
大模型的能力上限,最终会被物理定律限制。但在那个上限到来之前,系统效率的提升,还有很长的路可以走。 而这条路,恰恰是让AI从“偶尔惊艳”变成“天天能用”的关键。
写在最后
算力是“买得到”的,网络协同是“调得出来”的。你可以花钱买一万张卡,但你买不到一个让这一万张卡高效工作的网络。那需要架构设计、协议优化、故障定位能力、以及长时间的工程积累。
AI要干活,光有聪明的“大脑”不够。还需要一条不堵车、不出错、不拖后腿的“神经”。HPN在做的事,就是修那条神经。而百炼上那65款“一句话交办”的应用,是在告诉所有人:神经修好了,手才能动起来。