
Qwen3.8‑Max作为千问系列新一代MoE架构旗舰基座,总参数量达到2.4万亿,激活参数950亿,是面向复杂专业任务、长周期智能体、工程级代码开发、多模态深度解析的高阶大模型,原生支持文本、图像、视频多模态输入,最大上下文窗口达到百万Token,最大输出Token支持131072,内置深度思考推理链路,在编程、科研、法律金融专业分析、长视频文档解析、自主Agent任务等场景能力表现突出。很多开发者在项目前期直接接入该旗舰模型,却对模型能力边界、多种计费模式、订阅套餐权益、API参数配置、上下文缓存优化缺乏完整认知,出现成本失控、接口报错、长文本信息丢失、深度思考模式额外消耗大量Token等一系列线上问题。本文从模型核心功能、规格参数、按量计费、Token Plan订阅体系、NightPlan夜间折扣权益、完整接入配置、多语言调用代码示例、成本优化策略、生产环境避坑要点完整展开,覆盖个人开发者POC验证、中小企业业务落地、企业级智能体项目上线全流程。
一、Qwen3.8‑Max核心功能与硬件规格参数
1.1底层架构与基础规格
Qwen3.8‑Max采用MoE混合专家架构,模型调用ID固定为qwen3.8‑max,同时提供快照版本qwen3.8‑max‑0902用于版本锁定,避免模型迭代带来输出效果变动,正式生产业务建议指定快照版本,防止后台模型更新引发业务逻辑异常。详情👉访问阿里云百炼大模型服务平台页面 了解。
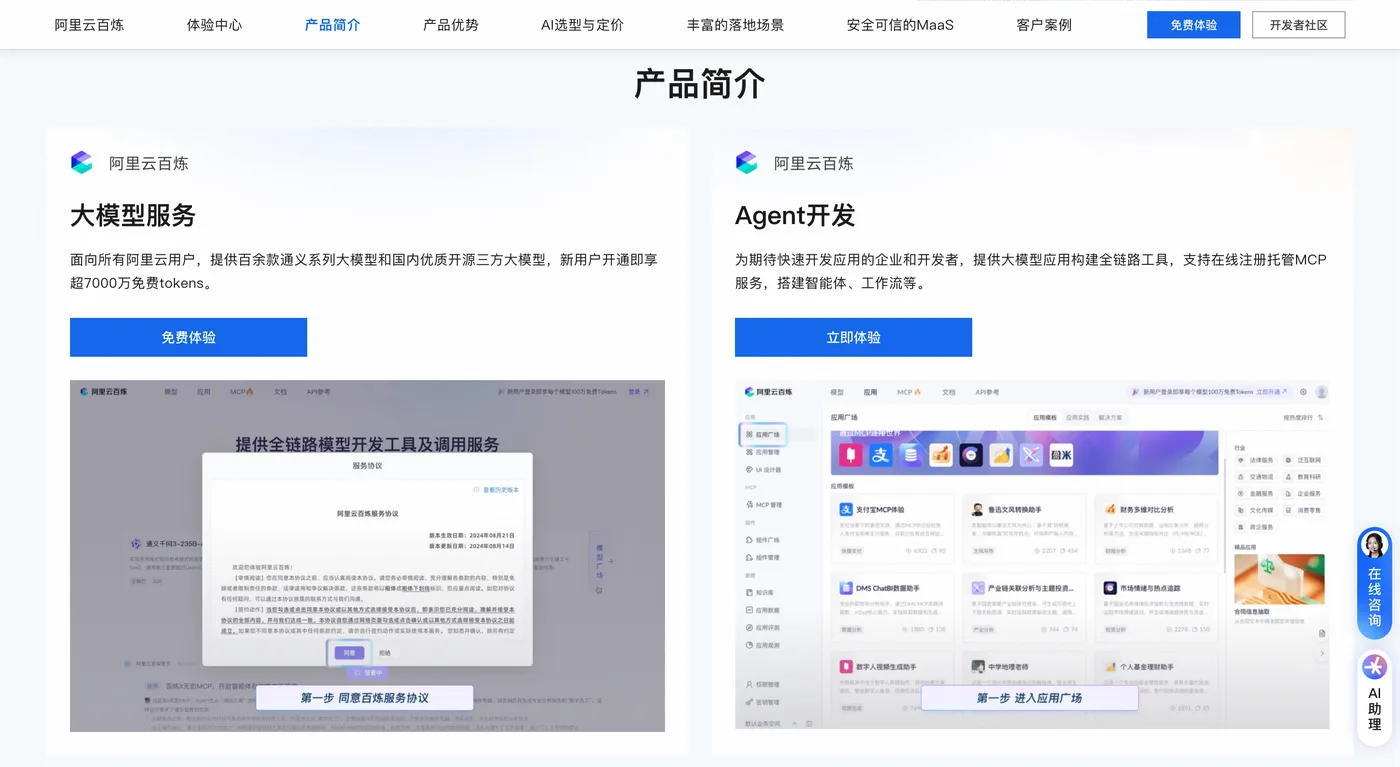
关键上下文参数:
- 整体上下文窗口:1000000 Token
- 最大输入Token:991808,开启深度思考模式下最大输入983616
- 最大输出Token:131072,深度思考模式最大思维链长度262144 Token
- 支持模态:文本、图片、长视频输入,输出仅为文本
- 不支持自定义微调、不支持批量推理;支持Function Calling函数调用、结构化JSON输出、前缀续写、上下文缓存、内置代码解释器、网页提取工具。
限流指标,国内区域RPM 30000,TPM每分钟500万Token;国际部署区域RPM15000,TPM每分钟200万Token,为动态限流,消费档位提升后限额会自动上调。
1.2核心能力拆解
深度推理与深度思考模式
内置深度思考链路,开启enable_thinking参数之后,模型会输出完整内部思考过程,面对复杂数学推导、多步骤业务拆解、法律条文分析、复杂方案设计,推理严谨度大幅提升;需要注意开启思考模式会额外消耗大量输出Token,直接拉高整体计费开销,简单对话业务建议关闭该参数,仅复杂任务按需开启。
工程级代码生成能力
可以独立完成完整软件项目搭建,多文件工程重构、漏洞排查、算法实现、单元测试编写,适配SWE类Agent开发场景,能够承接跨多轮迭代的大型编码任务,支持结合截图图片完成Vibe Coding视觉辅助编程,结合界面截图直接输出前端业务代码。
长周期Agent智能体能力
支持数十轮连续工具循环调用,自主规划任务、执行工具、根据返回结果纠错迭代,适配Hermes Agent、OpenClaw等复杂智能体框架,擅长需要多工具联动的自动化业务流程,工具调用JSON格式返回的稳定性优于同系列Flash模型,降低业务流程因为格式异常中断的概率。
原生多模态解析能力
支持图片、长视频输入,能够解析复杂图表、扫描版PDF、软件GUI截图、几分钟时长视频,提取视频当中关键业务信息,完成视频内容总结、界面识别、视觉规划,适用于GUI操作智能体、图文知识库、视频内容分析业务。
上下文缓存能力
上下文缓存是该模型非常关键的成本优化特性,针对重复不变的系统提示词、知识库公共前缀内容做缓存,缓存命中之后输入Token计费大幅降低,在Agent循环对话、知识库问答场景可以显著减少推理开销,同时降低接口响应延迟。
结构化输出与内置工具集
原生支持强制结构化JSON输出,减少JSON解析失败;内置代码解释器、网页内容抓取、联网检索、多媒体检索工具,不需要额外开发即可完成网页读取、代码运行、资料检索等任务。
二、计费体系:按量计费、Token Plan订阅、NightPlan夜间权益完整规则
Qwen3.8‑Max存在三套计费体系:按量后付费、Token Plan订阅套餐、NightPlan夜间折扣权益,不同模式可以叠加生效,开发者需要区分不同模式的抵扣逻辑,避免账单超出预期。详情👉访问阿里云百炼大模型服务平台页面 了解。
2.1按量计费(原价模式)
按量计费按照输入、输出Token分别计费,缓存命中场景输入会执行折扣计价,以国内区域价格作为参考,实际账单以控制台明细为准。
- 普通输入Token:12元 / 每百万tokens
- 普通输出Token:36元 / 每百万tokens
- 缓存命中读取输入:1.5元 / 每百万tokens
- 显式缓存创建:15元 / 每百万tokens(缓存创建阶段会小幅溢价,后续多次读取享受低价)
重要说明:开启深度思考模式,模型输出的思考内容同样计入输出Token统计,会产生对应计费;快照版本qwen3.8‑max‑0902每次请求会固定消耗额外输入Token,开发测试阶段统计成本时需要纳入考量。
2.2 Token Plan订阅(个人版与团队版)
Token Plan是预购Credits额度的订阅模式,购买对应额度Credits之后,调用Qwen3.8‑Max会优先消耗订阅Credits,相比按量原价具备明显折扣,适合持续调用、日均请求量稳定的业务场景。
- 个人版Token Plan:面向个人开发者,API Key仅限本人使用,禁止密钥对外共享,同一实名认证主体限购一份个人版套餐;个人版额度只能够个人账号使用,不支持拆分分给多业务人员。
- 团队版Token Plan:面向企业业务,支持团队内多子账号共享Credits额度,支持用量统计、成员权限管控,适合企业多业务线同时调用模型。
- 抵扣规则:请求优先消耗订阅Credits,Credits耗尽之后自动切换为按量计费,不会直接阻断业务;开发者需要配置用量告警,防止Credits耗尽后按量产生高额账单。
- 注意:Token Plan套餐额度有效期固定,过期未使用Credits直接失效,需要结合业务预估消耗量选择档位,不要盲目采购大额套餐。
2.3 NightPlan夜间折扣权益
NightPlan权益面向已经开通Token Plan订阅的客户,生效时间段为每晚22:00至次日早上8:00,该时间段调用Qwen3.8‑Max可以享受对应折扣,适合离线批量处理文档、夜间批量知识库处理、非实时异步任务。
实时面向用户的线上业务不建议完全依赖夜间折扣权益,仅适合离线异步作业;该权益只针对模型推理本身,缓存相关计费项不参与折扣,需要仔细阅读权益说明。
2.4上下文缓存计费规则
上下文缓存分为自动缓存与显式缓存两种模式。显式缓存可以标记指定消息片段,保证缓存稳定命中;缓存创建阶段有小幅溢价,后续多次读取享受极低单价。当系统提示词、知识库公共前缀反复复用,缓存收益最高;如果每轮请求全部内容都在变化,缓存几乎无法命中,开启缓存不会带来成本下降,反而会产生缓存创建开销。
生产环境判断缓存是否生效,不要只看API返回字段,以百炼控制台账单缓存计费明细作为真实结算依据。
2.5计费避坑重点
- 输入输出分别计费,输出单价远高于输入,开启深度思考会大幅拉高输出Token消耗,非必要业务关闭enable_thinking。
- 订阅Credits耗尽会自动切按量,不会直接报错,必须配置用量告警阈值。
- 缓存不是万能优化手段,内容频繁变动场景开启缓存反而增加成本。
- NightPlan仅夜间时段生效,实时在线业务不可依赖该折扣。
- 快照版本每次请求会附加固定额外输入Token,做成本测算时纳入该损耗。
三、Qwen3.8‑Max完整接入配置流程
接入方式分为DashScope原生SDK、OpenAI兼容接口两种,推荐优先使用OpenAI兼容接口,生态适配更好,可以直接对接LangChain、LlamaIndex等主流框架。详情👉访问阿里云百炼大模型服务平台页面 了解。
接入前置准备步骤:
- 登录百炼控制台,创建API‑Key,妥善保存密钥,禁止硬编码写入业务代码,使用环境变量加载。
- 在模型市场开通Qwen3.8‑Max模型调用权限,部分快照版本需要手动开启访问权限。
- 确认账号具备足够按量余额或者已经购买Token Plan订阅套餐。
- 测试环境充分验证接口返回、工具调用、多模态图片视频解析,再上线生产。
3.1 Python OpenAI兼容接口基础调用示例
安装依赖包:
pip install openai python-dotenv
创建.env文件存放密钥:
DASHSCOPE_API_KEY=sk-xxxxxxxxxxxxxxxxxxxx
基础对话调用代码:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

def qwen38max_chat(user_query: str, enable_thinking: bool = False):
    resp = client.chat.completions.create(
        model="qwen3.8-max",
        messages=[
            {
   "role":"system","content":"你是专业技术助手,回答严谨完整。"},
            {
   "role":"user","content":user_query}
        ],
        extra_body={

            "enable_thinking": enable_thinking
        },
        max_tokens=8192,
        temperature=0.6,
        stream=False
    )
    usage_info = resp.usage
    print(f"输入token:{usage_info.prompt_tokens},输出token:{usage_info.completion_tokens}")
    return resp.choices[0].message.content

if __name__ == "__main__":
    result = qwen38max_chat("梳理一份软件项目开发方案,包含需求拆解、模块划分、风险评估", enable_thinking=True)
    print(result)
3.2多模态图片输入调用示例
import os
from openai import OpenAI
from dotenv import load_dotenv
load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

resp = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {
   "role":"user","content":[
            {
   "type":"text","text":"分析这张界面截图,输出对应的前端实现方案。"},
            {
   "type":"image_url","image_url":{
   "url":"https://xxx.oss‑cn‑beijing.aliyuncs.com/demo_ui.png"}}
        ]}
    ],
    max_tokens=6144
)
print(resp.choices[0].message.content)
3.3 Function Calling工具调用示例
import os
from openai import OpenAI
from dotenv import load_dotenv
load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

tools = [
    {

        "type":"function",
        "function":{

            "name":"query_database",
            "description":"查询业务数据库获取用户信息",
            "parameters":{

                "type":"object",
                "properties":{

                    "user_id":{
   "type":"string","description":"用户编号"}
                },
                "required":["user_id"]
            }
        }
    }
]

response = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[{
   "role":"user","content":"查询编号1001用户的业务信息"}],
    tools=tools,
    tool_choice="auto",
    max_tokens=4096
)
print(response.choices[0].message.tool_calls)
3.4 cURL命令行调用示例
curl --location 'https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content‑Type: application/json' \
--data '{
 "model":"qwen3.8-max",
 "messages":[{"role":"user","content":"简单介绍大模型上下文缓存的作用"}],
 "extra_body":{"enable_thinking":false},
 "max_tokens":2048
}'
3.5上下文缓存显式标记示例片段
显式缓存标记可以把固定不变的system系统提示片段做缓存,反复请求命中后降低输入开销,适用于Agent、知识库问答场景,仅展示关键消息片段:
messages = [
    {

        "role": "system",
        "content": "你是专业智能体助手,严格按照工具调用规范完成任务...",
        "cache_control": {
   "type": "ephemeral"}
    },
    {
   "role":"user","content":"业务用户的动态问题内容"}
]
四、业务选型与适用场景
优先选择Qwen3.8‑Max的场景
- 复杂专业业务:法律文书分析、金融研报深度拆解、科研论文分析,需要强逻辑推理。
- 长周期Agent智能体:多工具循环调用、自主规划执行任务,Hermes Agent、OpenClaw等复杂智能体框架。
- 工程级代码开发:完整项目生成、多文件重构、复杂算法开发,需要高可靠编码输出。
- 长文档、长视频深度解析:几十万Token文档深度推理,长视频语义抽取,图文混合复杂分析。
- GUI视觉智能体:结合截图、视频画面完成业务规划、界面操作推理。
不建议直接选用该模型的场景
- 高并发简单问答业务,大量普通闲聊、简单摘要,直接使用会带来极高成本,建议选用Flash系列,做模型路由分层。
- 仅需要简单脚本生成,不需要深度推理的线上高QPS业务。
生产环境最佳实践是做模型路由,简单请求路由低成本Flash,中等复杂度任务使用Plus,高难度任务才分发到Qwen3.8‑Max,兼顾输出质量与整体推理成本。
五、生产环境避坑与常见故障排查
开启深度思考带来成本暴涨
enable_thinking开启后思考过程全部计入输出Token,简单业务务必关闭,只有复杂任务按需开启。密钥泄露风险
API Key禁止硬编码,全部通过环境变量读取;个人版Token Plan密钥禁止对外共享,违规会限制调用权限。长上下文不等于长文档强推理
虽然支持百万Token上下文,输入超长文档的时候,远端信息召回仍然存在上限,几十万Token复杂逻辑任务,优先使用Max系列,不要直接使用Flash。缓存没有节省费用
当每轮请求大部分内容动态变化,缓存命中率极低,应该关闭缓存;缓存收益主要来自固定不变的系统提示词、知识库公共前缀。快照版本选择
线上业务指定快照版本qwen3.8‑max‑0902,避免后台模型迭代导致输出效果突变;测试环境可以直接使用qwen3.8‑max自动跟随最新版本。Credits耗尽自动切换按量计费
订阅额度耗尽不会报错,自动切换按量,一定要配置用量告警,监控Token消耗,防止意外高额账单。多模态图片视频报错
图片URL需要公网可访问,内网OSS资源需要开启外网访问权限;视频输入对视频时长、文件大小存在限制,超长视频建议提前做分片预处理。工具调用偶发JSON解析失败
即使是Max旗舰模型,复杂多轮工具调用仍然存在格式异常概率,业务代码必须增加JSON解析捕获异常、重试逻辑,不能完全信任模型输出格式。限流报错429
出现429代表触发TPM/RPM限流,生产环境增加请求重试、退避策略;消费档位提升后,平台会自动上调限流配额。
总结
Qwen3.8‑Max作为千问旗舰MoE基座,百万级上下文、原生多模态、深度思考、高可靠Agent工具调用、工程级代码能力,面向高复杂度专业业务、长周期智能体、长文档视频解析场景。开发者上线业务前,需要完整理解按量计费、Token Plan订阅、NightPlan夜间折扣、上下文缓存四套成本相关规则,避免上线之后成本失控。
接入层面优先采用OpenAI兼容接口,便于对接主流开发框架;生产环境建议锁定快照版本,配置用量告警,增加异常捕获与重试逻辑。业务上不建议全部流量跑旗舰模型,采用分层路由策略,简单任务分发轻量模型,复杂任务才调用Qwen3.8‑Max,实现业务效果与推理成本之间平衡。正式上线前,使用真实业务数据集完成充分测试,验证输出质量、接口延迟、Token消耗规模,再推向生产环境。
