财税公司讨论GEO时,常把问题简化成“自建团队还是外包”。但真正要解决的,是选题权、执行排期和发布前确认由谁承担。本文从这一问题归属出发,梳理自建、外包和混合三种方式的适用条件、协作要点与验证边界,帮助在预算和人手有限时做出现实取舍。GEO是内容与信任建设的一种方式,不能替代服务质量、报价合理性和交付可靠性,也不保证带来咨询或排名。
先判断问题归属,再谈谁来做
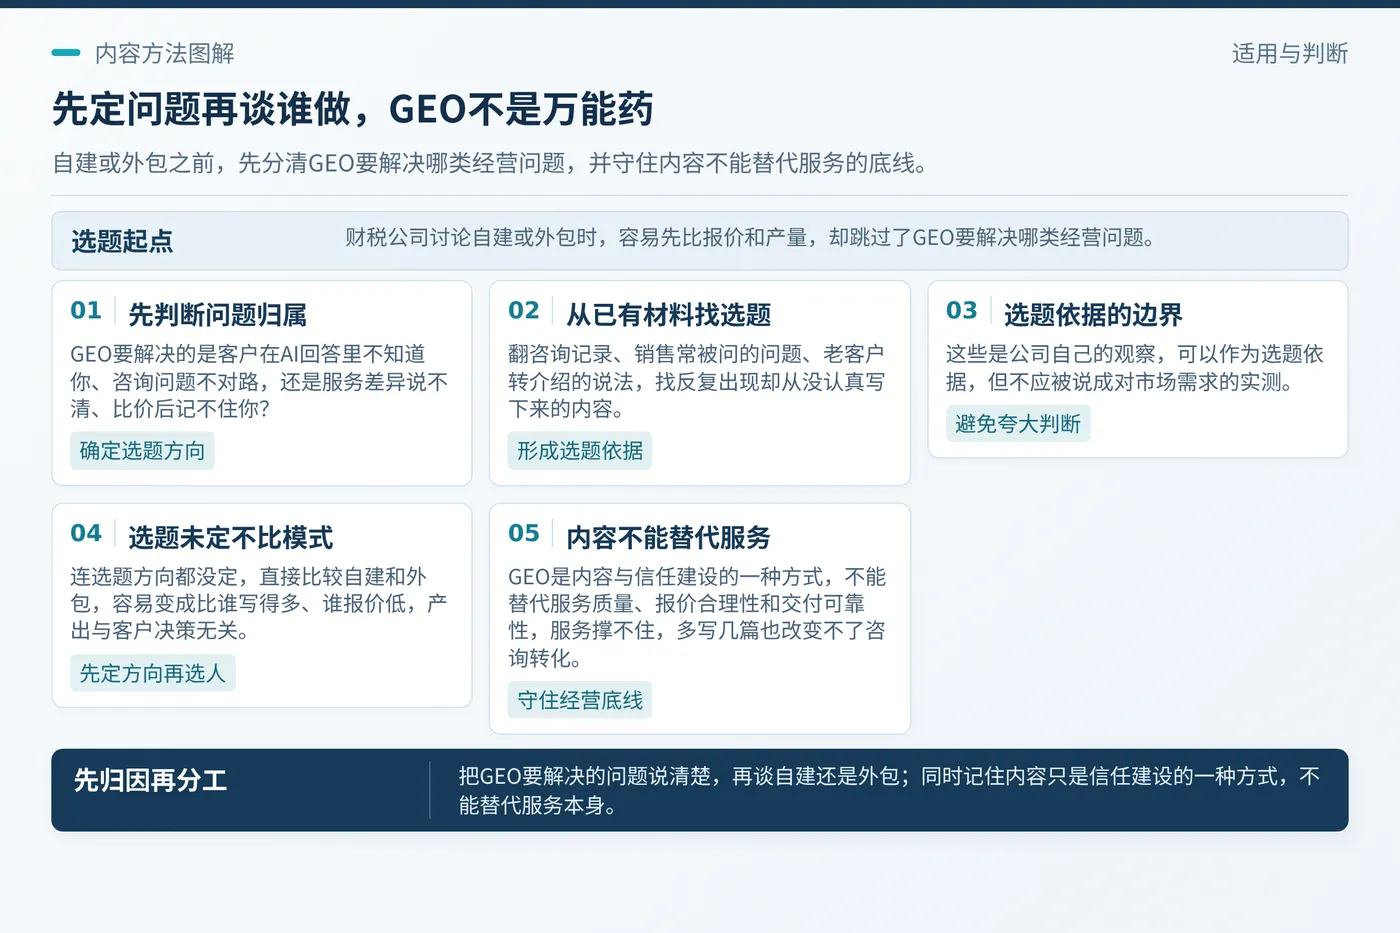
比较自建和外包之前,更前置的问题是:GEO要解决的是哪类经营问题。是客户在AI回答里根本不知道这家公司,是咨询来了但问题不对路,还是服务差异说不清、客户比价后记不住你?不同问题对内容能力和投入节奏的要求不一样。
更稳妥的做法是从已有材料出发:翻一翻近期咨询记录、销售常被问到的问题、老客户转介绍时怎么描述你们,看看哪些内容反复出现却从来没有被认真写下来。这些是公司自己的观察,可以作为选题依据,但不应被说成对市场需求的实测。如果连选题方向都没定,直接比较自建和外包,很容易变成比谁写得多、谁报价低,最后产出一批和客户决策无关的内容。
需要明确一个边界:GEO是内容与信任建设的一种方式,不能替代服务质量、报价合理性和交付可靠性。内容做得再顺,服务本身撑不住,咨询转化也不会因为多写几篇就改变。
 先判断问题归属
自建团队适合什么情况
自建更适合这样一类财税公司:负责人或核心业务骨干本身愿意出题,能判断哪些问题值得写、哪些说法会踩合规边界,内部也有人能稳定安排时间执行。此时自建的优势在响应快、上下文熟、改稿成本低。客户今天问了一个新问题,明天就能进入选题池,不必经过外部沟通。
自建的现实代价也要算清楚。财税专业人员的单位时间价值不低,写作、查资料、改稿、排期都会占用本可以做业务的时间。如果没有人真正负责这件事,常见结果是开头热情很高,两三周后停更,选题池空着,团队对这件事失去信心。这不是能力问题,而是排期和责任人没有落实。
一个务实的自建安排可以这样起步:指定一名内容负责人,不必是专职;每周固定一个短时段处理选题和进度;写作由熟悉业务的人出初稿或口述要点,再由文字能力较好的人整理;发布前由负责人做一次事实与边界确认。流程简单,但每一步都要有明确的人。适用边界在于:自建适合愿意持续投入管理精力、且能承受较慢起步的团队。如果负责人长期出差、业务骨干已经满负荷、也没有人能承担改稿与排期,自建很容易变成挂在计划表上的事。
外包服务适合什么情况
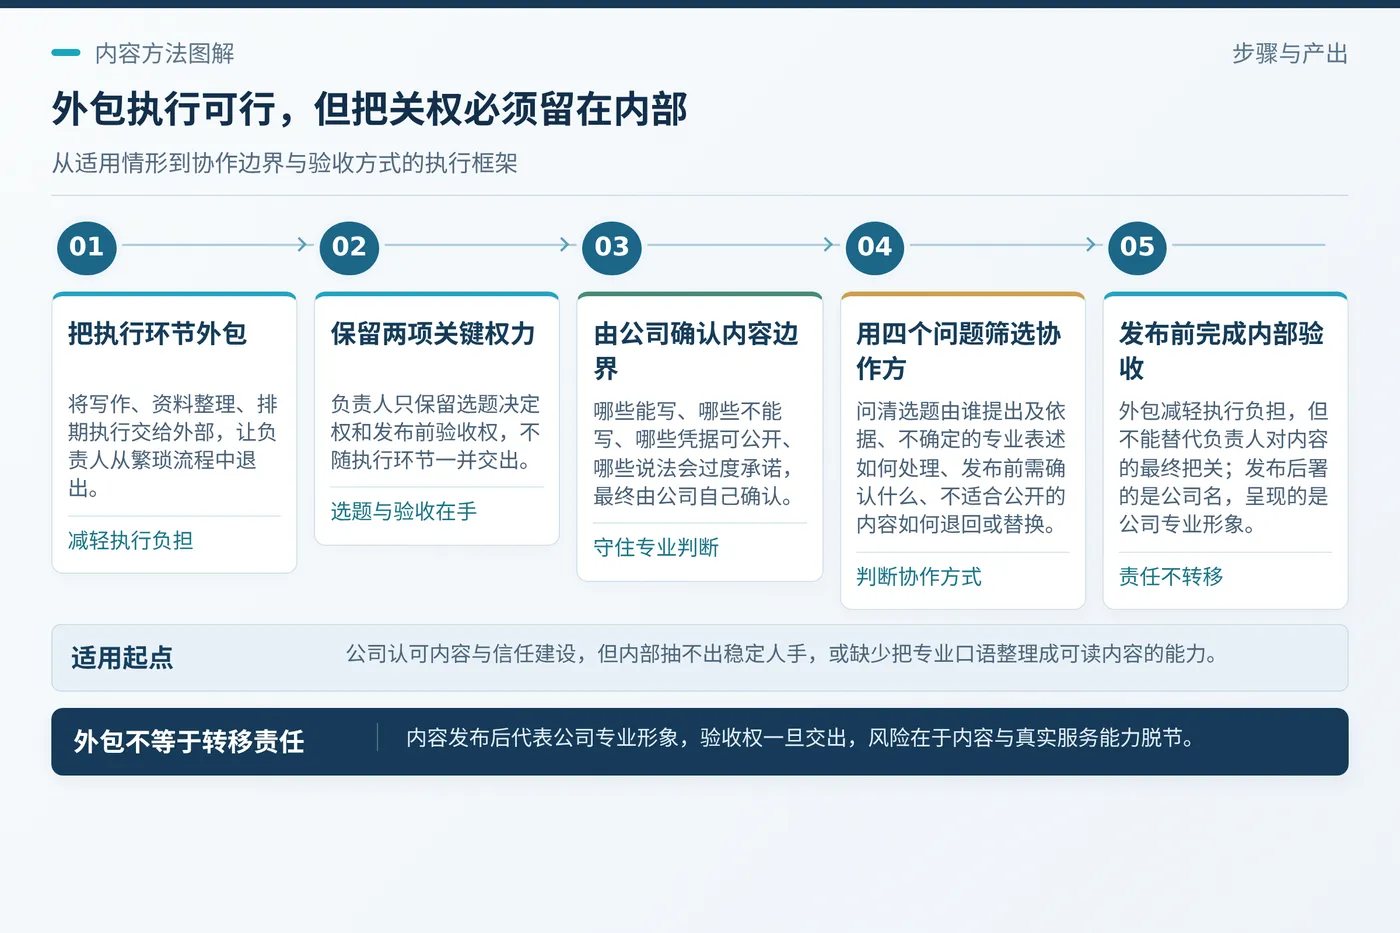
外包更适合另一种情形:公司认可内容与信任建设的必要性,但内部确实抽不出稳定人手,或者缺少把专业口语整理成可读内容的能力。此时把写作、资料整理、排期执行等环节交给外部,可以让负责人从繁琐流程中退出来,只保留最关键的两个权力:选题决定权和发布前验收权。
这里要特别注意外包的边界。财税内容涉及专业判断和客户信息,外包方通常不承担你们业务判断的责任。哪些能写、哪些不能写、哪些凭据可以公开、哪些说法会过度承诺,最终仍要由公司自己确认。把验收权一并交出去,风险不在文字好不好看,而在内容与你们真实服务能力脱节。
 外包服务适合什么情况
选择外包时,比较有用的问法是:选题由谁提出、依据什么;遇到你们不确定的专业表述怎么处理;发布前需要你们确认哪些内容;如果某类内容不适合公开,如何退回或替换。这些问题比问能写多少篇更能看出协作方式是否合适。还要说清一个常见误解:外包不等于把内容责任转移出去。内容一旦发布,署的是你们公司的名,客户和同行看到的也是你们的专业形象。外包能减轻执行负担,但不能替代负责人对内容的最终把关。
混合方式与试用验证
现实中不少财税公司采取混合方式:选题和客户问题梳理由内部完成,因为这部分最依赖业务判断;初稿整理、资料归类、排期执行交给外部或兼职;发布前的专业确认回到负责人。这样既不完全依赖外部对业务的理解,也不让内部被流程拖住。混合方式的关键是分工要写清楚,而不是模糊地说“一起做”。谁出选题、谁写初稿、谁核对事实、谁最终确认发布,每个环节对应到人。分工含糊时,最常见的问题不是没人干活,而是每个环节都以为别人会负责,最后拖到没有下文。
无论倾向哪种方式,都建议先小规模试用,再决定是否加大投入。试用期不必追求产量,重点验证三件事:选题能不能持续产出、协作流程能不能跑顺、发布前确认是否真的有人负责。如果选择自建,试用可以看内部排期是否真的执行、业务人员是否愿意配合提供素材、负责人的确认环节是否被跳过。小规模试用的价值在于暴露流程问题,而不是证明这件事一定有效。
试用结束后的判断也要克制:可以看流程是否稳定、内容是否准确、是否出现了值得继续跟进的问题,但不宜据此推断获客数量或排名变化。GEO内容建设的进展需要时间观察,且受服务、价格、区域竞争等多种因素影响,不能承诺固定结果。
决策时守住几条线
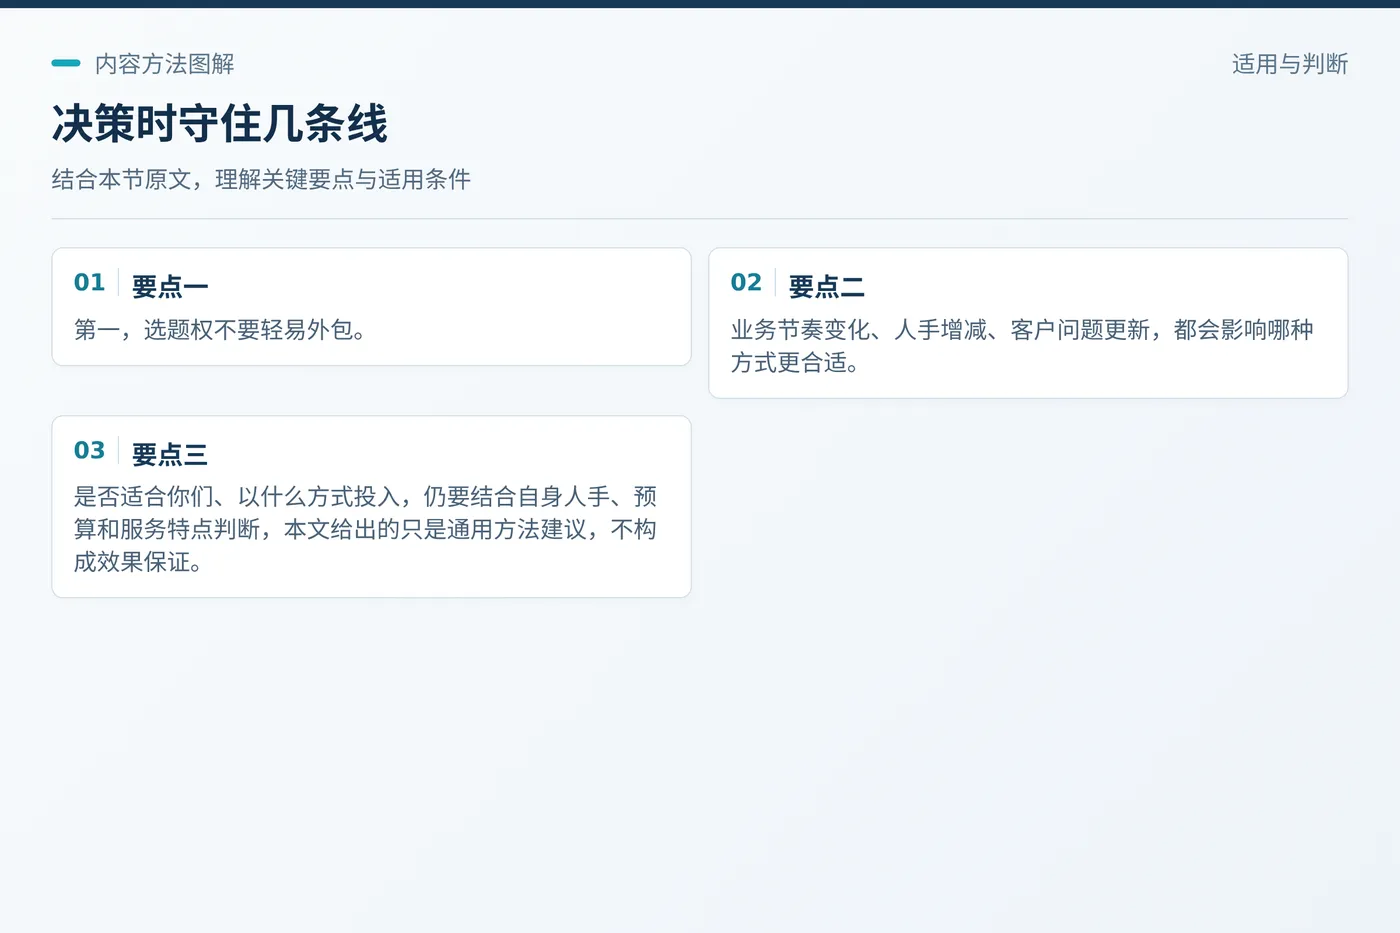
第一,选题权不要轻易外包。选题来自对客户问题的理解和对自身服务差异的判断,这是财税公司的核心经验,交出去等于让外部替你们决定讲什么。
第二,发布前的确认环节必须有人。哪怕只是负责人花十分钟过一遍,也比无人确认更稳。
第三,不要把自建或外包当成一次性决定。业务节奏变化、人手增减、客户问题更新,都会影响哪种方式更合适。定期回看流程是否还跑得动,比一开始选对更重要。
 决策时守住几条线
第四,对所有效果说法保持警惕。可以要求对方说明具体做什么、依据什么、如何验收,并把效果描述理解为对方自述而非已验证事实。
自建、外包或混合,各自对应不同的管理投入与协作条件,没有一劳永逸的选项。对财税公司而言,更可复用的判断顺序是:先把要解决的经营问题说清楚,再确认选题权、排期责任和发布前确认由谁承担,最后通过小规模试用观察流程是否跑得顺、内容是否准确、边界是否守住。这些方法本身不保证获客或排名,也不替代对服务质量和交付可靠性的持续投入。是否适合自身情况,仍需结合人手、预算和服务特点作独立判断。