
技术栈:Python · OpenCV · YOLO11 · ByteTrack · FastAPI · SQLite · JavaScript
01. 为什么目标检测不能直接用来统计车流量?
最近在研究计算机视觉的工程化应用时,我选择了一个比较具体的任务:给一段停车场出入口视频,自动统计进出车辆,并将识别结果展示在 Web 页面上。
这个问题表面上并不复杂。
使用预训练 YOLO 模型,可以直接识别画面中的轿车、公交车、摩托车和卡车。
但当真正开始实现计数逻辑时,就会发现一个问题:
识别出一辆车,不代表这辆车应该被计数一次。
假设视频帧率为 30 FPS,一辆车在画面中持续出现 3 秒,就可能产生约 90 次检测结果。
如果简单累加检测框数量,一辆车就有可能被统计几十次。
因此,我把整个问题拆解成三个核心任务:
- 目标检测:识别车辆及其坐标。
- 多目标跟踪:为同一辆车辆分配跨帧保持的 Track ID。
- 越线事件识别:判断车辆是否真正穿越指定计数线。
在此基础上,再通过 FastAPI 和前端页面完成数据展示。
02. 系统架构设计
整个项目采用分层流水线结构:
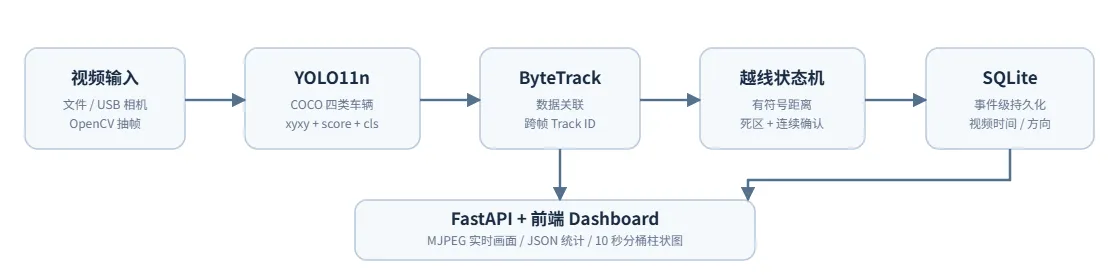
这里最关键的设计是将目标检测结果和业务事件分离。
目标检测只负责回答“当前画面中有哪些车辆”,而越线状态机负责回答“哪辆车在什么时候完成了一次进入或离开”。
这种架构可以避免将视频识别算法与业务统计逻辑耦合在一起,也方便后续增加车道识别、区域检测和异常行为分析等功能。
03. 使用 YOLO11 与 ByteTrack 实现多目标跟踪
检测模型选择 yolo11n.pt,主要是为了先建立一个相对轻量、容易复现的系统基线。
在模型选择上,不能只考虑检测精度,还需要考虑推理速度、资源消耗以及多目标跟踪的稳定性。
Ultralytics 官方提供的 COCO 测试数据显示:
|
模型
|
mAP50–95
|
CPU ONNX 参考延迟
|
| --- | --- | --- |
|
YOLO11n
|
39.5%
|
56.1 ms
|
|
YOLO11s
|
47.0%
|
90.0 ms
|
|
YOLO11m
|
51.5%
|
183.2 ms
|
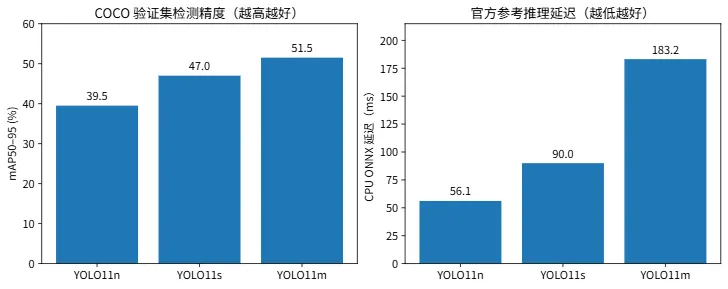
上述数据是官方参考基准,不是本项目的实测结果。
在视频分析任务中,我没有选择单纯逐帧调用 predict(),而是使用 Ultralytics 提供的 track() 接口,并启用 ByteTrack。
核心代码如下:
from ultralytics import YOLO

model = YOLO("yolo11n.pt")

result = model.track(
    frame,
    persist=True,
    tracker="bytetrack.yaml",
    classes=[2, 3, 5, 7],
    conf=0.1,
    imgsz=640,
    verbose=False
)[0]

if result.boxes is not None and result.boxes.is_track:
    track_ids = result.boxes.id.int().cpu().tolist()
    boxes = result.boxes.xyxy.int().cpu().tolist()
其中,classes=[2, 3, 5, 7] 对应 COCO 数据集中的 car、motorcycle、bus 和 truck。
persist=True 表示连续视频帧共享跟踪状态,让同一个目标尽量保持一致的 Track ID。
ByteTrack 的关键思想之一,是在目标关联过程中利用低置信度检测结果进行补充匹配,从而减少因遮挡造成的轨迹中断。
不过,Track ID 的连续性不能完全保证。如果发生严重遮挡、ID Switch 或长期丢失,依赖轨迹的计数逻辑仍然可能产生误差。
04. 核心算法:如何准确判断车辆越线?
这是整个项目中最值得单独讨论的部分。
首先,不能简单判断检测框是否与计数线相交,因为车辆可能长时间停在线附近,或者检测框边缘受到抖动影响。
我使用检测框底边中心点近似车辆接地点:
foot_x = (x1 + x2) // 2
foot_y = y2
假设计数线由两个端点 A、B 构成,车辆位置为 P。
计算 P 相对于有向直线 AB 的有符号距离:
d = ((Bx-Ax)*(Py-Ay) - (By-Ay)*(Px-Ax))
    / sqrt((Bx-Ax)^2 + (By-Ay)^2)
通过距离的正负号,就可以判断车辆位于计数线的哪一侧。
但仅仅判断符号发生变化还不够。
例如,某辆车停在计数线附近,连续几帧的距离可能为:
Frame 1: -3 px
Frame 2: +2 px
Frame 3: -1 px
Frame 4: +4 px
如果直接根据符号变化计数,这辆车可能被反复统计。
为了解决这个问题,我设计了一个简单的状态机,引入两个机制:
死区(Dead Zone):当车辆距离计数线小于设定阈值时,不更新其稳定侧。
连续帧确认(Temporal Debouncing):只有连续若干帧都处于同一非死区侧,才认为车辆已经稳定到达这一侧。
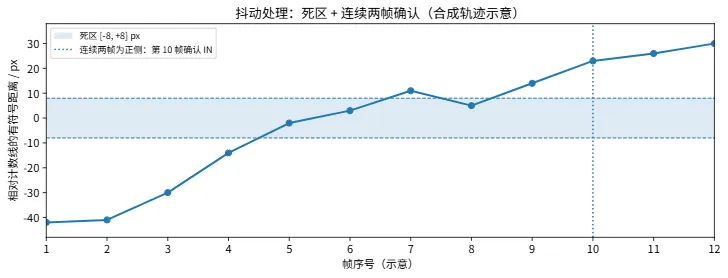
合成轨迹示意:通过死区和连续稳定帧确认,降低检测框在计数线附近抖动造成的误计数。
核心逻辑:
def update(self, track_id, point, frame_idx):
    distance = self.signed_distance(point)

    side = (
        1 if distance > self.margin
        else -1 if distance < -self.margin
        else 0
    )

    state = self.states.setdefault(
        track_id, TrackState()
    )
    state.last_frame = frame_idx

    if side == 0:
        state.candidate_side = 0
        state.candidate_frames = 0
        return None

    if side != state.candidate_side:
        state.candidate_side = side
        state.candidate_frames = 1
    else:
        state.candidate_frames += 1

    if state.candidate_frames < self.min_frames:
        return None

    if side == state.stable_side:
        return None

    previous = state.stable_side
    state.stable_side = side

    if previous is None:
        return None

    if previous == -1 and side == 1:
        self.in_count += 1
        return "IN"

    if previous == 1 and side == -1:
        self.out_count += 1
        return "OUT"

    return None
第一次稳定检测到车辆时,只初始化车辆所在侧,不立即计数。
只有已经建立稳定侧的车辆,后来又稳定出现在计数线另一侧时,才触发一次跨线事件。
相较于直接检测线段交叉,这种实现可以过滤一部分由检测框位置抖动引起的误触发。
05. 后端工程化:FastAPI + SQLite
完成目标识别和越线判断后,接下来要解决的是数据如何保存、查询和展示。
这里采用 SQLite 进行轻量化事件存储,而不是直接保存每一帧的检测结果。
数据库结构:
CREATE TABLE IF NOT EXISTS crossings (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    video_sec REAL NOT NULL,
    track_id INTEGER NOT NULL,
    direction TEXT NOT NULL
        CHECK(direction IN ('IN', 'OUT'))
);
每次越线产生一条记录,包含视频时间、车辆跟踪 ID 和方向。
然后使用 SQL 完成时段聚合:
SELECT
    CAST(video_sec / 10 AS INTEGER) * 10
        AS bucket,
    SUM(CASE WHEN direction='IN'
        THEN 1 ELSE 0 END) AS in_count,
    SUM(CASE WHEN direction='OUT'
        THEN 1 ELSE 0 END) AS out_count
FROM crossings
GROUP BY bucket
ORDER BY bucket;
为了防止模型推理速度影响统计结果,处理本地视频时采用视频时间,而不是系统当前时间。
FastAPI 提供三个入口:
/:Web 可视化界面。/stream:使用 MJPEG 输出标注视频流。/api/stats:查询进入总数、离开总数和分时段统计数据。
前端通过 JavaScript 周期性获取统计数据,并使用 Canvas 绘制车流量柱状图。
这样就完成了从计算机视觉算法到可访问 Web 系统的完整连接。
06. 测试:如何证明计数器没有明显逻辑问题?
真正做 AI 项目时,不能只看检测框有没有画出来,更重要的是验证业务结果是否符合预期。
所以在项目中,我为计数模块设计了独立的单元测试。
其中一个典型场景是:车辆在计数线附近发生抖动,但最终完成一次真实越线。
def test_crossing_once_with_dead_zone():
    counter = LineCounter(
        (0, 50), (100, 50),
        margin=4,
        min_frames=2
    )

    positions = [
        30, 31, 48, 49,
        58, 59, 61, 62
    ]

    events = [
        counter.update(7, (50, y), i)
        for i, y in enumerate(positions)
    ]

    assert [e for e in events if e] == ["IN"]
    assert counter.in_count == 1
另外还覆盖了来回穿越、新目标初始化以及过期轨迹清理等场景。
目前,四项纯计数逻辑单元测试已经通过。
但这并不等同于完整系统的实际识别准确率。真正的系统验收,还需要在真实视频上进行人工标注,统计跨线事件的 Precision、Recall、F1,以及分时段计数误差。
07. 运行项目
准备 Python 3.10+ 环境和一段固定机位的交通视频,安装依赖:
cd traffic_counter
pip install -r requirements.txt
将视频命名为 traffic.mp4,放在 traffic_counter 目录下,然后启动服务:
VIDEO_SOURCE=traffic.mp4 \
uvicorn server:app --host 127.0.0.1 --port 8000
在浏览器访问:
http://127.0.0.1:8000
即可查看带车辆跟踪 ID 的视频、累计进出车辆数量及分时段事件图表。
计数线默认为画面高度约 55% 的水平线,实际使用时需要根据摄像头机位调整位置及方向。
08. 进一步优化
当前实现已经覆盖了车辆检测、跟踪、事件判定、存储和前端展示的基本流程,但距离长期运行的生产系统仍然存在工程差距。
首先是跟踪稳定性。需要重点关注目标短暂遮挡带来的 ID Switch,必要时引入 ReID 或调整跟踪器参数。
其次是业务区域建模。复杂路口可能存在多个车道,仅靠一条计数线无法区分车辆真实行驶路线,可以进一步增加 ROI 区域约束和多车道计数规则。
最后是系统部署。实际接入 RTSP 摄像头后,需要考虑断流重连、推理队列、事件幂等、历史任务管理、性能监控及接口鉴权。
对于视频处理系统,我也会特别关注模型推理吞吐量与端到端延迟的区别。单帧推理耗时较短,不代表整个应用一定能够稳定处理对应帧率的视频。
结语
通过这个项目,我将一个看似简单的视觉检测任务,扩展成了完整的智能识别应用。
其中真正具有工程价值的,不只是使用 YOLO 找到车辆,而是围绕跨帧身份关联、时序事件判定、数据持久化和前端展示,构建了一条相对完整的 AI 应用开发链路。
计算机视觉不仅要解决“看到了什么”,也需要进一步解决“发生了什么,以及如何把它转化成可信的数据”。
这正是我持续探索 AI 智能识别、计算机视觉和全栈工程实践的方向。

