百炼模型内置联网搜索与网页抓取:一行 tools 声明的实测记录

简介: 阿里云百炼推出模型侧联网工具,仅需`--tool '{"type":"web_search"}'`一个参数,即可让大模型实时检索并抓取网页,无需应用层开发维护检索逻辑。实测上海天气查询从拒答变为精准播报,调用全程可审计,大幅降低AI接入业务的工程成本。(239字)

先说背景:为什么这件事值得记一笔

团队里想把大模型接进业务,第一个被问到的问题几乎都是"它能不能查最新的数据"。训练数据有截止日期,问它今天的事,它要么拒答,要么拿旧知识硬答。我们内部工具第一周就撞上了:问当天天气,九秒回一句"我无法提供实时天气数据,因为我的知识库没有联网更新功能",后面附三条让我们自己去查的建议。

常见的补法是自己在应用层接一套检索:选检索服务、写调用、把结果拼进上下文、再处理多轮。这条路能走通,但每一环都是自己的代码,每一环都要维护,而且多轮检索的编排逻辑会长在应用里。我们内部粗估过这条路的账:选服务加写调用和重试是一周起步,之后检索服务每改一次接口都要跟着改一次,这部分成本不会出现在立项表里,但会一直出现在排期里。

阿里云百炼把这件事做成了模型侧的工具。命令行里多写一个参数,搜索和网页抓取由服务端执行,应用层不持有任何检索逻辑。我 10 月 27 号把这条链路完整跑了一遍,读数都留了痕,版本 2.5.0。

基线:不带工具时模型怎么答

bl text chat --message "今天上海天气怎么样" --timeout 120 --max-tokens 400

9.2 秒返回,内容是一句拒答加三条自查建议。这一步是留对照用的:后面所有差别都只来自联网工具那一个参数。

装命令行看CLI 安装页,Key 在控制台密钥管理页。

顺带一个英文语境的同形对照,更能说明问题:不带工具问"今天西雅图天气、并报出你所指的日期",模型先说没有实时数据,然后报的日期是 2026 年 6 月 16 日,而那天实际是 10 月 27 日。加上工具后日期自己就对了。所以"不能联网"和"知道自己不能联网"是两回事,后者才是要解决的。

开启联网:一个参数

bl text chat --api responses --tool '{"type":"web_search"}' --message "今天上海天气怎么样" --timeout 120 --max-tokens 400

官方文档对开启方式的描述只有一句:通过 tools 参数添加 web_search 工具即可启用联网搜索。没有配置文件,没有要先启动的服务。

24.5 秒返回当天实况:多云到阴,气温约 15 到 20 度(实况最高 23.4 度、最低 17.7 度),北风小于 3 级,湿度约 70 到 80 成,空气质量良。表头日期模型自己写对:2026 年 10 月 27 日,周二。
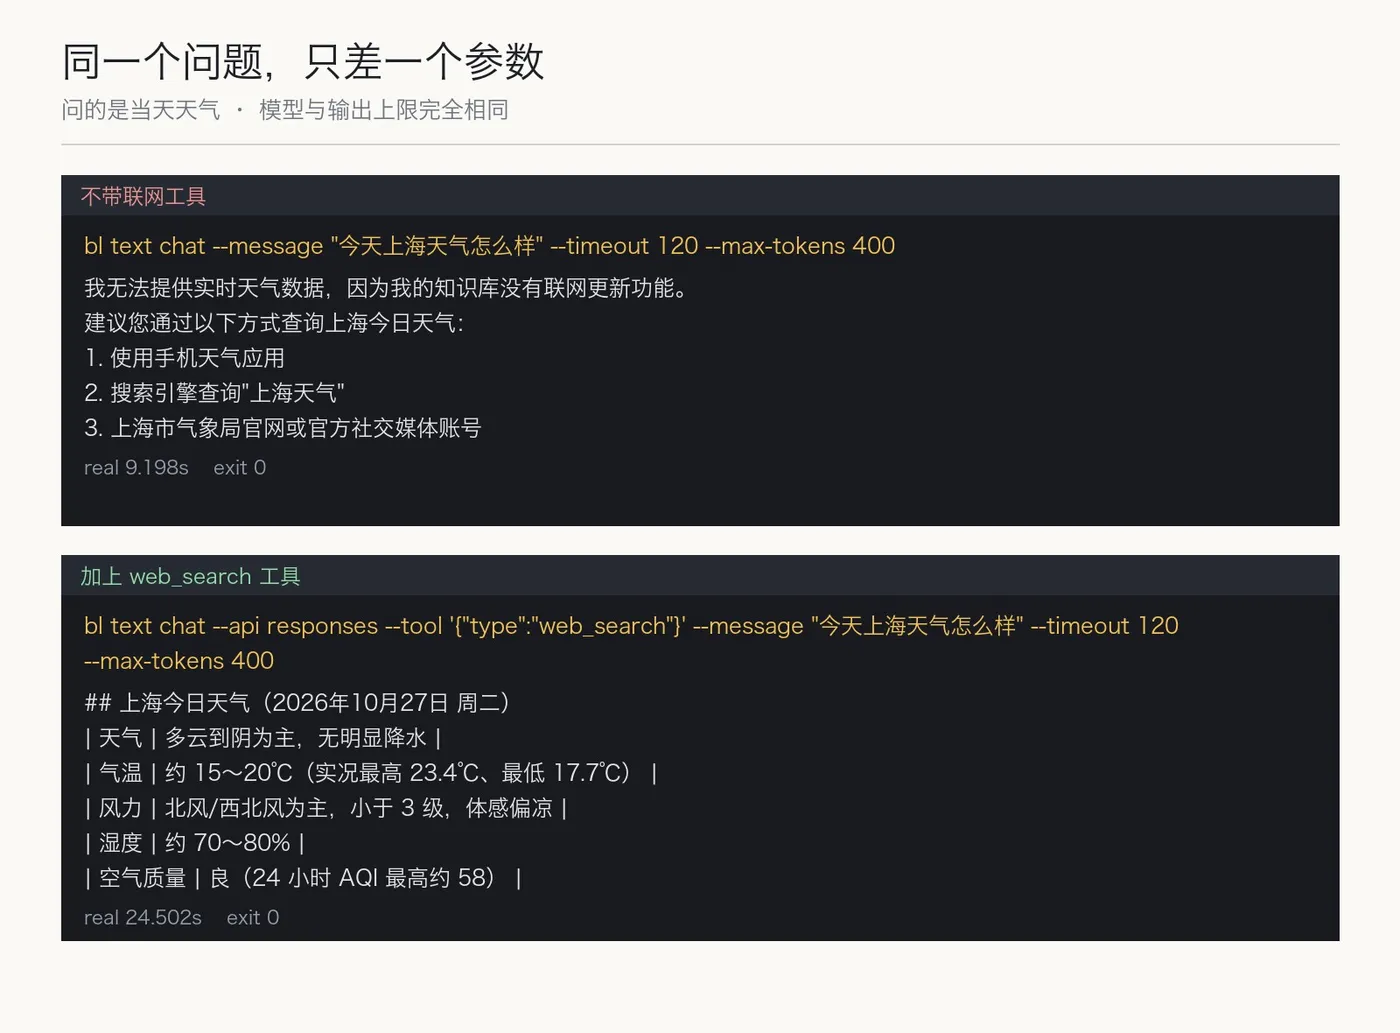
同一个问题,带与不带联网工具的对照

网页抓取:第二个工具

--tool 可重复传。加 {"type":"web_extractor"} 后模型能打开网页读正文。我让它读官方文档的联网搜索页并把参数念回来,74 秒返回,它自称已打开并阅读该页,列出的四种搜索策略名称与默认值,我事后逐字对过文档,一致。

这里有一个架构上值得注意的点:网址、关键词、读取页数我都没有指定。检索轮次与抓取目标由模型自行决定,应用层只声明"允许使用哪些工具"。这把多轮检索的编排从应用代码里移了出去,也意味着应用侧不再需要维护"查几次、查什么"的循环逻辑。

可审计性:调用次数写在输出里

把输出换成 json,output 数组逐条给出类型。我那次共十条:四条思考、两次搜索调用、三次网页抓取调用、一条最终回答。usage 里的工具计数字段写着 web_search 两次、web_extractor 三次,与逐条计数一致。
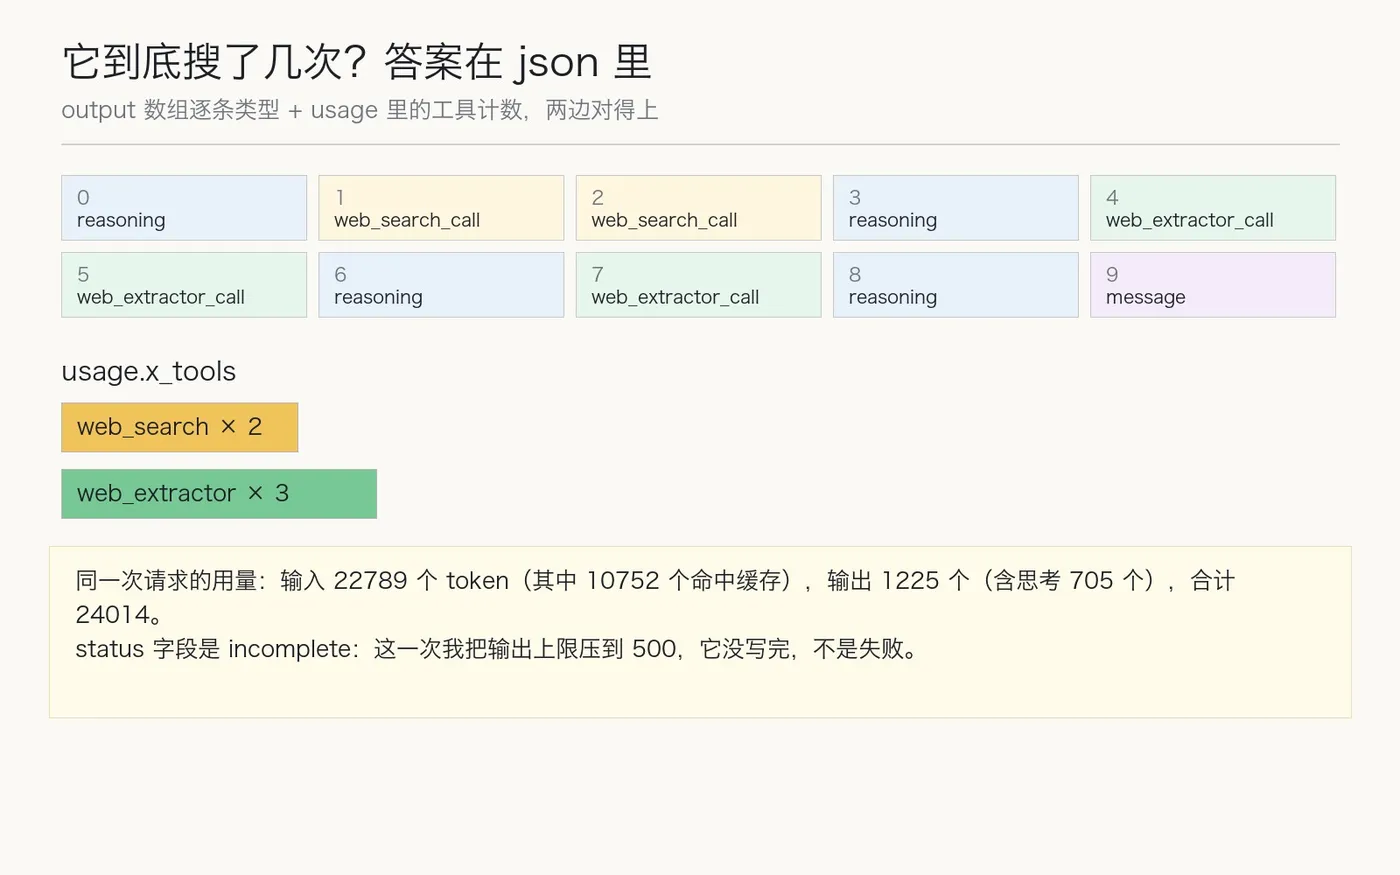
json 输出里的检索轨迹与工具计数

对要进生产流程的团队,这一点比"模型说它搜了"重要得多:工具调用次数是可核对的字段,可以进监控和断言。思考摘要同样可读,第一条是"我没有实时天气数据,所以我应该去搜",后面一条是"不同来源给的数据略有出入,国家气象中心说的是某个值"。它在对账,这个行为本身也是可以观察的。

进生产前要知道的三件事

一是延迟。我这几个读数在 17 秒到 127 秒之间,不联网的对照是 9 秒到 14 秒。多轮检索的问题更慢:我问"上个月新上架了哪些模型",带 300 秒超时跑了 205 秒,且因为输出上限设 800,只拿到过程叙述没拿到结论。超时与输出上限都要按问题复杂度给足,同步接口要按这个量级设超时。

二是上下文体积。联网那次输入 22789 个 token(其中 10752 命中缓存),输出 1225 个,合计 24014。检索回来的网页正文全部进上下文,容量规划要按带检索的峰值算,不能按裸对话算。

三是策略与收费。官方文档把搜索策略分四档,turbo 为默认,agent 与 agent_max 两档标注"启用该策略时,每次调用额外收费"。命令行没有选策略的参数,我这些调用走的都是接口默认;多轮搜索与抓取是工具自身行为,不等于显式开了某档。数额以官方文档为准,采购评估时单独核。

另一条路

需要自己控制检索内容时,用 bl search web,只检索不总结,2.3 秒返回带标题、摘要、链接的结果列表;--count 可指定条数,不指定给五条(帮助文档写的默认十与实际不符,按五规划)。它是上限不是保证,冷僻查询要二十条可能只回三条,分页逻辑别假设能拿满。

想先看控制台,去阿里云百炼控制台。整条验证链路我没有创建任何云资源,也没有改动任何既有配置。

相关文章
|
1月前
|
人工智能 JSON Shell
把 AI 漫剧做成一条可复现的生产管线:百炼 CLI 四步链路与单价账
本文聚焦AI漫剧工业化生产,以百炼CLI(v1.22.0)构建可复现、可验算、可计价的四步管线:角色设定图→参考图分镜→配音→生视频。强调“参考图”为唯一身份锚点,破除seed误区;提供实测命令、耗时与单价(单集约¥3.8),附完整可执行脚本,兼顾成本治理与合规边界。(239字)
把 AI 漫剧做成一条可复现的生产管线:百炼 CLI 四步链路与单价账
|
1月前
|
人工智能 数据安全/隐私保护
百炼图像生成三档模型实测:中文小字的正确率、耗时与计价口径
本文实测百炼三大图像生成模型在中文文字渲染上的真实表现,聚焦公众号封面、海报等物料中易出错的日期、价格、法务句等小字号文本。结果表明:z-image-turbo快且便宜(5.1s/¥0.1),但2026年误为2016年;qwen-image-3.0与3.0-pro两轮全对(19/19),兼顾精度与交付稳定性。推荐按场景分档使用,避免“一档通吃”。
百炼图像生成三档模型实测:中文小字的正确率、耗时与计价口径
|
20天前
|
人工智能 自然语言处理 安全
阿里云百炼产品月报【2026年9月】
阿里云百炼本月重磅升级:Qwen3.8全模态实时模型上线,Token Plan取消周限额、新增Essential套餐及Agent Harness工具权益;Flow Agent预置模板即开即用,MCP广场上新46项服务,覆盖科研、金融、多媒体等场景;应用与Skill广场新增超30款模板及解决方案,控制台全面焕新,助力企业高效构建AI应用。
557 0
|
1月前
|
JSON 文字识别 API
open-code-review 接百炼:7 档 qwen 模型审同一份代码,一次 PR 的总账与耗时实测
本文实测 open-code-review 接入百炼 qwen 系列模型的完整方案:内置 dashscope provider,支持 7 档 qwen 模型;单价差 40 倍,单次审查成本差 545 倍;qwen3.7-plus 为性价比拐点(23.4 秒、满分、¥0.0799 内);详解配置、成本估算与门禁选型。
open-code-review 接百炼:7 档 qwen 模型审同一份代码,一次 PR 的总账与耗时实测
|
8月前
|
机器学习/深度学习 人工智能 自然语言处理
除夕夜,国产顶流压轴上线,QWEN3.5多模态开源!
加我进AI讨论学习群,公众号右下角“联系方式” 文末有老金的 **开源知识库地址·全免费** --- ![Image](https://ucc.alicdn.com/pic/developer-ecology/p3shvhj26rigq_682da514f2d84d68857b797ebe2fbced.jpg) 除夕夜,老金我刚咬了一口韭菜鸡蛋饺子。 手机"叮"的一声,弹出个通知。 老金我瞄
|
1月前
|
运维 JavaScript API
语音能力栈的一次完整梳理:CosyVoice合成、Fun-ASR识别、Qwen-Omni多模态交互,一条CLI链路跑通
百炼CLI统一整合语音合成、识别与多模态交互能力,提供一站式命令行入口、统一计费与治理。支持64+系统音色(含方言)、Flash/异步ASR、Qwen-Omni多模态理解,集成Pipeline编排、用量管控及开源生态协同(如MCP),显著降低语音应用开发与运维成本。(239字)
语音能力栈的一次完整梳理:CosyVoice合成、Fun-ASR识别、Qwen-Omni多模态交互,一条CLI链路跑通
|
1月前
|
缓存 JSON 自然语言处理
从零开始搭建知识库 · EP06 · 范式篇(一)知识编译 vs 运行时检索
本文为「从零搭建知识库」第六期,对比检索式与编译式范式:前者实时切片检索,后者让模型通读全库生成结构化知识页。实测表明,编译范式能主动发现跨文档冲突、提升复杂问答一致性,并借助隐式前缀缓存显著降本(高频场景约6问回本),但牺牲元信息、不适用权限隔离与高频更新场景。(239字)
|
1月前
|
存储 人工智能 自然语言处理
阿里云千问办公QwenWork指南:产品核心能力、费用价格、使用场景及问题解答,一文看懂!
阿里云千问办公QwenWork是面向办公场景的AI智能体,支持自然语言一句话生成PPT、分析财报、搭建网页等,深度集成钉钉,覆盖文档、会议、审批、多模态理解与全栈网页交付等六大能力。提供免费版及个人/企业付费版,开箱即用,真正实现“说句话就干活”。
|
1月前
|
人工智能 文字识别 API
阿里开源的代码审查工具一周涨了 15000 星,它底层用的是谁家的模型?
GitHub周榜第一开源工具`open-code-review`(CLI名`ocr`)原生集成阿里云百炼(DashScope),支持一键调用Qwen系列大模型进行AI代码审查。实测验证:配置简单、国内直连、成本可控,最低单次审查仅需几厘钱,且模型按需切换,深度与效率兼顾。(239字)
|
1月前
|
缓存 JSON API
DeepSeek‑V4完整技术解析:Flash与Pro双版性能、计费缓存机制、API实战调用全教程
在大模型工程落地过程当中,超长上下文能力一直是开发者的强需求,但长期面临两大行业痛点:一部分长上下文模型推理速度缓慢,无法支撑线上高并发实时业务;另一部分虽然性能强劲,但是调用成本居高不下,中小企业很难大规模上线。DeepSeek‑V4系列采用差异化双版本产品策略,同时推出`deepseek‑v4‑flash`与`deepseek‑v4‑pro`两款MoE混合专家架构大模型,分别面向轻量化高频业务、复杂深度推理两大赛道,两款模型统一标配**100万Token超长上下文窗口**,把百万级长文本处理能力下放到普通开发者与中小企业,打破长上下文大模型的落地壁垒。
476 0

热门文章

最新文章