
背景
这次我想练习把数据库查询做成一个完整的后端接口。选题时,我给自己留了一个具体的问题:如果很多人反复查看同一份统计结果,后端有没有必要每次都重新计算?
商品分类统计就是一个容易理解的例子。页面上展示的商品数量、库存汇总和价格统计,可能在短时间内被读取很多次,但数据未必每次都发生变化。直接查询数据库很容易实现;加上缓存之后,请求会怎么走,数据更新后又会读到什么,就需要实际搭起来看了。
我用 20 万条模拟商品数据做了这个实验,没有接入真实商城。目标也定得比较小:在阿里云 ECS 上跑通接口,比较缓存前后的表现,再检查空缓存和数据更新这两个容易被忽略的情况。这样几个小时内就能完成,也能留下可以复现的代码和记录。
方案
实验使用一台杭州地域的 ECS,配置是 4 核 CPU、8 GiB 内存,系统为 Ubuntu 22.04。后端用 Python 标准库提供 HTTP 服务,SQLite 保存商品数据,Nginx 放在后端前面,负责转发请求和缓存响应。
选择这个组合,是因为它足够小,方便把每一层的作用看清楚。数据库负责统计,Python 把统计结果变成接口响应,Nginx 决定一个请求是否需要进入后端。ECS 提供统一的 Linux 环境,服务和测试程序都能在上面运行,执行过程则通过阿里云云助手保留记录。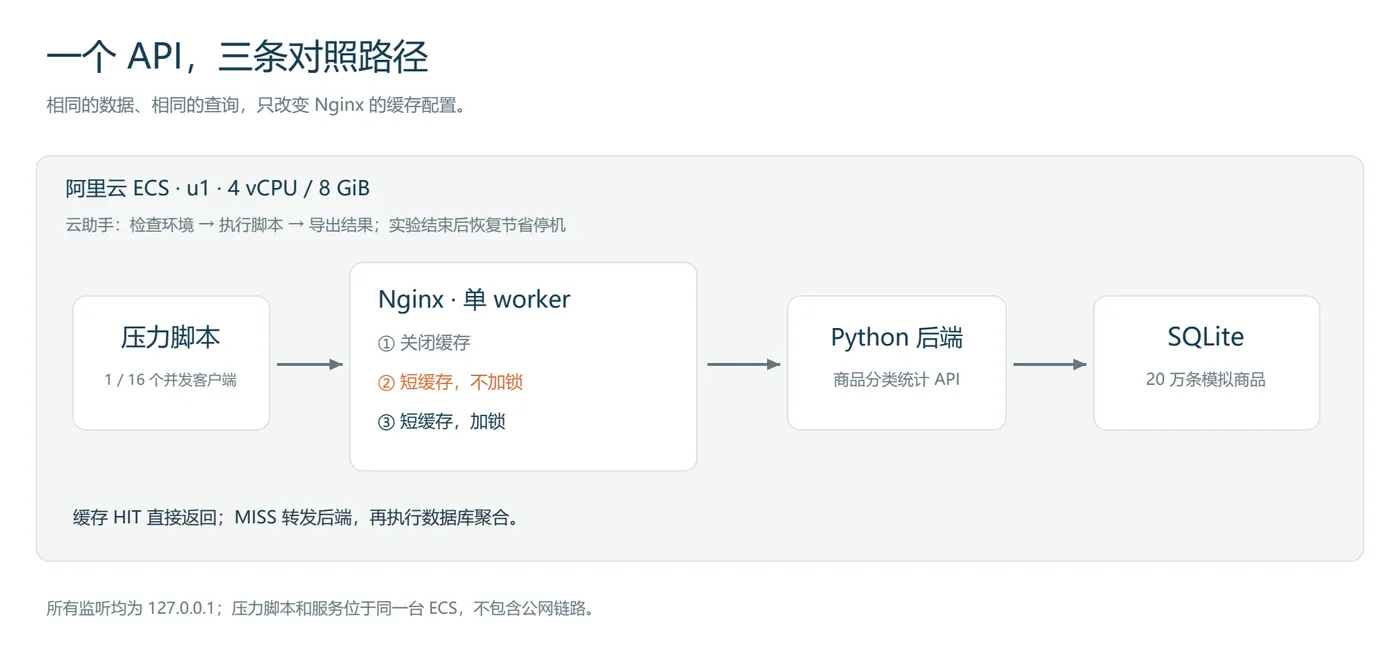
接口统计 20 个分类的商品数量、库存和价格,每个分类有 1 万条模拟记录。它返回的是公共汇总信息,所以我给缓存设置了 3 秒有效期,接受这类展示数据在短时间内略有延迟。
为了方便比较,我保留了三条访问路径:关闭缓存、开启缓存、开启缓存并加上缓存填充锁。三条路径连接同一个后端,执行同一条聚合查询。这样测出来的差异,才容易对应到缓存配置本身。
这里还有一个边界:实验只讨论公共汇总接口。带身份信息的请求需要绕过缓存,否则一个人的响应就可能被另一个人读到。这个条件从配置时就要考虑进去,不能等性能测完再补。
实现
我先通过云助手检查系统和运行环境,再从阿里云提供的 Ubuntu 软件源下载 Nginx 软件包,解包到单独的实验目录。这样可以把本次用到的程序、配置和日志放在一起,后面核对过程比较方便。
接着生成模拟商品表,启动 Python 后端。分类统计接口收到请求后,会执行一次分组聚合,返回 JSON。为了观察缓存有没有减少数据库工作,我在后端增加了计数:每真正执行一次聚合查询,计数就加一。仅看接口变快,还不足以判断请求是不是确实被缓存接住了。
Nginx 的三个入口都只监听本机回环地址,避免为了实验额外开放公网端口。配置写好后,我先执行配置检查,再用健康检查确认代理和后端都能访问,最后核对接口返回的数据。三条路径返回的内容一致,才开始测响应时间。
正式测试分别使用单并发和 16 并发,每种情况重复三轮。热缓存测试会先发送一次预热请求,这次请求不计入正式结果;测试程序对响应内容计算哈希,检查优化前后是否拿到了相同结果。后文主要展示 16 并发这一组,完整数据放在实验材料里。
测完热缓存,我又给每轮测试换一个新的缓存键,让 16 个请求同时访问还没有缓存的结果。这一步是想看看,服务刚启动或者缓存失效时,后端会不会一下收到很多相同查询。
最后检查数据更新和异常情况:修改一条模拟商品价格,观察缓存里的版本何时变化;用两个测试身份发送带 Authorization 的请求,检查是否绕过缓存;再让接口返回 503,确认错误响应没有成为后续请求的缓存结果。
这些步骤完成后,程序关闭实验服务,保存配置、访问日志和原始测量数据。我把结果取回本地核验,并将 ECS 恢复到节省停机状态。从准备环境到完成收尾,整个云端操作没有超过一小时。
结果
先看缓存已经存在时的情况。每轮发送 128 个请求,下表中的耗时取三轮统计值的中位数,后端聚合次数不包含预热请求。P50 表示一半请求的耗时不超过这个值,P95 则对应 95% 的请求。
| 16 并发下的访问方式 | 响应时间 P50 | 响应时间 P95 | 每轮后端聚合次数 |
|---|---|---|---|
| 关闭缓存 | 572.28 ms | 649.16 ms | 128 次 |
| 缓存已预热,开启缓存锁 | 1.60 ms | 4.54 ms | 0 次 |
这个结果比较容易解释:关闭缓存时,每个请求都要进入后端做一次聚合;缓存命中后,Nginx 可以直接返回已有响应,数据库就不用重复计算同一份统计了。改善来自减少重复工作,本次实验没有比较不同 ECS 机型的性能。
空缓存测试则让我看到另一面。不加缓存锁时,第一批 16 个请求触发了 16 次聚合;加锁后,同样一批请求只触发了 1 次。后端的重复工作确实少了,但等待中的请求仍然需要约半秒才拿到结果,并没有变成热缓存里的几毫秒。
这让我觉得,判断缓存有没有效果,至少要同时看两件事:平时命中时有多快,缓存失效时后端要承受多少重复查询。只保留第一张表,会漏掉服务刚启动时的体验。
数据更新的结果也符合这个思路。我把一条商品价格增加 100 分,后端数据版本随之变化。立即读取缓存入口时,拿到的还是旧版本;等待 4.2 秒后再次请求,缓存返回了新版本,内容与直接查询后端一致。第二次请求完成时,距离更新开始约 4.35 秒。
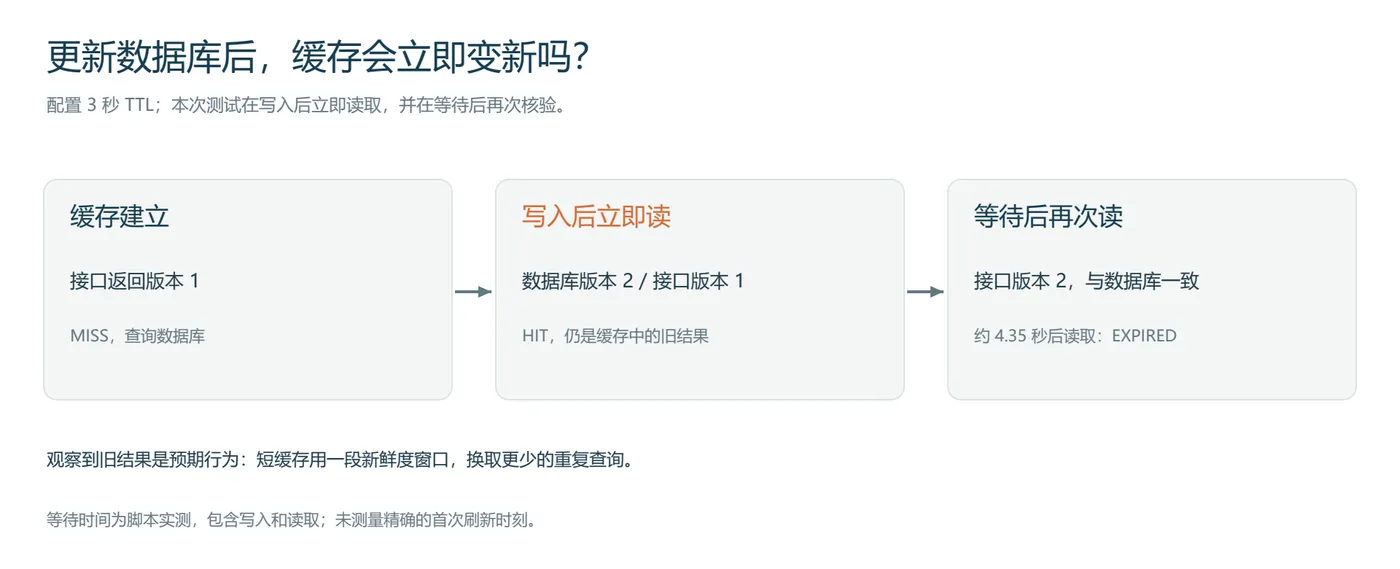
这次检查说明缓存会带来一个旧数据窗口。配置中的有效期是 3 秒,而实验只在两个时间点做了读取,不能据此说数据恰好在第几秒完成刷新。
另外,两个测试身份的请求都显示为 BYPASS,返回了各自对应的信息;连续三次 503 响应也都没有命中缓存。这些检查规模很小,但至少把“哪些响应可以缓存”这个条件落实到了实际请求上。
反思
做之前,我主要关心加缓存以后能快多少。做完以后,我更在意这个接口允许数据旧多久,以及缓存失效时会发生什么。公共分类统计可以接受几秒延迟,订单支付状态或实时库存就需要另外设计,不能直接照搬这份配置。
空缓存时的半秒等待也值得继续弄清楚。我查了 Nginx 1.18.0 的上游源码,发现缓存锁的等待处理使用定时器,检查间隔最多为 500 毫秒。这与测到的现象相符,但这次没有核对 Ubuntu 的版本补丁,也没有做源码插桩,所以只能把它作为解释线索。Nginx 1.18.0 缓存实现和缓存锁文档也帮助我理解了,减少回源次数和缩短每个请求的等待时间,是需要分别观察的。
这次实验还有明确的范围。压测程序与服务运行在同一台 ECS 上,走的是本机网络,测试持续时间也很短;Python 标准库服务适合这次学习验证,不能据此估算正式业务的承载能力。数据库查询本身也还有优化空间,索引、预聚合和换一种数据库都没有在本次实验中比较。
如果继续做,我会先把压测端移到另一台机器上,再观察更长时间内缓存反复过期的表现。至于这次留下的收获,是我终于把一次接口优化的过程串起来了:先明确数据能接受什么,再选择缓存方式,最后同时检查响应速度、后端工作量和返回内容。以后给接口加缓存时,我会先把这些问题写下来,再动配置。

