LangChain 到底是什么:从链式连接到 Agent 运行时,讲透 v1.0 的核心概念
摘要:大模型很强,但它不知道今天的新闻、打不开你的数据库、也记不住上一轮对话。LangChain 解决的就是这三件事。本文从 LangChain 的由来讲起,拆解 v1.0 之后的技术栈分层、六大核心概念、Agent 循环与中间件机制,给出 LangChain 与 LangGraph 的选型边界,并附一个可运行的最小 Agent 案例。
关键词:LangChain、LangGraph、Agent 智能体、RAG、中间件、LCEL、大模型应用开发、AI 工程化
一、先说清楚:LangChain 解决的不是"调用模型"
你有没有遇到过这种情况——花两天写完一个调用大模型的脚本,上线第一周就被业务方问住:
- "为什么它不知道我们上周发布的新产品?"——模型的知识截止在训练数据那一刻,之后的事它一概不知。
- "能不能让它直接去查一下订单库?"——模型只会输出文本,它没有任何手和脚去碰你的系统。
- "刚才聊到一半,刷新页面它怎么全忘了?"——模型调用本身是无状态的,每次请求都是一次全新的开始。
这三个问题,任何一个都不是"换个更大的模型"能解决的。它们属于工程问题,需要的是一套把模型、数据、工具和状态串起来的框架。
LangChain 就是干这个的。它不是一个模型 API 的封装层,而是一个由大语言模型驱动的应用程序开发框架:提供统一的模型抽象、预构建的 Agent 架构、工具集成机制和记忆管理,让你不用从零搭一套胶水代码。
名字很直白:Language(语言模型)+ Chain(链式连接)——把模型与计算资源、数据源以链式方式连起来。
二、四年演进:从 Chain 到 Agent 运行时
LangChain 由 Harrison Chase 于 2022 年 10 月创建并开源。早期它的核心抽象是 Chain(链):把提示模板、模型调用、输出解析串成一条流水线,这是"链式连接"最原始的含义。
真正的架构转折发生在 2024 年。随着大量项目从原型走向生产,开发者要的不再是"能跑通的流程",而是可控、可中断、可恢复、可观测的执行。LangChain 团队因此推出了 LangGraph 作为底层的编排与运行时框架,并把早期那些Chain 和 Agent 实现标记为弃用,转向基于 LangGraph 的统一 Agent 抽象。
2025 年 10 月,LangChain 1.0 与 LangGraph 1.0 同时 GA。官方在这次发布中明确承诺:在 2.0 之前不再引入破坏性变更。截至目前,LangChain 生态月下载量约 9000 万次,Uber、JP Morgan、BlackRock、Cisco、LinkedIn、Klarna 等公司在生产环境使用它。
这个承诺很重要。过去三年对 LangChain 最常见的批评是"抽象太重、API 变动太频繁",1.0 之后这条路线被彻底收紧:聚焦核心 Agent 循环,砍掉冗余表面积。
三、v1.0 之后的技术栈:五层分工看明白
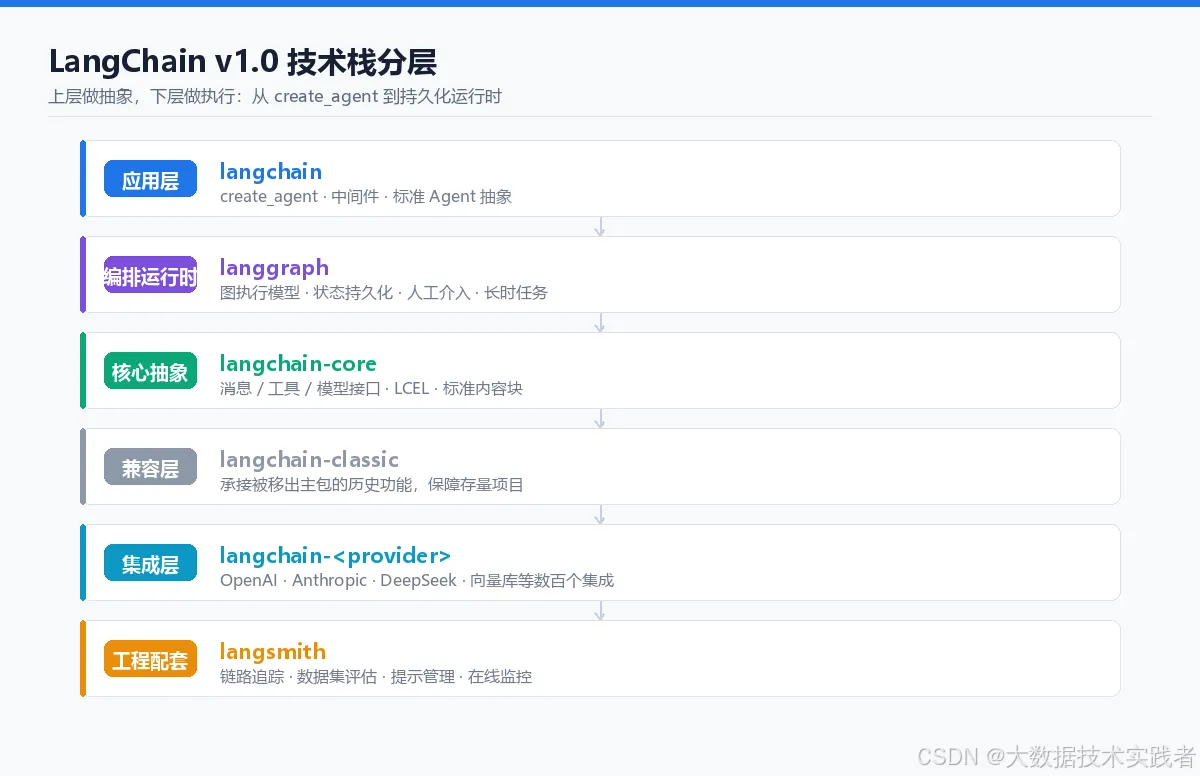
很多人学 LangChain 觉得乱,是因为没分清这几个包各自负责什么。v1.0 之后版图非常清晰:
| 层 | 组件 | 职责 |
|---|---|---|
| 应用层 | langchain |
create_agent、中间件、开箱即用的 Agent 抽象 |
| 编排运行时 | langgraph |
图执行模型、状态持久化、人工介入、长时任务 |
| 核心抽象 | langchain-core |
消息/工具/模型的基础接口、LCEL 表达式语言 |
| 兼容层 | langchain-classic |
承接被移出主包的历史功能 |
| 工程配套 | langsmith |
链路追踪、数据集评估、提示管理 |
| 集成层 | langchain-<provider> |
OpenAI、Anthropic、DeepSeek 等数百个模型与工具集成 |
一个关键变化:create_agent 取代了 create_react_agent,并且它底层就跑在 LangGraph 运行时上。这意味着你用高层 API 起步,需要精细控制时可以无缝下沉到 LangGraph,两条路线不是二选一,而是同一条路的不同坡度。
另一个容易被忽略的变化是 标准内容块(Standard Content Blocks)。不同厂商返回的推理过程、引用来源、工具调用片段格式各异,切换模型经常打断流式输出和前端渲染。v1.0 在消息对象上统一了 .content_blocks 属性,把推理轨迹、引用、服务端工具调用都纳入同一套类型化接口,同时保持向后兼容。
四、六个核心概念,拆开看
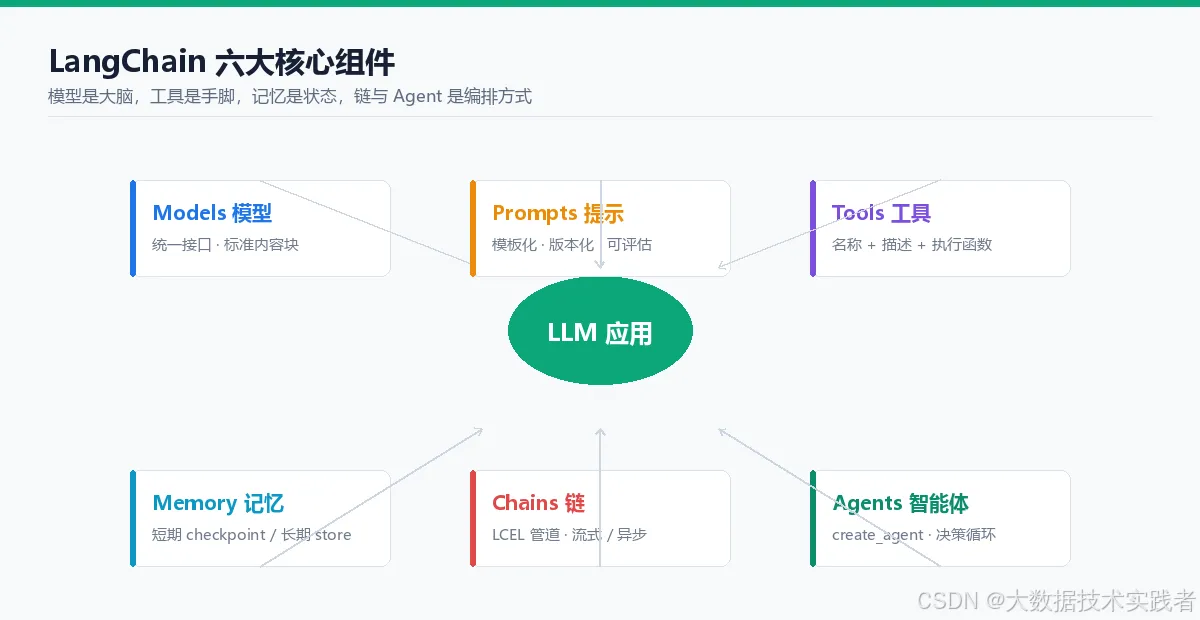
1. 统一的模型接口
OpenAI、Anthropic、DeepSeek、通义……每家都有自己的参数规范和响应格式。LangChain 用一层标准化抽象把这些差异吃掉,你可以用一行字符串指定模型:
from langchain.chat_models import init_chat_model

model = init_chat_model("openai:gpt-5")          # OpenAI
model = init_chat_model("anthropic:claude-3-5-sonnet-latest")
换模型不用重写业务代码。这在当下尤其重要——最适合某个任务的模型,每几个月就会变一次,把模型选型写死在代码里是一种技术负债。
2. 提示与消息(Prompts & Messages)
提示模板负责把变量注入成结构化提示,消息(System / Human / AI / Tool)则是模型输入输出的标准载体。工程上真正有价值的习惯是:把提示当成代码资产来管理,进版本库、进评估集,而不是散落在业务函数里的字符串拼接。
3. 工具(Tools)
工具是模型的手脚,一个标准工具包含三要素:名称、描述、执行函数。
其中描述的质量直接决定调用准确率。模型是根据描述来判断该不该调用、参数怎么填的。写一句"查询天气",它不知道要不要带城市;写"获取给定城市的当前天气,city 参数使用中文城市名",调用成功率会明显不同。这是很多人调 Agent 效果差却找不到原因的地方。
4. 智能体(Agent)
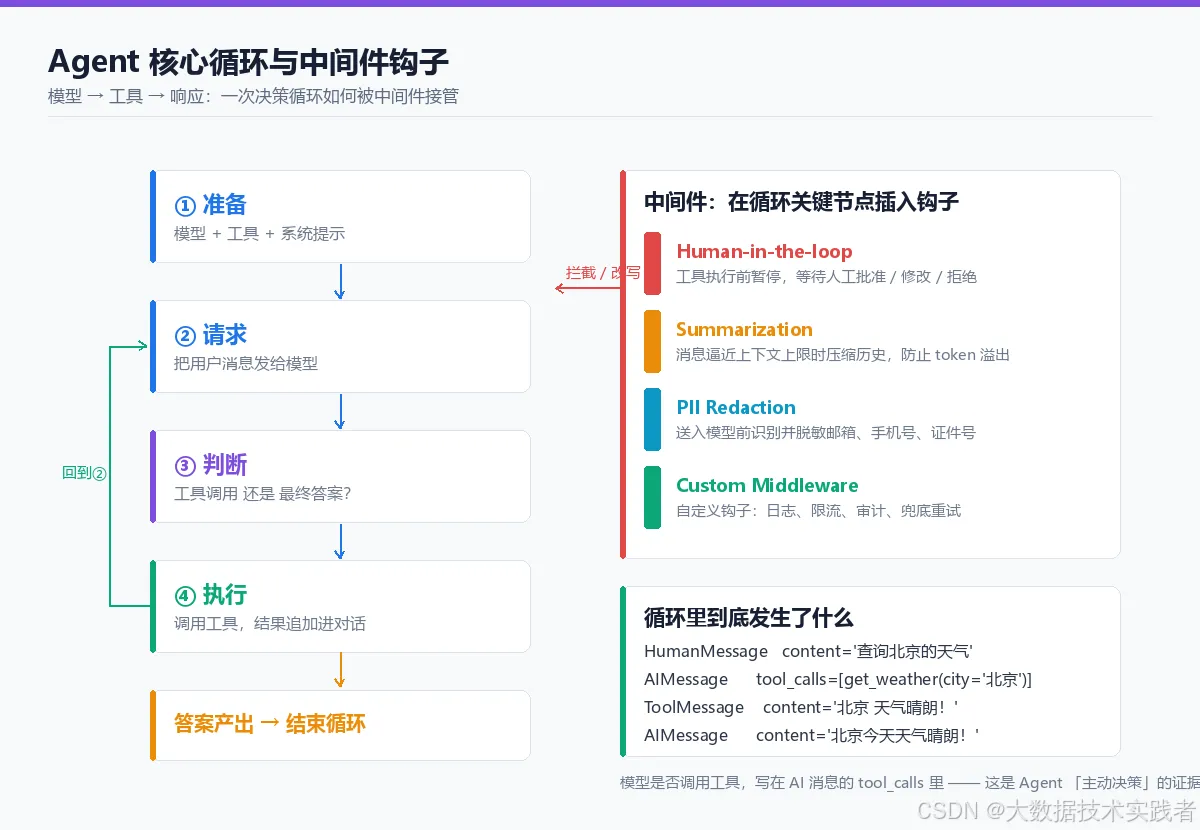
Agent 把模型从"被动的文本生成器"变成"能主动决策的执行者"。v1.0 的 create_agent 把这件事收敛成一个极其清晰的循环:
- 准备:选定模型,配好工具和系统提示;
- 请求:把用户消息发给模型;
- 判断:模型返回工具调用 → 执行工具、把结果追加进对话;或返回最终答案 → 结束;
- 回到第 2 步,直到产出答案。
5. 记忆(Memory)
无状态是纯 LLM 应用的先天缺陷。LangChain 的记忆分两层,对应两种完全不同的存储语义:
- 短期记忆:由 LangGraph 的 checkpointer 承载,作用域是单个会话线程。服务重启、长任务中断,状态自动恢复,用户不用从头再来。
- 长期记忆:跨会话持久化,用来记住用户偏好、历史结论这类长期有效的东西。客服场景需要它,一次性数据查询场景则不需要。
6. 中间件(Middleware)——v1.0 最重要的新增
这是 1.0 里最值得老用户关注的能力。中间件在 Agent 循环的关键节点上插入钩子,让你在不改写主循环的前提下精细控制每一步。官方内置了三类:
| 中间件 | 作用 | 典型场景 |
|---|---|---|
| Human-in-the-loop | 工具执行前暂停,等待人工批准、修改或拒绝 | 涉及外部系统写入、资金交易、对外发消息 |
| Summarization | 消息历史接近上下文上限时压缩旧内容,保留近期对话 | 长会话防 token 溢出 |
| PII Redaction | 在内容送入模型前识别并脱敏邮箱、手机号、证件号 | 隐私合规 |
此外还支持自定义中间件,可以介入循环的各个阶段。结构化输出也在这轮被并入主循环,不再额外多一次模型调用,延迟和成本都降下来了。
五、可组合性:LCEL 那根管道符
LangChain 表达式语言(LCEL)允许用管道操作符 | 把组件串成工作流:
chain = prompt | model | output_parser
这种声明式写法的价值不只是代码短。基于它构建的链路天然支持流式输出、异步调用和并行执行——这些能力是框架层面提供的,不需要你自己写线程池和异步调度。一个最简 RAG 流程,就是把检索器、提示模板、模型三个组件串起来:
rag_chain = {
   "context": retriever, "question": RunnablePassthrough()} | prompt | model | StrOutputParser()
六、LangChain 还是 LangGraph?别再纠结
这是被问得最多的问题,官方给出的边界其实很清楚:
| 维度 | LangChain 1.0 | LangGraph 1.0 |
|---|---|---|
| 定位 | 高层抽象,快速交付 | 底层运行时,精细控制 |
| 适用 | 标准 Agent 模式、默认循环够用 | 确定性流程与 Agent 混合、高度定制 |
| 长时任务 | 一般 | 持久状态、可跨天恢复 |
| 人工介入 | 通过中间件 | 一等公民能力 |
| 成本/延迟控制 | 常规 | 需要精细调控时 |
判断标准一句话:默认循环够用就用 LangChain,需要控制每一步就用 LangGraph。 而且由于 LangChain 的 Agent 本身就构建在 LangGraph 之上,你可以先用 create_agent 快速上线,等业务变复杂了再把其中的子图拆出来单独编排,图是可组合的,不用推倒重来。
七、四个高频落地场景
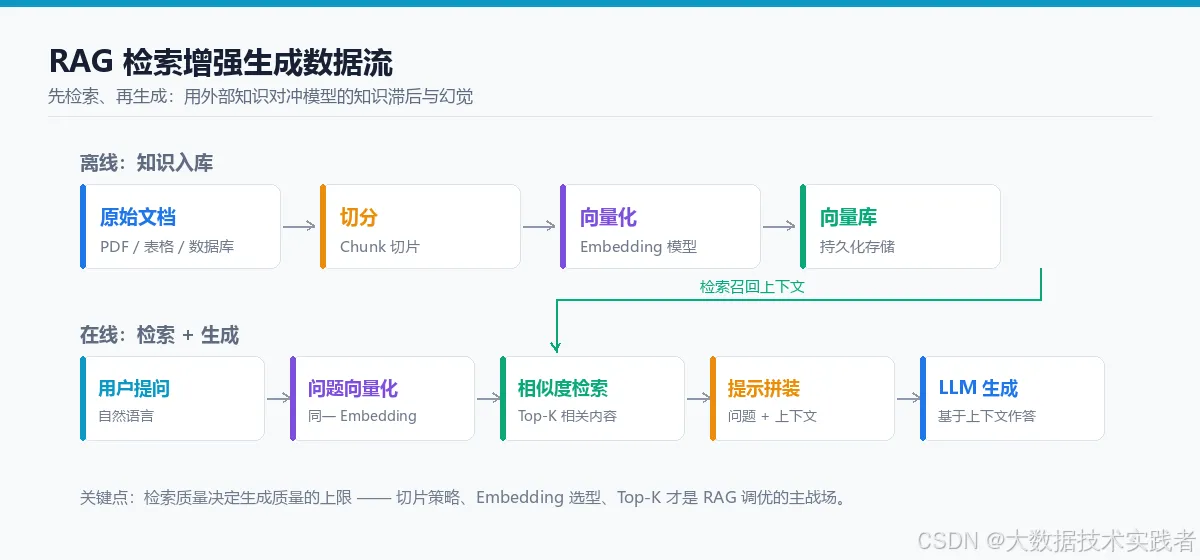
1. 检索增强生成(RAG)
最经典的场景,直接对冲知识滞后和幻觉:把文档、数据库切片向量化入库,提问时先检索再生成,让模型基于最新、最相关的数据作答。企业知识库问答几乎都是这个套路。
2. Agent 智能体
模型做推理引擎,自主规划并调用工具推进任务。比如市场调研 Agent:自动检索行业报告 → 抽取关键数据 → 生成简报。数据分析 Agent:把自然语言转成 SQL → 执行 → 解释结果。
3. 对话系统与客服机器人
靠记忆机制维持多轮连贯性,再叠加外部工具,就能从"通用聊天"升级为"能办业务":接订单库查物流、接知识库答售后、接工单系统建单。
4. 数据连接与结构化提取
从 PDF 合同里抽取甲乙方、金额、违约条款;从 Excel 里生成趋势分析;把自然语言翻译成 SQL。这类任务的共同点是输入输出都要有确定的结构,配合输出解析器和 Pydantic 模型就能稳定拿到结构化结果。
八、15 分钟跑通第一个 Agent
下面这套环境配置可直接复用。LangChain 1.x 要求 Python 3.10+(3.9 已于 2025 年 10 月 EOL),这里用 conda 管理环境:
# 创建独立环境
conda create --name langchain_v1.2 python=3.13.11
conda activate langchain_v1.2

# 安装依赖(langchain-deepseek 为 DeepSeek 模型适配包)
python -m pip install langchain==1.2.0 langchain-deepseek==1.0.1 dotenv==0.9.9 \
  -i https://pypi.tuna.tsinghua.edu.cn/simple
项目根目录建 .env,把密钥从代码里隔离出去:
DEEPSEEK_API_KEY=sk-xxxx
DEEPSEEK_BASE_URL=https://api.deepseek.com
env_utils.py 负责加载配置:
import os
from dotenv import load_dotenv

load_dotenv(override=True)   # override=True 确保 .env 优先

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
my_llm.py 统一创建模型实例,后续所有 Agent 共用:
from langchain_deepseek import ChatDeepSeek
from env_utils import DEEPSEEK_API_KEY, DEEPSEEK_BASE_URL

deepseek_llm = ChatDeepSeek(
    api_key=DEEPSEEK_API_KEY,
    api_base=DEEPSEEK_BASE_URL,
    model="deepseek-chat",
)
主程序 quick_start.py,一个会查天气的 Agent:
from langchain.agents import create_agent
from my_llm import deepseek_llm


def get_weather(city: str) -> str:
    """获取给定城市的天气。"""
    return f"{city} 天气晴朗!"


agent = create_agent(
    model=deepseek_llm,
    tools=[get_weather],
    system_prompt="你是一个助手,你可以查询城市的天气。",
)

resp = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "查询北京的天气"}]}
)
print(resp)
跑完你会拿到一个 messages 列表,正好可以把 Agent 循环看个通透:
HumanMessage  content='查询北京的天气'
AIMessage     content='我来帮您查询北京的天气。'
              tool_calls=[{'name': 'get_weather', 'args': {'city': '北京'}}]
ToolMessage   content='北京 天气晴朗!'   name='get_weather'
AIMessage     content='根据查询结果,北京今天的天气是晴朗的!'
四步就是一次完整的 Agent 循环:用户提问 → 模型决定调工具 → 工具返回结果 → 模型综合出答案。注意 AI 消息里的 tool_calls 字段,那是模型"主动决策"的证据;把它换成真实的 HTTP 天气接口,这个 Demo 就变成了能用的服务。
九、给 Java / 大数据工程师的三条建议
第一,用你已经熟悉的概念去映射。
LangChain 的 create_agent 之于 LangGraph,就像 SQL 之于执行引擎——前者描述"要什么",后者负责"怎么跑"。LangGraph 的持久化和 checkpoint 机制,和 Flink 的 state backend + checkpoint 是同一种工程思路:把执行状态外置,让长任务可中断、可恢复。想通这一点,LangGraph 的学习曲线会陡降。
第二,别急着把 Agent 塞进主链路。
Java 技术栈团队可以先把它当作独立的 Agent 服务,通过 HTTP 暴露能力,主系统按调用普通微服务的方式接入。这样既隔离了 Python 运行时,也保留了随时替换实现的余地。如果团队确实想用 Java 写,社区维护的 LangChain4j 提供了 Java 侧的对应抽象,可以作为备选评估。
第三,把可观测性和评估放在功能之前。
Agent 的输出是概率性的,没有 trace 就没有调试,没有评估集就没有重构依据。上线前先把 LangSmith 的链路追踪接上,再准备几十条覆盖边界情况的测试用例——这一步省不掉,越晚补代价越大。
十、小结
回到开头那三个问题,LangChain 给出的答案分别是:
- 知识截止 → RAG,把外部知识检索进来再生成;
- 碰不到外部系统 → Tools + Agent,给模型装上可执行的工具;
- 记不住上下文 → Memory,短期靠 checkpoint、长期靠 store。
至于 v1.0 的意义,可以概括成一句话:它不再试图做所有事,而是把"构建一个可靠的 Agent"这件事做扎实了——统一模型接口、收敛 Agent 循环、用中间件开放控制权、用 LangGraph 保证持久化执行。
如果你的项目还停在"调 API + 拼提示词"的阶段,现在是从原型走向生产的合适时机。建议的下一步:先用 create_agent 跑通一个带真实工具的最小闭环,再逐步叠加中间件、持久化和评估。
本文基于 LangChain 官方文档与 1.0 发布说明整理,配套代码在 Python 3.13 + langchain 1.2.0 环境下验证通过。
它不再试图做所有事,而是把"构建一个可靠的 Agent"这件事做扎实了——统一模型接口、收敛 Agent 循环、用中间件开放控制权、用 LangGraph 保证持久化执行。
如果你的项目还停在"调 API + 拼提示词"的阶段,现在是从原型走向生产的合适时机。建议的下一步:先用 create_agent 跑通一个带真实工具的最小闭环,再逐步叠加中间件、持久化和评估。
本文基于 LangChain 官方文档与 1.0 发布说明整理,配套代码在 Python 3.13 + langchain 1.2.0 环境下验证通过。