线性代数和空间变换,解决的是“已知一个三维点,怎么把它在坐标系之间搬来搬去”的问题。但AR要做的事情比这更狠:给你一张照片上的一个像素,让你反推它在三维世界里到底在哪。
这个“反推”的过程,就是相机模型和多视图几何要处理的事。相机把三维世界“压”成二维图像,这个“压”的动作有精确的数学模型;而多视图几何则告诉你,当你有不止一张照片时,怎么利用它们之间的几何关系,把被压扁的信息重新“撑”回三维。
本文不聊任何具体框架的API,只聊这套几何背后的逻辑。理解了它,再看SLAM或VPS的代码,每一行都是在解本文里的某个方程。
一、相机是怎么“拍”的:针孔模型的数学拆解
1.1 从三维到二维的“降维打击”
相机成像的本质是一个投影过程:三维空间中的一个点,沿着一条光线穿过镜头中心,落在图像传感器上。用一个理想化的模型来描述,就是针孔相机模型。
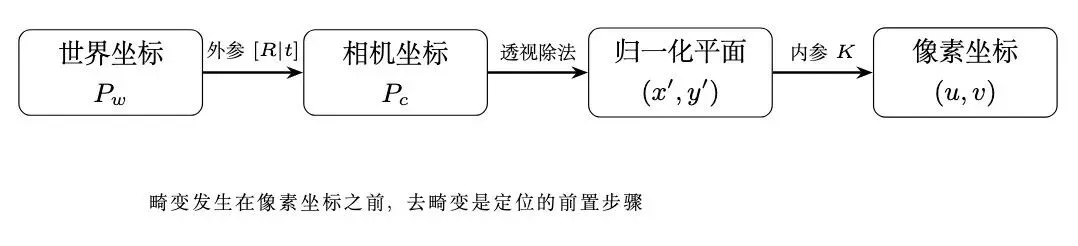
针孔模型做的事情可以用一句话概括:把三维点沿着它到光心的连线,投影到图像平面上。 数学上,这个过程可以拆成两步。第一步,用上一篇讲的变换矩阵把世界坐标系下的三维点 Pw 搬到相机坐标系下:Pc = [R|t] · Pw。第二步,把相机坐标系下的 Pc = (Xc, Yc, Zc) 投影到图像平面。根据相似三角形,图像平面上的坐标是 (Xc/Zc, Yc/Zc)——这一步“除以深度”的操作,就是投影的数学本质。深度 Zc 被除掉了,三维的信息在这里被“压”成了二维。
1.2 内参:相机自己的“体质”
投影到图像平面之后,还需要把物理坐标换算成像素坐标。这个换算关系由相机的内参矩阵 K 来描述:
K = [ fx   0   cx ]
    [  0  fy   cy ]
    [  0   0    1 ]
其中 fx、fy 是焦距(以像素为单位),cx、cy 是主点(光轴与图像平面的交点)的像素坐标。内参矩阵只跟相机本身的硬件有关——换了相机就要重新标定,但同一台相机只要焦距不变,标定一次就可以反复用。
把内参和投影拼在一起,完整的投影公式就是:
s · [u, v, 1]ᵀ = K · [R|t] · [Xw, Yw, Zw, 1]ᵀ
这里的 s 是尺度因子,本质上就是投影前的深度 Zc。这个公式是整个多视图几何的起点——它定义了一个从三维世界到二维像素的映射,而AR定位要做的,就是已知 K 和 (u,v),去反推 (R,t) 。
1.3 归一化平面:去掉内参的“标准空间”
公式里的内参 K 有时候会让推导变得啰嗦。一个常用的技巧是把像素坐标乘上 K⁻¹,转换到归一化平面上:
[x', y', 1]ᵀ = K⁻¹ · [u, v, 1]ᵀ
归一化平面上的坐标 (x', y') 就是 (Xc/Zc, Yc/Zc)——它跟相机的内参无关,只跟三维点在相机坐标系下的方向有关。后面讲对极几何和PnP的时候,很多推导在归一化平面上会干净得多。
1.4 现实中的不完美:畸变
针孔模型是理想化的,真实镜头会有畸变。最主要的是径向畸变——图像边缘的点会比理论位置更“往外跑”(桶形畸变)或更“往里收”(枕形畸变)。数学上用多项式来建模:
x_distorted = x · (1 + k₁r² + k₂r⁴ + k₃r⁶)
其中 r 是点到图像中心的距离,k₁、k₂、k₃ 是径向畸变系数。
还有切向畸变,由镜头和传感器不完全平行引起,用 p₁、p₂ 两个参数描述。在AR定位的流程里,一个标准的前置步骤是先用标定好的畸变参数把图像“去畸变”,让像素坐标回到理想针孔模型的框架下,然后再做后续的几何计算。这一步不做,定位精度会在图像边缘明显下降。
二、两张照片之间的“隐形契约”:对极几何
2.1 单张照片的深度歧义
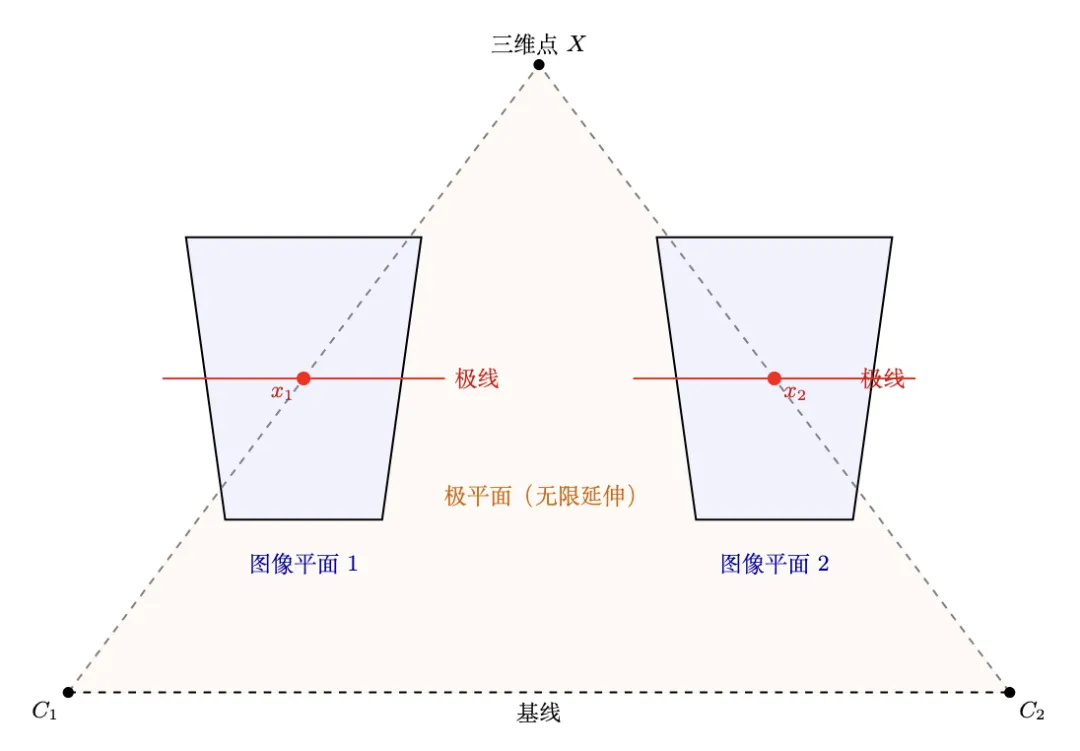
给你一张照片上的一个像素,它对应三维空间中的哪个点?答案是:无法确定。这个像素对应的是从相机光心出发的一条射线,射线上任何一个点投影到图像上都会落在同一个像素位置。深度信息在投影过程中被丢掉了。
这就是单目视觉的根本困难。但如果你有第二张照片,并且知道同一个物理点在两张照片里分别落在哪个像素上,那么两条射线的交点就唯一确定了这个三维点的位置。对极几何描述的就是:在不知道三维点具体位置的情况下,两张照片之间必须满足什么约束。
2.2 本质矩阵与基础矩阵
设空间中一个三维点在两个相机坐标系下的归一化坐标分别是 x1 和 x2,两个相机之间的相对旋转和平移是 R 和 t。可以证明,这两个坐标必须满足一个极其简洁的约束:
x2ᵀ · E · x1 = 0, 其中 E = t× · R
这个 E 就是本质矩阵。它把两个相机之间的几何关系“压缩”进了一个3×3的矩阵。t× 表示平移向量 t 对应的反对称矩阵,t× · R 这个组合的几何含义是:平移方向与旋转后坐标的叉积,正好描述了那条“极线”的方向。
如果用的不是归一化坐标而是像素坐标 p1、p2,那么约束变成:
p2ᵀ · F · p1 = 0, 其中 F = K⁻ᵀ · E · K⁻¹
F 叫基础矩阵。它跟本质矩阵的关系就是内参矩阵的“三明治”——把内参从两边“夹”进去,把归一化坐标下的约束翻译成像素坐标下的约束。基础矩阵的好处是它不需要知道相机的内参,直接从像素坐标就能估计。
2.3 八点法:从匹配点解出矩阵
本质矩阵和基础矩阵都是3×3的矩阵,各有9个元素,但尺度不确定(乘一个常数等式仍然成立),所以实际自由度是8。这意味着理论上8对匹配点就足以解出这个矩阵。
把 p2ᵀ · F · p1 = 0 展开,每一项都是 F 的9个元素的一次组合。8对匹配点给出8个方程,构成一个齐次线性方程组 W · f = 0,其中 W 是由匹配点坐标构成的8×9矩阵,f 是 F 的9个元素排成的列向量。这个方程组的解就是 W 的零空间——通过对 W 做奇异值分解(SVD),取最小奇异值对应的右奇异向量,就是 F 的估计值。
但这里有个细节:基础矩阵的秩必须是2(因为它本质上是一个叉积矩阵和内参矩阵的乘积,叉积矩阵的秩是2)。SVD估出来的 F 通常秩是3,所以还要再做一次“秩2投影”:把 F 再做一次SVD,把最小的奇异值置零,然后重组回去。
直接对像素坐标跑八点法,数值稳定性很差——像素坐标的数值范围可能从几百到几千,矩阵 W 的条件数会变得很糟糕。所以实际用的是归一化八点法:先把像素坐标平移到原点附近、缩放到单位尺度,在这个“干净”的坐标系里解出 F,最后再反归一化回来。
2.4 从本质矩阵到相机位姿:四组解与正深度
解出本质矩阵 E 之后,可以对它做SVD分解,从中提取出旋转 R 和平移 t。但数学上,这个分解会给出四组可能的解——因为 E 和 -E 满足同一个约束,而平移的方向也有正负两种可能。
四组解里哪一组是真实的?靠正深度约束来筛选:三维点必须位于两个相机的前方(深度为正)。对四组解分别做三角测量,哪一组能让所有匹配点的深度都为正,哪一组就是真实解。通常只有一组能满足这个物理约束,另外三组会被排除。
三、三角测量:把像素“还原”成空间点
3.1 两条射线求交点
知道了两个相机的位姿(从本质矩阵分解得到),就可以反过来算匹配点的三维坐标了。原理很直观:每个像素对应一条从光心出发的射线,两条射线的交点就是三维点的位置。
但真实数据里,两条射线通常不会精确相交——像素有噪声,位姿估计有误差。所以三角测量变成一个优化问题:找空间中到两条射线距离之和最小的那个点。
3.2 线性三角化:DLT的思路
直接线性变换(DLT)提供了一种优雅的线性化方案。对于相机1,投影关系是 s1 · x1 = P1 · X;对于相机2,是 s2 · x2 = P2 · X。利用叉积的性质,可以把 x1 × (P1 · X) = 0 展开成关于 X 的线性方程。两个相机各给出两个独立方程,合起来构成一个形如 A · X = 0 的齐次线性系统,用SVD取最小奇异值对应的向量即可求解。
DLT的优点是线性、直接、不需要迭代。但它最小化的是“代数误差”,而不是“几何误差”——在噪声较大的时候,代数误差和重投影误差的偏差会变大。所以DLT通常作为初始解,后面再用非线性优化做精化。
四、PnP:已知地图,反推自己的位置
4.1 问题定义
对极几何和三角测量解决的是“两张照片之间互相配合”的问题,前提是两张照片的位姿都不知道。但VPS的典型场景不同:云端已经有一张预先建好的三维地图,相机拍了一张照片,在里面找到了一些特征点,并且知道它们对应的三维地图点。问题变成:已知一组3D-2D对应关系,求相机的位姿 (R,t) 。
这就是PnP(Perspective-n-Point)问题。它是VPS定位最核心的一步——对极几何帮你找到两张图之间的关系,PnP帮你把当前图和已有地图对齐。
4.2 P3P:最小解与RANSAC
PnP的最小情况是P3P:用3对3D-2D点,可以解出有限个(最多4个)可能的位姿。P3P的几何直觉是:3个三维点和相机光心构成一个四面体,已知3条边的长度(3D点之间的距离)和3个角度(相机到3个点的方向),可以解出光心到每个点的距离,从而确定位姿。
P3P本身对噪声非常敏感——3个点里有一个是误匹配,解就废了。所以实际中P3P总是和RANSAC配合使用:随机选3对点做P3P,然后用这个位姿去检验所有其他点对,统计有多少点对的重投影误差在阈值以内(内点);重复若干次,内点最多的那组位姿就是最终解。
4.3 重投影误差:优化目标
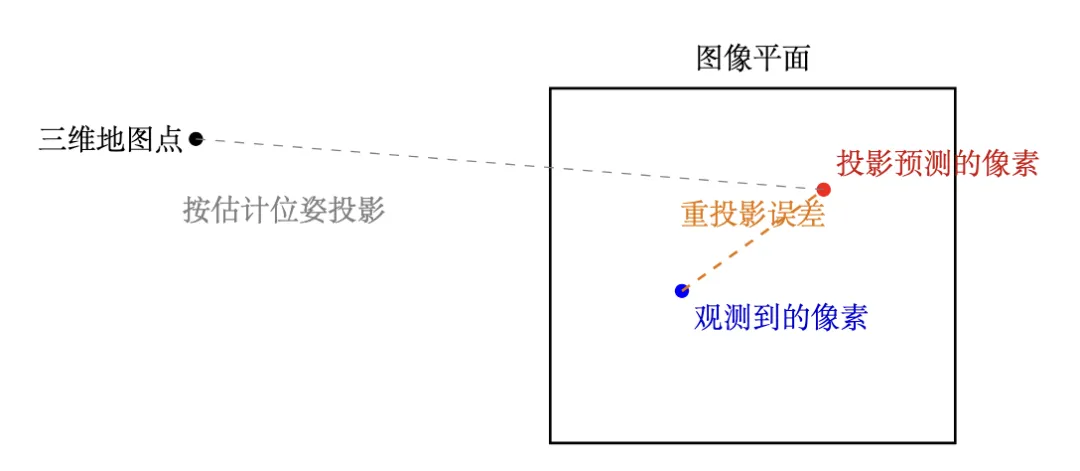
P3P给的是“最小配置”下的解析解,用点少、精度有限。更稳妥的做法是用多于最小数量的点对,把位姿求解变成一个优化问题:找到 (R,t),使得所有三维点投影到图像上的位置,和实际观测到的像素位置之间的差异总和最小。这个差异就是重投影误差,它是整个多视图几何里最重要的误差度量。
用文字表达就是:重投影误差 = Σ ‖观测像素 − 投影预测像素‖²。它的物理含义很直接:如果你估计的位姿是准的,那么把三维地图点用这个位姿投影到图像上,应该跟照片上看到的特征点位置重合。不重合的部分,就是估计的误差。
五、鲁棒估计:当数据里有“坏人”
5.1 特征匹配从来不干净
上面所有的推导都假设匹配点是正确的。但现实是,特征匹配几乎不可能100%正确——重复纹理、光照变化、视角差异,都会产生误匹配。一个误匹配点对重投影误差的贡献可能是正确匹配点的几十倍甚至几百倍,如果不做处理,优化结果会被几个“坏人”彻底带偏。
5.2 RANSAC的工作方式
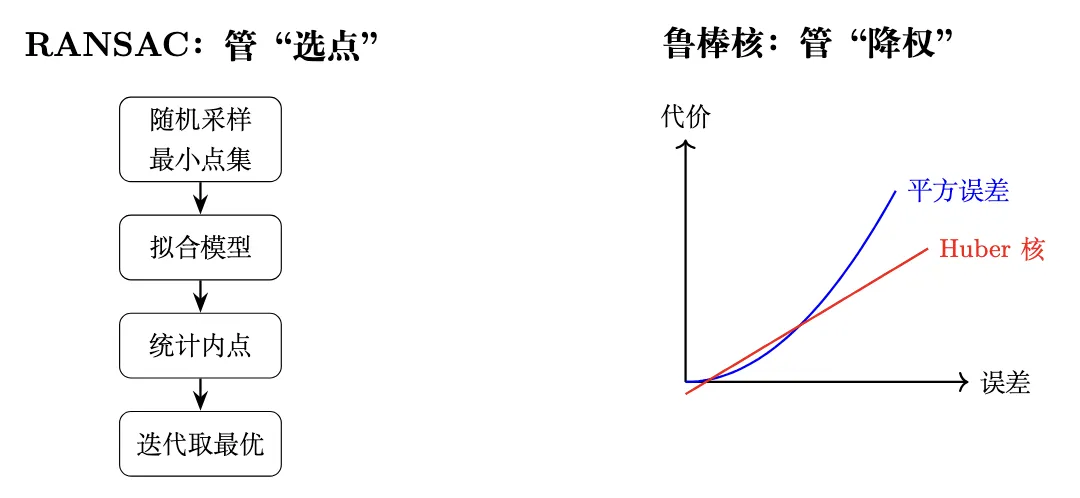
RANSAC是处理误匹配的标准框架。它的逻辑是:随机抽样最小点集,拟合模型,用模型去检验全部数据,统计内点数量,重复足够多次,选内点最多的模型。
在PnP里,最小点集是3对点(P3P),重复次数取决于期望的内点比例——内点比例越低,需要的重复次数越多。RANSAC的优点是它不要求预先知道哪些点是错的,只要内点比例不太低(通常50%以上),就能以高概率找到正确的模型。
5.3 鲁棒核函数:给异常值“降权”
RANSAC解决的是“选哪些点参与估计”的问题。在优化阶段,还有另一种处理异常值的方式:鲁棒核函数。标准的最小二乘对每个误差项一视同仁地做平方惩罚,异常值的大误差会被平方放大,主导整个优化。鲁棒核函数(如Huber、Cauchy)的思路是:误差小的时候正常惩罚,误差大到一定程度后,惩罚的增长变缓甚至停止。这样异常值就不会在总代价中占据支配地位,优化器会更“听”内点的话。
这套思路在以后讲Bundle Adjustment的时候还会详细展开,但它的基本直觉在这里就出现了:真实数据总是有噪声和错误,几何模型必须学会在“不干净”的数据里找到最合理的解释。
六、这些几何在AR里到底在做什么
回到AR本身。这套多视图几何的链条,在AR定位系统里是这样串联起来的:
初始化阶段:用对极几何(八点法+本质矩阵分解)从两张或多张图像中估计出相机之间的相对位姿,同时用三角测量恢复出一批三维点的位置。这是SLAM/VPS“从零开始认识环境”的第一步。
定位阶段:已知三维地图,用PnP(P3P+RANSAC+重投影误差优化)求解当前相机的绝对位姿。这是VPS“在已知环境里找到自己”的核心步骤。
鲁棒性保障:特征匹配的错误、光照和视角的变化,都靠RANSAC和鲁棒核函数在估计层面做过滤和降权。几何模型不是“精确解方程”,而是“在不完美数据里找最合理的近似”。
这套几何不直接出现在用户界面里,但AR系统每一帧的定位精度和稳定性,都取决于这些方程解得对不对。
七、小结
针孔模型用“透视除法”把三维压成二维,内参和外参描述了这个投影的完整链条;对极几何用本质矩阵和基础矩阵描述了两视图之间必须满足的约束,八点法从匹配点中解出这个约束;三角测量用两条射线的交点恢复深度;PnP用3D-2D对应关系反推相机位姿;RANSAC和鲁棒核函数则在“不干净”的数据里保障估计的可靠性。
这些工具各自解决一个特定的几何问题,但它们组合在一起,构成了AR视觉定位的完整几何引擎。
参考链接
OpenCV: Camera Calibration and 3D Reconstruction
http://vision.stanford.edu/teaching/cs231a_autumn1213/lecture/lecture10_multi_view_cs231a.pdf