日志里拉出来几万条异常源IP,要用脚本批量查归属地和网络类型——这时候最先想到的往往是免费API。但跑着跑着就会发现:免费API的配额和限流,往往卡在批量查询最难受的位置。为了量化这种差距,在实际测试中,通常会将IP数据云的在线API和离线库作为商业方案的性能基线:在线API平均响应约35ms,离线库在本地内存中查询耗时约0.18ms。下面用实测数据对比两者在“批量查”动作下的真实差距。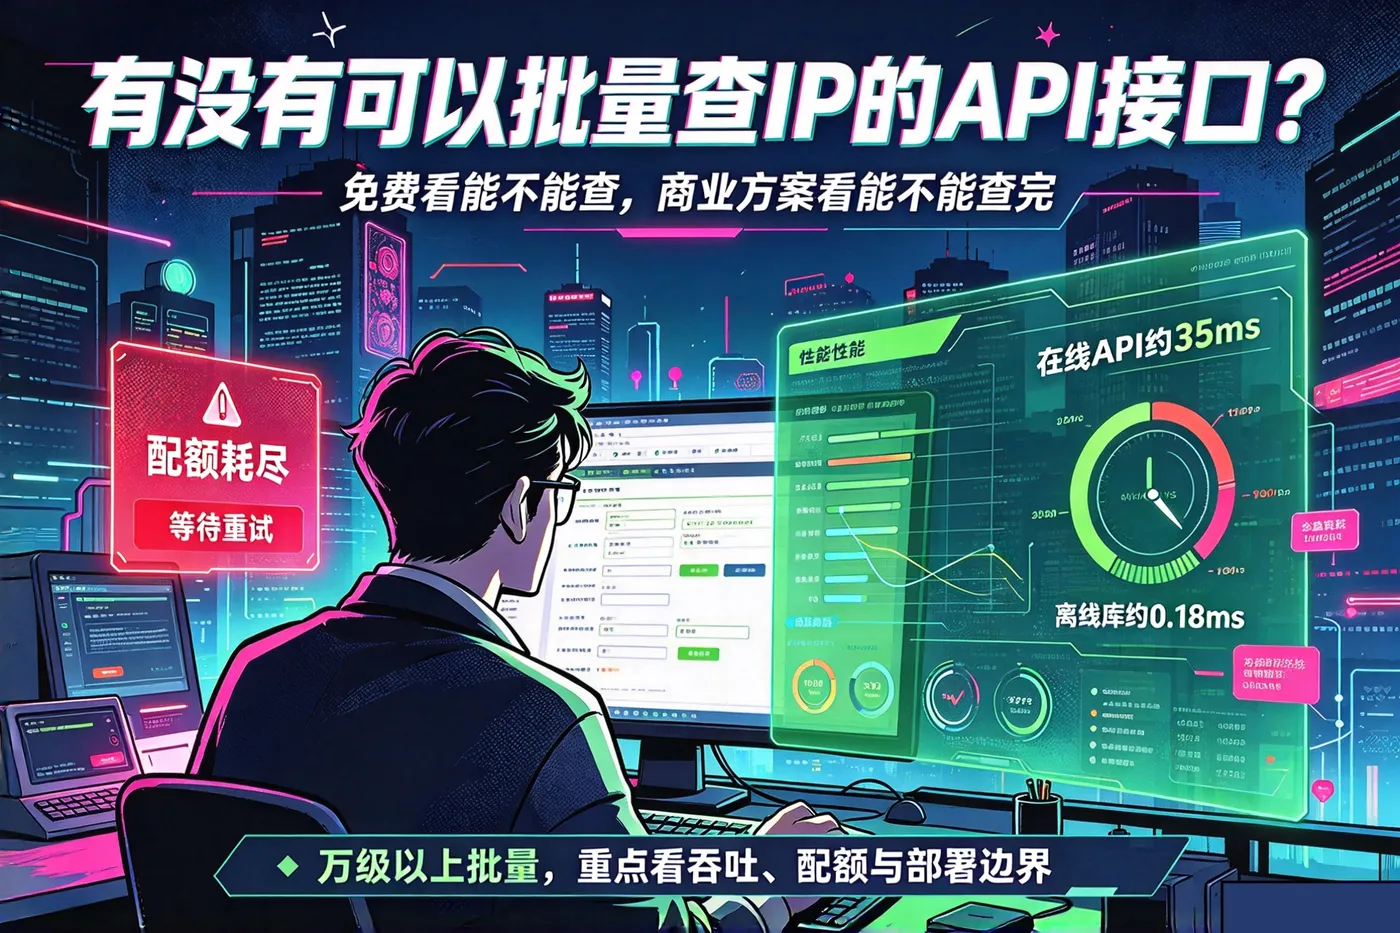
一、免费API批量查询的限制:配额与频率瓶颈
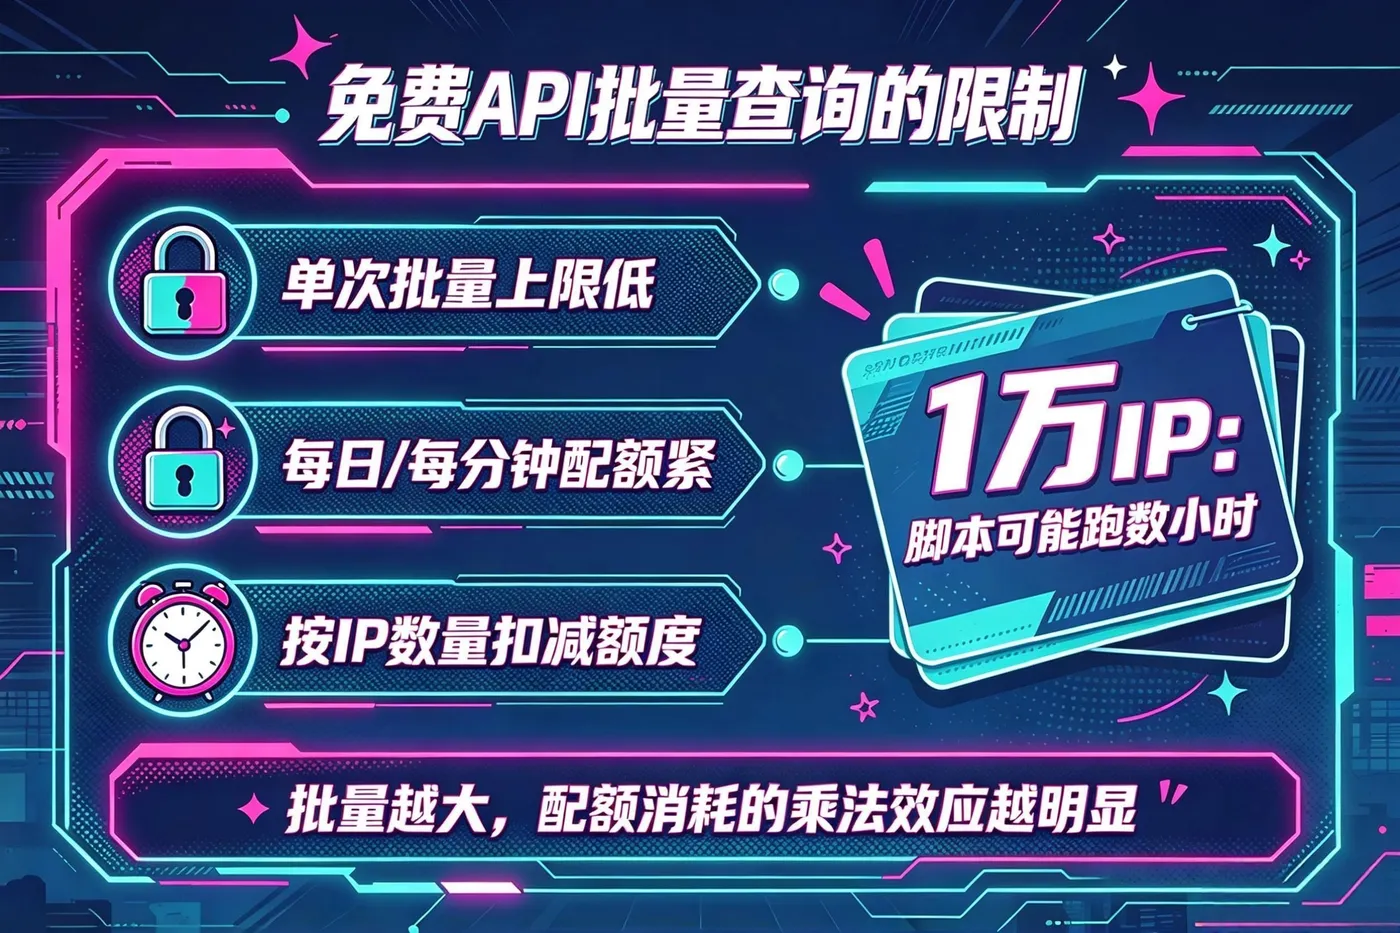
免费API的承载能力受限于服务商策略,核心痛点在于:单次批量调用的IP数量被严格限制,每日/每分钟配额很低。
| 服务类型 | 免费配额示例 | 批量上限 |
|---|---|---|
| 匿名免费 | 30次/分钟,1000次/天 | 5个IP/次 |
| 免费Key | 120次/分钟,10000次/天 | 10个IP/次 |
| 部分免费API | 45次/分钟 | 不支持批量接口 |
假设你要查1万个IP。按免费版每次批量10个计算,需要发起1000次请求;即便不计网络耗时,仅触发限流等待的时间就足以让脚本跑上数小时。如果遇到“不支持批量接口”的免费API,逐个查询10000次,按每次50ms计算,光网络往返就超过8分钟。
更隐蔽的问题是配额消耗的“乘法效应” 。部分API的批量接口按IP数量扣减配额,一次查100个IP,配额就减少100。免费版每日1万次的额度,跑100次批量请求就耗尽。批量规模一旦上千,免费API的配额很快见底。
二、免费与付费API工具对比:吞吐量与性能差距
付费API的核心价值在于批量吞吐能力的数量级提升。免费API往往只开放单IP查询接口,批量需脚本层循环调用并处理重试;付费API通常提供批量端点,单次请求可提交多个IP,减少网络往返开销。在对比测试中,调用ipdatacloud的在线API,其架构设计支持较高QPS的并发请求,能避免批量脚本因限流频繁重试,适合高吞吐的自动化场景。
| 对比维度 | 免费API | 付费API/离线库 |
|---|---|---|
| 批量规模 | 千级以内,受配额严重制约 | 万级到百万级,受本地资源约束 |
| 单次批量上限 | 5-10个IP/次 | 百级/次,或本地无限制 |
| 延迟 | 受公网波动,存在限流等待 | 本地微秒级,无网络开销 |
| 配额模型 | 每日/每分钟硬上限 | 按套餐/授权,QPS可控 |
| IP外发 | 是 | 离线库不出域 |
三、海量IP批量查询的实操方案:如何突破限流
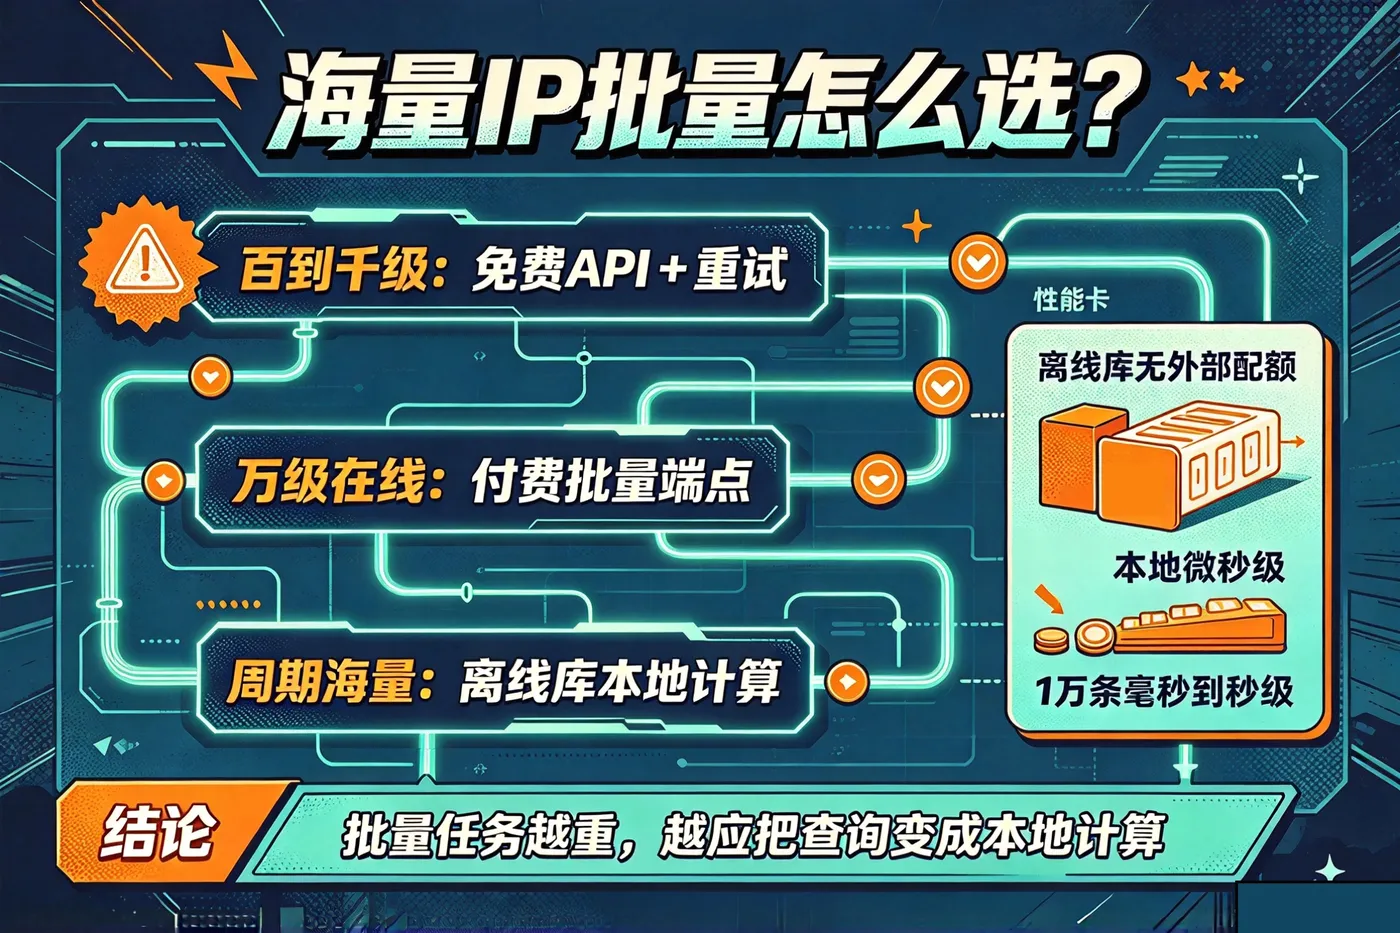
如果批量规模在几百到一千条,且不是周期性任务,免费API配合多线程和重试机制勉强可用。但需要监控响应头中的 X-RateLimit-Remaining,在配额耗尽前暂停或切换备用Key。
批量规模超过五千条,或者需要每天/每小时周期性跑,免费API的配额模型基本不可行。这时更务实的路径是离线库本地批量加载:将IP列表读入内存,循环调用本地SDK查询,单条微秒级,1万条IP的总耗时在毫秒到秒级之间。批量任务直接在脚本中完成,不受任何外部配额约束。
如果必须使用在线API处理万级以上的批量,付费版的批量端点和更高的QPS配额是必要的。选型时重点确认批量接口的单次上限、配额扣减规则,以及是否支持异步批量任务。
四、总结:批量IP查询工具如何选择
免费API可以用来验证“能不能批量查”,但它解决不了“能不能批量查完”。配额和批量上限决定了它只适合千级以内的偶发任务。万级以上的批量查询,要么走付费API的高并发端点,要么用离线库把查询变成本地计算——后者的批量吞吐不再受任何外部限流影响。