前言
做后端开发时,日志几乎每天都要打交道。
服务运行正常时,日志安静地躺在磁盘里;一旦出现接口超时、请求失败或者业务异常,排查问题的第一步往往就是翻日志。
刚开始,几条 grep、awk 命令就能解决大部分问题。随着业务运行时间增长,日志逐渐积累到几十万、几百万条,想统计某一天的错误请求、比较不同服务的响应时间,处理起来就有些麻烦了。
尤其是一些小型项目,平时只需要每天生成一次统计结果,偶尔回查某个时间段的数据。为这样的需求准备一套长期运行的日志分析集群,运维和资源成本都比较高。
最近关注阿里云 ECS 的 AMD 实例规格时,我想到一个比较适合这类场景的方案:用 ECS 承担批量计算,DuckDB 执行 SQL 分析,Parquet 保存整理后的数据,再通过 OSS 完成归档。
整个方案只需要一台云服务器,组件数量少,部署过程也比较直接。
下面以 200 万条模拟 HTTP 访问日志为例,从环境搭建开始,完整实现日志生成、格式转换、错误统计和云端归档。
一、先把方案理清楚
这次要实现的是一个简单的日志分析工具。
原始日志采用 JSON Lines(JSONL)格式,每行记录一次 HTTP 请求,包含请求时间、服务名称、状态码、响应耗时以及链路追踪 ID。
分析时主要关注三个问题:
- 某一天各个服务分别处理了多少请求?
- 哪些服务出现了较多的 5xx 错误?
- 各服务的平均请求耗时是多少?
这些指标可以帮助开发人员快速判断服务的运行状态,也适合作为每天的基础运维报表。
整个处理过程分为三个环节。
首先,业务日志进入 ECS 的本地工作目录,同时将原始文件上传至 OSS 保存。
接着,使用 DuckDB 读取 JSONL 日志,完成字段解析和数据整理,将结果转换为 Parquet 文件。
最后,通过 SQL 汇总指定日期的数据,生成 CSV 统计报表,并把整理后的文件和报表上传到 OSS。
原始日志、分析数据和统计报表分别存放,方便后续查询和管理。
为什么选择 DuckDB 和 Parquet?
DuckDB 是一款嵌入式分析型数据库,可以直接在 Python 程序中调用,也能够通过 SQL 读取本地文件。
对于这种按天执行的批量统计任务,用起来很轻便。
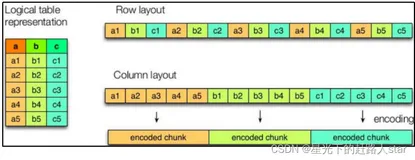
Parquet 则是一种面向分析场景的列式存储格式。
举个例子,一条原始日志可能包含十几个字段,但统计接口错误率时,只需要读取时间、服务名称和状态码。
Parquet 可以配合 DuckDB 的列裁剪和过滤下推能力,减少查询过程中的数据读取量。尤其是同一批日志需要反复统计时,提前整理成 Parquet 会更加方便。
OSS 负责存放长期数据。后续即使更换 ECS 实例,也可以重新下载日志和分析文件继续处理。
这几个组件搭配起来,正好覆盖了日志采集后的整理、计算和保存需求。
二、准备阿里云 ECS 环境
1. 创建 ECS 实例
进入阿里云 ECS 控制台,创建一台 Ubuntu 云服务器。
本文采用下面的配置作为教程环境:
| 配置项 | 选择 |
|---|---|
| 云产品 | 阿里云 ECS |
| 实例规格 | ecs.u2a-c1m2.xlarge |
| 计算资源 | 4 vCPU、8 GiB 内存 |
| 操作系统 | Ubuntu 24.04 LTS |
| 系统盘 | 40 GiB |
| Python | Python 3 |
| 分析组件 | DuckDB |
| 存储服务 | 阿里云 OSS |
这里选择了阿里云通用算力型 u2a 实例。
根据阿里云官方规格说明,u2a 采用 CIPU 架构,兼容多代 AMD EPYC 处理器,其中包括 Turin。
4 vCPU、8 GiB 内存的规格适合用来开展这类单机数据处理实践,也方便观察 CPU、内存和磁盘资源的使用情况。
需要了解的是,u2a 支持多代 AMD 处理器,具体分配到的 CPU 型号以实例实际信息为准。
实例创建完成后,通过 SSH 登录服务器,查看计算环境:
lscpu | grep -E 'Model name|CPU\(s\)'
free -h
df -h
其中,lscpu 可以查看虚拟机中可见的处理器信息,free -h 用来检查内存,df -h 则用于确认磁盘剩余空间。
百万级日志处理会持续读写文件,建议在开始之前确认可用磁盘容量。
安全组方面,保留必要的 SSH 管理入口,并将访问来源限制在自己的管理地址范围内即可。
2. 安装 DuckDB
Ubuntu 环境准备完成后,安装 Python 虚拟环境和 DuckDB。
sudo apt update
sudo apt install -y python3-venv

mkdir -p ~/loglab/data
cd ~/loglab

python3 -m venv .venv
source .venv/bin/activate

pip install duckdb
安装完成后,检查版本:
python -c "import duckdb; print(duckdb.__version__)"
这里使用虚拟环境管理 Python 依赖,可以保持系统 Python 环境整洁,也便于后续升级 DuckDB。
DuckDB 可以直接通过 Python 库运行 SQL。对于本次任务,Python 负责组织处理流程,SQL 负责完成数据计算。
三、准备 200 万条访问日志
为了让教程可以直接复现,先准备一份模拟业务日志。
假设系统包含四个服务:
api:核心业务接口auth:用户认证服务pay:支付服务search:搜索服务
每次请求记录时间、所属服务、HTTP 状态码、响应耗时以及 trace_id。
单条日志的结构如下:
{
   "ts":"2026-10-01 00:00:00","service":"api","status":200,"latency_ms":86,"trace_id":"0000000000000000"}
生产环境通常可以从 Nginx、API 网关或应用日志中获得这些字段。这里使用 Python 生成测试数据,方便从零搭建完整流程。
在项目目录新建 generate.py:
import json
import random
from datetime import datetime, timedelta

rng = random.Random(2026)
start = datetime(2026, 10, 1)
services = ["api", "auth", "pay", "search"]

with open("data/access.jsonl", "w") as f:
    for i in range(2_000_000):
        record = {

            "ts": str(start + timedelta(seconds=i // 4)),
            "service": services[i % 4],
            "status": 500 if rng.random() < 0.03 else 200,
            "latency_ms": rng.randint(10, 1000),
            "trace_id": f"{i:016x}"
        }
        f.write(json.dumps(record) + "\n")
执行:
python generate.py
wc -l data/access.jsonl
文件包含 200 万行日志,每行对应一次请求。
这里将随机种子固定为 2026,方便重复生成相同数据。
模拟数据覆盖了请求量、错误码和响应耗时三个常用维度。实际接入业务日志时,只需要根据应用输出格式调整字段映射即可。
另外,本文的日志按时间顺序生成,这个细节后面转换 Parquet 时还会用到。
四、使用 DuckDB 处理日志
1. 先解决数据格式问题
JSONL 非常适合日志写入。
一行对应一条记录,既方便追加,也方便从日志文件中定位原始事件。
但日志分析经常要对同一批数据进行多次过滤和聚合,例如上午查看错误率,下午排查某个接口的响应耗时。
这时可以提前把日志整理成 Parquet。
DuckDB 提供了 read_json 函数,能够读取 JSONL 文件。转换过程使用 SQL 的 COPY 语句完成。
新建 analyze.py,先加入数据转换逻辑:
import duckdb

db = duckdb.connect()
db.execute("SET threads = 4")
db.execute("SET memory_limit = '5GB'")

db.execute("""
COPY (
    SELECT
        CAST(ts AS TIMESTAMP) AS ts,
        service, status, latency_ms, trace_id
    FROM read_json(
        'data/access.jsonl',
        format = 'newline_delimited'
    )
    ORDER BY ts
)
TO 'data/access.parquet'
(FORMAT PARQUET, COMPRESSION ZSTD);
""")
代码主要完成了几件事。
首先,将 DuckDB 的查询线程数设置为 4,与 ECS 的 vCPU 数量相匹配。
接着,将内存使用上限设置为 5 GiB,为操作系统和其他进程留出一定空间。
随后读取 JSONL 数据,将时间字段转换为标准时间类型,并按照时间排序。
最后,将处理后的数据写入 Parquet,使用 ZSTD 压缩。
2. 为什么要按照时间排序?
日志查询通常带有时间条件。
例如,查看某天凌晨的错误情况,或者分析一次版本发布后半小时内的接口请求。
Parquet 内部以行组组织数据,每个行组可以包含列的统计信息。
当相近时间段的数据集中存放时,DuckDB 有机会根据行组的统计信息跳过无关部分,减少实际扫描的数据量。
随着日志规模增加,这种数据布局会越来越有价值。
实际项目中,还可以根据业务规模将日志按日期组织为多个 Parquet 文件,例如每天生成一份分析数据。
这样既方便归档,也方便按日期管理文件生命周期。
五、用 SQL 生成错误统计报表
数据转换完成后,开始处理真正关心的业务指标。
假设现在要检查 2026 年 10 月 3 日的请求情况,希望得到每个服务的请求总数、5xx 错误数量、错误率以及平均请求耗时。
继续在 analyze.py 中加入下面的 SQL:
db.execute("""
CREATE TEMP VIEW day_report AS
SELECT
    service,
    COUNT(*) AS requests,
    COUNT(*) FILTER (WHERE status >= 500) AS errors,
    ROUND(
        100.0 * COUNT(*) FILTER (WHERE status >= 500)
        / COUNT(*), 2
    ) AS error_rate_pct,
    ROUND(AVG(latency_ms), 1) AS avg_latency_ms
FROM read_parquet('data/access.parquet')
WHERE ts >= TIMESTAMP '2026-10-03 00:00:00'
  AND ts < TIMESTAMP '2026-10-04 00:00:00'
GROUP BY service;
""")

for row in db.execute(
    "SELECT * FROM day_report ORDER BY service"
).fetchall():
    print(row)

db.execute("""
COPY (
    SELECT * FROM day_report ORDER BY service
)
TO 'data/error_summary.csv'
(FORMAT CSV, HEADER TRUE);
""")
现在执行整个脚本:
python analyze.py
程序会在终端打印四个服务的统计结果,并生成 error_summary.csv。
报表包含五个字段:
| 字段 | 含义 |
|---|---|
| service | 服务名称 |
| requests | 请求总数 |
| errors | 5xx 错误请求数 |
| error_rate_pct | 5xx 错误率,单位为百分比 |
| avg_latency_ms | 平均请求耗时,单位为毫秒 |
根据前面的日志生成规则,每秒生成四条请求,四个服务各占一条。因此,10 月 3 日全天共有 345600 条请求,每个服务对应 86400 条。
这也提供了一个简单的数据校验依据。
错误数量和平均耗时由生成的具体数据决定,运行脚本即可得到完整报表。
让报表真正有用
对开发人员来说,单独的错误数量只能反映一部分情况。
例如,一个服务每天处理十万次请求,出现一百次错误;另一个服务只处理两千次请求,却出现五十次错误。
第二个服务虽然错误数量较少,但错误率更高,更值得关注。
因此,这里同时保留了请求总数与错误率。
平均响应耗时则提供了另一个观察维度。如果某个服务错误率正常,但请求耗时持续增加,就可以进一步检查数据库查询、缓存命中情况和下游依赖。
对于这类日报需求,先把几个关键指标统计清楚,就能解决不少日常排查问题。
需要进一步分析时,也可以直接修改 SQL,增加按小时统计、状态码分布或指定服务的慢请求查询。
DuckDB 的好处就在这里:数据已经整理好,后续分析基本围绕 SQL 展开。
六、接入阿里云 OSS,保存原始数据和报表
到这里,日志已经可以在 ECS 上完成分析。
接下来解决数据的长期保存问题。
云服务器适合承担计算任务,OSS 则适合存储原始日志、历史 Parquet 文件和定期生成的报表。
二者配合,可以让计算任务和数据保存分别管理。
1. 创建 OSS Bucket
进入阿里云 OSS 控制台,新建一个 Bucket。
建议与 ECS 选择相同地域,便于通过适当的内网 Endpoint 访问,减少跨地域传输带来的额外开销。
Bucket 的访问权限设置为私有。
对象目录可以按照用途组织:
| 对象前缀 | 保存内容 |
|---|---|
loglab/raw/ |
原始 JSONL 日志 |
loglab/curated/ |
转换后的 Parquet |
loglab/reports/ |
SQL 生成的 CSV 报表 |
这种划分便于后续设置不同的存储生命周期。
原始数据可以保留更长时间,用于故障复盘;整理后的数据和统计报表则可以根据实际查询频率调整保存周期。
2. 使用 RAM 角色管理访问权限
ECS 访问 OSS 时,可以给实例绑定 RAM 角色。
通过实例 RAM 角色,程序能够获取临时访问凭证,省去在脚本中保存长期 AccessKey 的管理工作。
在 RAM 控制台创建适用于 ECS 的实例角色,授予访问指定 Bucket 及对象前缀所需的权限,再将角色绑定到 ECS。
日常使用中,可以按读写需求设置权限:
读取日志需要 oss:GetObject,上传文件需要 oss:PutObject。列出对象和处理分片上传时,再补充相应操作权限。
权限范围尽量收敛到当前项目使用的 Bucket 和路径。
3. 安装 ossutil 并上传文件
ossutil 是阿里云提供的 OSS 命令行工具,支持文件上传、下载及批量管理。
按照阿里云官方 ossutil 2.x 安装文档完成安装后,可以在 ~/.ossutilconfig 中配置实例角色认证。
例如,Bucket 位于杭州地域时,配置如下:
[default]
mode = EcsRamRole
region = cn-hangzhou
地域按实际环境修改。这里使用 ECS 实例角色认证,角色名称可由工具自动获取。
随后上传三个文件:
ossutil cp data/access.jsonl \
  oss://YOUR_BUCKET/loglab/raw/access.jsonl

ossutil cp data/access.parquet \
  oss://YOUR_BUCKET/loglab/curated/access.parquet

ossutil cp data/error_summary.csv \
  oss://YOUR_BUCKET/loglab/reports/error_summary.csv
将 YOUR_BUCKET 替换成实际 Bucket 名称。
上传完成后,通过 OSS 控制台就可以查看原始日志、整理后的 Parquet 文件和统计报表。
到这里,一条完整的日志处理链路就搭建好了。
后续更换计算实例时,只要准备好 DuckDB 环境,从 OSS 下载所需数据,就可以继续执行分析任务。
七、让这套工具适合日常使用
前面的代码解决了核心分析功能。真正放到项目中使用,还需要考虑日志按天处理、重复执行和文件管理。
这几个细节会直接影响工具的使用体验。
1. 按日期组织日志
教程中使用单个 JSONL 文件,是为了方便演示。
日常运行时,更推荐按照日期保存数据。
例如,10 月 3 日的原始日志放到 raw/2026-10-03/ 目录下,对应的 Parquet 文件放到 curated/2026-10-03/,统计报表放到 reports/2026-10-03/。
脚本接收日期作为参数,根据日期选择输入文件和输出路径。
这样查找历史数据会比较方便,也容易结合 OSS 生命周期规则进行管理。
当日志持续增长时,可以进一步按服务名称或业务类型划分目录。
2. 让重复执行得到一致结果
批处理任务偶尔会遇到网络中断、实例重启或者输入文件尚未上传完成的情况。
一个比较实用的处理方式是:先在临时目录生成 Parquet,校验数据完整性后,再将文件上传到正式的 OSS 路径。
这里可以增加两项基础校验。
第一项是记录数校验,检查原始日志和转换后 Parquet 的记录数量是否一致。
第二项是查询结果校验,例如对指定日期统计总请求数,确认转换前后结果相同。
对于有重复数据或者缺失字段的业务日志,还可以根据 trace_id、请求时间等信息设计相应的清洗规则。
报表上传完成后,可以保存一份任务清单,记录输入文件、处理日期、程序版本和输出对象路径。
后续需要重跑时,直接根据清单恢复处理过程即可。
3. 观察磁盘与内存使用
DuckDB 的嵌入式运行方式比较轻便,但排序、聚合和数据转换仍然需要计算资源。
尤其是处理包含大量字段的日志时,中间数据可能占用较多内存。
本次使用 4 vCPU、8 GiB 内存的 ECS,DuckDB 设置为 4 个线程、5 GiB 内存上限,就是为了让分析任务拥有明确的资源边界。
随着日志规模增长,可以观察 CPU 使用率、内存占用和云盘吞吐情况,再决定是否调整配置。
如果主要耗时集中在 JSON 解析和 Parquet 压缩,可以重点关注处理器能力与并行度。
如果大量时间消耗在文件读写,则可以检查云盘性能、文件布局和数据扫描方式。
这些数据能够帮助我们更有针对性地选择 ECS 规格。
4. 根据任务频率管理计算成本
这套方案还有一个值得关注的特点:日志分析可以按批次执行。
例如,每天凌晨处理前一天的访问日志,生成统计报表并上传 OSS。
可以通过定时任务触发分析脚本,也可以结合 ECS 的启停或实例创建机制安排计算时间。
选择按量付费实例时,应结合实际计费方式管理使用周期。实例停止之后,云盘等附属资源仍可能继续产生费用。
OSS 的存储、请求和数据传输费用也需要结合实际使用量评估。
对于长期运行的项目,建议定期查看成本账单,再根据日志增长速度和每天的处理窗口调整资源配置。
八、后续还可以怎样扩展?
目前已经完成了日志生成、格式转换、SQL 分析和 OSS 归档四个部分,具备了一套轻量日志分析工具的基本能力。
如果要继续完善,可以从三个方向入手。
第一个方向是增加更多分析指标。
例如统计 P95、P99 响应耗时,按小时分析错误率变化,或者筛选耗时超过指定阈值的请求。
这些功能都可以利用 DuckDB 的 SQL 能力逐步加入。
第二个方向是自动生成可视化报表。
CSV 适合保存数据,但日常查看还可以更直观。
可以通过 Python 绘图库生成错误率折线图、服务响应耗时分布图,再将图片与 CSV 一起上传 OSS。
这样每天打开报表,就能快速了解服务运行状态。
第三个方向是让计算过程自动化。
将日志下载、Parquet 转换、SQL 统计、结果上传封装成一个任务脚本,再配合定时调度执行。
如果业务量继续增长,还可以根据数据规模调整 ECS 配置,或者把不同日期的任务拆分处理。
整个方案可以随着业务需要逐步扩展。
九、总结
这次教程围绕一个很常见的需求展开:如何利用一台云服务器,把百万级访问日志整理成便于查询和归档的数据。
从实现过程来看,几个组件之间的分工比较清晰。
阿里云 ECS 提供计算环境,AMD EPYC 处理器承担日志解析、排序和聚合等计算任务;DuckDB 负责执行 SQL;Parquet 让重复分析更方便;OSS 则负责保存原始日志和处理结果。
整个流程保留了原始数据,分析逻辑集中在 SQL 和少量 Python 代码中,后续添加新指标也比较容易。
这套工具适合定期生成日志报表、进行历史故障分析,以及处理开发测试环境中的批量日志。
实践中还有一个很实用的思路:先把数据处理流程做清楚,再根据任务规模配置计算资源。
从一台 ECS 开始,处理好日志格式、文件布局、查询逻辑和结果归档,很多日常分析需求就有了一套容易维护的解决方案。
随着业务发展,再逐步增加自动调度、可视化和更细粒度的数据管理能力。
对于希望了解阿里云 ECS、AMD 算力和轻量化数据分析的开发者来说,这也是一个比较容易上手的实践项目。