一份日志要反复统计,直接读 CSV 就够了,还是值得先换成 Parquet?这次我在阿里云 ECS 上生成了 200 万条模拟访问日志,做了一个小实验。
最显眼的结果是:同样做一次指定小时的统计,查询耗时从 704.35 ms 降到了 4.90 ms。但把整个过程算进去,我发现事情没有“换个格式就完事”这么简单。
先看这次实验的三个发现:
- 查询更快、文件更小:Parquet 文件体积减少约 89%,三类查询都有明显提速。
- 只查一次,转换未必划算:转换本身需要约 1.35 秒,也得算进总耗时。
- 四线程并非次次占优:一个很短的查询,单线程反而略快。
01|场景很简单:查一个小时,找一组错误,做一次汇总
我选的是日志分析中容易理解的三个问题:某个小时有多少请求、哪些接口的错误最多、整份日志的请求和返回字节数是多少。这样既有带条件的查询,也有全量汇总,比较起来更有意思。
实验复用了账号里的一台 ECS,通过云助手完成环境检查、依赖安装和实验执行,再把结果取回本地整理。
| 项目 | 本次实际配置 |
|---|---|
| 云服务器 | 阿里云 ECS 通用算力型 u1,杭州地域 |
| 计算资源 | 4 vCPU、8 GiB 内存;系统识别为 Intel Xeon Platinum |
| 软件环境 | Ubuntu 22.04、Python 3.10.12、DuckDB 1.4.4 |
| 实验数据 | 200 万条模拟日志,按时间排序,包含 6 个字段 |
日志字段分别是请求编号、时间、接口、状态码、耗时和返回字节数。这些数据由脚本生成,不包含真实用户访问记录,生成规则也保留在复现材料里。
02|先把比较方法固定,再看谁更快
我设置了三组:CSV 单线程、Parquet 单线程、Parquet 四线程。前两组比较文件格式,后两组观察线程数的影响。
为了让数字能放在一起比较,实验按下面的方式执行:
- 固定输入和查询逻辑。 使用同一份数据、相同查询,CSV 提前指定字段类型。
- 预热后重复测量。 每个组合先预热一次,再正式测量 7 次,测试顺序交错排列,最终取中位数。
- 同时核对结果。 每次查询都校验结果,避免只看速度、忽略统计内容是否一致。
最终得到 63 次正式测量,查询结果全部通过一致性校验。下面的时间只统计查询执行与取回结果,程序启动耗时另行记录。
03|换个格式,查询时间差多少?
先看结果,单位均为毫秒,数值越小越好。
| 查询任务 | CSV 单线程 | Parquet 单线程 | Parquet 四线程 |
|---|---|---|---|
| 指定小时:按状态码统计请求数与返回字节数 | 704.35 | 4.90 | 5.60 |
| 错误接口 Top 10:统计错误数与耗时 | 546.14 | 25.26 | 13.12 |
| 全量汇总:请求、错误、返回字节数与耗时 | 542.59 | 37.67 | 18.34 |
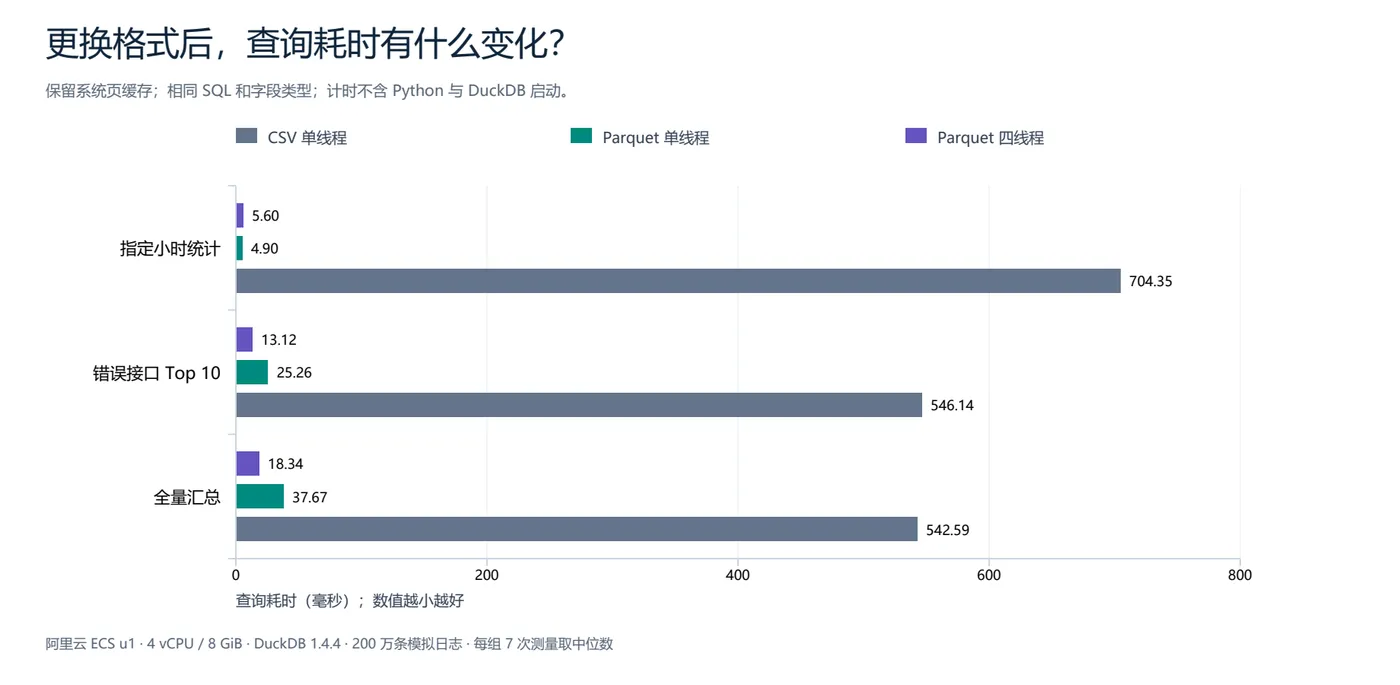
图 1|同一台 ECS、同一份数据,每组 7 次测量取中位数。
变化最大的是指定小时统计。我选取了傍晚六点到七点的数据,按状态码汇总请求数和返回字节数,Parquet 单线程只用了约 4.9 毫秒。另外两个查询也明显缩短了耗时。
这份数据本身按时间排列,时间过滤可能让 Parquet 更容易跳过无关数据。不过,本次没有单独拆分压缩、列读取和数据跳过各自的贡献,能确认的是这套格式与查询组合的整体收益。
04|四个线程,为什么没有全部跑赢?
把 CSV 那根较长的柱子拿掉,再单独比较 Parquet,区别会更清楚。
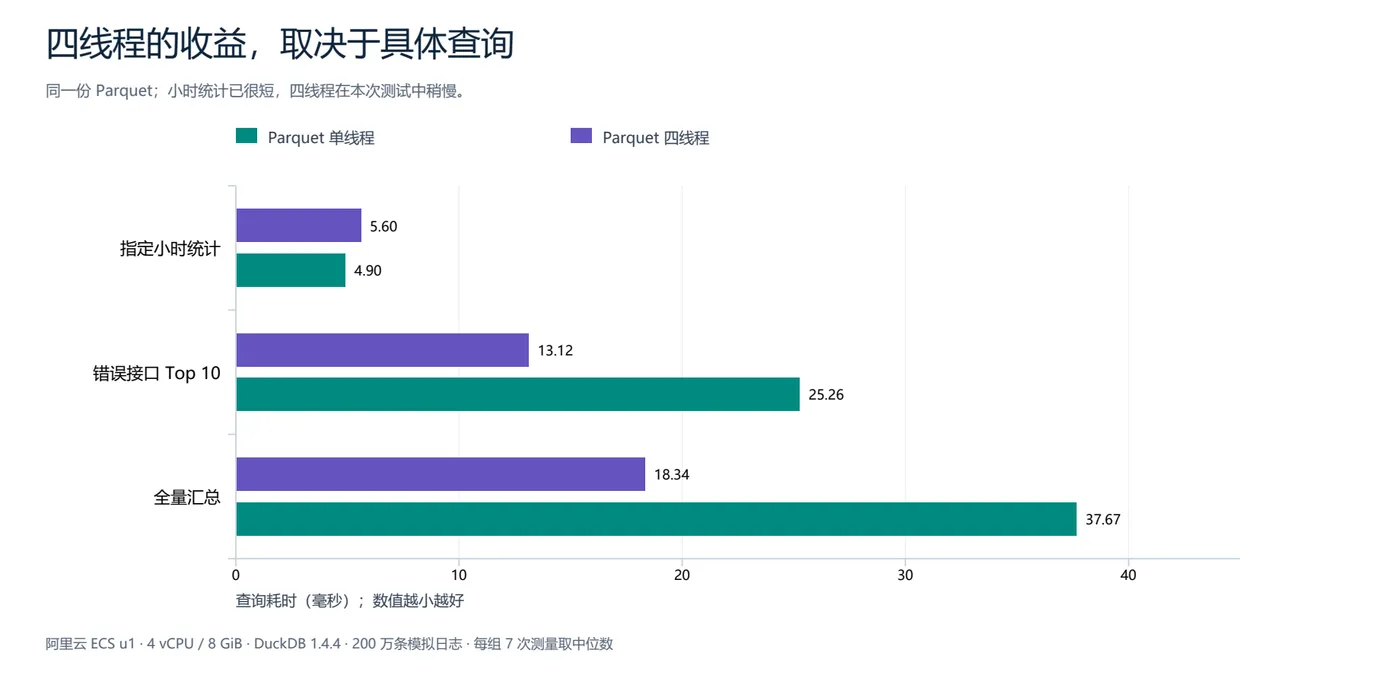
图 2|四线程缩短了两类查询的耗时,但指定小时统计从 4.90 ms 增至 5.60 ms。
错误接口统计从 25.26 ms 降到 13.12 ms,全量汇总从 37.67 ms 降到 18.34 ms,都接近缩短一半。小时统计却反过来,四线程略慢。
这个结果让我觉得,线程数不能直接照着 CPU 核数填满。对于已经很短的查询,并行调度等额外开销可能抵消收益;具体原因还需要更细的测试。至少这次的结果提醒我:调整线程以后,还是要用自己的查询再跑一遍。
05|查询只要几毫秒,转换的 1.35 秒算谁的?
只看查询图,很容易觉得应该马上把 CSV 全换掉。但前面还有一次格式转换。
| 要算的这笔账 | 本次实测结果 |
|---|---|
| 原始 CSV 文件 | 105.38 MiB |
| Parquet 文件(ZSTD 压缩) | 11.55 MiB |
| 文件体积减少 | 约 89% |
| CSV 转换为 Parquet | 约 1.35 秒 |
如果我只想查一次小时统计,直接读 CSV 约需 0.70 秒;先转换再查,则需要约 1.36 秒。这时,即使 Parquet 的查询本身更快,总时间还是更长。
如果同一份数据要反复使用,情况就不同了。按本次中位数估算,重复做 2 次小时统计,就开始抵消转换耗时;另外两类查询大约需要 3 次。这里仅比较转换与查询时间,没有把开发和环境安装时间算进去。
做完这个小实验,我觉得最大的收获是学会把几笔时间放在一起看:转换花多久、查询省多久、程序启动又要多久。 阿里云 ECS 提供了固定的运行环境,云助手方便执行和留存结果;而下一次遇到类似任务,我会先看数据会被用几次,再决定格式和线程数。这样选出来的方案才更贴近实际需要。