2.2 迁移文档列了几处会影响升级的变更:
geo_point换了新的存储格式(doc_values和coerce参数因此被移除)、脚本受 Java Security Manager 限制、field stats API 的响应格式变化、systemd 下日志默认输出改到 journal、Java 客户端遍历ClusterHealthResponse的方式变化,另有 AWS 插件代理设置改名和 multicast 插件弃用。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(migrate_2_2.asciidoc、BaseGeoPointFieldMapper.java、security.asciidoc),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
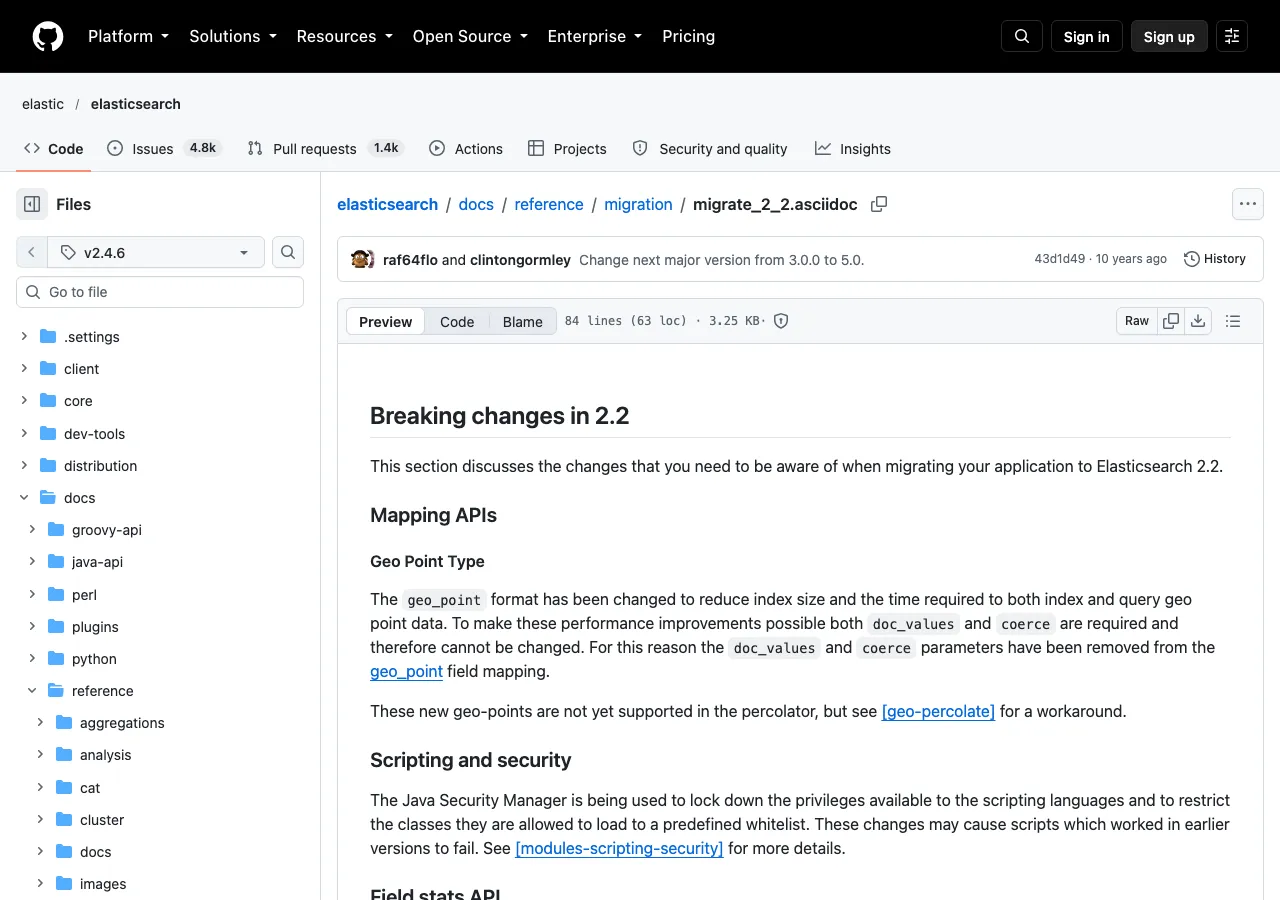
图 1:官方文件 migrate_2_2.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 migrate_2_2.asciidoc
geo_point 换了格式
2.2 迁移文档(migrate_2_2.asciidoc @ v2.4.6)的原文:
The
geo_pointformat has been changed to reduce index size and the time required to both index and query geo point data. To make these performance improvements possible bothdoc_valuesandcoerceare required and therefore cannot be changed. For this reason thedoc_valuesandcoerceparameters have been removed from thegeo_pointfield mapping.
新格式要减少索引体积并加快索引与查询,前提是必须启用 doc_values 且必须做 coerce(坐标值强制转换)。这两项成了前提,就不能再让用户关掉,于是从 mapping 参数里删除。
影响面:
- 老 mapping 里显式写了
"doc_values": false或"coerce": false的geo_point字段,要在新建索引的 mapping 里删掉这两个参数。v2.4.6 的新格式解析代码(BaseGeoPointFieldMapper 第 202–260 行)没有处理这两个参数,写了会怎样(报错还是忽略),本文没有实测; - 新格式的 geo_point 在 2.2 时还没有被 percolator 支持,官方指向 geo-percolate 一节给 workaround;
- 按 第 206–207 行,2.2.0 之前创建的索引仍走
GeoPointFieldMapperLegacy,所以老索引的 mapping 不用动。我的判断是想用上新格式,就得在新版本里建新索引再迁移数据,别指望老索引原地升级。
同一段源码里还能看到,新格式的 geo_point 对 lat_lon、precision_step、geohash、geohash_prefix、geohash_precision 这几个参数会写 deprecation 日志,提示下个大版本移除。如果 mapping 里用了它们,升级后日志里会出现告警。
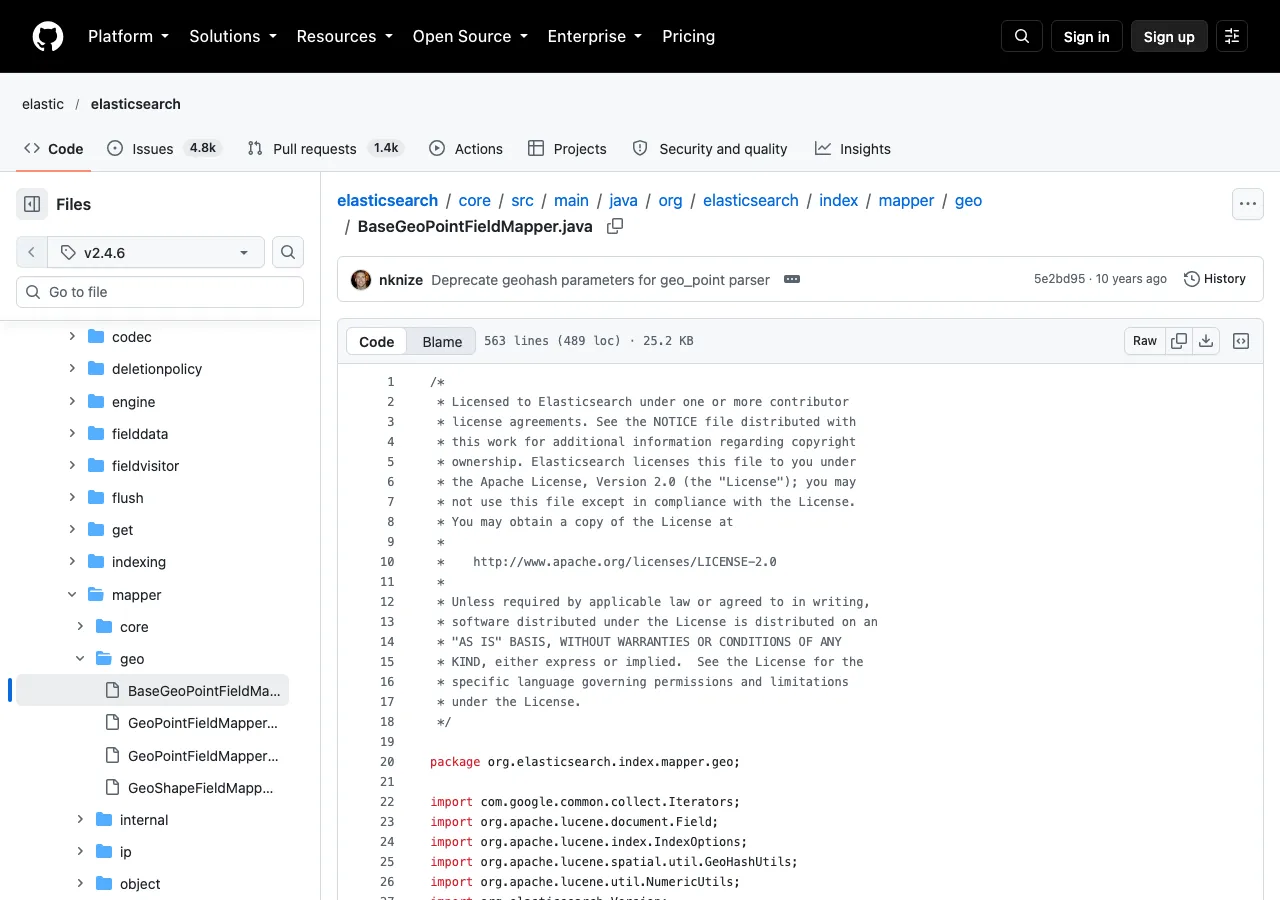
图 2:官方文件 BaseGeoPointFieldMapper.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 BaseGeoPointFieldMapper.java
脚本受 Java Security Manager 限制
The Java Security Manager is being used to lock down the privileges available to the scripting languages and to restrict the classes they are allowed to load to a predefined whitelist. These changes may cause scripts which worked in earlier versions to fail.
从 2.2 起,脚本能用的权限和可加载的类被白名单限制。这是安全加固,后果是之前能跑的脚本在升级后可能失败。
脚本安全一节(security.asciidoc)说明了两点:Security Manager 默认开启,安全策略把每个类的权限收到运行所需的最小;脚本语言只能加载 ClassPermission 里硬编码白名单中的类,加载白名单之外的类"可能"(may)得到 ClassNotFoundException。文档给的例子是 Groovy 脚本 use(java.math.BigInteger),响应是 script_exception,里面嵌套 no_class_def_found_error 和 class_not_found_exception。所以症状是 script_exception 带这类原因。文档没有给出文件 IO、网络等具体被拦操作的报错样例,本文不猜测异常类型。处理方式:
- 尽量把逻辑收敛到
doc['field'].value这类标准访问上; - 确实用到白名单外能力的,考虑改成在应用端计算;
- 排障时看报错里被拒绝的类名,判断是脚本写法问题,还是确实需要额外权限。
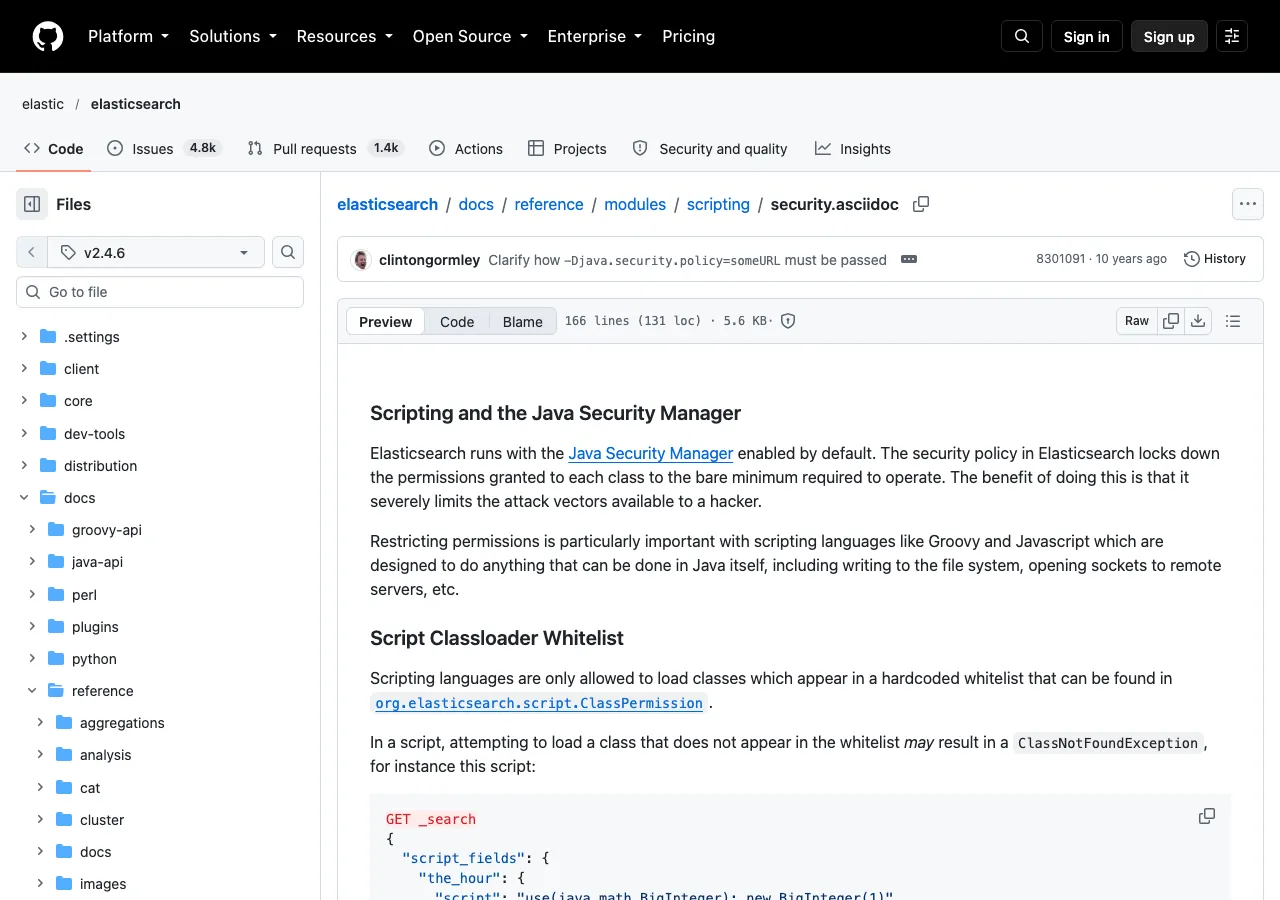
图 3:官方文件 security.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 security.asciidoc
field stats API 响应格式变了
The field stats' response format has been changed for number based and date fields. The
min_valueandmax_valueelements now return values as number and the newmin_value_as_stringandmax_value_as_stringreturn the values as string.
数值和日期字段的 min_value/max_value 从此返回真正的数字,字符串形式挪到新增的 min_value_as_string/max_value_as_string。
这个改动对解析方是破坏性的:原来按字符串处理 min_value 的代码,升级后拿到的是数字,类型断言可能失败;反过来,依赖字符串精度(比如日期格式、高精度数值的原样表示)的地方要改用新的 _as_string 字段。
systemd 下的日志默认值
In previous versions of Elasticsearch using systemd, the default logging configuration routed standard output to
/dev/nulland standard error to the journal. However, there are often critical error messages at startup that are logged to standard output rather than standard error and these error messages would be lost to the ether. The default has changed to now route standard output to the journal and standard error to inherit this setting.
之前 systemd 部署时 stdout 被丢到 /dev/null,而启动阶段的关键错误信息恰恰打在 stdout 上,于是这些错误"消失在以太里"。2.2 起 stdout 也进 journal,stderr 继承该设置。需要改的话编辑 elasticsearch.service。
运维上的影响是 stdout 的内容也进 journal,日志量可能变大,以前"看不到启动错误"的问题则不再出现。
ClusterHealthResponse 的遍历方式
Previously it was possible to iterate over
ClusterHealthResponseto get information aboutClusterIndexHealth. While this is still possible, it requires now iterating over the values returned fromgetIndices().
新写法:
ClusterHealthResponse clusterHealthResponse = client.admin().cluster().prepareHealth().get();
for (Map.Entry<String, ClusterIndexHealth> index : clusterHealthResponse.getIndices().entrySet()) {

    String indexName = index.getKey();
    ClusterIndexHealth health = index.getValue();
}
代码里直接 for-each ClusterHealthResponse 的地方要改成遍历 getIndices().entrySet()。同一节还提到 ClusterHealthStatus 从 org.elasticsearch.action.admin.cluster.health 搬到了 org.elasticsearch.cluster.health,import 要跟着改。
同一份迁移文档的另外两条
文档末尾还有两条,和 mapping、脚本无关,但会影响部署:
- Cloud AWS 插件的代理设置改名并标记弃用:
cloud.aws.proxy_host改为cloud.aws.proxy.host,cloud.aws.proxy_port改为cloud.aws.proxy.port,ec2、s3子级同理(如cloud.aws.ec2.proxy_host改为cloud.aws.ec2.proxy.host)。文档说旧设置会在下个大版本移除; discovery-multicast插件在 2.2.0 弃用,在 5.0 移除。用 multicast 做节点发现的集群,要在 5.0 之前换成单播发现。
原文见 migrate_2_2.asciidoc。
升级 2.2 的检查顺序
- mapping 里
geo_point字段删掉doc_values、coerce参数;用到 percolator + geo 的场景确认 workaround; - 灰度跑一遍所有脚本,看有没有
script_exception; - field stats 的解析代码改成按数字读
min_value/max_value,字符串用*_as_string; - systemd 部署确认 journal 容量;
- Java 客户端里
ClusterHealthResponse的遍历方式和ClusterHealthStatus的 import 改掉; - 用到 AWS 插件代理设置或 multicast 发现的,按上一节改。
脚本沙箱那条比 geo 更容易被忽略
这几条里,geo_point 换格式只影响新建索引的 mapping,写法对不对在建索引时就能看出来,好排查。更容易漏的是脚本受 Security Manager 限制。
原因是它的失败发生在运行时,而且取决于脚本里调用了什么。脚本在灰度环境可能一切正常,到生产因为某个调用被拦住才失败,静态看代码也看不出来。官方文档自己用的措辞是"may result in",说明连文档也不保证每次的表现一致。
我的建议是把所有脚本列出来,逐个在生产等价环境跑一遍,不要假设编译通过就能跑。上面检查清单里单列"灰度跑一遍所有脚本",原因就在这里:它没法靠读代码完成。
文档对这个限制的解释是:脚本语言(文中点名 Groovy 和 Javascript)本来就能做 Java 能做的一切,包括写文件系统、向远程服务器开 socket,所以权限限制对它们尤其重要。靠白名单去限制一门通用语言,是在通用能力上做减法。5.0 起有了 Painless(见 Groovy 到 Painless),2.2 这一步可以看作过渡,代价是上面说的"运行时才暴露"。
怎么提前找出会踩沙箱的脚本
# 1) 把索引里的脚本(indexed script)列出来,2.x 存在 .scripts 索引(ScriptService 第 90 行);文件脚本在各节点的 config/scripts 目录
curl -s 'localhost:9200/.scripts/_search?size=100&pretty'

# 2) 搜索代码里的内联脚本
grep -rn '"script"\s*:' --include=*.json --include=*.java --include=*.py . | head -30

# 3) 逐个在测试环境执行一次,看有没有 script_exception
#    (执行成功不代表生产一定通过,但失败能提前发现)
第三条是关键:沙箱问题只能靠执行发现。找到脚本之后,先看有没有加载白名单之外的类,比如 use(...) 引入的 JDK 类;文件读写、网络调用这类操作,文档只在说明限制动机时提到,没给具体报错,需要在测试环境实际执行确认。
写在最后
2.2 这批改动里,geo_point 的问题在建索引时就能看到,脚本沙箱要到运行时才暴露。升级前把脚本全量执行一遍,比读文档更有用。
systemd 那条:日志默认改到 journal 之后,如果 journal 没配容量上限,日志量增加可能占用更多磁盘。这是推断,文档只说了 stdout 现在也进 journal。
geo 那条:改 mapping 之前,先确认老索引要不要重建。按源码的版本判断,2.2.0 之前创建的索引继续走旧的映射器,只有新建索引才用新格式。这和父子关系那次的处理思路类似,见 2.0 的 _parent 重写。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。