2.3 迁移文档只有四条:每个索引的 nested 字段数量被限制到 50(可调
index.mapping.nested_fields.limit)、Groovy 依赖从groovy-all瘦到org.codehaus.groovy:groovy、Analyze API 的filters/token_filters/char_filters参数改名为单数形式,另外 2.3.0 和 2.3.1 的 CORS 预检请求是坏的,2.3.2 修好。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(migrate_2_3.asciidoc、ClusterModule.java、MapperService.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
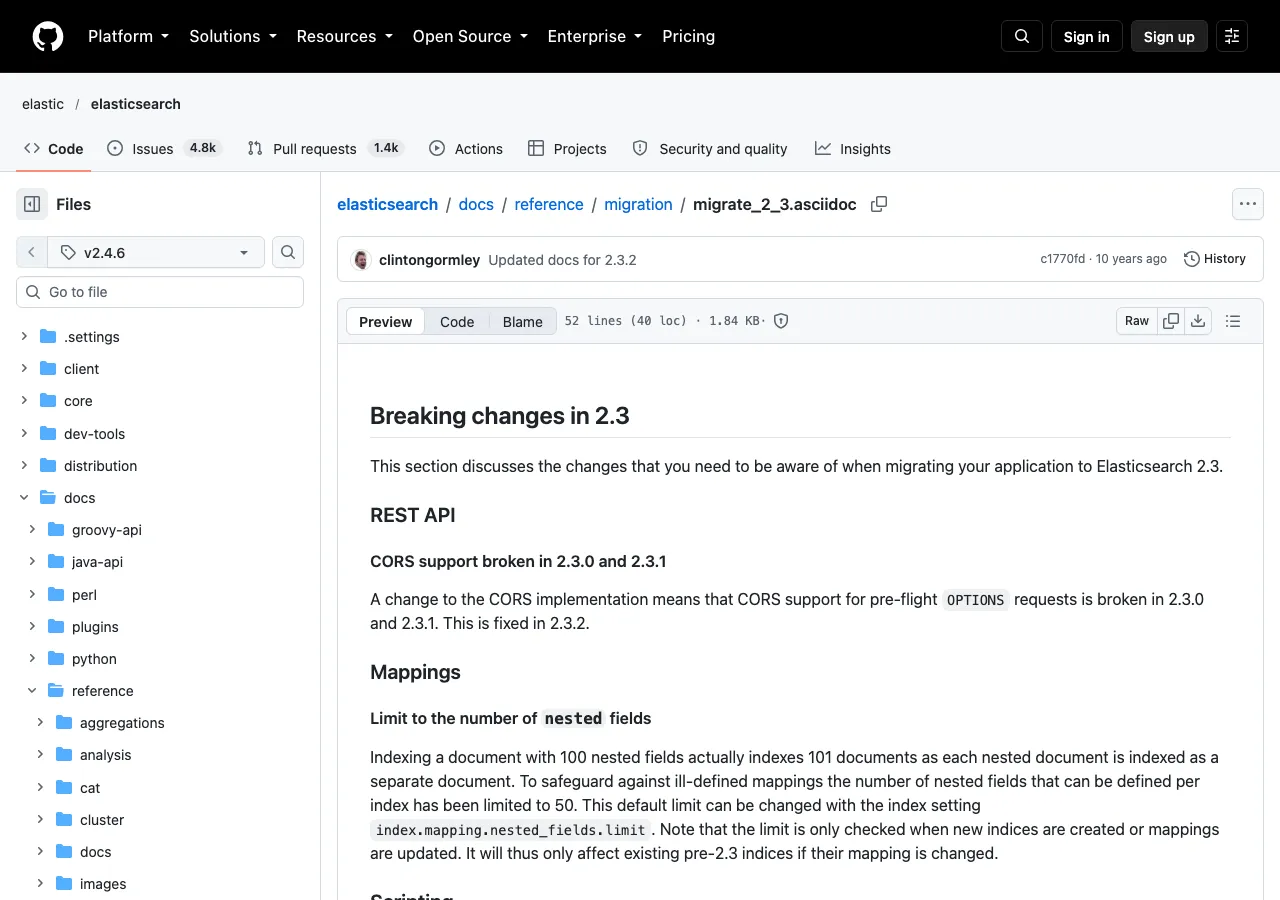
图 1:官方文件 migrate_2_3.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 migrate_2_3.asciidoc
nested 字段数量上限 50
2.3 迁移文档(migrate_2_3.asciidoc @ v2.4.6)先解释了代价:
Indexing a document with 100 nested fields actually indexes 101 documents as each nested document is indexed as a separate document. To safeguard against ill-defined mappings the number of nested fields that can be defined per index has been limited to 50.
nested 对象在 Lucene 里是独立的文档,所以一个含 100 个 nested 字段的文档,实际索引出 101 个文档。由此可以推断索引的文档数、体积和合并开销都会随 nested 的数量上涨,但文档没有给增长幅度,本文也没有实测。
限制的行为细节:
- 默认值 50,用索引设置
index.mapping.nested_fields.limit调整。这个设置是动态的,见 ClusterModule 第 284 行,可以在已有索引上直接改; - 只在新建索引或更新 mapping 时检查,2.3 之前创建的老索引,除非改它的 mapping,否则不受影响;
- 超限时抛
IllegalArgumentException,消息形如Limit of nested fields [50] in index [xxx] has been exceeded,见 MapperService 第 530–538 行。这段代码还显示,限制值设成负数(allowedNestedFields >= 0的判断)就等于不限制。
排障时可以记住最后一条:老索引平时没事,某天加个字段就报 nested 超限,原因就是它在更新 mapping 时才检查。
遇到超限的处理思路:
- 先看 mapping 设计:我的判断是,不需要查"同一个子对象内多个条件同时成立"的 nested,就该换成 object 或扁平化成多个字段(见后文),这条优先于调 limit;
- 确实需要更多 nested:调
index.mapping.nested_fields.limit,同时按"每个 nested 对象都是一份独立文档"估算索引增长; - 若该索引的 nested 字段仍然很多,评估把部分子结构拆成独立索引,或用 parent/child(2.x 里还支持,两者的取舍这里没有展开)。
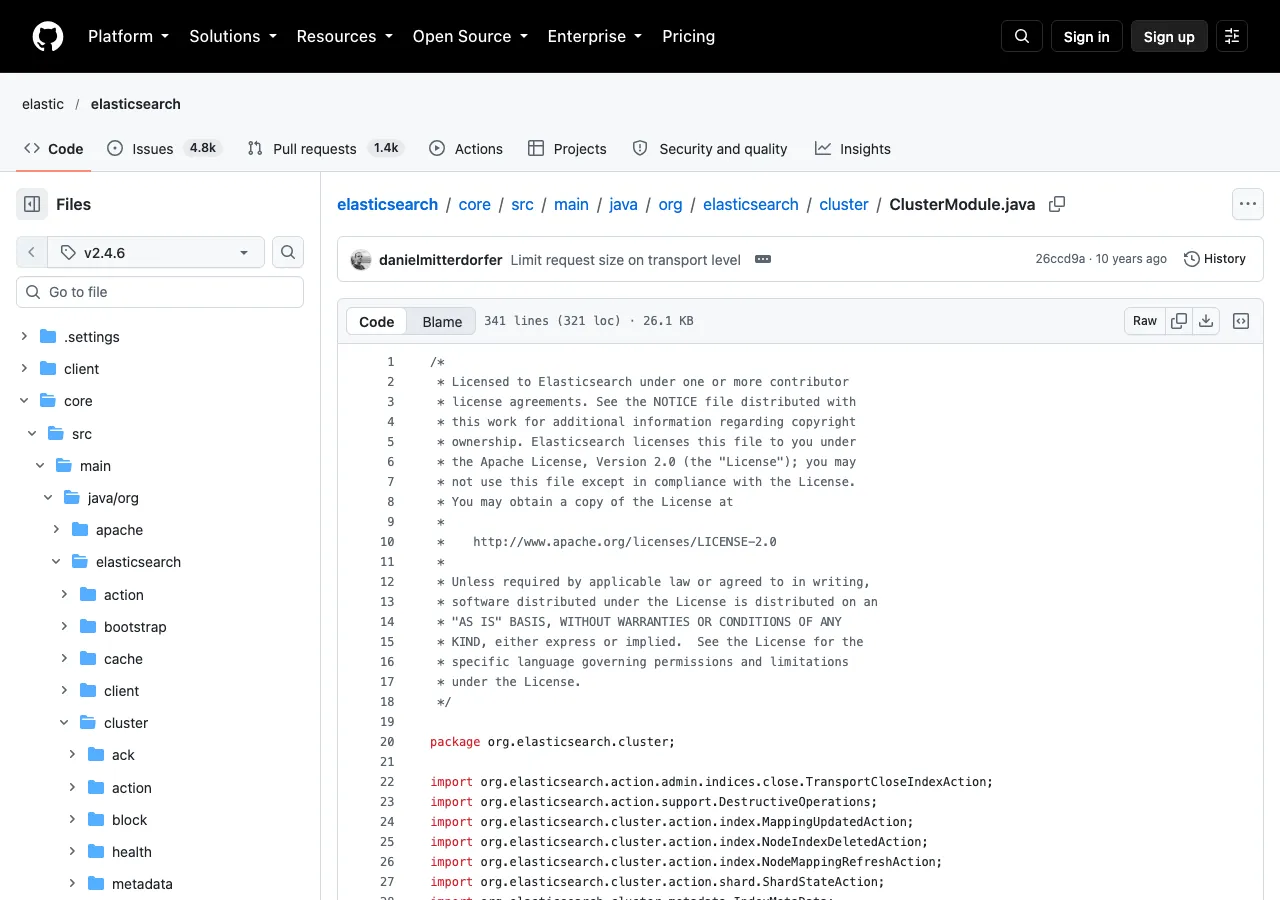
图 2:官方文件 ClusterModule.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 ClusterModule.java
Groovy 依赖瘦身
In previous versions of Elasticsearch, the Groovy scripting capabilities depended on the
org.codehaus.groovy:groovy-allartifact. In addition to pulling in the Groovy language, this pulls in a very large set of functionality, none of which is needed for scripting within Elasticsearch. Aside from the inherent difficulties in managing such a large set of dependencies, this also increases the surface area for security issues. This dependency has been reduced to the core Groovy languageorg.codehaus.groovy:groovyartifact.
groovy-all 会带进来一大堆 ES 脚本根本用不到的功能,管理麻烦且扩大安全攻击面,所以 2.3 换成核心语言包 org.codehaus.groovy:groovy。
影响面:文档没有列出被去掉的具体类。可以推断,脚本里如果用到了 groovy-all 附带但核心包里没有的类,升级后会找不到类。结合 2.2 引入的 Security Manager 类白名单(见 2.2 的 geo_point 与脚本沙箱),脚本本来能加载的类就不多,碰上的可能性不大,具体是否受影响要靠把脚本跑一遍确认。
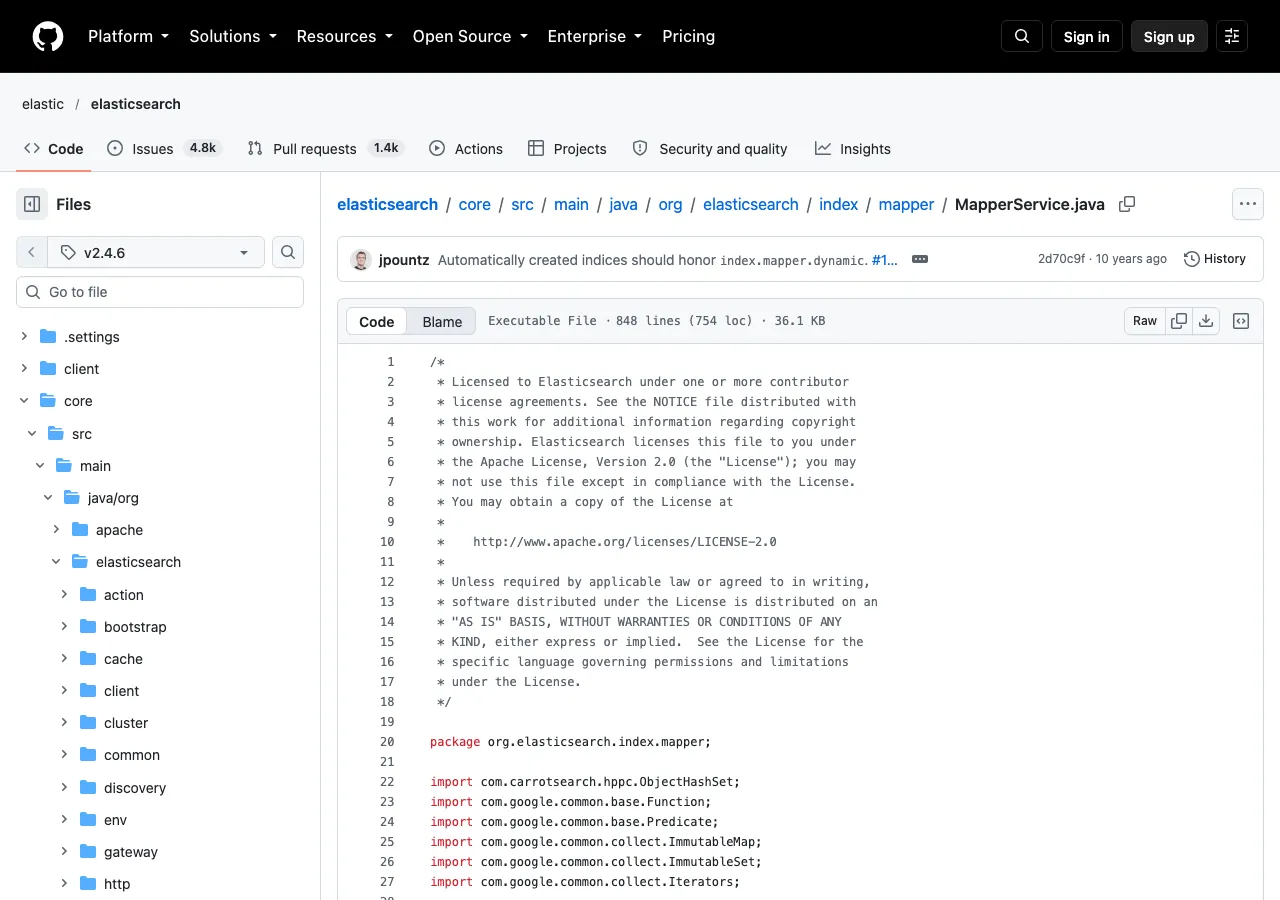
图 3:官方文件 MapperService.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 MapperService.java
Analyze API 参数改名
The deprecated
filters/token_filters/char_filtersparameter has been renamedfilter/token_filter/char_filter. Andfilters/token_filters/char_filtershas been removed in 5.0.0
复数的旧参数名被废弃,改用单数:filter、token_filter、char_filter。复数形式在 5.0.0 才删除,2.3 期间是"能用但已废弃"的过渡期。我的建议是别等过渡期:调用 _analyze 的脚本或工具,在升到 5.0 之前就改掉。
2.3.0 与 2.3.1 的 CORS 问题
这一条是已知缺陷而不是设计变更:
A change to the CORS implementation means that CORS support for pre-flight
OPTIONSrequests is broken in 2.3.0 and 2.3.1. This is fixed in 2.3.2.
预检 OPTIONS 请求在这两个版本里不工作。浏览器直连 ES 做跨域调用时,预检失败后后续请求发不出去,这是对预检作用的推断,文档只说了"broken"。建议不要停在 2.3.0 和 2.3.1,直接上 2.3.2 或更高。
三条改动各自的指向
文档给出的理由:nested 限制是防止"定义不当的 mapping",Groovy 瘦身是减依赖和攻击面,Analyze 参数改名为 5.0 移除旧名字做准备。升级时需要主动检查的是 nested 字段数量,因为它只在改 mapping 时才暴露。
nested 用多了,问题不在 50 这个数
限制 50 个 nested 字段的目的是防 mapping 失控,调大之前先想想建模对不对。
文档那句"100 个 nested 字段实际索引出 101 个文档"是关键:nested 越多,Lucene 里的文档越多,索引体积和 segment 合并的开销随之增加。把业务对象里所有子结构都设成 nested,调大 index.mapping.nested_fields.limit 只是让这个问题更大。
判断标准是:nested 只用在需要查询子对象内部关系的地方,例如"找出同时满足 A 和 B 的商品规格"。只是存着一起展示的话,用 object 就够了,代价是失去内部对应关系;只是按子字段过滤的话,扁平化成多个普通字段更简单。
怎么查现在用了多少 nested
curl -s 'localhost:9200/_all/_mapping' > /tmp/m.json
python3 -c "
import json
m=json.load(open('/tmp/m.json'))
for idx,body in m.items():
    n=0
    def walk(p):
        global n
        for f,d in (p or {}).items():
            if d.get('type')=='nested': n+=1
            walk(d.get('properties'))
    for t,td in (body.get('mappings') or {}).items(): walk(td.get('properties'))
    if n: print(idx, 'nested 字段数 =', n)
"
跑完对照 50 这个上限,超了或接近的按上面三条路处理。这个检查要在改 mapping 之前做:限制只在新建或更新 mapping 时触发,等报错再查,变更就已经卡住了。
nested 的替代方案:object 与扁平化
既然限制的本质是"nested 太贵",那把替代方案写清楚更有用。三种建模对比:
// 1) nested:子对象独立成文档,可查询内部关系,索引开销最大
{
    "specs": {
    "type": "nested", "properties": {
    "k": {
   "type":"keyword"}, "v": {
   "type":"keyword"} } } }

// 2) object:普通对象,ES 会扁平化存储,开销小,但失去内部对应关系
{
    "specs": {
    "type": "object", "properties": {
    "k": {
   "type":"keyword"}, "v": {
   "type":"keyword"} } } }

// 3) 扁平化成多字段:按用途直接展开,写法最简单
{
    "spec_color": {
   "type":"keyword"}, "spec_size": {
   "type":"keyword"} }
选择依据只有一条:要不要查询"同一个子对象内部的多个条件同时成立"。要(比如"颜色是红且尺寸是 L 的规格"),只能用 nested;不要,用 object 或扁平化。这个判断可以放到业务层面问:产品会不会按规格组合筛选,会就上 nested 并控制数量,不会就用 object。
object 的数组会失去内部对应,也就是"交叉匹配"。[{k:color,v:red},{k:size,v:L}] 用 object 存,查 "k=color 且 v=L" 会命中,即使它们属于不同的元素。这是 nested 存在的理由,选 object 之前要确认业务能接受这个误差。
调阈值前先算一笔账
如果确实要调 index.mapping.nested_fields.limit,先把增长算清楚:
实际索引文档数 ≈ 主文档数 × (1 + nested 子文档平均数)
假设平均每个文档有 30 个 nested 子文档,100 万条业务数据会变成约 3100 万个 Lucene 文档。这是按文档那句话推出来的数量级,没有实测。拿这个数字去估算磁盘、段数量和查询延迟,再决定调不调。建议是把它当成一次容量评估,而不是改个配置:算完通常会发现该改的是建模,不是把阈值从 50 调到 200。
写在最后
- nested 对象是独立的文档,用之前先算增长;
- 50 是对 mapping 设计的提醒,调大之前先想建模对不对;
- 限制只在改 mapping 时检查,老索引可能平时没事,某天加字段就报错,主动查一遍比等报错强。
Groovy 瘦身和 Analyze 参数改名两条不影响多数业务代码:前者减依赖和攻击面,后者是 5.0 移除旧名字的前置。CORS 那条:不要停在 2.3.0 和 2.3.1,直接上 2.3.2。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。