很多企业做数据安全,第一反应是:手机号打码、数据库加密、系统加权限。 这些措施都没错,但真正的问题是,企业往往只保护了“数据库里的那份数据”,却没有管住数据后面的流动。
生产库里的客户信息很安全,但被复制到了测试库;核心系统权限很严格,但业务人员可以一次导出几十万条明细;数据库做了加密,但ETL任务又把数据同步到了权限宽松的下游系统。
因此,敏感数据保护真正要解决的不是某一个技术问题,而是一条完整链路:先知道什么数据敏感,再判断敏感到什么程度,然后决定谁可以在什么场景下看到什么,最后持续追踪它流向了哪里。
一、第一步不是脱敏,而是先把敏感数据找出来
很多企业的敏感数据清单里只有几个字段:姓名、手机号、身份证号、银行卡号。 但真正进入企业环境以后,敏感数据远不止这些。
例如:客户名单、供应商底价、产品成本、员工薪资、核心配方、合同价格、经营预测,都可能具有很高的商业敏感性。
因此第一步不是立即设计脱敏规则,而是建立:敏感数据地图。 至少梳理清楚五件事:数据是什么、存在哪里、谁负责、谁在使用、流向哪里。
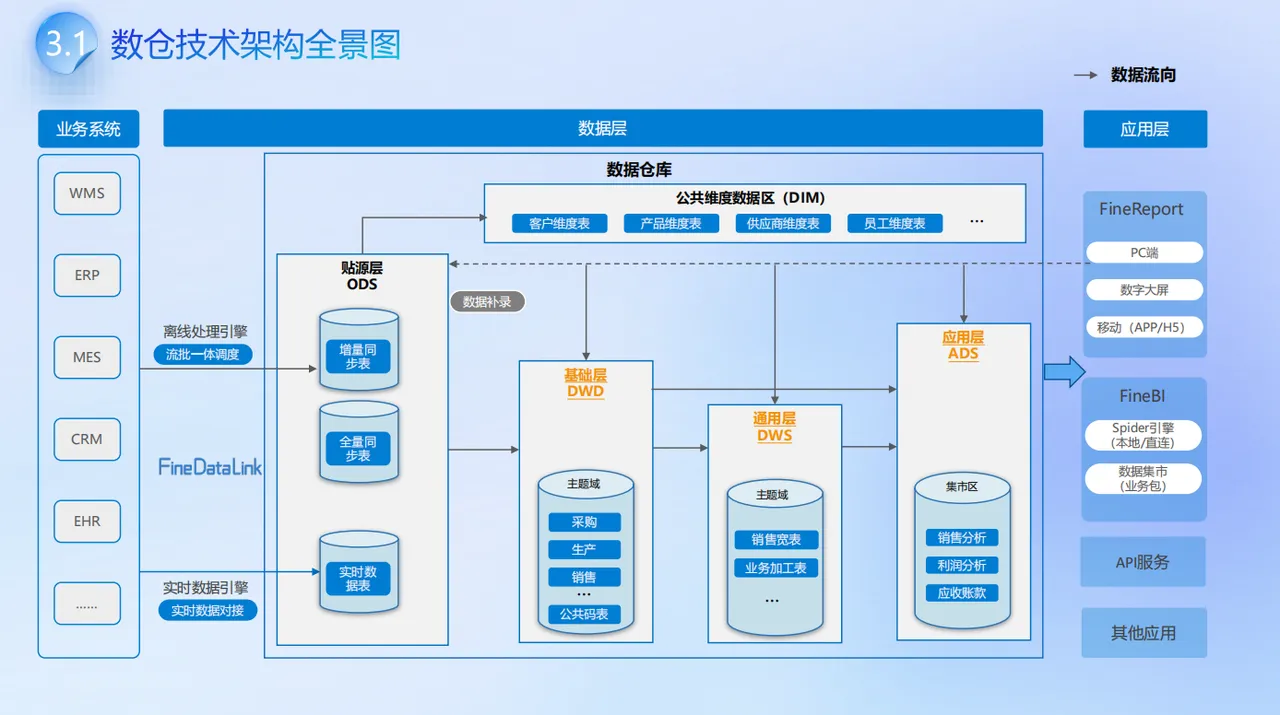
尤其是最后一项。因为今天的数据往往不会停留在原系统。例如CRM中的手机号可能经历:CRM → 数据同步 → ODS → DWD → 客户宽表 → BI → 营销系统。
如果只知道CRM里有敏感字段,却不知道它已经复制到了多少个下游系统,那么安全治理实际上只完成了一半。这时候需要关注的不只是“表”,还要关注数据链路。
在实际的数据平台建设中,如果企业通过连接ERP、CRM、MES、数据库、API等数据源,可以在梳理同步任务时同步建立一份“敏感字段流转清单”:哪些任务读取敏感表、哪些字段进入数仓、又被写入哪些目标端。
真正要解决的是:某个敏感字段一旦发生变化,我能不能知道它影响了哪些下游? 这才是敏感数据保护的起点。
二、分类分级:真正目的不是贴标签,而是决定怎么保护
发现数据以后,第二步才是分类分级。很多项目会把它做成两个Excel字段:数据分类:客户信息。数据等级:三级。然后就结束了。
但如果三级和四级数据最终采用完全相同的权限、脱敏和审计规则,这个“分级”其实没有任何意义。可以这样理解:分类回答“这是什么数据”; 分级回答“这份数据出问题以后有多严重”。
企业可以从四个维度评估:第一,敏感性。 泄露后是否会侵犯个人权益、暴露商业秘密或者影响企业经营?第二,规模。 100条手机号和1000万条手机号,即使字段完全相同,风险也并不相同。
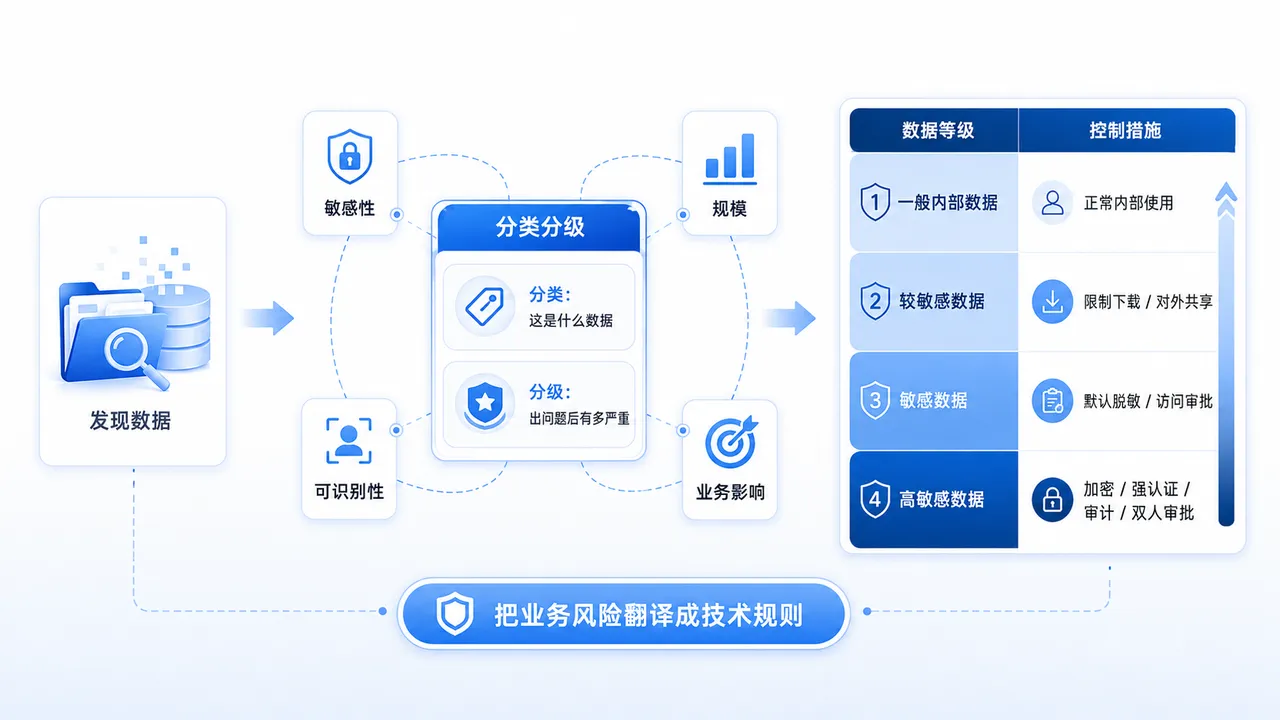
第三,可识别性。 单独一个年龄价值有限,但:姓名 + 手机号 + 地址 + 消费记录 组合后可能直接定位到具体个人。
第四,业务影响。 数据被泄露、篡改或者不可用以后,会不会影响交易、生产、财务或者重大经营决策?最终要形成的不是一个“等级标签”,而是一张:数据等级 × 控制措施矩阵。
例如:一般内部数据,可以正常内部使用;较敏感数据,限制下载和对外共享;敏感数据,默认脱敏并加强访问审批;高敏感数据,进一步增加加密、强身份认证、操作审计甚至双人审批。
因此分类分级真正承担的是一个非常重要的作用:把业务风险翻译成技术规则。 没有这一层,后面的脱敏、加密和权限控制很容易变成“一刀切”。
三、脱敏:重点不是打几个星号,而是让真实值只出现在必要场景
最常见的数据脱敏是:138**8888。但真正做数据治理时,需要先区分两种情况。
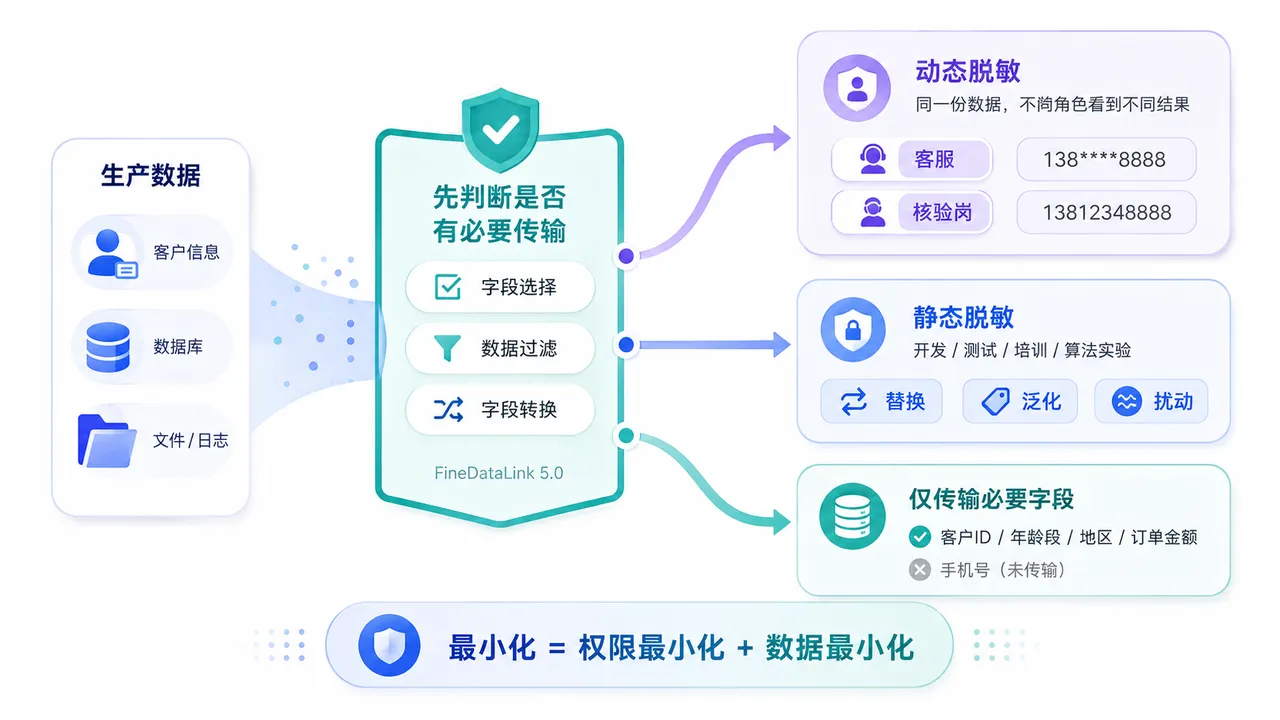
动态脱敏
底层仍然保存真实数据,但不同人在查询时看到不同结果。例如客服看到:138**8888,而经过授权的客户身份核验岗位可以查看完整手机号。所以动态脱敏解决的是:同一份数据,不同角色应该看到多少。**
静态脱敏
另外一种情况发生在:开发、测试、培训、算法实验等非生产环境。 这些场景通常需要数据结构和分布,却不一定需要真实身份信息。
例如测试人员需要知道手机号字段长度是不是11位,但完全没有必要知道客户真实手机号。这时候就可以在数据复制之前完成替换、泛化或者扰动。这里有一个非常重要的顺序:先判断这个字段有没有必要传输,再判断怎么脱敏。
假设下游只需要:客户ID、年龄段、地区、订单金额。那么手机号根本没有必要同步过去。此时最安全的脱敏方式不是:把13812345678改成138**5678,
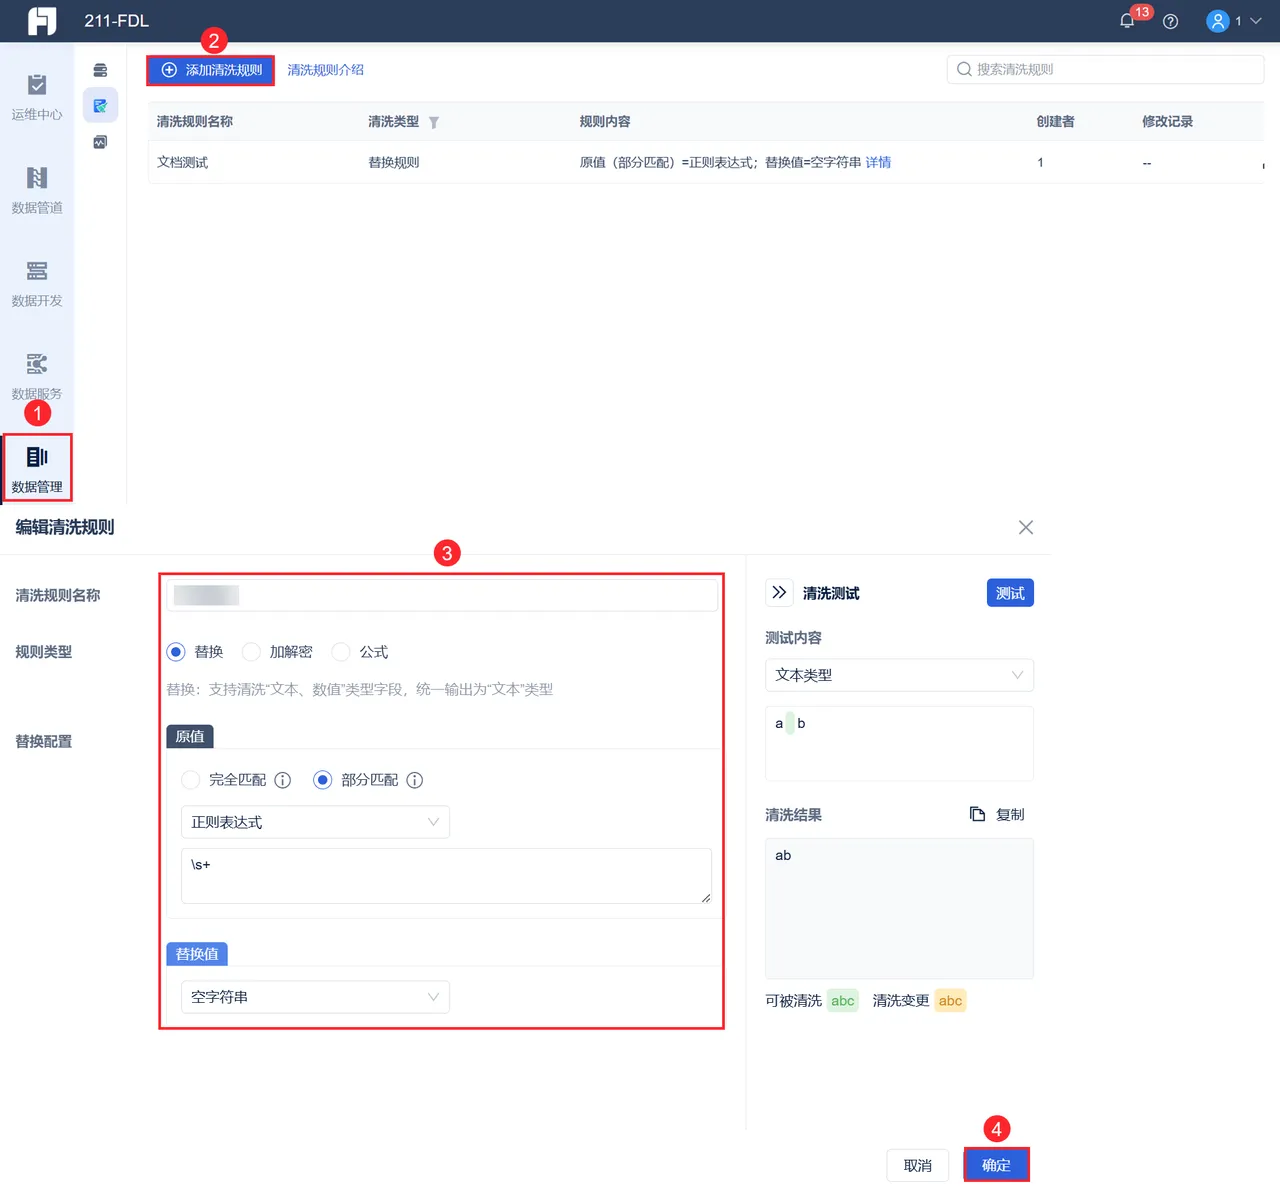
而是:这个字段根本不进入下游。 如果数据本身从生产库进入数仓或测试环境,就可以把这种思路直接放进数据处理链路。
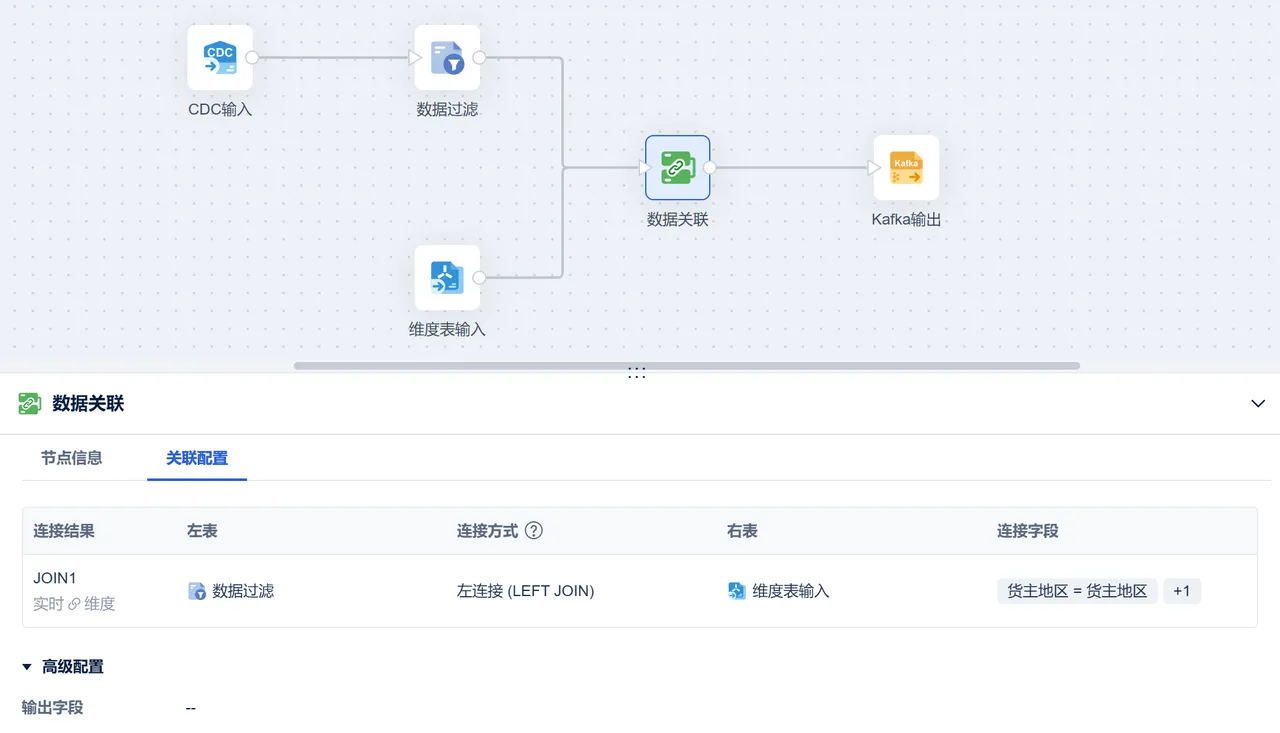
例如利用字段设置控制输出字段,通过数据过滤控制进入下游的数据范围;需要进一步处理时,也可以在数据转换环节完成字段计算和转换。
这样安全规则不是等数据落到目标库以后再处理,而是在流转过程中就减少不必要的敏感数据暴露。这背后其实对应一个很重要的数据安全原则:最小化,不只是权限最小化,也包括数据最小化。
四、加密:解决的是数据被拿走以后还能不能读懂
脱敏和加密经常被放在一起讨论,但它们解决的完全不是一个问题。脱敏解决“给你看什么”; 加密解决“数据被非法拿到以后能不能直接看懂”。
一个银行账号,如果业务系统还需要正常扣款、结算,就不能直接把真实值永久变成:6222**1234。 真实值仍然需要保留,只是应该受到更严格保护。
通常需要考虑三层。传输加密,保护数据从A系统到B系统过程中的安全。 存储加密,降低磁盘、数据库文件或者备份泄露后的风险。 字段级加密,针对身份证号、银行卡号等高敏字段进一步保护。
这里还要特别区分一个概念:哈希不是加密。 加密通常存在密钥,并且在合法场景下可以解密;哈希更强调单向计算,常用于密码校验、完整性校验等场景。
因此不要看到“SHA256”就认为它可以用来代替所有数据加密。真正做数据链路建设时,加密还必须延伸到传输过程。
加密体系真正难的部分其实不是算法,而是:密钥管理。 谁能拿到密钥?密钥多久轮换?离职人员的权限是否及时撤销?密钥和密文是否被放在同一个地方?如果密钥、账号和密文始终放在同一套权限体系里,那么再强的算法也可能因为管理问题失效。
五、权限控制:不要只问“能不能访问”,还要问“能访问到什么程度”
现实中的数据泄露并不一定来自外部攻击。非常常见的一种情况是:账号本身就是合法的,只是权限给得太大。
例如一个开发人员只需要同步订单表中的:订单号、时间、商品、金额。为了省事,却直接获得了整个生产数据库的查询权限。
结果他同时可以看到:姓名、身份证号、手机号、地址、银行卡信息。系统没有被攻破,但安全边界已经失效。因此权限控制首先要遵循:最小权限原则。
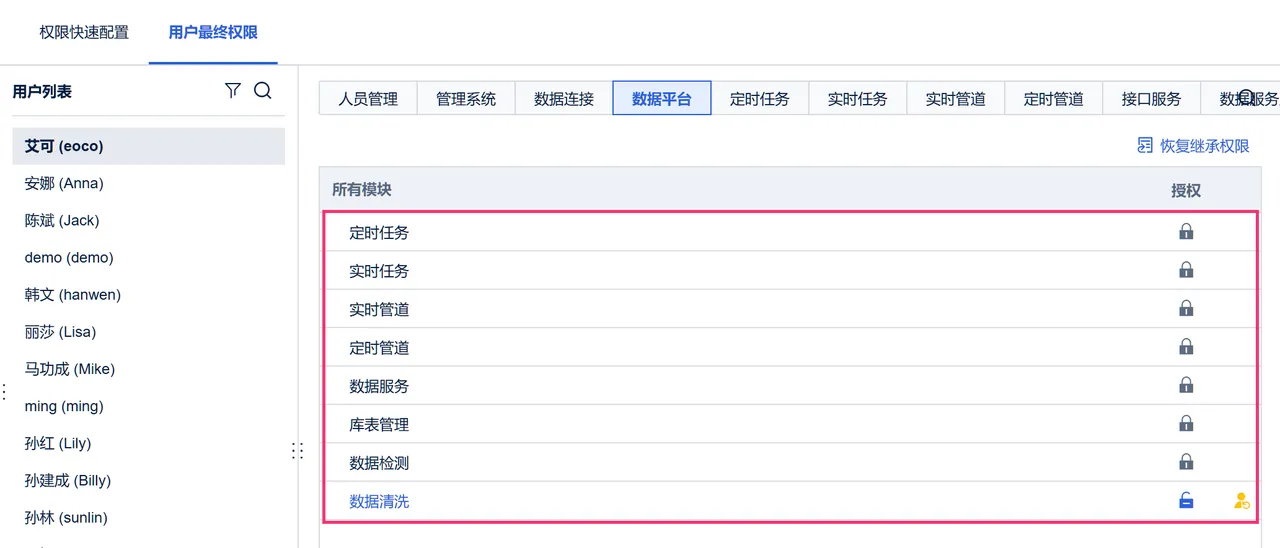
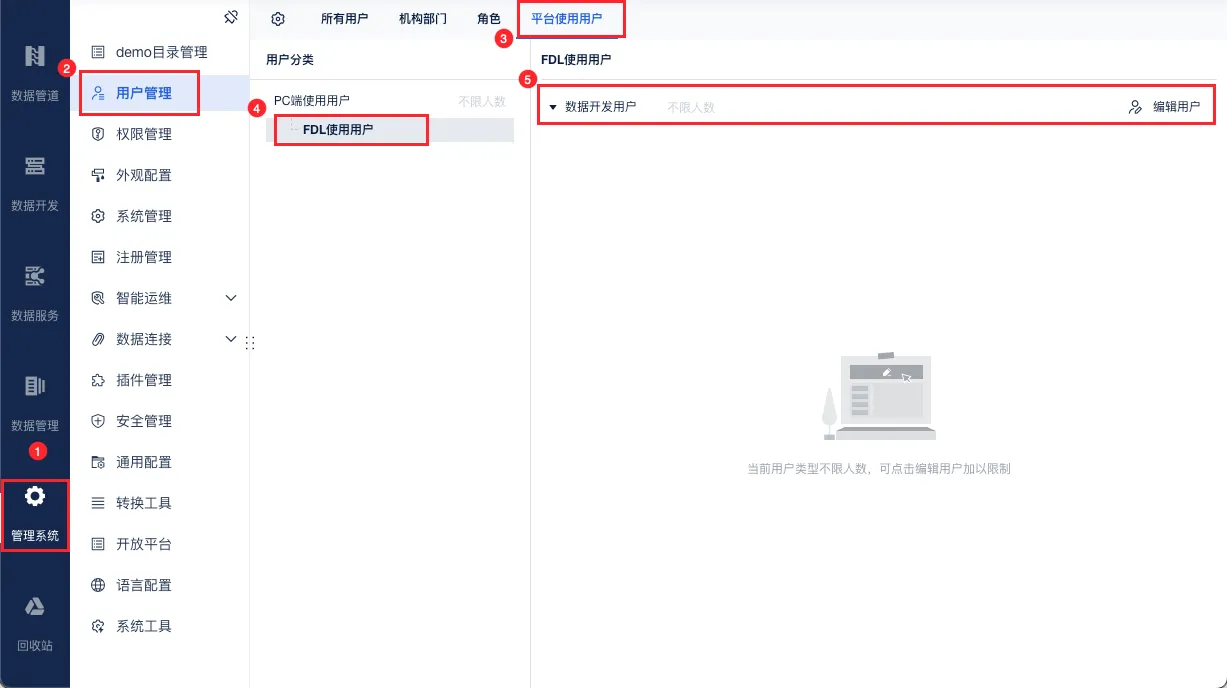
进一步还可以拆成几个层次:系统权限:能不能进入平台;资源权限:能不能访问某个数据连接或任务;数据权限:能看到哪些表、字段和数据行;操作权限:只能查询,还是能够修改、删除、导出;授权权限:能不能继续把权限授予别人。
很多企业主要使用RBAC,也就是按照角色授权。但数据安全进一步精细化以后,还需要考虑更多上下文:部门、岗位、数据等级、访问时间、使用场景等。
例如同样是财务人员,总部财务可以查看集团数据,区域财务只能查看本区域;同一个员工在日常分析时只能看脱敏数据,但进入经过审批的专项核查任务后,可以临时获得完整字段权限。
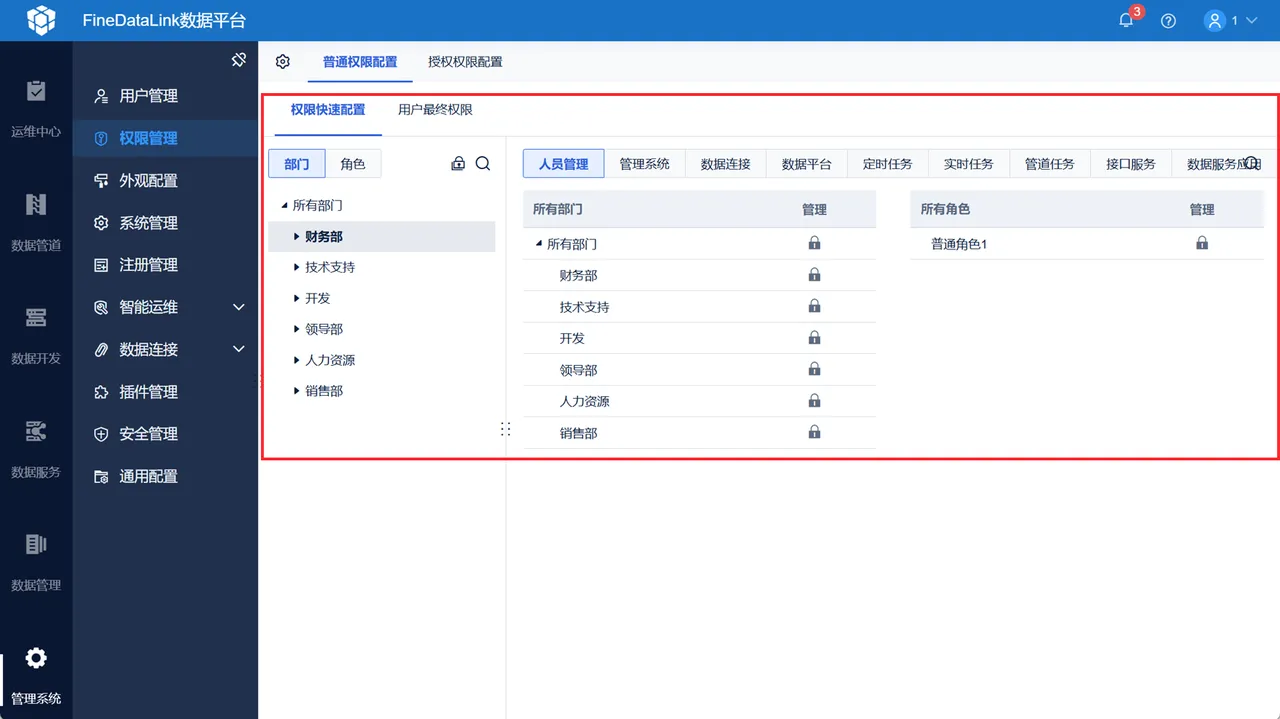
如果把这套思路放到数据集成平台里,重点就不仅是“谁能登录”,还包括谁可以使用某个数据连接、谁能管理任务、谁拥有授权能力。平台支持围绕用户、角色、部门以及数据连接、任务等资源配置不同权限,同时可以通过平台日志追踪用户行为和管理操作。最终要做到的是:权限可申请、可审批、可回收、可追溯。 而不是权限一旦给出去,就永久存在。
六、真正的安全,要一直管到数据被删除
很多企业的数据安全体系最后还有一个漏洞:只管生产系统,不管数据副本。 一条客户记录可能经历:采集 → 生产系统 → 数仓 → 报表 → API → Excel → 邮件 → 本地电脑。
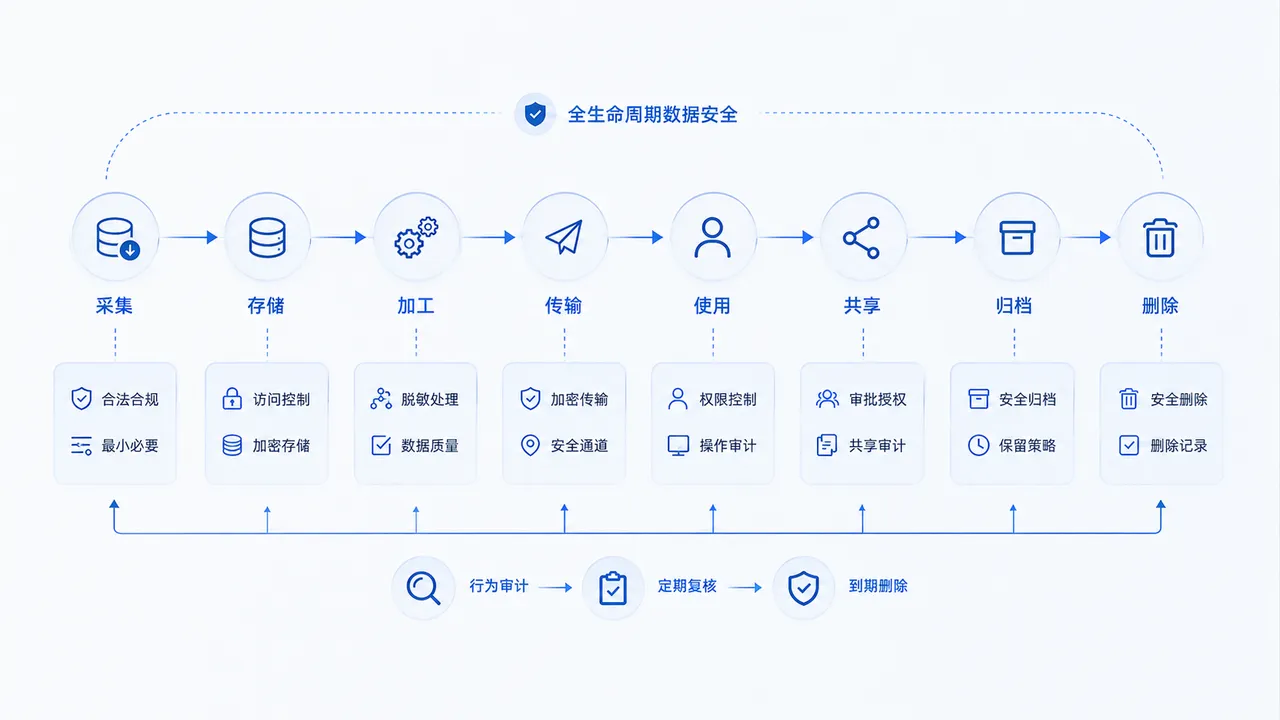
最初数据库里的数据保护得非常严格,但到了最后,可能已经变成一份几十万行的Excel文件。因此真正的数据安全必须覆盖整个生命周期:采集、存储、加工、传输、使用、共享、归档、删除。
每个阶段都应该重新问几个问题:这份数据还有必要存在吗?谁还需要访问?是否产生了新的副本?使用目的是否发生变化?权限是否应该重新评估?
尤其要警惕三个地方:测试环境、文件导出和临时数据。 很多敏感数据并不是从核心生产库泄露,而是从这些“安全等级较低的副本”流出去的。
所以成熟的数据保护最终应该形成一套闭环:敏感数据发现 → 分类分级 → 策略配置 → 数据使用 → 行为审计 → 定期复核 → 到期删除。 只有这样,企业管理的才不再是某几个敏感字段,而是:敏感数据从产生到消亡的整个生命周期。
写在最后
敏感数据保护并不是简单地把所有数据锁起来。真正成熟的安全体系,反而要回答:哪些数据可以正常流动,哪些数据必须受到约束。
可以把整套逻辑记成五句话:分类解决“数据是什么”;分级解决“数据有多重要”;脱敏解决“应该看到多少”;加密解决“数据被拿到后能不能读懂”;权限解决“谁在什么情况下可以使用”。再加上最后一层:持续追踪数据去了哪里。
只有当这些能力真正进入数据采集、同步、加工、分析、共享和删除全过程以后,企业的数据安全才不再是一堆孤立的安全功能。而会变成一套真正能够执行、审计和持续运营的:数据安全治理体系。