聊AR的时候,大家关注的是模型好不好看、定位准不准、交互炫不炫。但这些东西能不能成立,底层取决于一件事:我们能不能用一套数学语言,把"物体在空间中的位置和朝向"这件事描述清楚,并且能计算。
这套语言就是线性代数。具体来说,是向量空间、矩阵变换和齐次坐标这三样东西。它们不直接出现在产品界面里,但AR系统里每一帧的渲染、每一次的定位解算,都在用这套语言做运算。
本文不绑定任何具体框架,只聊这套语言本身——它是怎么描述空间的,为什么矩阵乘法能描述刚体运动,以及为什么"齐次坐标"这个看起来很绕的概念其实是让一切变简洁的关键。
1. 空间里的点、向量和"参照系"
1.1 点和向量是两种东西
在三维空间里,一个点表示一个位置,一个向量表示一个有方向和大小的量。在坐标表示上,它们都是三个数 (x, y, z),但含义不同。
点描述的是"在哪",向量描述的是"往哪走、走多远"。点的坐标依赖于参照系——同一个物理位置,在不同坐标系里坐标值不同。向量的坐标则只依赖于坐标轴的方向和尺度,原点在哪不影响向量。
这个区别在AR里很关键。相机的位置是一个点,物体的位移是一个向量。你可以移动坐标系原点改变一个点的坐标,但不会改变一个位移向量的值。
1.2 坐标系就是一组"基"
什么叫坐标系?本质上就是选定了原点,再选三个方向作为X、Y、Z轴,再确定每个轴的度量单位。这三根轴的方向,构成了这个坐标系的基向量。
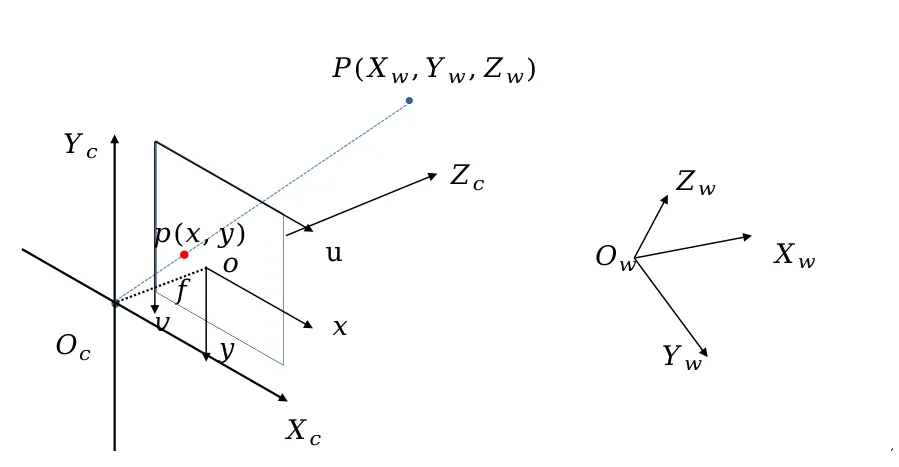
同一个物理空间里,可以定义无数个坐标系。相机有自己的坐标系,物体有自己的坐标系,整个世界场景还有一个世界坐标系。AR系统要做的第一件事,就是搞清楚这些坐标系之间的转换关系。
从坐标系A到坐标系B的转换,可以分解为一次旋转和一次平移——先把A的坐标轴旋转到和B一致,再把A的原点平移到B的原点。
2. 旋转的数学表示:为什么是矩阵
2.1 旋转矩阵的构造
要把一个向量绕某个轴旋转一定角度,可以用一个3×3的矩阵乘以这个向量来实现。这个矩阵就是旋转矩阵。
以绕Z轴旋转θ角为例,旋转矩阵长这样:
Rz(θ) = [cosθ  -sinθ  0]
        [sinθ   cosθ  0]
        [0      0     1]
这个矩阵作用在一个向量上,X和Y分量会旋转,Z分量不变——因为旋转轴就是Z轴。绕X轴和Y轴的旋转矩阵形式类似,只是被作用的分量和不变的分量不同。
三维空间中的任意旋转,都可以分解为绕三个坐标轴的旋转组合。但要注意,旋转的顺序会影响最终结果——先绕X再绕Y,和先绕Y再绕X,得到的结果通常不一样。这也是为什么姿态的表示和插值在AR里是个需要小心处理的问题。
2.2 旋转矩阵的两个关键性质
旋转矩阵不是随便一个3×3矩阵都行,它必须满足两个条件:
正交性:R的转置等于R的逆,即 RᵀR = I。这意味着旋转不改变向量的长度,也不改变向量之间的夹角。一个物体旋转之后,形状不变、大小不变,只是朝向变了。
行列式为1:det(R) = 1。这个条件排除了"镜像"——反射也能保持长度不变,但它会把左手系变成右手系,不是刚体旋转。
这两个约束意味着:旋转矩阵虽然有9个元素,但真正独立的自由度只有3个。9个数字里藏着6个约束,实际只需要3个参数就能确定一个旋转。但用3个参数(比如欧拉角)表示旋转会有"万向节死锁"的问题,所以在计算中通常保留9个元素的矩阵形式,把约束交给数学工具去维护。
2.3 旋转矩阵的复合
两个旋转叠加,在数学上就是两个旋转矩阵相乘。如果先做旋转R₁,再做旋转R₂,总效果是 R₂R₁。注意顺序:矩阵乘法不满足交换律,R₂R₁ 和 R₁R₂ 通常不相等。
这个性质在AR里很重要。比如一个物体先绕自身轴旋转,再跟随相机转动,和先跟随相机转动再绕自身轴旋转,最终姿态完全不同。理解矩阵乘法的非交换性,是理解空间变换链条的基础。
3. 平移与齐次坐标:为什么需要四维
3.1 平移不能写成3×3矩阵乘法
旋转可以用3×3矩阵乘法表示,但平移不行。平移是"加上一个向量",不是"乘以一个矩阵"。如果你想把旋转和平移统一成一种操作,就会遇到麻烦:旋转是乘法,平移是加法,两者没法合并。
3.2 齐次坐标的解法
齐次坐标的思路是:把三维点 (x, y, z) 扩展成四维 (x, y, z, 1),把平移向量 t 塞进矩阵的最后一列,构造一个4×4的变换矩阵:
T = [R  t]
    [0  1]
其中R是3×3旋转矩阵,t是3×1平移向量,左下角的0是1×3零向量,右下角是1。
用这个4×4矩阵乘以四维齐次坐标 [x, y, z, 1]ᵀ,得到的结果前三维是 Rx + t,正好就是"先旋转再平移"的结果。平移被"藏"进了矩阵乘法里。
齐次坐标还有一个附带的好处:它可以统一表示"点"和"方向"。四维坐标的最后一个分量如果是1,表示一个点;如果是0,表示一个方向向量。方向向量不受平移影响——这符合直觉:平移一个坐标系,方向向量不会变。
4. 坐标系层级:AR里的变换链
4.1 世界、相机、物体、屏幕
AR系统里通常有四个层级的坐标系:
世界坐标系:整个场景的全局参照系。所有物体的位置最终都要转换到这个世界坐标系下描述。
物体坐标系:每个物体有自己的局部坐标系,方便独立建模和操控。一个桌子在它自己的坐标系里,原点可能在桌面中心。
相机坐标系:以相机光心为原点,Z轴指向拍摄方向。SLAM解算出的位姿,就是相机在世界坐标系下的位置和朝向。
屏幕坐标系:二维图像平面上的像素坐标。渲染的最终输出落在这里。
4.2 变换链
从物体坐标系到屏幕坐标系,要经过一串变换:
物体坐标 →(模型矩阵)→ 世界坐标 →(视图矩阵)→ 相机坐标 →(投影矩阵)→ 裁剪空间 →(视口变换)→ 屏幕坐标
这一串矩阵乘法,就是渲染管线里顶点着色器做的事。每一级变换都有明确的几何含义,搞清楚每一级在做什么,是理解3D渲染的基础。
在AR里,这条链还多了一层:相机在世界坐标系下的位姿不是预设的,而是由SLAM/VPS实时解算出来的。视图矩阵的来源不同——传统3D渲染里相机位姿是手动设定的,AR里是算法估计的。
5. 矩阵分解:从一个矩阵里读出旋转和平移
给你一个4×4变换矩阵,你能不能从中提取出旋转R和平移t?可以。平移t直接就是矩阵的最后一列前三行。旋转R就是左上角的3×3块。
但如果这个矩阵是从实际数据中估计出来的(比如从点云配准中算出来的),它可能不严格满足旋转矩阵的正交性约束。这时候需要做正交化——把估计出的3×3块投影到最近的合法旋转矩阵上。常用的方法是SVD分解:对3×3块做奇异值分解,把奇异值全部置为1,再乘回去,就得到了最近的正交矩阵。
这个操作在SLAM和VPS的后端优化里经常用到——每次迭代更新完位姿之后,要确保旋转部分仍然是一个合法的旋转矩阵。
6. 为什么这些在AR里重要
回到AR本身。每一帧渲染,GPU要做的事就是:把场景里每个物体的顶点,从物体坐标系一路变换到屏幕坐标系。这一路上用的全是矩阵乘法——模型矩阵、视图矩阵、投影矩阵。
每一次定位解算,SLAM/VPS要做的事就是:估计相机在世界坐标系下的旋转和平移。估计的结果就是一个4×4变换矩阵。
每一次虚实融合,系统要做的事就是:确保虚拟物体的变换矩阵和真实相机的变换矩阵在同一套坐标系下对齐。
这些操作的正确性,完全依赖于对线性代数和几何变换的理解。矩阵乘法的顺序搞错了,虚拟物体就会跑到错误的位置;齐次坐标的最后一个分量搞错了,点会被当成方向向量处理;旋转矩阵的约束没有维护,优化迭代会发散。
这些不是"底层细节",而是AR系统能不能跑通的根本问题。
7. 小结
线性代数给AR提供了一套描述空间的精确语言。向量和点区分了"位置"和"位移",旋转矩阵用正交性和行列式为1这两个约束描述了刚体旋转,齐次坐标把旋转和平移统一成了矩阵乘法,坐标系层级和变换链则定义了从物体到屏幕的完整路径。
这些概念单独看都是教科书上的内容,但在AR系统里,它们组合在一起,构成了从"空间中的位置"到"屏幕上的像素"的完整数学链路。
参考
Hartley, R., & Zisserman, A. Multiple View Geometry in Computer Vision. Cambridge University Press, 2004.
Strang, G. Introduction to Linear Algebra. Wellesley-Cambridge Press, 2016.