
当一个开源库很久没更新了,你的项目还在用它。
依赖版本越来越旧,安全问题没人修,社区里有人提了补丁,等了很久也没有回应。你翻了翻代码,觉得核心功能并不复杂,于是冒出一个念头:要不自己重写一个,顺便兼容一下原来的接口?
这个想法很合理。我做数据采集,经常要把各种解析、请求和调度组件拼在一起,对这种处境并不陌生——一个依赖平时安安静静,真到了要换的时候,才发现业务代码里到处都有它的影子。
只不过,重写完成的那一刻,事情通常才做了一半。
你的代码也许能跑,用户也许也确实需要一个还在维护的版本。可他们凭什么相信新项目不会过几个月也停下来?原项目的维护者没有回复,是否意味着你可以去它的每个 issue 下面贴链接?你说的“兼容”,到底是换个包名就能用,还是只兼容了文档首页那几个例子?
这些问题,编译器帮不上忙。
先别急着重写
我习惯先把几条路分开看。它们都能产生一个“新项目”,成本却完全不同。
第一条是 fork。 从原项目的代码继续改,保留现有实现和历史,再修复问题、更新依赖。它适合原来的架构还能用,你需要的是有人继续维护,而不是推倒重来。
fork 不代表许可证就不用管了。原项目是什么许可证、要求保留哪些版权声明和许可文本、修改后如何分发,都要按对应条款处理。许可证不清楚的时候,别先复制代码、发布完再研究。
第二条是重写。 不沿用原项目的具体实现,重新设计内部代码,可能是为了摆脱难以维护的架构,也可能是为了支持新的运行环境。
重写可以做得更干净,代价是原代码里那些多年积累的边界处理,也得重新找回来。输入为空怎么办?异常类型是什么?超时会不会重试?这类东西不一定写在文档里,用户却可能早就依赖上了。
这里也得说清楚:重写不自动解决所有法律问题。是否涉及代码、文档、测试数据或其他受保护内容,以及项目名称和商标能怎么用,都要具体看。拿不准就先核对许可证和相关权利,必要时找专业人士,别把“我重新写了一遍”当成万能答案。
第三条是做替代品。 它解决的是同一类问题,但不承诺接口一致。用户需要改调用方式,换来的可能是更合适的设计。
第四条是兼容层。 让旧接口继续存在,内部转到新实现上。它可以是 fork 或重写项目的一部分,也可以单独存在。
兼容层听着像一层薄薄的转接代码,维护起来未必薄。旧接口里那些不太优雅、甚至有点别扭的行为,可能正是用户的业务依赖。你觉得应该修掉的东西,对别人来说可能是一次破坏性变更。
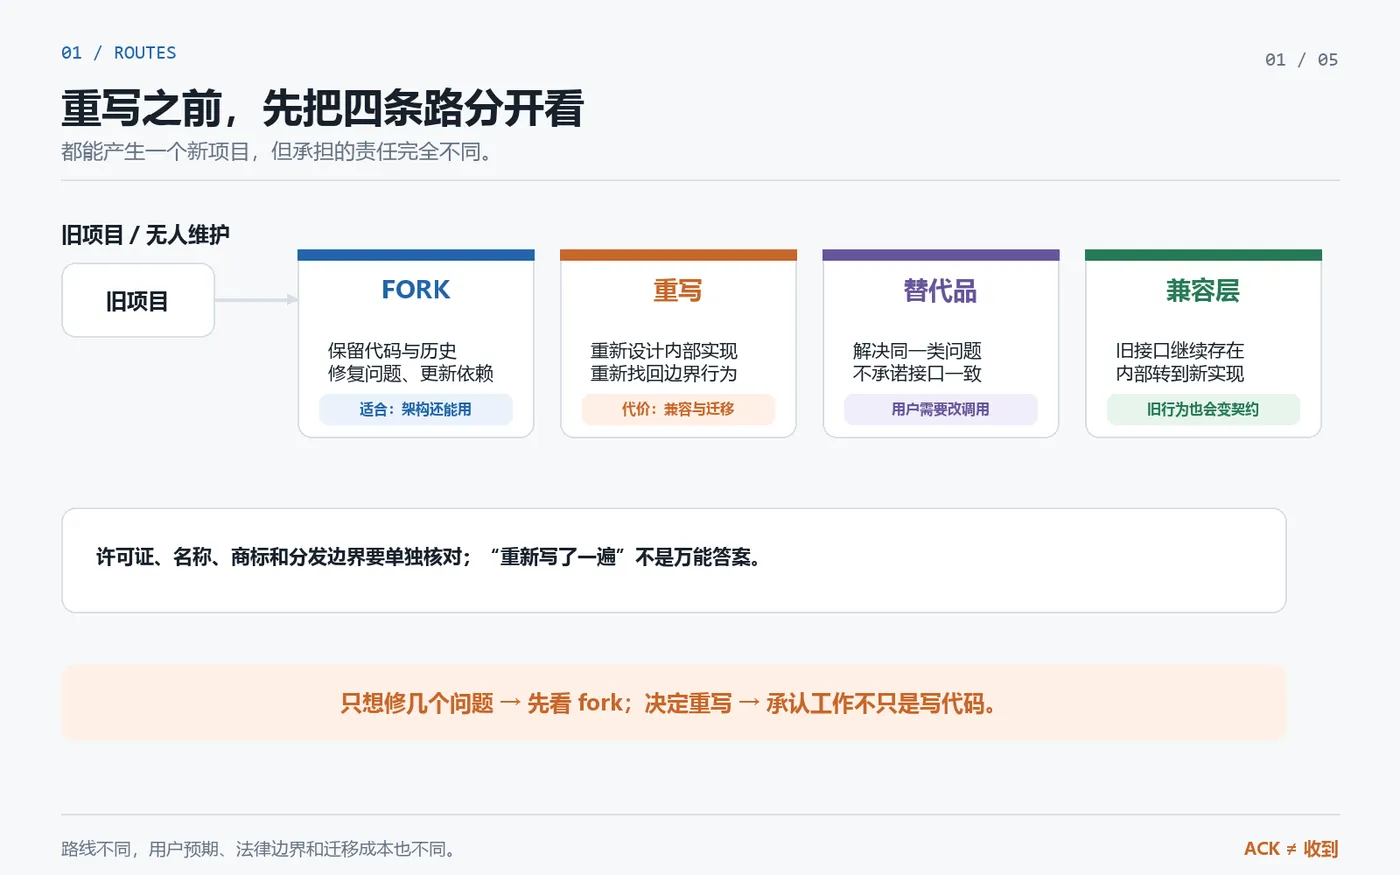
所以我的判断很简单:如果你只是想修几个问题,先看 fork 够不够;如果决定重写,先承认自己接下来的工作不只是写代码。
“兼容”两个字,得往细了说
假设原来的库叫 oldlib,你写了个 newlib。下面这段代码能跑:
from newlib import Client

client = Client(token="example")
client.fetch("item-1")
这只能说明一个最基本的调用跑通了。实际迁移时,用户可能还关心:
- 返回值里缺失的字段,是不存在,还是返回
None? - 请求超时抛什么异常?原来的异常捕获还能不能生效?
- 默认超时时间、重试次数、编码方式有没有变化?
- 多线程调用、异步调用、连接关闭的行为是否一致?
- 日志里会不会多出敏感信息?配置项的默认值有没有变?
最后一个问题尤其容易被忽略。接口名字一样,不代表运行行为一样。你把默认重试改得更积极,开发环境看不出什么,放到采集任务里,目标服务收到的请求量可能就变了。
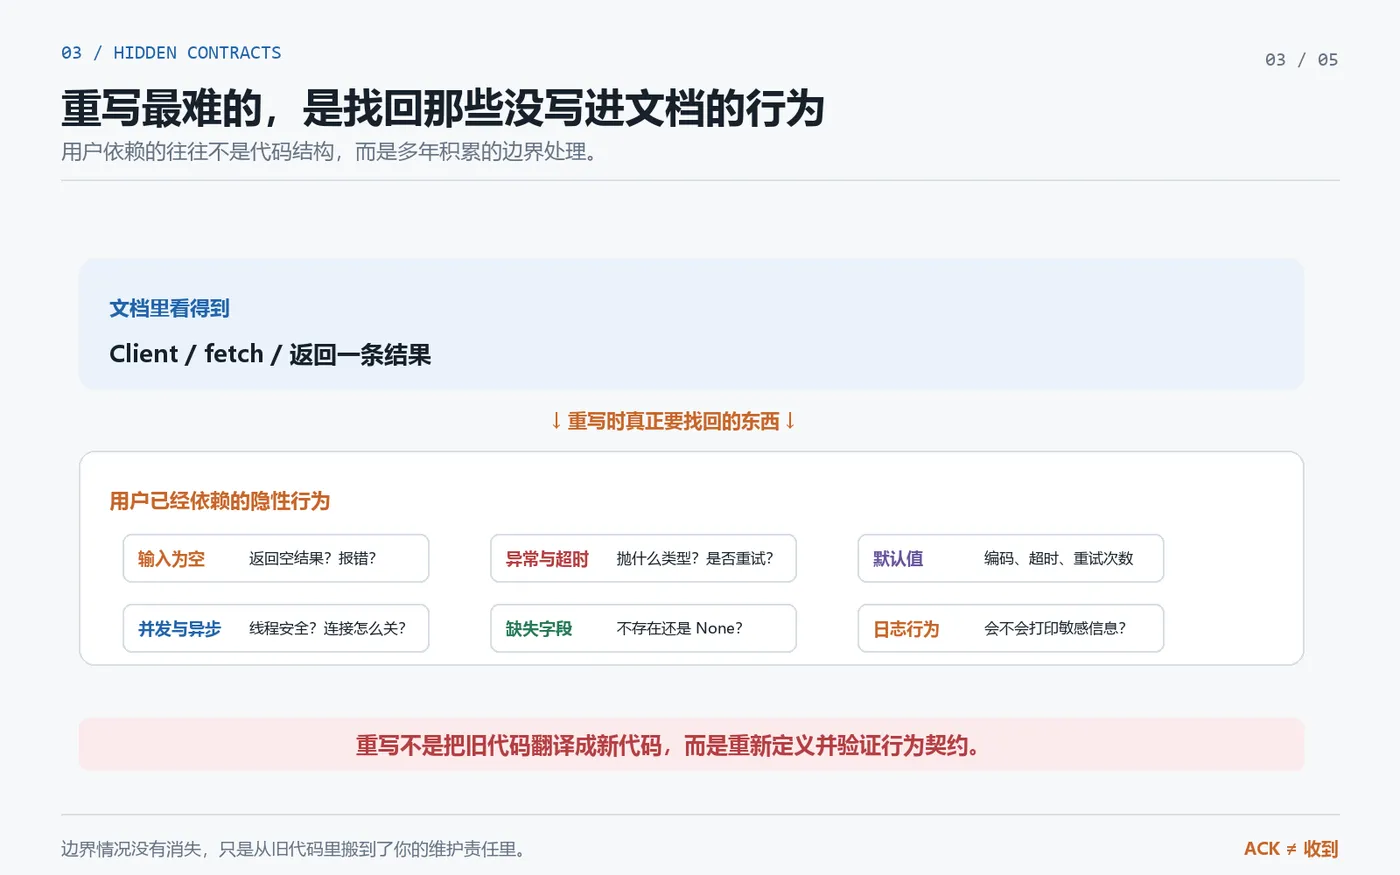
我会把兼容性写成一份具体清单,而不是在首页放一句“完全兼容”。清单里至少标出:对照的是原项目哪个版本;覆盖了哪些公开接口;哪些行为有意修改;哪些情况还没测过。
测试也别只测“正常返回”。拿原项目公开的使用示例、在允许使用的前提下参考其测试用例,再加上真实调用中常见的异常输入,分别跑旧版本和新版本,对比结果。能自动化就自动化;暂时测不到的场景,就老老实实写“未验证”。
还有一点得补上:原项目本身有缺陷时,新版本不一定要原样保留。关键是让用户知道你改了什么,以及这个变化会不会影响现有代码。兼容不是把所有旧行为供起来,而是不让用户在不知情的情况下承担变化。
去原项目的 issue 里说一声,算不算截流?
这事儿没法只靠一句“开源精神”判断。
如果有人在一个具体 issue 里问“这个问题还有解决办法吗”,你恰好做出了修复,留一条相关回复,说明你的方案、适用范围和链接,我认为是可以理解的。这个回复首先应该回答问题,链接是补充,不是整段话的目的。
比如可以这么说:
我遇到了相同的问题。原项目在这个版本下会出现上述报错;我维护了一个独立版本,目前针对这个问题做了修复。它不是原项目的官方续作,接口兼容范围也还有限。如果你愿意尝试,可以先看修复说明和迁移注意事项:[链接]。
这里有几个细节:
第一,说清楚关系。是 fork、独立重写,还是兼容层,就写明白。原维护者没有授权,不要暗示自己接手了官方项目。
第二,只在相关讨论里回复。一个问题一条有信息量的答复,和在几十个 issue 下面复制同一段推广文案,是两回事。
第三,不要替原项目盖棺定论。很久没有提交,不必然意味着作者放弃;维护者没有回你的邮件,也不等于同意你代表他们发声。你可以写“截至某个日期,我没有看到新的维护回复”,别直接写“作者已经不管了”。
第四,接受社区规则和他人的边界。如果仓库规则不欢迎推广,或者维护者明确要求不要继续发,就停下来。自己的发布文章、技术社区里合适的讨论区、项目文档,都可以作为介绍新项目的地方,没必要占着别人的工单区做宣传。
顺便说一句,原项目的名字也容易出问题。新项目最好用有区分度的名称,在说明里写“兼容某项目的特定版本”,而不是让人误以为这是官方更新。包名、组织名、标识和项目介绍都应避免造成混淆;涉及商标时,还要单独核对相关规则。
你不需要把自己藏起来,但也不能让用户猜测你和原作者是什么关系。
迁移不是让用户改一行 import
我更愿意把迁移看成一份需要交付给用户的操作说明,而不是一句“直接替换即可”。
发布前,先选定一个明确的参照版本。原项目版本之间可能已经有差异,你说“兼容原项目”,用户没法判断自己手里的版本算不算在范围内。
然后准备一份迁移文档,至少讲清楚三件事:安装和配置怎么改;接口、默认值、异常和行为有哪些差异;如果切换后发现问题,怎么回退。
回退这条别省。
依赖迁移经常不是单个开发者能拍板的事。线上服务、定时任务、数据处理作业可能共用一个库,出了问题要能快速切回原来锁定的版本。要是新版本还会改写缓存、配置文件或持久化数据,那就把格式变化、备份方式和回退限制单独写出来。代码可以回退,不代表数据状态也能自动回退。
验证时,我建议先用测试环境和脱敏样本跑,再挑一小部分低风险任务试用,对照旧版本检查输出、异常、耗时和资源消耗。涉及真实外部请求的,不要为了“双跑对比”就直接把生产请求复制一遍——重复请求可能触发写入、计费或给对方服务增加负担。
观察期里发现差异,先判断它是缺陷、预期变更,还是原项目本来没有明确保证过的行为。这个分类不只是给维护者看,也方便用户决定自己能不能接受。
发布之后,承诺要比功能少一点
一个新项目上线时,最容易写下的承诺是“长期维护”“完全兼容”“稳定可靠”。
我对这几句话都比较谨慎。
更有用的是说清楚眼下能做到什么:谁在维护,目前支持哪些运行环境,安全问题往哪里报告,已知缺陷有哪些,预计怎么处理不兼容变更。如果只有一个人维护,也可以直接说。一个边界清楚的个人项目,未必比一份写得很满的承诺差。
安全报告渠道最好单独设。不要要求用户把漏洞细节直接贴到公开 issue;如果暂时没有能力提供固定响应时间,也别编一个。收到报告后如何确认、修复和公开披露,可以写出原则,再根据实际情况处理。
版本策略同样要提前交代。哪些接口算稳定,哪些还在试验,什么时候可能删除兼容层,发布破坏性变更时会怎样提醒——这些东西看起来没有新功能亮眼,却决定了别人敢不敢把你放进依赖文件。
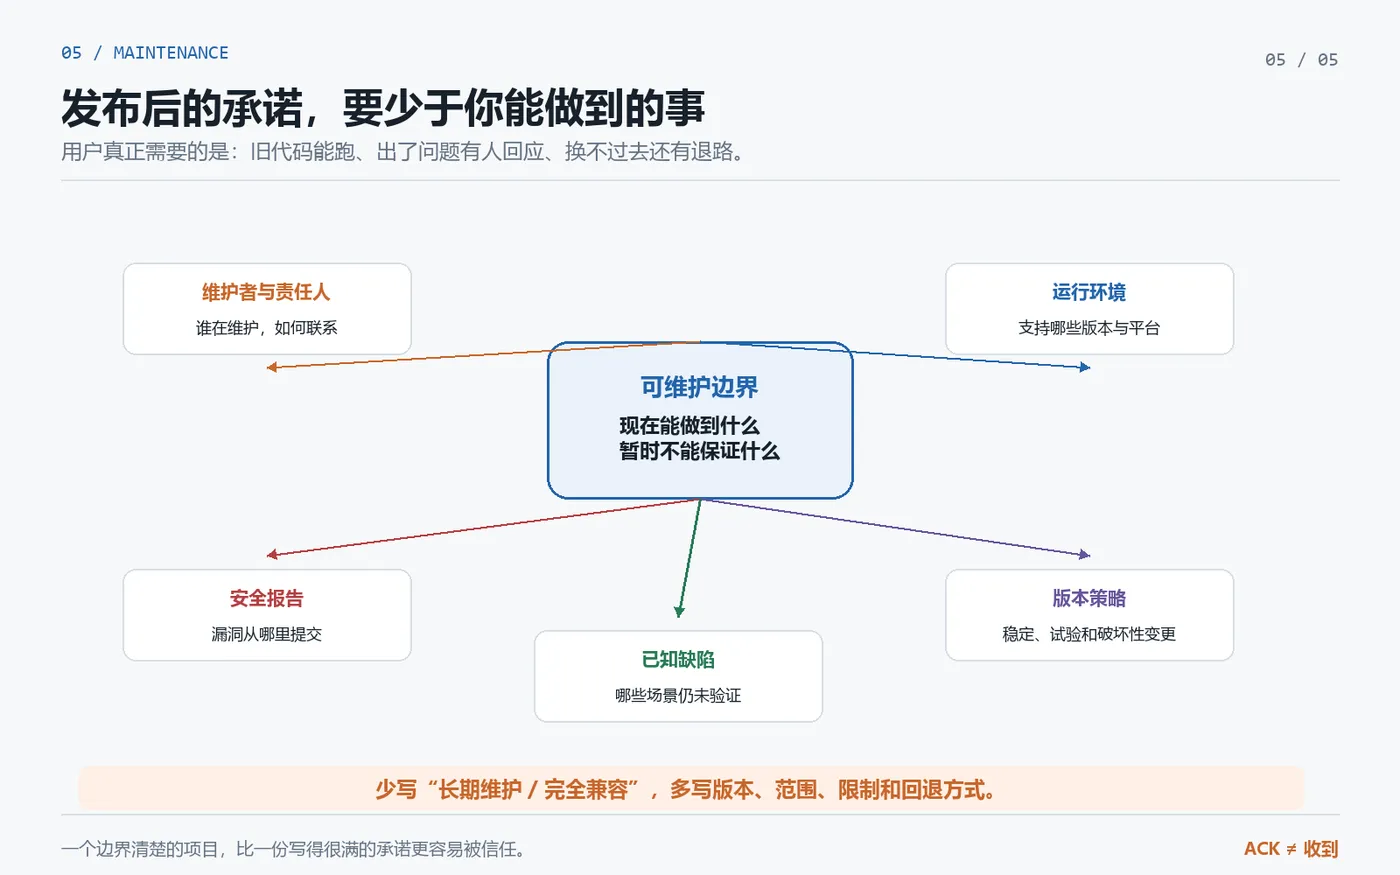
有时你最后会发现,用户真正需要的不是一个更漂亮的新库。他们需要的是旧代码下周还能运行,出了问题有人能说清楚,换不过去时还有路退。
这件事不浪漫,甚至有点琐碎。
但如果决定接住一个开源项目留下来的用户,这些琐碎就是维护工作的一部分。
