
摘要:上一篇讲清了数据源的种类与边界,这一篇全部落地。Kafka 订单流从订阅到限流的完整参数与首跑翻车记录;File 源日志入湖的原子写入管道与 maxFileAge 误读事故;Rate 源不用真上游压出 8 万行/秒的背压验证方法;foreachBatch 一托三(MySQL + Delta + 明细回流)的幂等骨架与批次重放对账。每个案例都是"约束 → 写法 → 翻车 → 修复"的完整闭环,抄代码之前先抄思路。
关键词:Structured Streaming, Kafka Source, File Source, Rate Source, foreachBatch, 数据源, 幂等写入, 背压, 生产案例
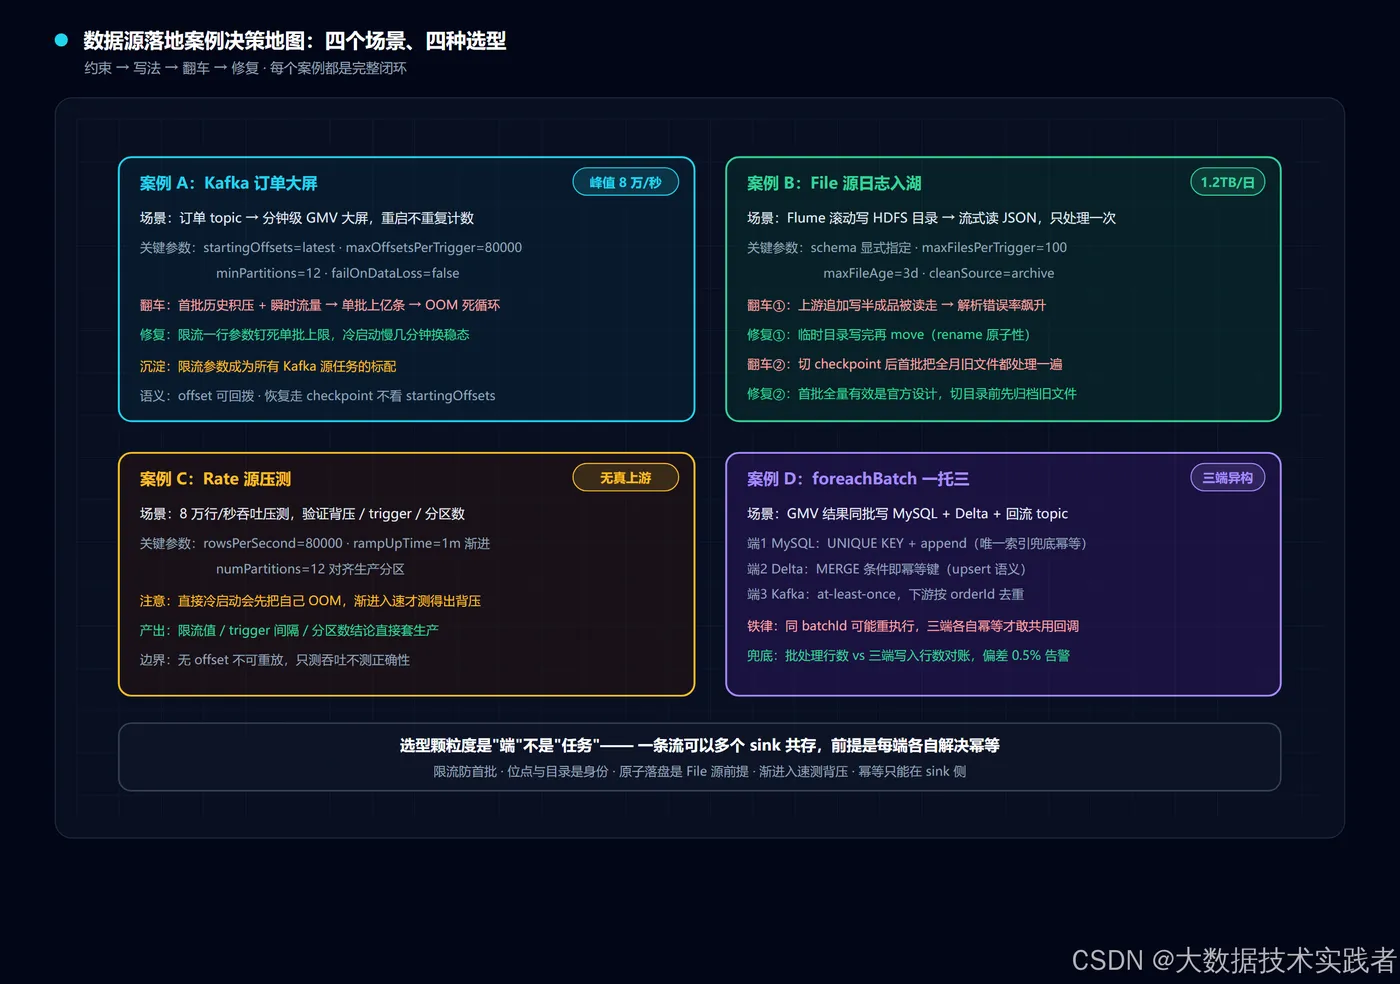
一、案例总览:四个场景、四种选型
四个案例覆盖了数据源选型的绝大多数路径:
| 案例 | 源 | 规模特征 | 核心难点 | 关键决策 |
|---|---|---|---|---|
| A 订单大屏 | Kafka | 峰值 8 万条/秒 | 首批积压打爆集群 | 限流 + latest 起始 |
| B 日志入湖 | File | 日增 1.2 TB | 重复消费与存储成本 | 原子落盘 + cleanSource |
| C 压测验证 | Rate | 造 8 万行/秒 | 无真上游验证背压 | Rate 源替代 Kafka |
| D 多端分发 | Kafka→三 sink | 结果三路消费 | 各端语义不同 | foreachBatch 一托三 |
二、案例 A:Kafka 订单流——从翻车到稳态
2.1 需求与约束
电商大屏,上游是订单事件 topic(12 分区、保留 7 天),要求端到端延迟 < 60 秒、重启不重复计数。
2.2 完整写法
val orders = spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092,broker2:9092")
  .option("subscribe", "order_events")          // ① 订阅
  .option("startingOffsets", "latest")          // ② 首跑从最新开始
  .option("maxOffsetsPerTrigger", "80000")      // ③ 限流:单批封顶
  .option("minPartitions", "12")                // ④ 对齐分区数
  .option("failOnDataLoss", "false")            // ⑤ 容忍极端场景
  .load()
  .select(
    from_json($"value".cast("string"), orderSchema).as("o"))
  .select($"o.orderId", $"o.amount", $"o.province", $"o.eventTime")
  .withWatermark("eventTime", "2 minutes")
五个参数各管一件事:① subscribe 支持正则匹配多 topic(subscribePattern),分场景选;② latest 只对新查询生效,恢复永远走 checkpoint——想改位点必须换 checkpoint 目录;③ 限流量按各分区积压量按比例分配,不是平均分;④ minPartitions 是提示值,用于分区数与并行度的对齐;⑤ 关掉严格失败前先确认丢失区间可离线补齐。
2.3 翻车与修复
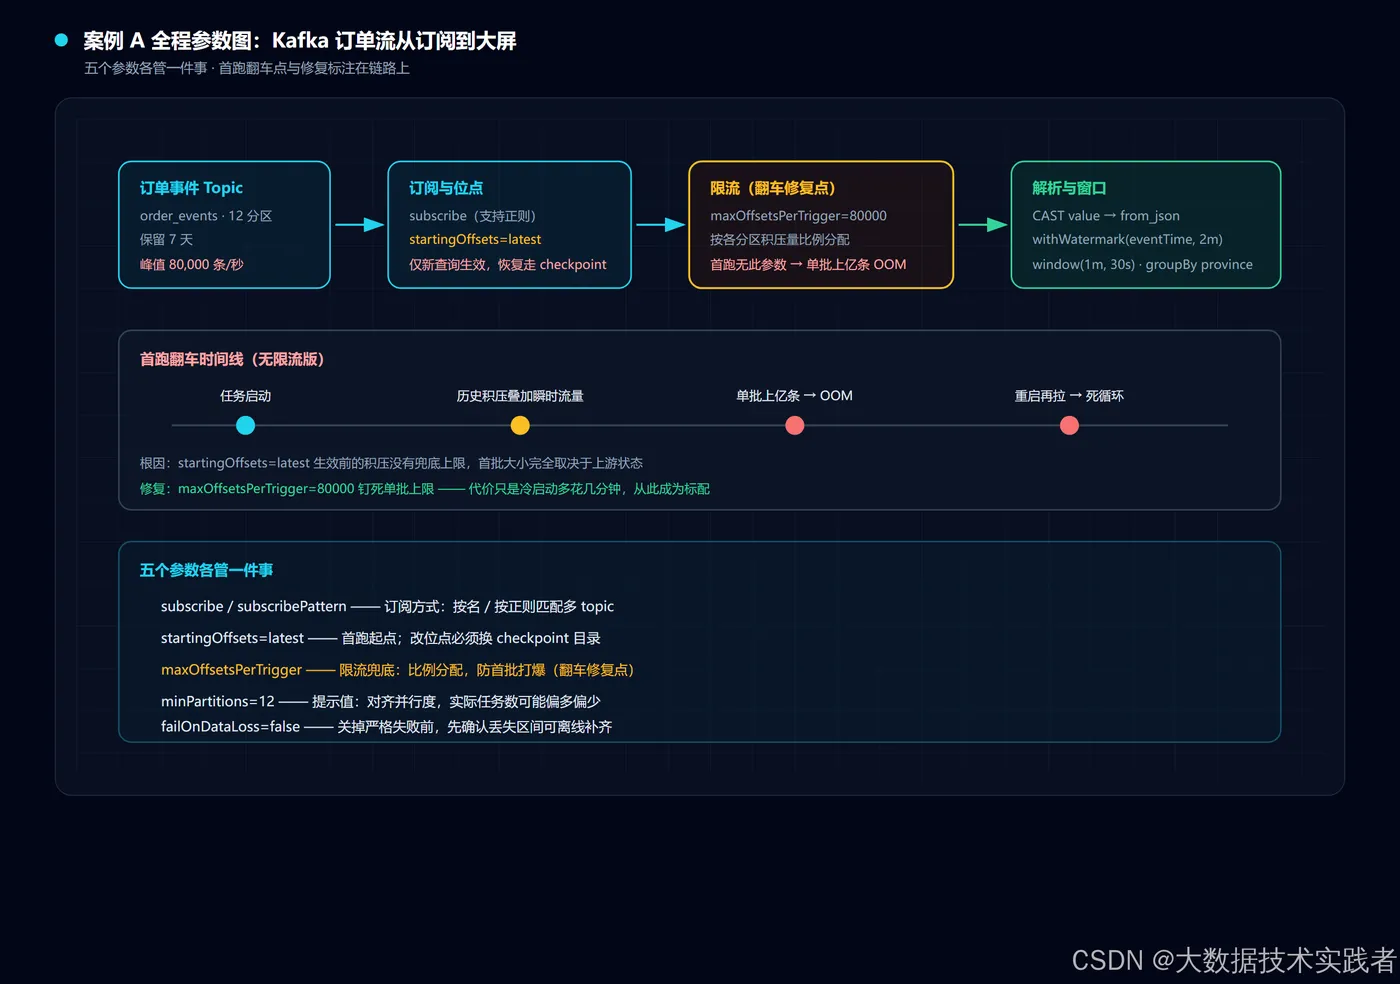
首跑当天翻车:startingOffsets=latest 生效前的历史积压叠加瞬时流量,单批拉进上亿条,Executor OOM 重启,重启又拉一次,死循环。根因是没有限流兜底。修复就是 ③ 那行——maxOffsetsPerTrigger=80000 把单批钉死,代价只是冷启动慢几分钟。这一行后来成了我们所有 Kafka 源任务的标配。
三、案例 B:File 源日志入湖——便宜的代价是纪律
3.1 需求与约束
服务日志每分钟由 Flume 滚动写到 HDFS 目录,单文件约 200 MB,日增 1.2 TB。要求只处理一次、存储成本可控。
3.2 完整写法
val logs = spark.readStream
  .format("json")                                // ① 目录即流
  .schema(logSchema)                             // ② 必须显式指定
  .option("path", "hdfs://nn:8020/logs/nginx")
  .option("maxFilesPerTrigger", "100")           // ③ 首批封顶
  .option("maxFileAge", "3 days")                // ④ 超龄忽略
  .option("cleanSource", "archive")              // ⑤ 处理完归档
  .option("sourceArchiveDir", "hdfs://nn:8020/logs/archive")
  .load()
① 支持五种格式(text/CSV/JSON/ORC/Parquet),目录按 glob 匹配;② 流式读不推 schema,不指定直接报错;③ 防止积压期首批打爆;④ 按"相对最新文件的时间戳"算,默认 7 天;⑤ 三档可选:off / delete / archive,归档目录不能是 path 的子目录,否则会被当成新文件反复处理。
3.3 两个纪律性坑
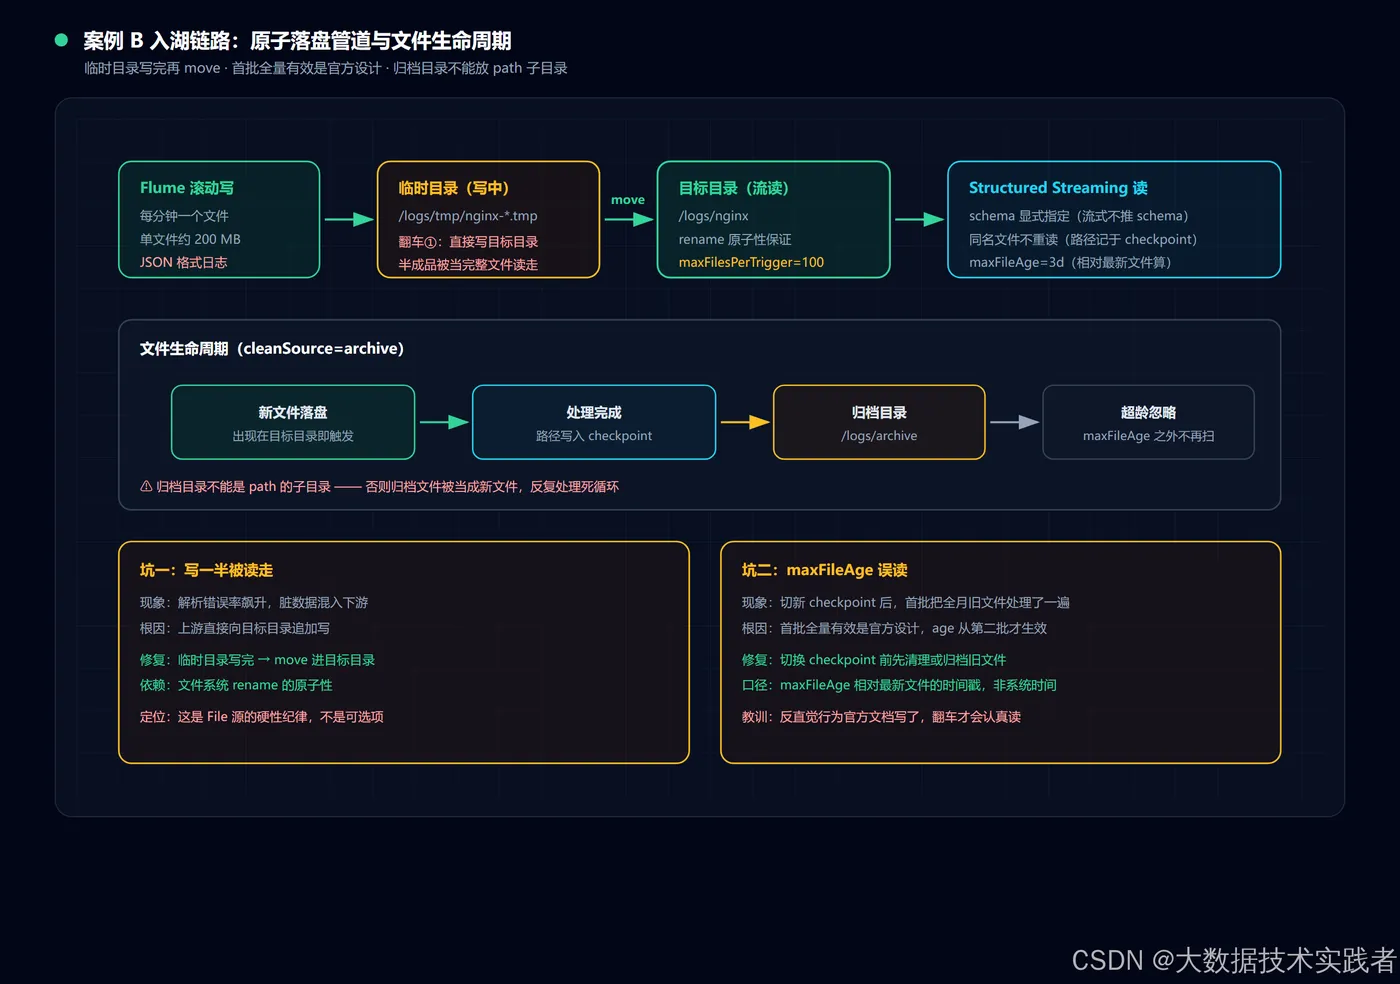
坑一:写一半的文件被读走。 早期上游直接往目标目录追加写,引擎把半成品当完整文件处理,解析错误率飙升。修复:上游改成"临时目录写完 → move 到目标目录",利用文件系统 rename 的原子性。这是 File 源的硬性纪律,不是可选项。
坑二:maxFileAge 误读。 同事把任务切到新 checkpoint 目录,以为"设了 3 天就只读 3 天内的文件",结果第一批把目录里所有文件(包括几个月前的)全部处理了一遍——首批全量有效是官方设计,maxFileAge 从第二批才开始生效。修复:切换目录前先清理或归档旧文件。
四、案例 C:Rate 源压测——不用真上游验证背压
4.1 场景
大屏链路要压测 8 万行/秒的吞吐,但测试环境没有等量 Kafka 集群,造数据成本高。
4.2 完整写法
val load = spark.readStream
  .format("rate")                                // ① 测试专用源
  .option("rowsPerSecond", "80000")              // ② 目标速率
  .option("rampUpTime", "1 minute")              // ③ 渐进入速
  .option("numPartitions", "12")                 // ④ 模拟 12 分区
  .load()
// 输出固定两列:timestamp(发送时间)、value(从 0 递增)
③ 是关键:直接 8 万行/秒冷启动会让自己先 OOM,渐进入速才能测出真实的背压行为;④ 对齐生产分区数,否则并行度失真。输出只有 timestamp 和 value 两列,压测时用 expr("value % 32 as province") 之类的表达式造业务字段。
4.3 价值
用 Rate 源压测调出了三个配置:maxOffsetsPerTrigger 该设多少、trigger 间隔选 30 秒还是 1 分钟、shuffle 分区数从 200 降到多少不丢吞吐。这些结论直接套到生产 Kafka 源上,省掉了一整套压测环境。注意 Rate 无 offset 不可重放,只做吞吐验证不做正确性验证;要结果可比对的测试用 Rate Per Micro-Batch(每批行数固定)。
五、案例 D:foreachBatch 一托三——三种语义一次满足
5.1 需求与约束
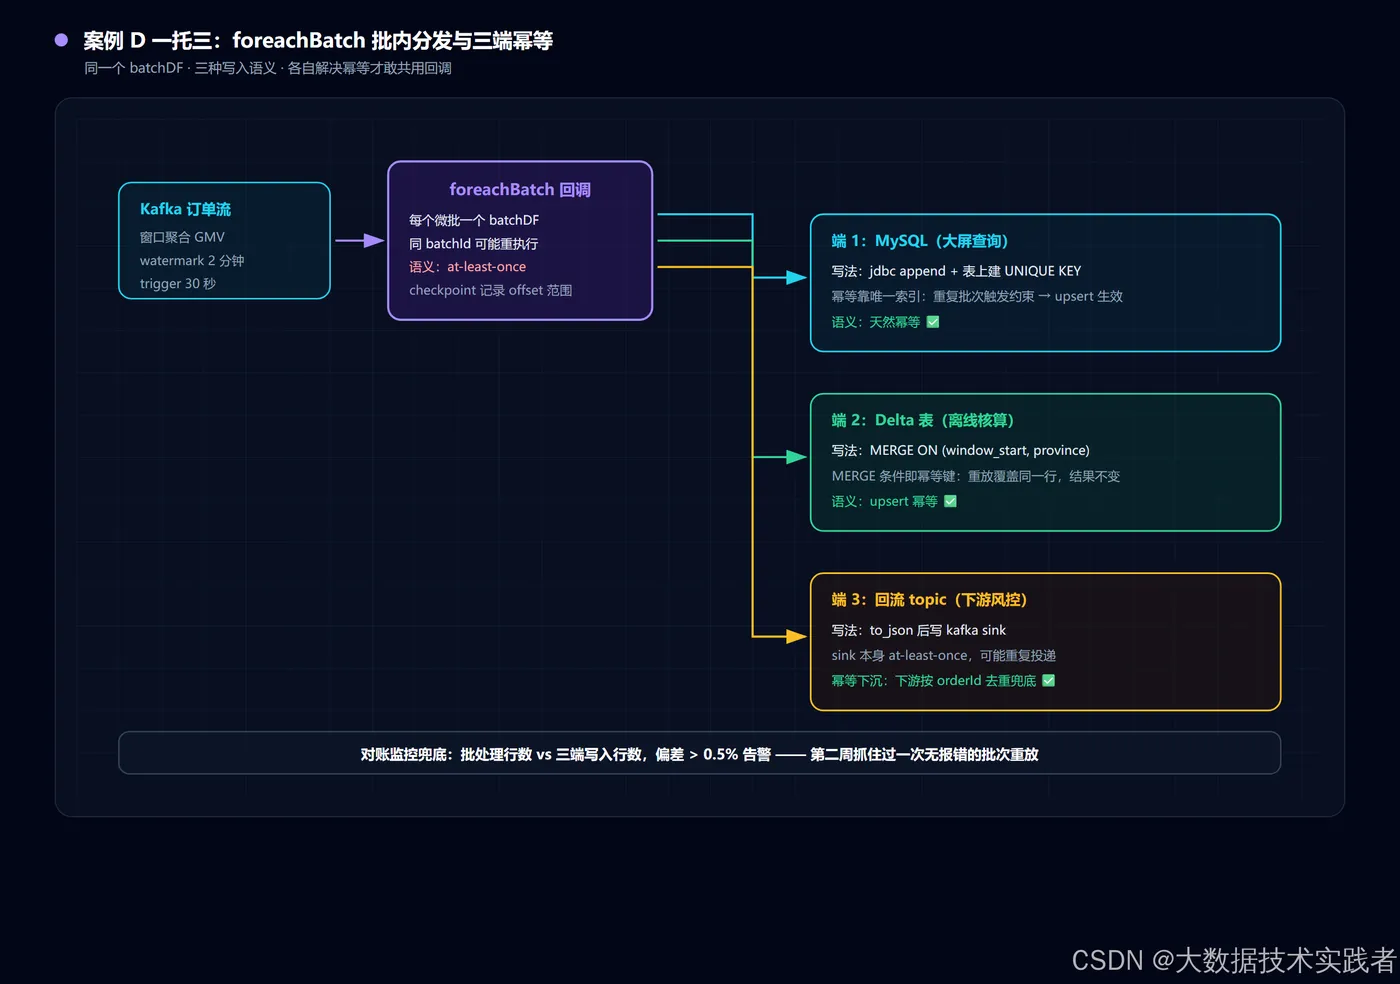
GMV 聚合结果要同时写三处:MySQL 给大屏查询、Delta 表给离线核算、回流 topic 给下游风控。三端语义不同(upsert / MERGE / append-only),一个 writeStream 表达不了。
5.2 完整写法
gmv.writeStream
  .outputMode("append")
  .foreachBatch { (batchDF: DataFrame, batchId: Long) =>
    // 端 1:MySQL upsert(唯一索引兜底)
    batchDF.write
      .format("jdbc")
      .option("url", "jdbc:mysql://mysql:3306/report")
      .option("dbtable", "gmv_1m")
      .mode("append")                            // 表上建 UNIQUE KEY
      .save()

    // 端 2:Delta MERGE
    DeltaTable.forPath(spark, "s3a://lake/gmv_1m")
      .as("t")
      .merge(batchDF.as("s"),
        "t.window_start = s.window_start AND t.province = s.province")
      .whenMatchedUpdateAll()
      .whenNotMatchedInsertAll()
      .execute()

    // 端 3:明细回流 topic(at-least-once,下游按 orderId 去重)
    batchDF.selectExpr("CAST(province AS STRING) AS key",
                       "to_json(struct(*)) AS value")
      .write
      .format("kafka")
      .option("kafka.bootstrap.servers", "broker1:9092")
      .option("topic", "gmv_result")
      .save()
  }
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-1m")
  .trigger(Trigger.ProcessingTime("30 seconds"))
  .start()
5.3 必须内化的一条语义
foreachBatch 是"至少一次":同一 batchId 在失败恢复时可能被重复执行。所以端 1 靠 MySQL 唯一索引天然幂等,端 2 的 MERGE 条件就是幂等键,端 3 的 Kafka sink 本身 at-least-once、由下游按 orderId 去重兜底——三端各自解决幂等,才敢共用这一个回调。上线后配了一条对账监控:批处理行数 vs 三端写入行数,偏差超 0.5% 告警,正是这条监控在第二周抓住了一次批次重放(无报错、数字对不上)。
六、四案例沉淀的通用套路
- 限流参数是所有源的标配:Kafka 用
maxOffsetsPerTrigger,File 用maxFilesPerTrigger,目的都一样——把首批积压钉死在可控范围; - 位点与目录是"身份":改
startingOffsets要换 checkpoint,切 File 源 checkpoint 要清旧文件,否则行为与预期不符; - File 源的两个纪律不可妥协:原子落盘(临时目录 + move)、归档目录不放 path 子目录;
- 测试源有明确分工:Rate 做吞吐压测(渐进入速 + 对齐分区数),Rate Per Micro-Batch 做结果比对,Socket 只做冒烟;
- foreachBatch 一托三的前提是三端各自幂等:唯一索引 / MERGE 键 / 下游去重,缺一个都不敢上线,再配对账监控兜底。
七、总结
- 四个案例对应四个真实决策:Kafka 看限流、File 看纪律、Rate 看模拟、foreachBatch 看幂等;
- 代码可以抄,但每个参数的"为什么"才是可迁移的:①限流防首批、②位点只对新查询生效、③原子落盘是 File 源前提、④渐进入速才能测出背压、⑤至少一次语义下幂等只能在 sink 侧解决;
- 数据源选型从来不是单选题——案例 D 一条流三个 sink 共存,说明选型颗粒度是"端"不是"任务";
- 所有事故里最贵的一条认知:首批全量有效、恢复忽略 startingOffsets,这两个"反直觉设计"官方文档都写了,但只有翻过车才会认真读。

