
引子:一次 NameNode 重启,为什么能让你等半小时
一次例行维护,NameNode 停机重启,本以为几分钟,结果服务一挂半小时,日志停在"replaying edits(回放编辑日志)"。把本地目录翻出来,edits_inprogress 大到好几 GB,fsimage 还停在几天前。
问题只有一个:没有人帮它把 edits 合并进 fsimage。这并非个例——生产环境出现过 NameNode 攒下几百 GB 编辑日志、写满磁盘后节点直接宕机的事故。
这一篇把 checkpoint 从"是什么"讲到"文件长什么样、分几步、怎么用事务号推算、怎么监控告警、怎么排障恢复",并给出可直接照抄的参数与命令。
一、30 秒建立心智模型:四个核心概念
先给四个自包含的定义,后面所有内容都围绕它们展开:
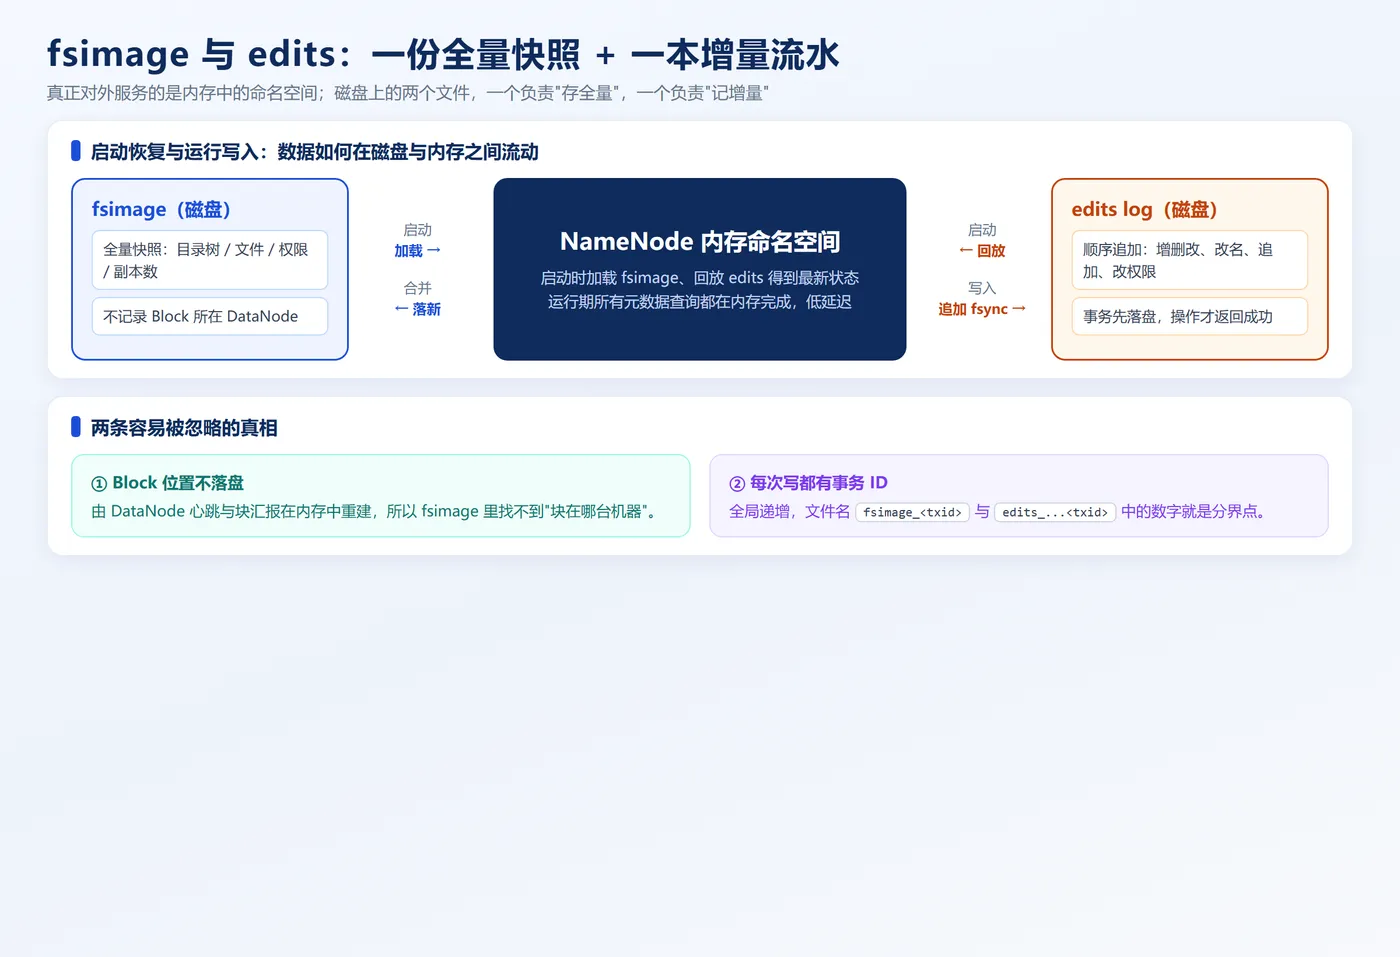
- fsimage(命名空间镜像):HDFS 在某一时刻的完整元数据快照,包含目录树、文件、权限、副本数、时间戳。它是"读得快、改不动"的全量档案。
- edits log(编辑日志):快照之后每一次写操作(新建、删除、改名、追加、改权限)按事务顺序追加的增量日志。它是"改得快、需回放"的流水账。
- checkpoint(检查点):把旧 fsimage 与累计 edits 压缩合并成一份新 fsimage 的过程;合并后旧日志可被截断,edits 从一个很小的文件重新开始。
- 事务 ID(txid):NameNode 给每条写事务分配的全局单调递增编号。文件名里的数字、checkpoint 的分界点,全靠它定位。
二、为什么是"快照 + 日志":把随机写变成顺序写
为什么不直接把每次修改都写进 fsimage?因为 fsimage 是一棵庞大的树,其格式为"读"做了优化,不适合做小的随机增量修改;如果每次都全量重写整棵树,既慢,又可能在写到一半时崩溃、损坏整份快照。
edits 则是顺序追加:一条 edit 通常只有几十到几百字节,顺序写磁盘极快,崩溃后能逐条重放。这就是经典的"全量快照 + 预写日志(WAL)"模式——和数据库、以及 ext3、ext4、XFS 的 journal 同一思路:先写日志再落最终位置,崩溃后靠日志恢复。
对外服务的是内存。NameNode 启动时先把 fsimage 加载进内存、再逐条回放 edits 恢复到停机前状态,之后元数据查询全在内存完成。两个要点要钉死:
① fsimage 不记录 Block 在哪台 DataNode。 块位置由 DataNode 启动后块汇报、在内存中重建,不落盘。fsimage 只记录"文件由哪些块组成"。
② 日志先落盘、操作才返回成功。 每条写事务必须等 edits 真正 fsync 刷盘后才向客户端返回成功;宕机最多丢未刷盘的一条,已确认操作不丢。
磁盘上的文件格式:现代 Hadoop(2.x/3.x)的 fsimage 与 edits 都采用 Protocol Buffers 序列化(fsimage 在 HDFS-5698 切换为 Protobuf)。fsimage 按"段(Section)"组织,主要有 NS_INFO(命名空间信息)、INODE(每个 inode 的属性)、INODE_DIR(目录与其子项的关系)、FILES_UNDERCONSTRUCTION(正在构建的文件)、SNAPSHOT 相关段等。值得注意的是,它把 inode 拆成"属性表 + 目录关系表",把目录树当成一张图而不是一棵树——因为快照(snapshot)会让一个 inode 同时属于多个目录,树结构无法表达;这种扁平化也让顺序加载更快。
三、不合并会怎样:edits 滚雪球,最终写满磁盘
快照停在"过去某一刻",之后的变化全靠 edits。如果 checkpoint 一直不发生,会同时引发:
- 写满磁盘:edits 只增不减,从 MB 涨到 GB 甚至上百 GB,最终占满 NameNode 本地磁盘。
- 重启极慢:NameNode 启动要把这堆日志逐条回放,故障窗口随 edits 大小线性增长。
checkpoint 把 fsimage + edits 压缩(compact)成一份新 fsimage,事务一旦写进新镜像,旧日志就可以截断。这样 NameNode 重启时直接从新镜像加载最终状态,不必再回放无界日志——这正是 checkpoint 的价值。
四、非 HA:SecondaryNameNode 的完整七步流程
非 HA(单 NameNode)下,合并由 SecondaryNameNode 完成。它不是热备,而是专门干"合并脏活"的辅助节点。因为没有共享日志、也不自动跟进,它要先刷新自己的视图,步骤更细:
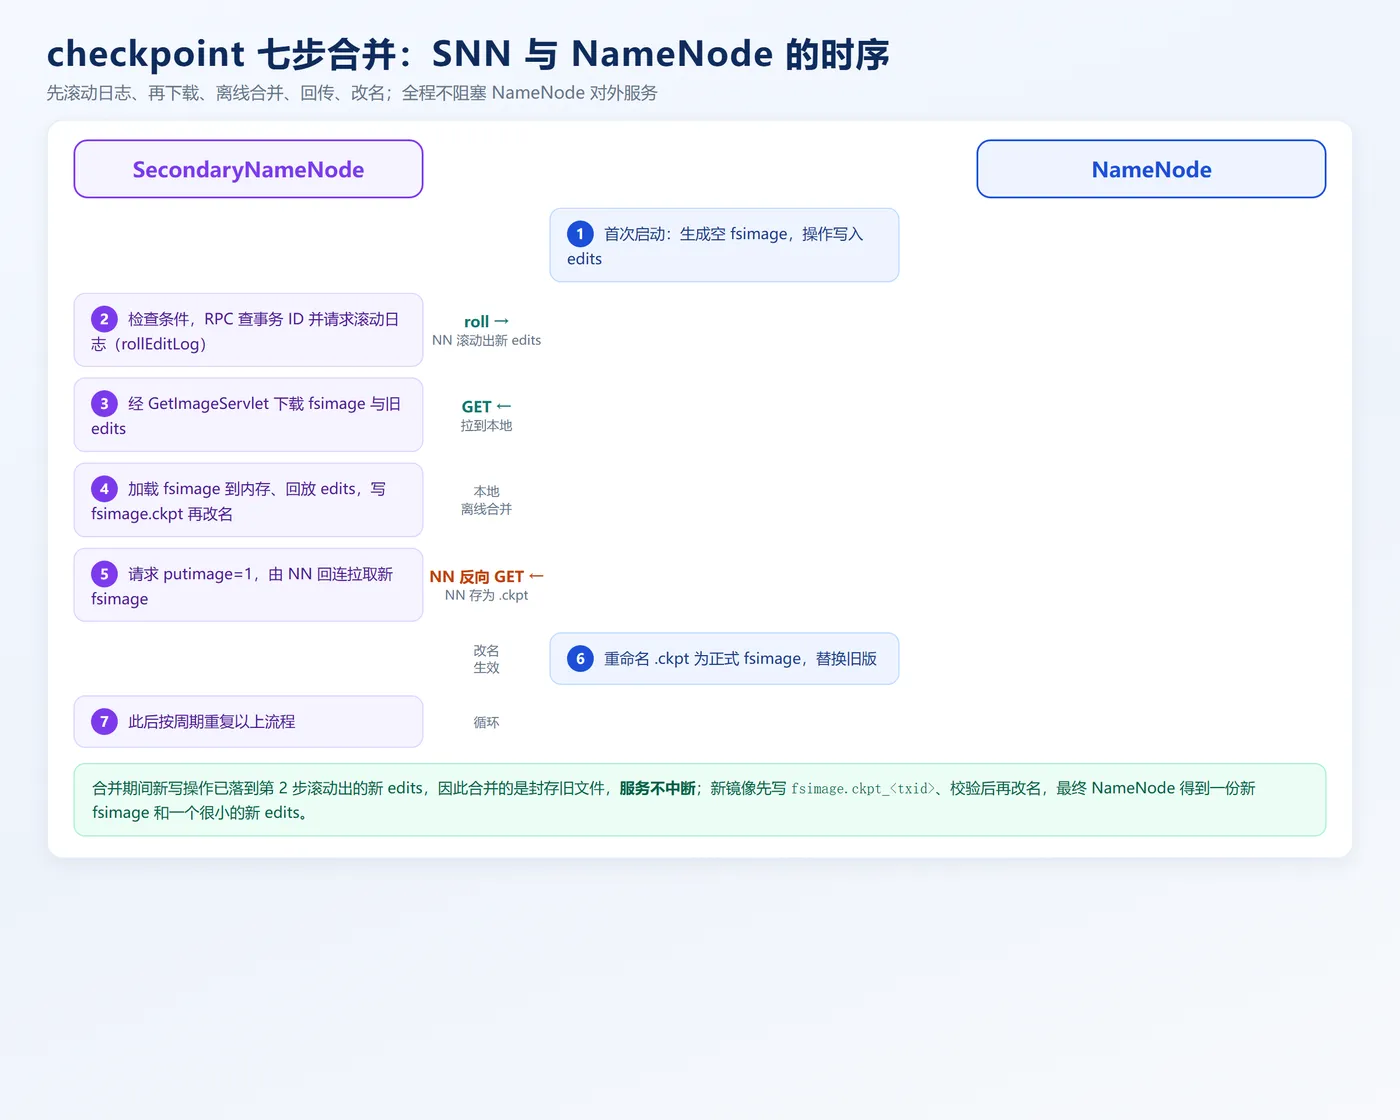
- 检查触发条件:确认是否满足"时间到了"或"事务攒够了";非 HA 下先通过 RPC
getTransactionId向 NameNode 查询最新事务 ID。 - 滚动日志(rollEditLog):触发编辑日志滚动,结束当前 in-progress 段、开一个新段。NameNode 继续往新段写,SecondaryNameNode 合并封存的旧段,互不干扰。
- 下载(HTTP GET):经 NameNode 的
GetImageServlet把当前 fsimage 和旧 edits 拉到本地,上一轮已下载、未变化的文件复用。 - 重载快照:必要时把新下载的 fsimage 加载进自己的内存。
- 回放 edits:逐条回放新 edits 段,把内存命名空间追赶到当前事务 ID。
- 写新 fsimage:先以临时名
fsimage.ckpt_<txid>写出,再生成 MD5 校验,最后改名为fsimage_<txid>。 - 回传:SecondaryNameNode 请求
/getimage?putimage=1,由 NameNode 的 ImageServlet 主动回连、用 GET 从 SecondaryNameNode 把新镜像拉回,同样先存.ckpt、校验、再改名。
一个常见误解:第 7 步并不是 SecondaryNameNode 直接 PUT 推送,而是"NN 向 SNN 取货"。理解为 NameNode 主动回连拉取更贴近真实实现。
核心设计是全程不阻塞 NameNode 服务:第 2 步先滚动日志,新写操作落新段,合并的是封存旧文件。也正因为合并要在 SecondaryNameNode 内存里"完整重建一遍命名空间",它的 JVM 堆必须与 NameNode 相同,否则加载 fsimage 即 OOM;还需足够本地磁盘存放下载与生成的文件。
五、HA:SecondaryNameNode 消失,Standby 借 QJM 接管
线上几乎都是 HA 高可用:一主一备两个 NameNode(Active / Standby)。此时 jps 里没有 SecondaryNameNode,checkpoint 职责被 Standby 完整接管,流程更简单:
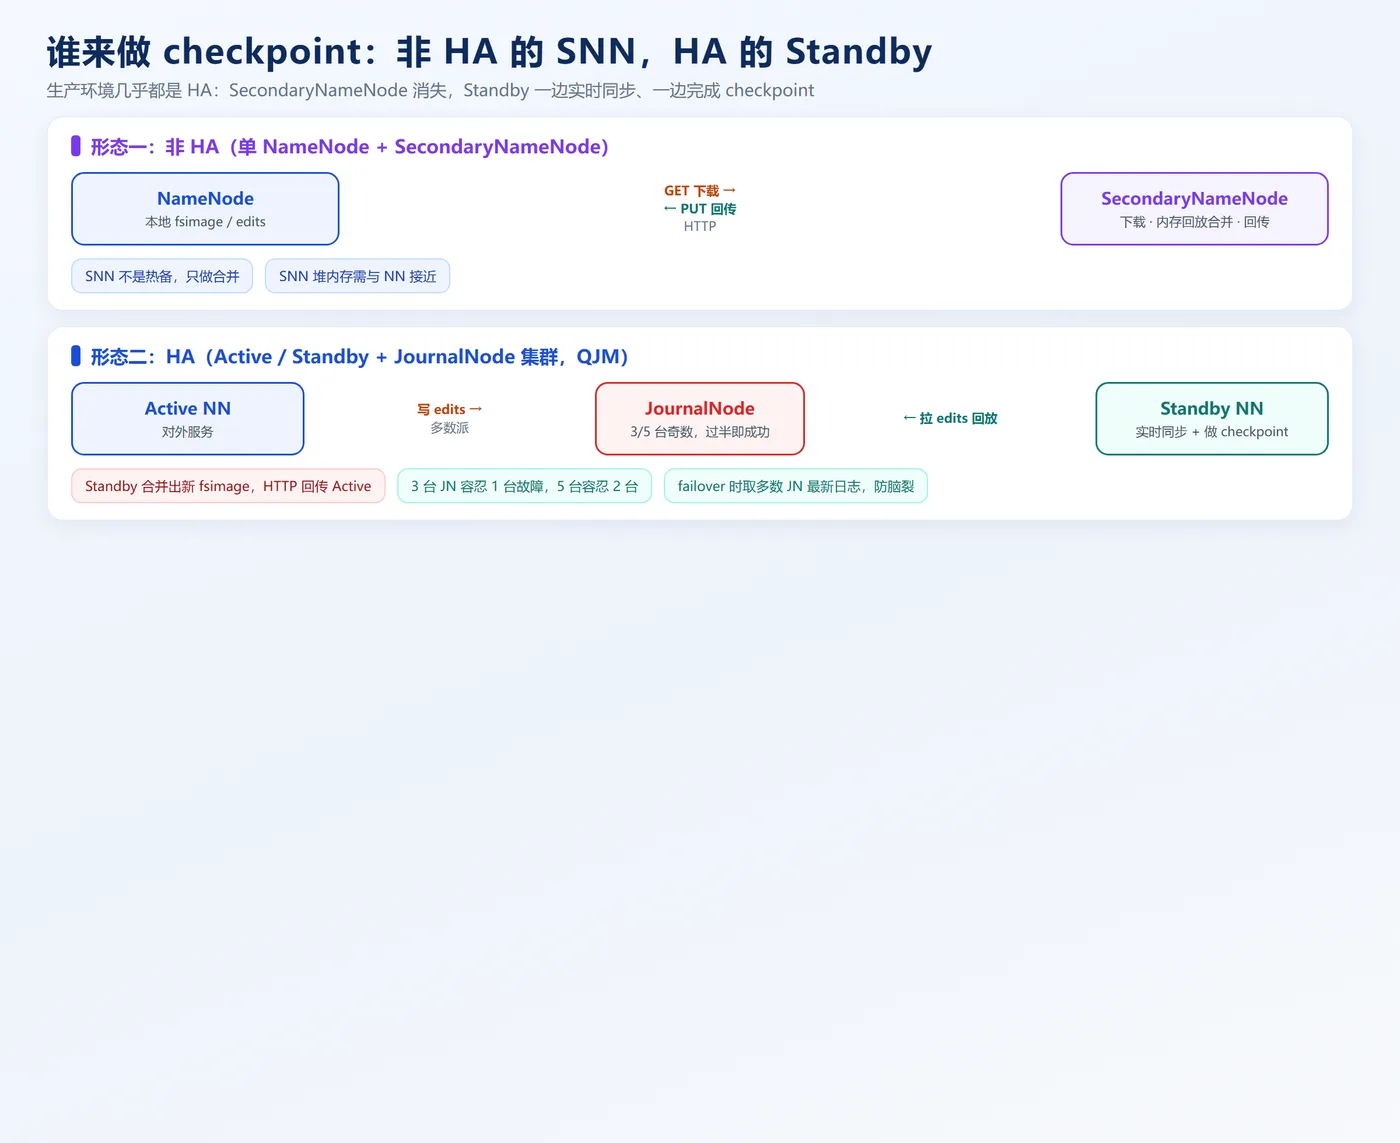
- edits 写进 JournalNode 集群(QJM):JournalNode 通常 3、5 台奇数节点,Active 写入时只要多数派(majority)落盘成功即视为成功。
- Standby 持续 tail edits 并回放:命名空间始终与 Active 基本同步,随时可接管,因此省掉非 HA 中"查事务 ID、滚动、下载、重载"的准备动作。
- Standby 直接做 checkpoint:把命名空间保存成新 fsimage(等价于命令行
saveNamespace),再回传给 Active。 - Active 同样需要这份新镜像:否则它重启时仍要回放庞大日志。
分清"谁被阻塞":checkpoint 期间被短暂限制的是 Standby 自己的管理操作(故障切换、部分 Web UI),客户端读写不受影响(由 Active 服务)。新版还把镜像传输移出写锁,避免传输期间 Standby 无法接管。
"多数派"是 QJM 可靠性的关键:3 台 JN 写满 2 台即成功、可容忍 1 台宕机;5 台容忍 2 台。故障切换时新 Active 拿到多数 JN 的最新日志即可保证不丢已确认事务,从根本上避免"两个 Active 各自写入、日志分裂"的脑裂。JN 总是奇数,正是用最少节点凑出多数派。
六、一个带事务号的完整例子:从 checkpoint 到重启
用一段连续事务走一遍,文件名和分界点就全清楚了:
上一检查点:fsimage_1000,旧 edits 已截断
新操作写入:edits_inprogress_1001,事务编号 1001 → 1050
  ① 触发条件满足(满 1 小时或攒够阈值)
  ② SNN 发起 rollEditLog:
       当前段封成 edits_1001_1001001_1050,开启 edits_inprogress_1051
  ③ SNN 下载 fsimage_1000 与 edits_1001_1050
  ④ 加载 fsimage_1000、回放 1001~1050,写 fsimage.ckpt_1050 并改名
  ⑤ putimage 通知,NN 回连拉取 fsimage_1050,校验后改名生效
  ⑥ 旧 edits_1001_1050 被截断清理
  ⑦ 此后 NN 重启:直接加载 fsimage_1050,只回放 1051 起的少量日志
关键结论:重启要回放的日志,是"最近一次 checkpoint 之后"的那部分。checkpoint 越新,重启越快。
七、参数、容量规划与监控:把数字钉死
触发与保留参数(hdfs-site.xml),默认值可直接对照:
dfs.namenode.checkpoint.period:两次 checkpoint 的时间间隔,默认 3600 秒(1 小时)。dfs.namenode.checkpoint.txns:未检查点事务数阈值,默认 1000000(100 万),达到即合并。dfs.namenode.checkpoint.check.period:检查上述条件的频率,默认 60 秒。dfs.namenode.num.checkpoints.retained:保留的 fsimage 份数,默认 2。dfs.namenode.num.extra.edits.retained:重启所需之外额外保留的事务数,默认 1000000。dfs.namenode.max.extra.edits.segments.retained:额外保留的日志段上限,默认 10000。dfs.image.transfer.bandwidthPerSec:镜像传输限速(字节/秒),默认 0(不限);dfs.image.transfer.timeout为传输超时。
容量规划:每个命名空间对象(一个文件、目录或 Block)在 NameNode 内存中约占 150 字节;Cloudera 更保守口径为"每百万 Block 约 1 GB 堆"。按此估算:1 亿个对象约 150 亿字节、约 15 GB 堆(需再留 RPC 与数据结构余量)。一个小于块大小的文件仍占一个 Block 对象——小文件对内存的杀伤与文件大小无关。SNN/Standby 的堆必须与 NN 相同,否则会出现"checkpoint 反复 OOM、edits 越滚越大"的恶性循环。
监控与告警:重点看 NameNode JMX(Hadoop:service=NameNode,name=NameNodeInfo / FSNamesystem 指标)中的三个值:
LastCheckpointTime:最近一次检查点时间,超过 2 个检查点周期(默认 2 小时)未更新即告警。TransactionsSinceLastCheckpoint:自上次检查点以来的事务数,逼近阈值(如超过 80 万)即告警。CheckpointTxId/mostRecentCheckpointTxId:最近检查点事务号,与当前 txid 的差距反映待回放量。
八、实战命令速查
离线分析镜像与日志(不影响集群):
# oiv:Offline Image Viewer,-p 处理器可选 Web(默认)/XML/Delimited/
#     DetectCorruption/FileDistribution/ReverseXML
hdfs oiv -i fsimage_1000 -o fsimage.xml -p XML

# FileDistribution:统计文件大小分布(排查小文件)
hdfs oiv -i fsimage_1000 -o dist.txt -p FileDistribution

# oev:Offline Edits Viewer,-p 处理器可选 binary/xml(默认)/stats
#      stats 只输出统计、不能转回 edits
hdfs oev -i edits_1001_1050 -o edits.xml -p xml
hdfs oev -i edits_1001_1050 -o edits.stats -p stats

# 查看待合并 edits 大小、手动强制 checkpoint
hdfs secondarynamenode -geteditsize
hdfs secondarynamenode -checkpoint force
维护与灾难恢复:
# 维护时手动把当前内存命名空间落盘(先进安全模式)
hdfs dfsadmin -safemode enter
hdfs dfsadmin -saveNamespace
hdfs dfsadmin -safemode leave

# 元数据全丢、但 SNN 仍有检查点:建空目录、用 dfs.namenode.checkpoint.dir
# 指向检查点,以 -importCheckpoint 启动 NN 导回(会略落后于故障点)
hdfs namenode -importCheckpoint

# HA 中首次初始化 Standby,从 Active 拉取最新 fsimage
hdfs namenode -bootstrapStandby
九、高频问题 FAQ
Q1:checkpoint 是不是备份? 不是。它是把 fsimage + edits "压缩"成新镜像,并不额外增加数据副本。SNN 那份也不是可靠备份;但在 NN 元数据全部丢失时,可用 -importCheckpoint 从检查点抢救回最近状态。
Q2:SecondaryNameNode 是热备吗? 不是。它不实时同步,只周期性合并,NameNode 宕机时最近一段事务可能丢失,无法直接顶替。
Q3:HA 下 jps 为什么没有 SecondaryNameNode? 因为它的合并职责被 Standby 接管,Standby 既是热备又是 checkpoint worker,同时解决单点与合并。
Q4:checkpoint 过程中集群能读写吗? 能。非 HA 下 NN 第 2 步滚动日志后继续服务新段;HA 下客户端读写由 Active 承担,被阻塞的只是 Standby 自身的管理操作。
Q5:能为了"干净"手动删 edits 吗? 不能。手动删除可能导致元数据无法恢复,应让 checkpoint 按保留策略自动回收。
写在最后
fsimage 与 edits 的合并看似不起眼,却决定了 NameNode 能否快速重启、元数据能否不丢、磁盘会不会被写满。记住这条主线:fsimage 是全量快照,edits 是增量日志,checkpoint 把二者压缩成新快照;非 HA 时 SecondaryNameNode 干,HA 时 Standby 借 JournalNode 干。
