基于 YOLO26 的火灾检测预警系统 | 完整源码分享
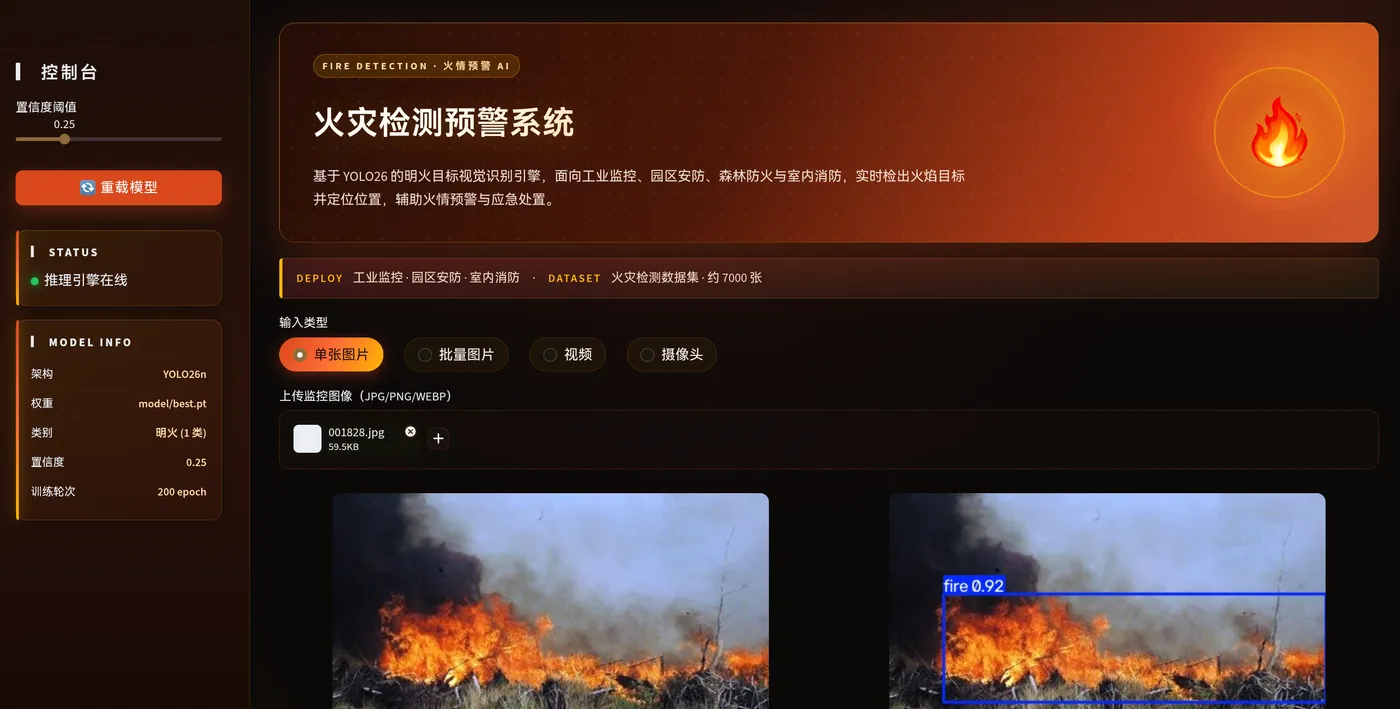
本文介绍一个面向工业监控、园区安防与室内消防场景的明火目标检测应用。项目以 YOLO26n 为检测模型、Streamlit 为交互界面,支持单张图片、批量图片与视频输入,可实时定位画面中的明火目标并输出边界框与置信度,为火情预警与应急处置提供辅助判断依据。
一、项目背景:为什么要做火灾视觉检测
火灾是工业与民用场景中破坏性最强的灾害之一,而"早发现"始终是防灾链条中最关键的一环。传统火灾探测手段各有局限:
- 烟感温感有滞后:点式传感器需要烟气或热量聚集到一定程度才触发,在开放空间、高大厂房或户外场景响应更慢;
- 人工盯屏不可持续:安保中心往往一人面对多路监控,注意力有限,夜间与节假日尤其容易漏判;
- 事后查证成本高:传统监控只能回放,火灾发生时每一秒都珍贵,事后录像无法挽回损失;
- 告警缺乏定位信息:传统探测器告诉你有火,但不告诉你是哪个区域、火点在哪。
本项目将上述流程封装成一个可直接运行的 Web 应用。用户不需要编写推理脚本,也不必逐张调用命令行程序;打开浏览器即可上传图像,查看原图与检测图,并在需要时批量处理图片或分析视频。
视频演示与源码下载
包含: 📦完整项目源码 📦预训练模型权重 🗂️数据集
项目运行效果
*Web 界面总览
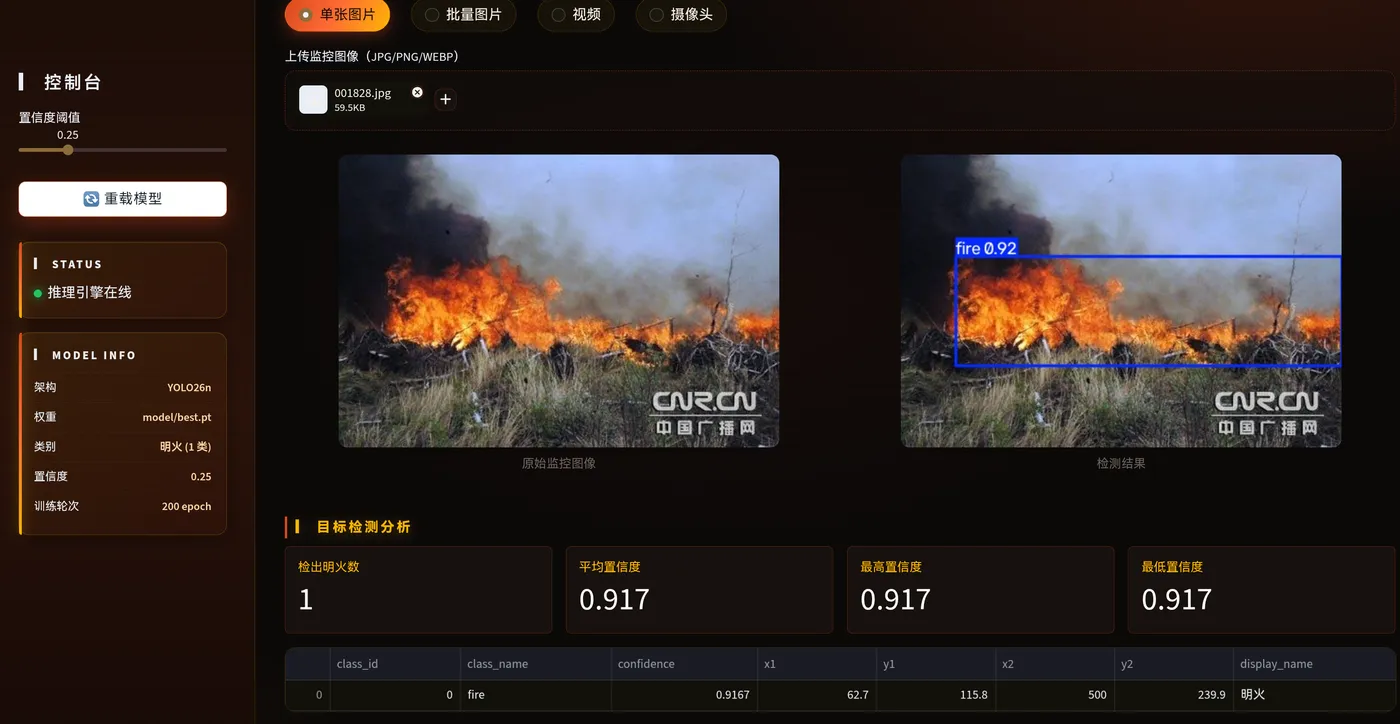
*单张图片识别效果
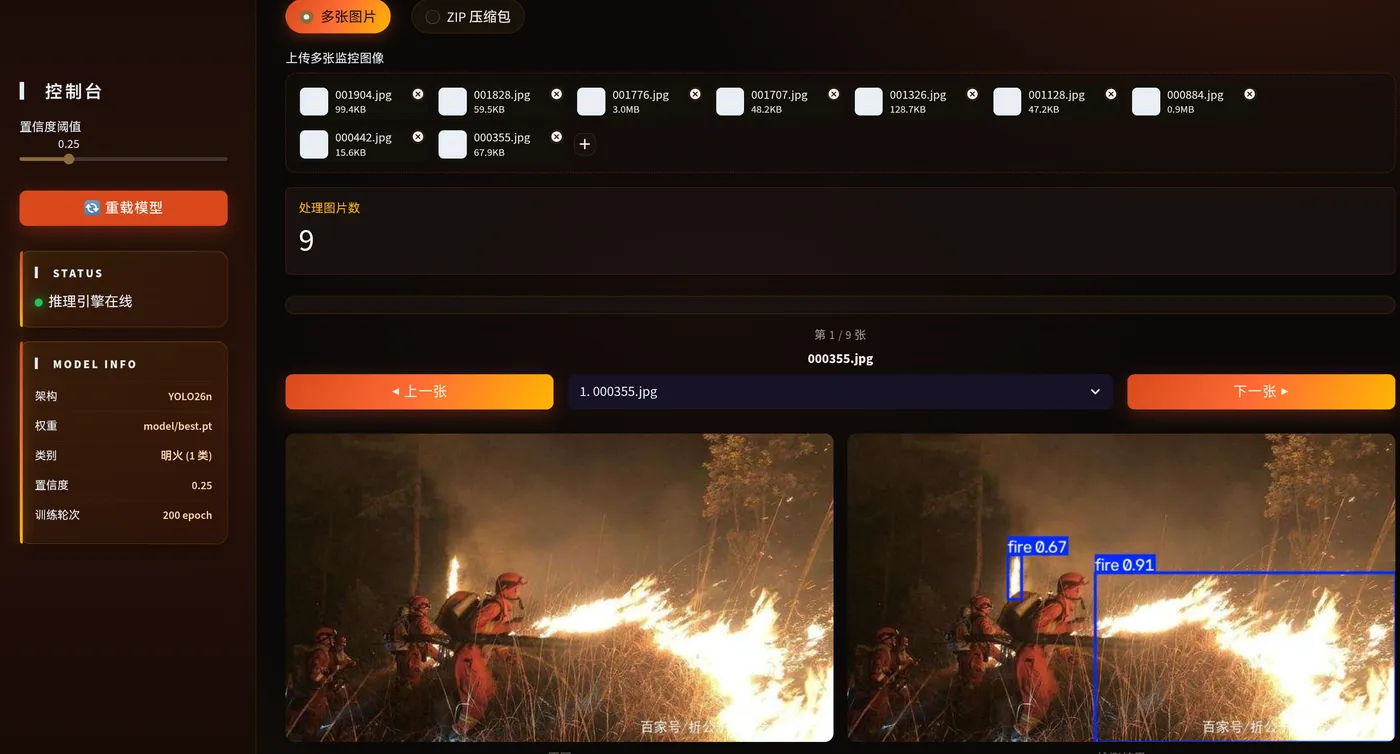
*批量图片合规检查
二、项目功能与检测类别
系统使用 YOLO26n 权重执行目标检测,数据集为单类别明火目标:
| 类别 | 场景说明 |
|---|---|
| 明火 | 画面中的明火目标,覆盖白天、夜晚、室内、室外等场景 |
数据集共约 7000 张人工标注图像,按 train / valid / test 划分,YOLO 格式标注,单类别配置(nc=1)。样本涵盖不同光照、不同火焰大小与不同背景,可用于工业监控、野外火情、室内火灾等场景的模型验证。
应用提供以下主要能力:
- 单张图片检测:上传 JPG、PNG 等常见格式,输出带边界框的检测图与逐目标明细。
- 批量图片检测:一次提交多张图片,也支持 ZIP 图片包;逐张推理并汇总,便于快速筛查一批监控截图。
- 视频检测:上传视频后按帧执行检测,输出带标注的结果视频与分析信息。
- 摄像头输入:通过应用界面调用可用摄像头进行实时检测。浏览器权限与运行环境会影响此功能可用性。
- 阈值调节:侧栏提供置信度阈值滑块。阈值调低通常保留更多候选框,可能增加误报;调高则过滤弱候选,可能漏掉小火点。
- 结果查看与导出:除标注图外,还可查看类别、置信度、边界框坐标等表格信息,方便复核与留档。
需要说明:检测结果是图像层面的模型判断,不等同于火灾确认结论。实际部署中应与烟感、温感、热成像及人工确认结合,避免单一视觉误报引发处置混乱。
三、系统整体架构
系统采用清晰的分层结构:浏览器负责上传与展示,Streamlit 负责交互与流程控制,Ultralytics YOLO 执行模型推理,OpenCV、Pandas 等组件承担图像处理与结果整理。
用户 / 浏览器
    │ 上传图片、图片压缩包或视频,调整置信度阈值
    ▼
Streamlit 应用(app/streamlit_app.py)
    │ 输入校验、模式分发、进度提示、结果展示与下载
    ▼
YOLO26n 推理模型(model/best.pt)
    │ 预处理 → 前向推理 → 置信度筛选 → NMS
    ▼
结果后处理
    │ 类别名称、置信度、xyxy 坐标、标注图与汇总数据
    ▼
浏览器展示 / 下载结果
项目界面配置集中在 configs/project.yaml,包括应用标题、简介、主题色、默认推理阈值、批量上限等。展示信息与推理代码分离后,修改标题或颜色通常不需要改动核心逻辑。界面采用深色火焰主题,与火情预警场景的视觉调性一致。
四、YOLO 推理流程简述
YOLO 属于单阶段目标检测方法:模型在一次前向过程中同时预测目标位置与类别,不需要像两阶段检测那样先生成候选区域再逐个分类,适合构建交互式检测应用。
对一张输入图像,典型推理过程包括:
- 图像预处理:读取文件并转换为模型可接收的张量,按输入尺寸进行缩放与填充。
- 模型前向计算:YOLO26n 提取特征并生成类别分数与边界框候选。
- 置信度过滤:按当前阈值剔除低分候选框。界面默认值来自项目配置,可通过侧栏调整。
- 非极大值抑制(NMS):对高度重叠的候选框去重,减少同一火点被重复框出的情况。
- 结果绘制与结构化:将类别、置信度和坐标整理为表格,同时生成叠加检测框的图像。
火焰检测有自己的难点:火点尺度变化极大,从远处一簇小火苗到占据半幅画面的大火都可能出现;夜间画面中火焰往往是唯一高亮区域,与灯光、晚霞等暖色光源外观接近;烟雾弥漫时火点轮廓会被部分遮挡。因此相机位置、画面视野、夜间补光方式和目标尺度都会影响模型输出。部署时应先用实际摄像头和现场环境验证,不宜仅凭少量示例判断效果。
五、核心推理代码解读
下面摘取项目图像推理函数的主要逻辑。它调用 Ultralytics 的 model.predict,再把结果转换为标注图和 Pandas 表格:
def infer_image_path(model: YOLO, image_path: Path, conf: float) -> tuple:
    result = model.predict(str(image_path), conf=conf, verbose=False)[0]
    annotated = result.plot()
    rows = []
    if result.boxes is not None:
        for box in result.boxes:
            cls_id = int(box.cls.item())
            confidence = float(box.conf.item())
            x1, y1, x2, y2 = [float(v) for v in box.xyxy[0].tolist()]
            rows.append({

                "class_id": cls_id,
                "class_name": result.names[cls_id],
                "confidence": round(confidence, 4),
                "x1": round(x1, 1), "y1": round(y1, 1),
                "x2": round(x2, 1), "y2": round(y2, 1),
            })
    return annotated[:, :, ::-1], pd.DataFrame(rows)
关键点如下:
model.predict(..., conf=conf)将用户设置的阈值传入推理接口,控制候选框保留范围。result.plot()绘制类别标签与边界框,避免另行编写绘图逻辑。result.boxes包含类别索引、置信度与坐标;坐标采用xyxy表示,即左上角与右下角位置。result.names[cls_id]将类别索引转为模型类别名。项目在配置中通过class_display_names把fire映射为中文「明火」,前端展示更友好;类别名称与顺序必须与权重训练时保持一致,否则会出现"框对类错"。- Ultralytics 绘图结果通常为 BGR 通道顺序,返回前用
[:, :, ::-1]转为 RGB,以适配 Streamlit 图像展示。 - 每个检测框整理为字典,最终形成 DataFrame,便于前端展示,也可扩展为 CSV 导出、数据库写入或告警系统对接。
模型对象通过 Streamlit 的资源缓存机制加载,避免每次交互重复初始化;批量图片与视频流程复用同一实例,并通过临时目录管理上传文件,减少逻辑分散。
六、Streamlit 页面与配置组织
项目页面主要分为三部分:
- 页面顶部:项目名称、火情预警用途简介与场景标签。
- 侧栏:推理引擎状态、模型信息(架构、权重、类别数、当前阈值)与置信度控制。
- 主区域:通过输入类型选择器切换检测流程,显示原图、检测图、分析表格与下载按钮。
推理阈值和界面文案由配置文件读取:inference.conf 为默认置信度,inference.iou 控制重叠框筛选参数,inference.max_batch_images 限制单次批量数量。建议调整参数时一次只改变一个变量,并保留一组代表性图像做对比,避免仅凭单张图片下结论。
界面当前不展示整体检测率等模型评测指标卡,重点是实际输入图像后的检测结果、类别与置信度。置信度只反映单个候选框的分数,不能等同于整体准确率;某个框置信度较高,不代表模型在所有光照、角度与场景下都有同等表现。
七、快速部署
7.1 环境准备
依赖清单位于 requirements.txt。建议在项目目录创建独立虚拟环境,降低与其他 Python 项目冲突:
python -m venv .venv
Windows PowerShell 激活:
.\.venv\Scripts\Activate.ps1
安装依赖:
pip install -r requirements.txt
若需要浏览器直接播放结果视频,可安装 FFmpeg 并确认命令行可用;图片检测不依赖该组件。
7.2 启动应用
在项目根目录执行:
streamlit run app/streamlit_app.py
浏览器访问:
http://localhost:8501
7.3 局域网访问
如需同一局域网内其他设备访问,可将监听地址设为 0.0.0.0:
streamlit run app/streamlit_app.py --server.address 0.0.0.0 --server.port 8501
其他设备使用运行主机的局域网 IP 与端口访问,例如 http://192.168.x.x:8501。实际 IP 以主机网络配置为准;连接失败时检查设备是否同网段、防火墙是否放行 TCP 端口、路由器是否启用客户端隔离。不要在没有访问控制的情况下将开发用服务直接暴露到公网。
八、使用步骤
- 启动应用并打开浏览器页面。
- 在侧栏设置置信度阈值;首次体验可沿用默认值,再根据误报、漏报情况调整。
- 选择输入方式:单张图片、批量图片、视频或可用摄像头。
- 上传清晰、火点可见的图像;批量模式可一次选择多个文件或提交 ZIP。
- 查看标注结果与检测明细。无检测框可能意味着图中无可识别明火,也可能是火点过小、被遮挡或阈值较高。
- 人工复核后下载需要留存的标注图或结果文件。
九、效果评估与使用边界
数据集训练记录中包含 mAP、Precision、Recall 等评测指标,但 UI 按需求不显示整体检测率。不同指标关注点不同:Precision 看检出目标中正确的比例,Recall 看实际目标中被找到的比例,mAP 综合不同置信度与定位标准下的检测质量。这些指标来自特定数据划分,不能直接等同现场表现。
火灾检测的域差异比较明显:昼夜光照、镜头视角、场景类型(厂房、仓库、森林、室内)、火点距离、烟雾浓度和相机参数都会改变图像分布。部署前建议准备覆盖白天与夜间、远近不同火点、有无烟雾干扰的现场图像,逐张人工核验模型表现。误报较多时可适当提高阈值,并检查现场是否存在灯光、晚霞、红色设备等易混光源;漏报较多时可尝试降低阈值、改善相机视野与火点在画面中的占比,并持续记录难例供后续评估。
以下情况尤其需要谨慎:
- 火点只占少量像素、图像压缩严重或主体失焦;
- 浓烟遮挡导致火焰轮廓不完整;
- 夜间画面中暖色灯光与火焰外观接近;
- 逆光、强反光或镜头污损;
- 现场图像与训练样本分布差异明显。
因此,本项目适合作为监控火情初筛、巡检辅助与原型验证工具;涉及消防处置、联动控制与生产决策时,应由专业人员结合多传感器信息与现场情况确认。视觉检测不应作为消防系统的唯一依据。
十、项目结构与扩展方向
火灾检测_yolo26n/
├── app/
│   └── streamlit_app.py       # Web 应用与推理交互
├── configs/
│   └── project.yaml           # 页面、主题与推理配置
├── model/
│   └── best.pt                # YOLO26n 检测权重
├── dataset/                   # 数据集图像与标注(train/valid/test)
├── outputs/                   # 运行时结果目录
├── train/                     # 已有评估与运行产物
├── requirements.txt           # Python 依赖清单
└── README.md                  # 项目使用说明
后续可以从几个方向迭代:第一,接入摄像头或 NVR 视频流,实现不间断的定时抽帧检测;第二,增加按时间、区域汇总的火情告警记录与统计视图;第三,与烟感、温感、热成像数据融合,做多模态确认以降低误报;第四,在充分验证性能与稳定性后,将推理部署到边缘盒子,降低网络传输压力并支持断网工作;第五,建立困难样本回流机制,定期评估模型在不同季节、时段与设备上的泛化表现。
十一、总结
这个项目把 YOLO26n 的明火检测能力封装成一个易部署、可交互的 Streamlit 应用,覆盖单图、批量图片和视频等常用入口,并提供置信度调节、结果可视化与结构化明细。它展示了从权重加载、单图推理、结果转换到 Web 交互的完整工程链路,并用火焰主题的界面呈现检测结果。
对初学者,这个项目适合学习目标检测模型如何接入实际应用:模型只负责产生预测,完整产品还需要处理上传、绘制、表格整理、配置管理与部署访问。对安防与消防使用者,系统可作为火情初筛辅助工具,但最终判断仍应结合多传感器信息与专业处置流程。
标签:#YOLO26 #目标检测 #火灾检测 #智能安防 #计算机视觉 #Streamlit