Zed 调试器迎来重大更新

简介: Zed调试器新增变量类型着色功能:字符串(橙)、数字(绿)、布尔(蓝)、结构体(灰),支持主题联动,告别“扫屏找变量”,大幅提升调试效率与准确性。(239字)


作为一个程序员,有很多痛苦的事情,其中一件事情就是debug调试

下面就是我经常遇到的一个场景

我在调一个复杂函数,断点停下的那一刻,调试面板里刷出了一整屏变量:字符串、数字、布尔值、结构体,混在一起,格式全都一样。我要找的那个 is_ready 布尔值,藏在一堆长得差不多的变量里。

我只能一行一行地看。看到 "user_id",哦是字符串;看到 42,哦是数字;看到 true……等等,我刚才看的那一行是哪个?

这不是在调试,这是在考眼力。

没有颜色的情况下,在一大堆调用栈里扫变量非常困难,只能一行一行读,而不是“先找颜色,再看键名”。

VS Code 早就解决了这个问题:字符串是橙色,数字是绿色,布尔值是蓝色,结构体是灰色。 你不用读变量名,扫一眼颜色就知道它的类型。

但 Zed 的调试器一直没这个能力,所有变量都是同一个颜色,像一个没有高亮的代码编辑器。

现在,Zed 也学会了

Zed  新版本的调试器现在能根据变量类型,给它们上不同的主题色。

下面来直观感受下

以前是这样
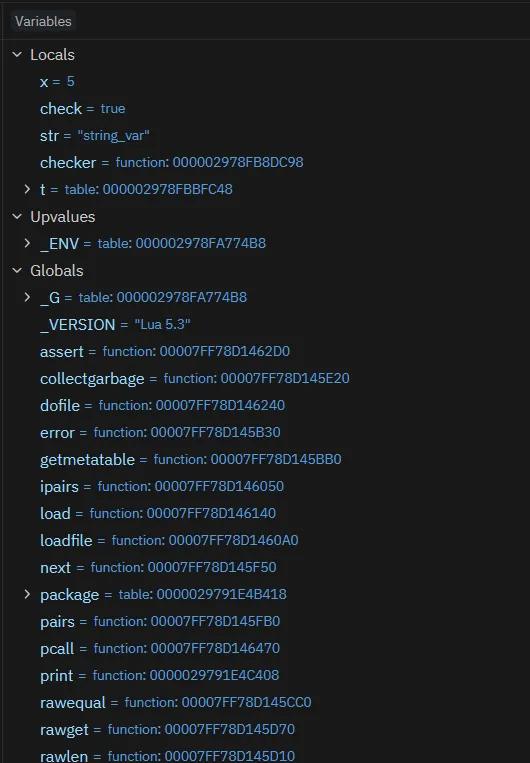
所有的都是清一色的蓝色

现在是这样
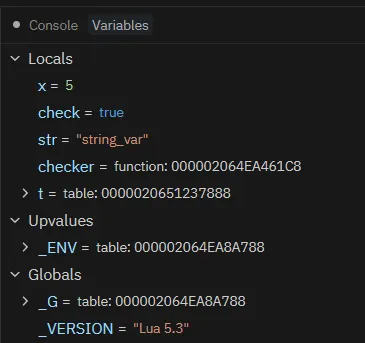
在 VS Code 的 里,字符串是橙色,数字是绿色,布尔值是蓝色,表格(结构体/类)是灰色。
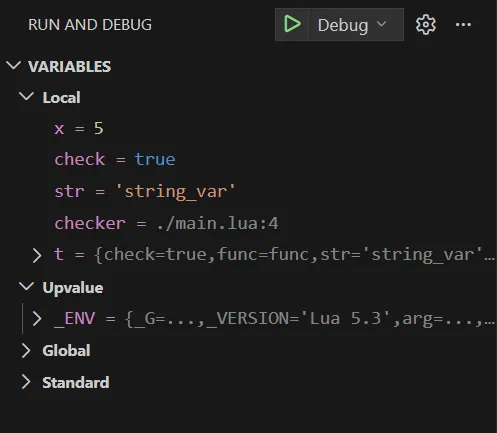
zed和vscode最大的区别就是变量本身的颜色有些不一样

现在调试再也不用一行一行扫描式查看了

你想找一个布尔值,眼睛直接去找蓝色。你想找一个字符串,直接去看橙色。类型成了颜色索引,变量名成了第二层信息,而不是唯一入口。

调试大对象时尤其明显。  一个结构体里嵌了十几个字段,类型混杂。以前你要一个个展开、一个个读。现在颜色先帮你分组,你一眼就知道哪些是值类型、哪些是引用类型。

降低“看错变量”的概率。  调试时最烦的事之一,是盯着一个变量看了半天,发现它不是你要找的那个。颜色编码等于给你加了一层“类型提示”,减少这种低级误判。

VS Code 在这件事上是先行者。 它的调试器很早就支持按类型着色,而且这个能力跟主题深度绑定,你换主题,变量颜色也跟着换。这是它调试体验成熟的地方之一。

Zed 这次是补课,但补得挺聪明。 它没有发明一套自己的颜色系统,而是直接接入主题。也就是说,变量颜色不是写死的,而是跟着你的主题走。你用暗色主题,它就是暗色主题里定义的类型色;你换一个主题,颜色也跟着变。这比“硬编码一套配色”要灵活。

但差距还在。 VS Code 的调试 UI 经过多年打磨,在变量分组、懒加载、搜索过滤这些方面都更成熟。Zed 这次解决的是“有没有”的问题,距离“好不好用”还有空间。
 

相关文章
|
28天前
|
前端开发 C++
Zed新特性:自定义窗口标题,VS Code用户自动爽用
Zed 新增 `window_title_format` 和 `window_title_separator` 设置,支持用 `${projectName}`、`${fileName}` 等变量自由定制窗口标题,告别固定格式;更智能兼容 VS Code 配置,自动翻译变量,迁移零成本。(239字)
|
13天前
|
缓存 BI 测试技术
2026通义千问Qwen3.7-Max全解:Agent智能体底座,架构拆解与API实操教程
随着智能体应用快速落地,面向长周期自主任务的大模型成为开发选型的重点,新版通义千问Qwen3.7‑Max作为旗舰文本大模型,主打Agent智能体底座能力,在复杂推理、工程代码开发、超长文档处理、多轮工具调用等方面进行大规模优化,能够支撑长时间连续自动化任务。很多开发者在初次接触该模型时,容易混淆它与同系列其他版本的能力差异,不清楚MoE混合专家架构的运行逻辑,在API接入、工具调用编排时遇到参数配置、返回格式异常等问题。本文将从核心功能、底层技术架构、实操使用方法三个维度完整解析Qwen3.7‑Max,附带可直接运行的API调用代码,讲解参数配置方法,梳理开发过程中的限制条件与避坑要点,帮助开
384 2
|
21天前
|
人工智能 运维 前端开发
接入多家模型供应商之后,我总结的 7 条铁律
AI 应用接了第二家模型供应商之后,事情就不再是"多加一个接口"那么简单——不是调不通,是钱会算错。这篇讲我们定下来的 7 条规则:幂等键、任务落库时机、备用线路的切换边界、退款、凭据隔离、付款来源固化、密钥不进浏览器。
|
26天前
|
存储 NoSQL 安全
用 Java 接入大模型(五):多轮对话的上下文怎么管
本文深入剖析多轮对话的核心误区:大模型本身无记忆,所谓“遗忘”实为上下文管理失当。从messages结构化封装、token精准截断策略,到Redis会话存储与三步排错法,系统讲解如何可靠构建长程对话能力。
186 7
|
21天前
|
人工智能 监控 IDE
Jetbrains 正式官宣:全新AI IDE正式发布!
JetBrains AIR 是全球首个AI原生IDE,定位为“智能体调度台”而非AI供应商。它不内置模型,而是通过ACP协议统一管理Codex、Copilot等第三方智能体,支持多任务并行、实时会话监控、一键子任务与Worktree开发,强调确定性、可审查性与开发者主权。(239字)
170 1
|
24天前
|
人工智能 前端开发 API
阿里云百炼api入口官网:前台和后台,免费领超7000万Tokens
阿里云百炼是其AI大模型服务平台,提供前台官网(介绍、计费、领券)与后台控制台(API Key管理、Token用量查询、模型配置)。新用户可免费领取超7000万Tokens(每模型100万),支持按量付费或订阅计划降本。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
|
28天前
|
监控 安全 算法
驾驶员行为检测数据集 | 22600张YOLO智能驾驶数据集
本数据集含22600张YOLO格式标注图像,覆盖安全驾驶、11种分心/疲劳行为及“其他”共13类,专为疲劳预警、分心识别与驾驶员状态检测设计,适配YOLOv5-v12等主流模型,支持智能座舱、车联网安全等场景研究与落地。(239字)
|
1月前
|
人工智能 自然语言处理 测试技术
Google 开源 ARTEMIS:AI Agent 如何接管 Android 真机测试?
Google开源的ARTEMIS是一款AI驱动的Android自动化测试框架,支持自然语言指令、跨App长流程操作、多模态控件识别(Accessibility+OCR+视觉模型),原生集成MCP协议,可无缝接入Antigravity等AI编程环境,实现“描述目标→自主规划→真机执行→结果分析”闭环,标志着移动端测试迈向AI Agent时代。
|
1月前
|
人工智能 自然语言处理 开发者
豆包与Kimi的内容引用机制:信息密度与平台分布解析
本文分析豆包与Kimi在内容引用上的差异:豆包偏好CSDN等平台的高信息密度技术干货,强调可操作性;Kimi倾向知乎、36氪等平台的深度分析与观点类内容,重视论证逻辑。二者均要求内容具备可验证性、数据支撑与语义完整性,为开发者提供AI搜索优化实践指南。
285 1
|
1月前
|
人工智能 自然语言处理 测试技术
LangGraph Server Agent 框架本地部署指南
本文详解如何在Windows本地离线部署LangGraph Server构建AI Agent:全程不依赖公网大模型,适配llama.cpp等本地模型,提供纯净环境安装、项目模板搭建、UTF-8编码配置及内存调试服务。强调MIT协议核心库免费无限制,但LangGraph Server Lite版年节点执行上限100万次。
216 2