很多 Flink 作业的 checkpoint 间隔设得很短,单次却跑得很久。
本地 RocksDB 刷盘是顺序写,快得多,剩下的大头都在把文件传到对象存储。
这就是这篇要拆的事。
checkpoint 越跑越慢,慢的不是快照,是上传。
先把结论放前面。
增量 checkpoint 传的也不是纯增量。
compaction 会把旧数据重新写成新文件,赶上合并的那一轮就得多传一遍。
对 exactly-once 来说,checkpoint 是刚需,绕不开。
所以问题不是要不要做,是怎么把开销压下来。
要讲清楚这件事,得先看增量 checkpoint 到底存了什么。
RocksDB 是 LSM 树,memtable 刷盘变成 SST,SST 一旦写完就不再改。
刷盘是本地顺序写,跟网络没关系。
慢的那一段,发生在文件离开本地盘之后。
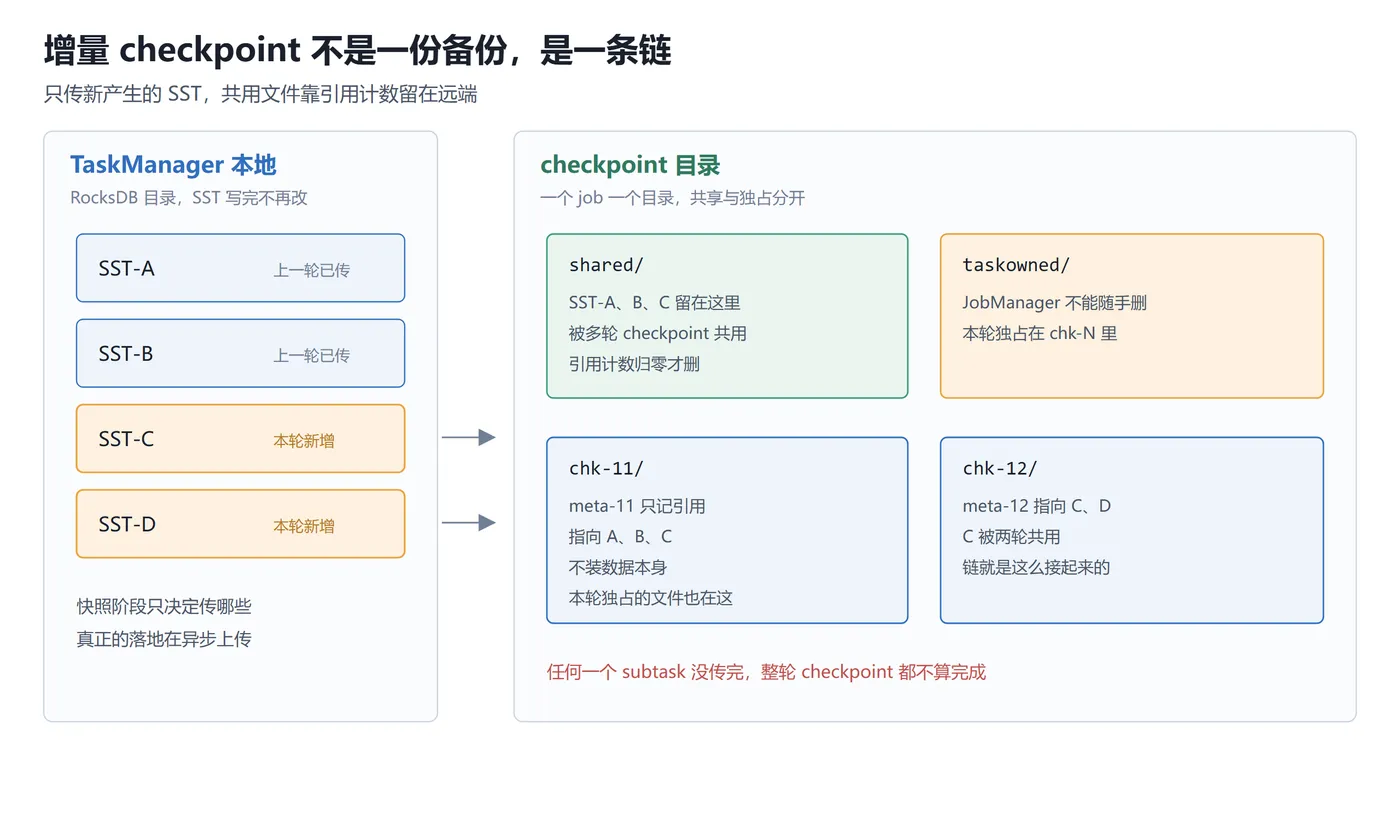
checkpoint 触发时,Flink 让 RocksDB 把这一轮新产生的 SST 挑出来,只传这些,再附一份 metadata。
metadata 里不放数据,只放指向这些 SST 的引用。
目录结构不复杂,一个 job 一个目录,下面分 shared、taskowned 和 chk-N。
shared 放可能被多个 checkpoint 共用的文件,taskowned 放 JobManager 不能删、也不属于某一轮的文件,chk-N 放只属于这一轮的。
共用靠引用计数,认的是 state handle 的物理 ID,不是文件路径。
文件一旦被合并重写,物理 ID 就换了,引用计数也就认不出它是老文件。
所以增量 checkpoint 不是一份完整备份,是一条链,每一轮挂在前一轮后面。
一条链意味着一件事,快照做完,不等于文件已经传完。
增量 checkpoint 的快照阶段只决定这一轮要传哪些文件,真正的落地在异步上传里。
JobManager 收集每个 subtask 的 state handle,全部到齐,这一轮才算完成。
任何一个 subtask 上传翻车,整轮 checkpoint 就失败,上传这关绕不开。
这里还有个容易被忽略的前提。
增量 checkpoint 默认不开,得手动把 execution.checkpointing.incremental 设成 true,这是 2.3 的正名。
很多人以为用了 RocksDB 就自动增量,其实没有。
全量和增量的差别,不只是传多传少。
全量 checkpoint 写的是 Flink 自己的 key/value 快照格式,一份快照自带全部状态,换后端也能读。
增量传的是 RocksDB 的 SST,恢复的时候省掉了重建本地表那一步。
代价是恢复要顺着链把多个 delta 拉下来,链越长,拉得越多。
这也是为什么增量 checkpoint 的恢复时间,可能比全量还长。
savepoint 走的是另一条路。
它默认写成 canonical 格式,所以不能靠增量链。
要保留换状态后端的能力,就得接受全量写一遍。
canonical 格式的好处是跨后端可读,坏处是每次都要全量写。
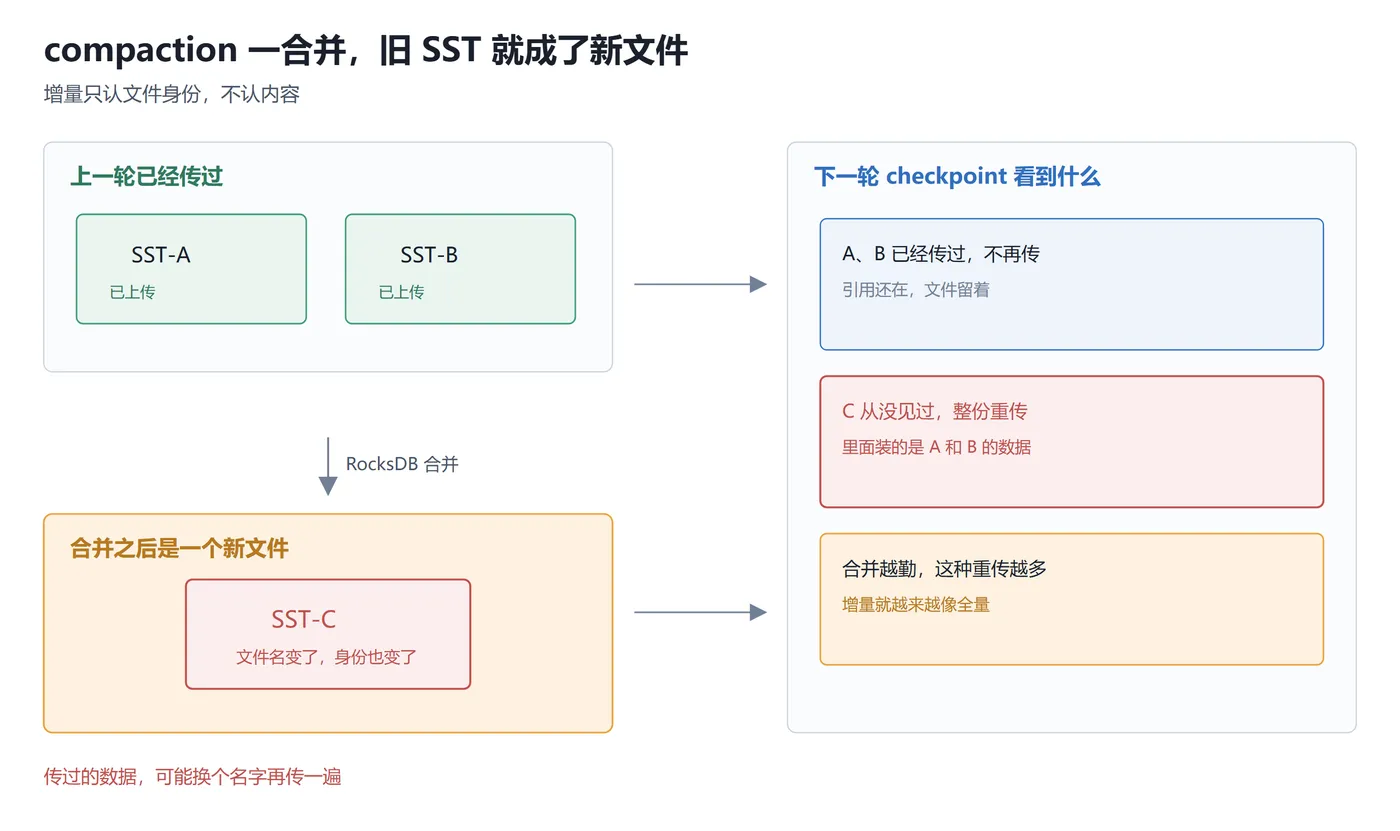
链本身没问题,问题在 compaction。
RocksDB 会把小 SST 合并成大 SST,读得少,文件也少。
但合并出来的是新文件,文件名变了,身份也变了。
在 Flink 眼里,这就是一批从没见过的新 SST,得重新传一遍。
官方文档写得很直白,大多数增量状态后端都会周期性 compaction,结果就是把旧状态重新上传一次。
集群一大,几乎每个 checkpoint 里都有一个 task 在上传大量数据。
所以状态越大、更新越频繁、compaction 越勤,增量 checkpoint 就越像全量。
还有一层放大效应,来自数据分布。
状态是按 key 分到 subtask 的,key 一歪,某个 subtask 的 SST 就特别多。
compaction 也是按本地数据跑的,数据多的节点合并得更勤,重传得也更多。
于是每个 checkpoint 都有一两个重活节点,别的节点早就传完了。
上传还不只是总量的问题,是短板问题。
一个 checkpoint 要所有 subtask 都传完才算完成。
九十九个传得快没用,第一百个慢,整体就慢。
更麻烦的是排队。
文档里说得很清楚,checkpoint 跑得比间隔久,下一个不会提前触发,等当前完成之后立刻开始。
于是系统会一直处在 checkpoint 里,资源一直绷着。
execution.checkpointing.min-pause 能拉开一点距离,但只是把频率降下来,没解决单次为什么慢。
execution.checkpointing.max-concurrent-checkpoints 也不是解药,并发多了只会让上传互相抢带宽。
上传是异步的,但完成事件是同步等的。
JobManager 要等所有 handle 到齐才宣布完成,异步只说明它不挡算子处理数据,不代表完成判定可以提前。
把间隔拉长也不是免费。
间隔越长,两次 checkpoint 之间的 delta 越大,恢复点越旧。
RPO 和上传成本,本来就是跷跷板的两头。
指标也别只看一个。
duration 看总时长,size 看这一轮传了多少,full size 看总状态。
三个一起看,才知道是状态大了,还是这一轮改多了。
真正要看的,是单次 checkpoint 里,时间花在哪一段。
看两段就够了,对应 UI 里的 sync 和 async。
快照阶段长,多半是对齐或反压;上传阶段长,才是这篇文章要说的事。
还有一项开销,很多人根本没注意。
checkpoint 目录是会留下来的。
保留几份由 execution.checkpointing.num-retained 控制,每份增量都引用一批 SST。
引用计数没降到零之前,这些文件不会被删。
所以只要还在产生新 SST,共享目录就会一直长,引用计数归零只回收没人用的旧文件。
FLINK-30461 讲过一个极端场面,上传到一半超时,已经传上去的 SST 没被登记,共享目录里堆到上百万个文件。
这个 bug 在 1.15.4、1.16.2 和 1.17.0 都修了,但它说明了一件事,上传失败不是重来一次就能抹平的,是会留下垃圾的。
本地备份能救恢复,但救不了上传。
execution.checkpointing.local-backup.enabled 打开之后,TaskManager 的本地盘还会留一份状态副本,恢复时可以少拉远端。
但 checkpoint 该传的还得传,这份开销不会消失。
还有一个容易看错的数字。
开了增量之后,Web UI 里的 Checkpointed Data Size 就是刚才说的 size,只是这一轮的 delta,不是全量状态。
看到它很小就以为没事,其实总状态可能已经很大,只是这一轮刚好没怎么改。
真要看清,得看上传耗时、checkpoint 目录的增长速度、以及恢复时要拉多少数据。
恢复这事也有反直觉的地方。
网络带宽是瓶颈时,增量 checkpoint 恢复可能比全量更慢,因为要按链把多个 delta 都拉下来。
CPU 或本地 IO 是瓶颈时,增量反而快,因为不用按 Flink 的 key/value 格式重建本地表。
所以增量和全量之间,不是单纯的新比旧好,得看瓶颈在哪。
那怎么办。
我不太喜欢一上来就调间隔。
间隔被吃满,是上传慢的结果,不是原因。
先看三处。
第一处是重写。
compaction 越勤,重传越多。
能少更新、能提前把 key 打散、能让分布更稳,都是在减少重写。
第二处是上传。
本地盘和对象存储之间的带宽、并发、单文件大小,决定了这一轮要多久。
对象存储按请求计费,一个 SST 至少一次请求,文件越小,请求越多。
同一个目录下对象太多,list 也会变慢,清理和恢复都受影响。
小文件多了,光请求开销就够肉疼,让 SST 少而大,往往更划算。
大文件走分片上传,吞吐能上去,但并发和连接数又成了新的上限。
小文件太碎,在状态大的作业里很常见,调参折腾半天,到头来问题还在文件上。
第三处是换路。
ForSt 在 Flink 2.3 里还是实验特性,SST 直接放远端,天生就是增量。
好处是 checkpoint 时不用再整批搬一次。
代价是状态访问要过网络,延迟敏感的场景不一定合适。
但文档明确说不适合生产,只能当方向看。
三条路里,前两条是今天能动的,第三条是明年再看的事。
说实话,这套机制不算复杂,坑都在细节里。
传的是什么,为什么重传,谁在等谁,哪个数字会骗人。
这四个问题里,踩坑最多的是第一个,很多人根本不知道增量传的是 SST。
把这四件事拆开,checkpoint 慢在哪就清楚了。
checkpoint 的时间,最终都花在上传这一步。
本地快照再快,传不出去,这一轮就不算完。
Flink 2.3 的状态后端文档,增量那一节我翻了几遍,最要紧的就两句。
一句是默认不开,得手动打开;另一句是 compaction 会把旧状态重新上传。
这两句读懂了,剩下的都能自己推。
祝大家的 checkpoint,别卡在末尾那个 subtask 上。