
摘要:窗口是流式聚合的核心骨架——但很多人只会用固定窗口,不知道滑动窗口的状态代价、会话窗口的动态边界,更说不清 watermark 到底在哪个时刻触发窗口关闭。本文把窗口机制一次讲透:三种窗口的本质差异(滚动切片、滑动重叠、会话按 gap 动态成窗)与状态量公式;窗口与 watermark 联动的完整生命周期(开启、聚合、追加、过期四阶段);迟到数据的三种处置策略(丢弃、update 修正、多水印容忍)及选择依据;三个案例分别落地 GMV 滚动窗口、滑动告警、会话统计;最后是实践中最容易翻车的三个问题——窗口不输出、状态膨胀、时间字段用错。
关键词:Structured Streaming, Spark, 窗口操作, 滚动窗口, 滑动窗口, 会话窗口, session window, Watermark, 迟到数据, 事件时间
一、窗口的本质:把无界流切成"有界的小表"
流数据没有起点和终点,聚合必须有边界——窗口就是把无限事件流切成一串有界小表的机制。每条数据按事件时间落入一个或多个窗口,聚合在各窗口内独立进行,像给流水账盖上一枚枚时间戳的章。
窗口不是凭空切的,它由三个问题定义:窗口多长(窗口长度)?多久开一个(滑动间隔)?按什么时间切(事件时间还是处理时间)?前两个问题的组合产生三种窗口,最后一个问题决定了统计口径——生产上 99% 用事件时间(数据自带的发生时间),处理时间(到达 Spark 的时间)只用于监控。
二、三种窗口:切片方式决定状态代价
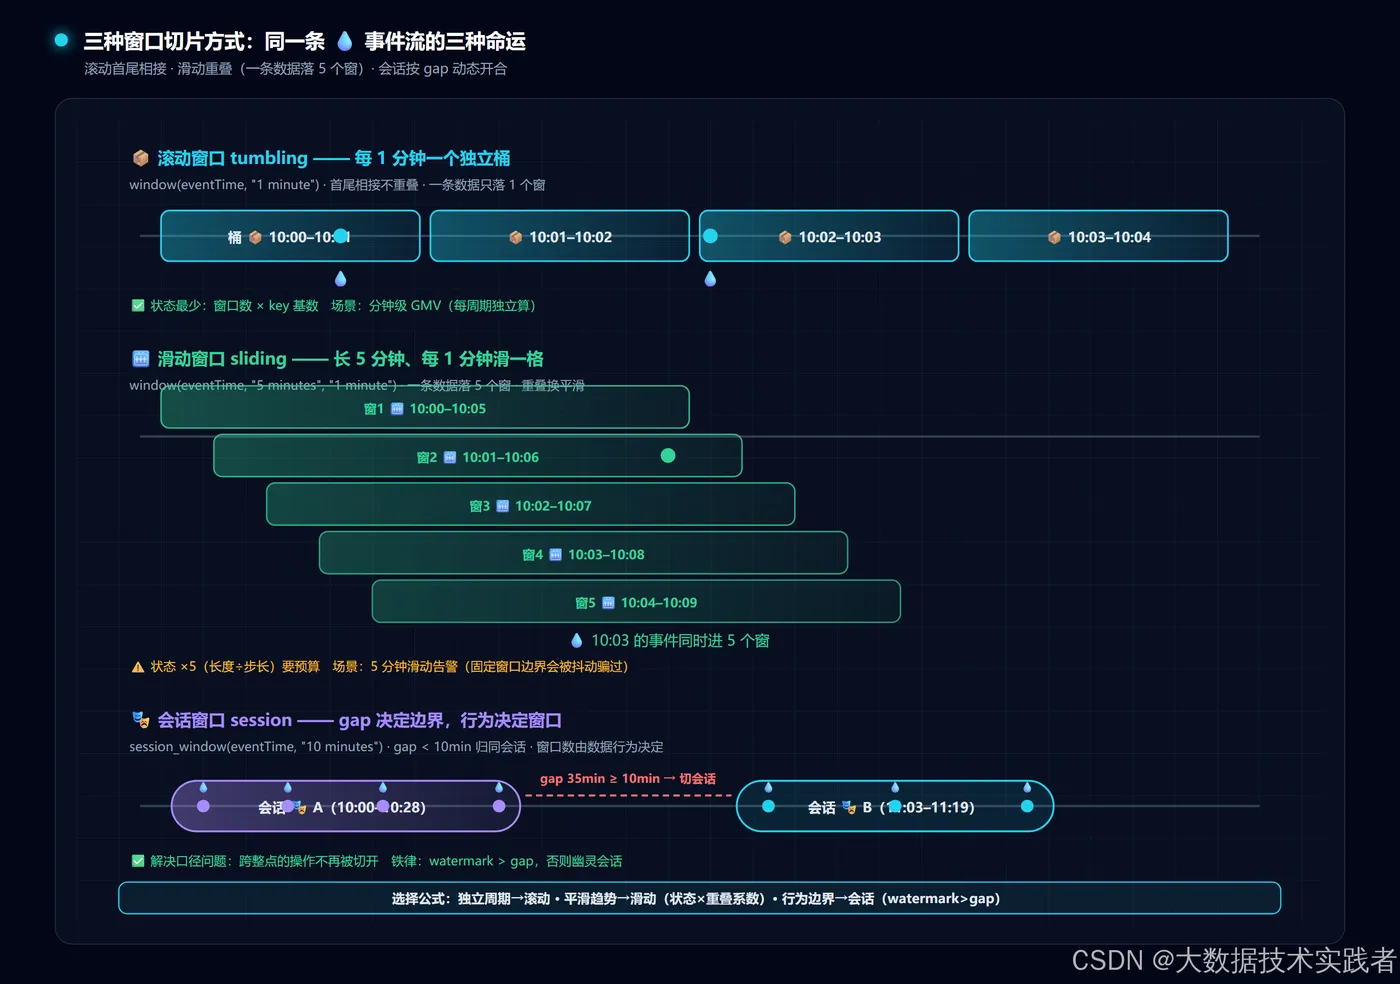
| 维度 | 滚动窗口 | 滑动窗口 | 会话窗口 |
|---|---|---|---|
| 切片方式 | 固定长度、首尾相接 | 固定长度、按步长重叠 | 按 gap 动态开合 |
| 一条数据落入 | 1 个窗口 | 长度÷步长 个窗口 | 0 或 1 个动态窗口 |
| 状态量 | 窗口数 × key 基数 | 窗口数 × 重叠系数 × key 基数 | 活跃会话数 |
| 典型场景 | 分钟级 GMV | 5 分钟滑动告警 | 用户行为会话 |
滚动窗口(tumbling):window(eventTime, "1 minute")——每分钟一个完整的桶,无重叠。最简单、状态最少,"每个统计周期独立算一遍"的场景直接用它。
滑动窗口(sliding):window(eventTime, "5 minutes", "1 minute")——窗口长 5 分钟,每 1 分钟滑动一格。一条数据会同时落进 5 个窗口(长度÷步长),状态量也随之 ×5。它的价值是"平滑趋势":固定窗口在边界处会剧烈跳变(59 秒与 61 秒的数据被切开),滑动窗口每一步都有完整 5 分钟视角,告警阈值不会被窗口边界骗过。
会话窗口(session):session_window(eventTime, "10 minutes")——没有预设边界,事件之间的 gap 小于 10 分钟就归入同一会话,超时就切一个新会话。窗口数由数据行为决定:活跃用户多会话就多。它解决了"用户操作跨过整点被切成两段"的口径问题,代价是窗口边界不可预测、关闭依赖 watermark 推进。
三、窗口与 watermark 的联动:四阶段生命周期
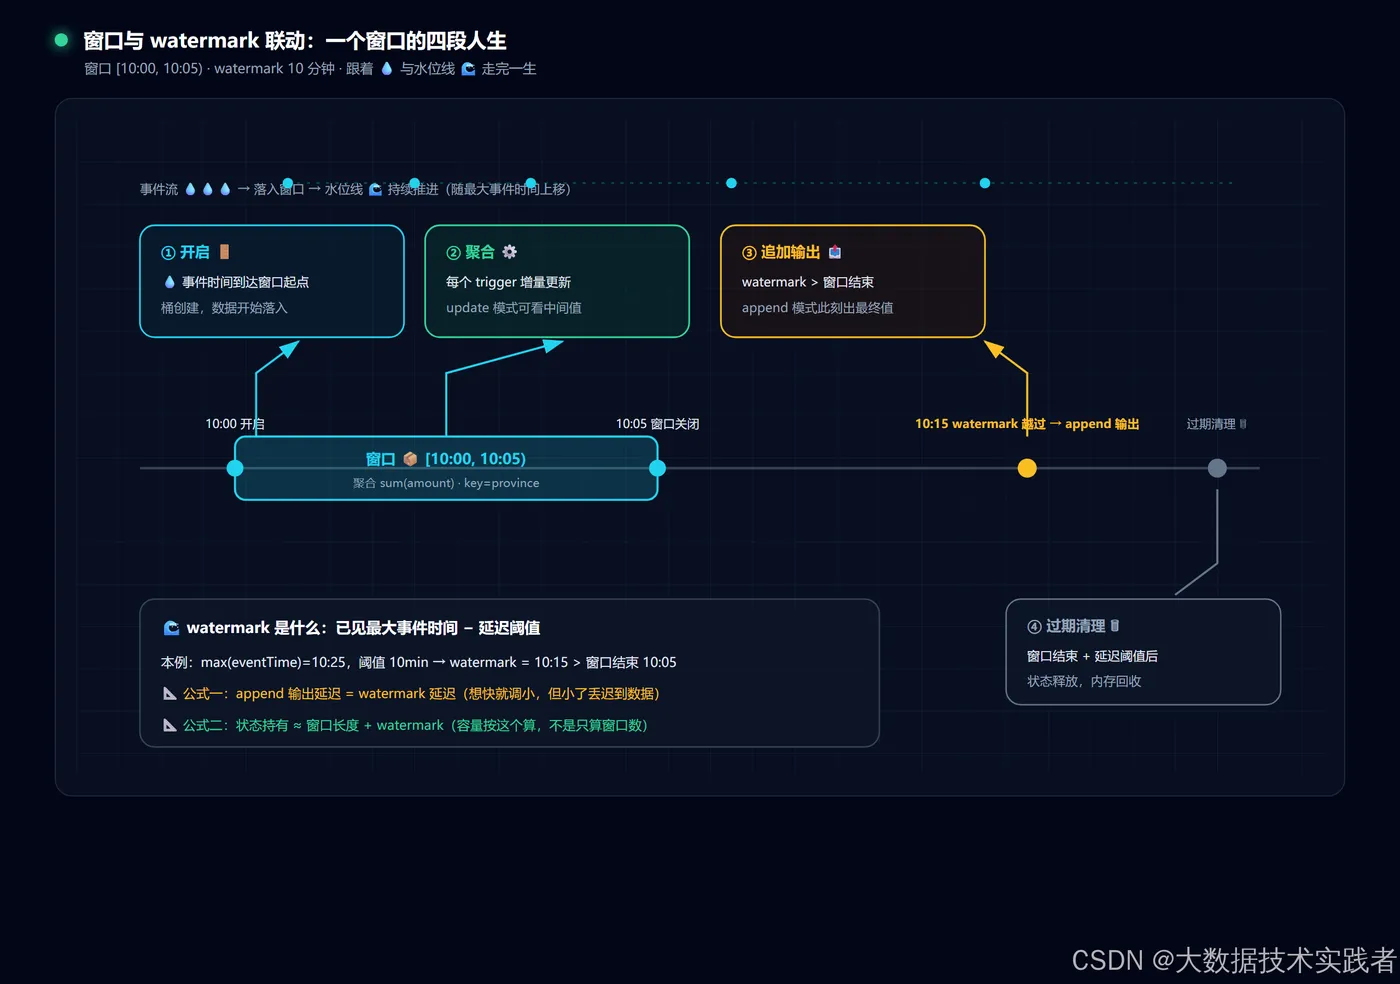
window 和 watermark 是绑定的——不带 watermark 的窗口聚合要么不能输出(append 模式没有输出时机),要么状态无限膨胀(update/complete 模式永不清理)。一条窗口的生命周期分四阶段:
orders
  .withWatermark("eventTime", "10 minutes")   // ① 水位 = 已见最大事件时间 − 10min
  .groupBy(window($"eventTime", "5 minutes"), $"province")
  .agg(sum("amount").as("gmv"))
阶段一·开启:窗口结束时间到达前,数据持续落入对应窗口桶;阶段二·聚合:每个 trigger 增量更新桶内聚合值(update 模式可实时看到中间值);阶段三·追加:当 watermark > 窗口结束时间,引擎确认"这个窗口不会再有数据"——append 模式此刻才输出最终值;阶段四·过期:watermark 再推进(部分实现里窗口结束 + 延迟阈值之后),窗口状态被清理释放。
两个关键公式记牢:append 输出延迟 = watermark 延迟(想要窗口关得快就把 watermark 设小,但设太小会丢迟到数据);状态持有时间 ≈ 窗口长度 + watermark 延迟(容量规划按这个算,不是只算窗口数)。
四、迟到数据的三种处置
迟到(事件时间 < 当前 watermark)不可避免——网络重传、客户端缓存、分区重平衡都会造成。三种处置按业务容忍度选:
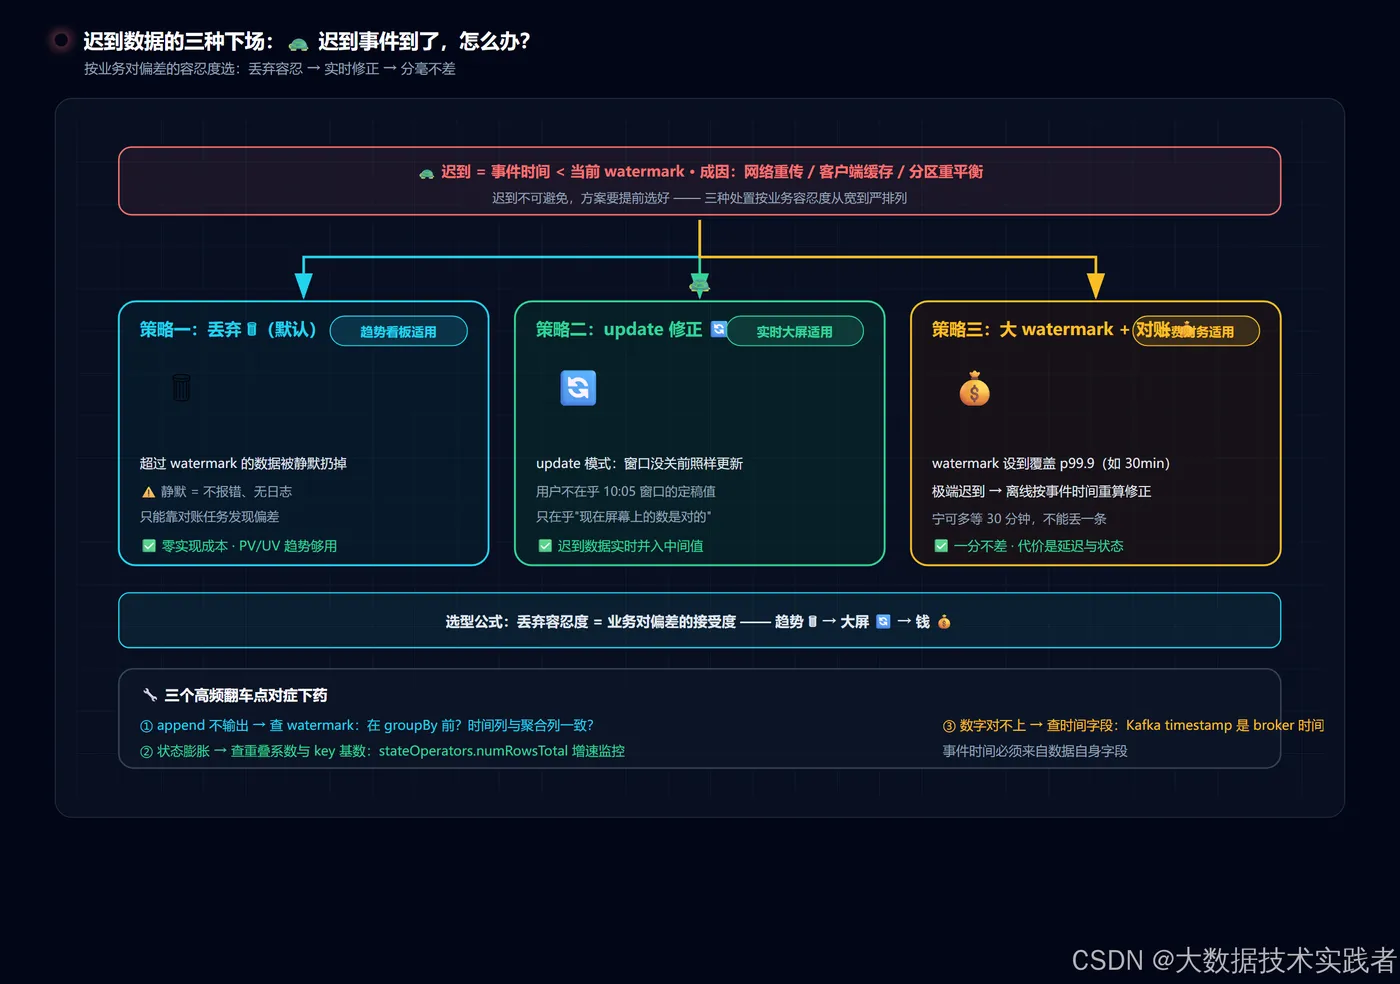
策略一:丢弃(默认)。超过 watermark 的数据被静默扔掉。适合丢一点无所谓的统计(PV、UV 趋势),实现零成本。注意"静默"——不会报错、不会有日志,只能靠对账发现。
策略二:update 修正。用 update 输出模式,窗口没关闭前迟到的数据照样更新中间值。适合大屏类"当前累计值"场景——用户不在乎 10:05 那个窗口的最终定稿,只在乎现在显示的数是对的。
策略三:多 watermark 容忍 / 离线对账。把 watermark 设大到覆盖 p99.9 迟到(比如 30 分钟),极端迟到交给离线任务按事件时间重算修正。适合计费、财务类"一分不能差"的场景——宁可多等 30 分钟,不能丢一条。
选型公式:丢弃容忍度 = 业务对偏差的接受度。趋势看板选策略一,实时大屏选策略二,钱相关选策略三。
五、案例 A:分钟级 GMV——滚动窗口的标准用法
val gmv = orders
  .withWatermark("eventTime", "2 minutes")
  .groupBy(window($"eventTime", "1 minute"), $"province")
  .agg(sum("amount").as("gmv"),
       count("*").as("order_cnt"))

gmv.writeStream
  .outputMode("append")                        // 窗口关了才出最终值
  .format("kafka")
  .option("topic", "gmv_1m_final")
  .start()
要点:watermark 2 分钟是实测迟到分布(p99 ≈ 40 秒)加余量的结果,不是拍脑袋;append 输出意味着每分钟 GMV 在窗口结束约 2 分钟后定稿——业务方接受了这个延迟换取"数字不再变"。
六、案例 B:滑动告警——用重叠换平滑
val alerts = metrics
  .withWatermark("ts", "3 minutes")
  .groupBy(window($"ts", "5 minutes", "1 minute"), $"service")
  .agg(avg("latency").as("avg_latency"),
       max("latency").as("p_max"))
  .filter($"avg_latency" > 800)               // 阈值判断放在窗口聚合后

alerts.writeStream
  .outputMode("update")                        // 每分钟刷新最近 5 分钟均值
  .foreachBatch(upsertAlertStore _)
  .start()
要点:为什么不用固定 5 分钟窗口——服务在 12:04:59 与 12:05:01 的抖动会被固定窗口切开稀释,滑动窗口每分钟都有完整的 5 分钟视角,抖动立刻可见;状态代价是 5 倍重叠,service 数量 × 5 个并发窗口要提前算容量;filter 放在聚合后让告警条件跟随每个滑动步长重估。
七、案例 C:会话统计——gap 定义行为边界
val sessions = events
  .withWatermark("eventTime", "15 minutes")    // 必须 > gap
  .groupBy(session_window($"eventTime", "10 minutes"), $"userId")
  .agg(count("*").as("actions"),
       approx_count_distinct($"itemId").as("items"))

sessions.writeStream
  .outputMode("update")
  .foreachBatch(upsertSessionStore _)
  .start()
要点:watermark > gap 是硬约束(本例 15 > 10)——watermark 推进过"最后事件 + gap"才会话关闭,设小了尾部事件会开出幽灵会话;会话中的统计持续更新(用户还在操作),关闭后定稿;approx_count_distinct 在会话这种高基数场景比 exact 去重省一个数量级内存。
八、三个高频翻车点
窗口不输出(append 模式):九成是没设 watermark——引擎无法确认窗口死亡,永远等下去。检查 withWatermark 是否在 groupBy 之前、时间列与聚合列是否一致。
状态持续膨胀:滑动窗口按重叠系数放大状态;key 基数大(userId 级)时再乘上去。监控 lastProgress 的 stateOperators.numRowsTotal,增速不为零就要评估 RocksDB state store 或降低窗口重叠。
时间字段用错:把处理时间当事件时间用(Kafka source 的 timestamp 列是 broker 写入时间),大屏数字与离线对不上。事件时间必须来自数据自身字段,且要先验证上游时钟没有明显偏移。
九、总结
- 三种窗口的本质是三种切片:滚动首尾相接、滑动按步长重叠(状态 ×重叠系数)、会话按 gap 动态开合(边界随行为);
- window 与 watermark 绑定使用:四阶段生命周期(开启→聚合→追加→过期),append 输出延迟 = watermark 延迟,状态持有 ≈ 窗口长度 + watermark;
- 迟到三策略按容忍度选:丢弃(趋势)/ update 修正(实时大屏)/ 大 watermark + 离线对账(计费);
- 三个案例各取一种窗口:GMV 用滚动(独立周期)、告警用滑动(重叠换平滑,状态×5 要预算)、会话用 session(watermark > gap 是铁律);
- 高频翻车点对症:不输出查 watermark、膨胀查重叠系数与 key 基数、对不上账查时间字段来源——窗口问题的答案,一半在窗口参数,一半在 watermark 与时间口径。
