
2008 年,一家电商公司想知道「昨天卖了多少」。运维连上订单库,跑一条 GROUP BY,三秒出结果。
2026 年,同样的问题,答案要实时亮在大屏上。而这「三秒」背后站着 Kafka、Flink、Paimon 和对象存储。
数据没变,问题也没变。变的是这个问题被问了多少次、被多少人在等、被追问得多细。
所以「数据架构演变」这六个字,如果只理解成技术栈升级——MySQL 换成 Hive、Storm 换成 Flink——就把因果搞反了。真正的主线只有一条:
状态放在哪里,决定了这套架构要维护几套系统。
状态越集中,重复计算就越少;重复计算越少,口径就越不容易出错。五代的演进,本质上都是把状态往更靠底层、更共享的位置挪一格。
一、先看全景:目标态长什么样
在逐个拆解历史之前,先把「终局」摆出来。因为后面四代的所有妥协,都是为了绕开这张图里已经解决掉的问题。
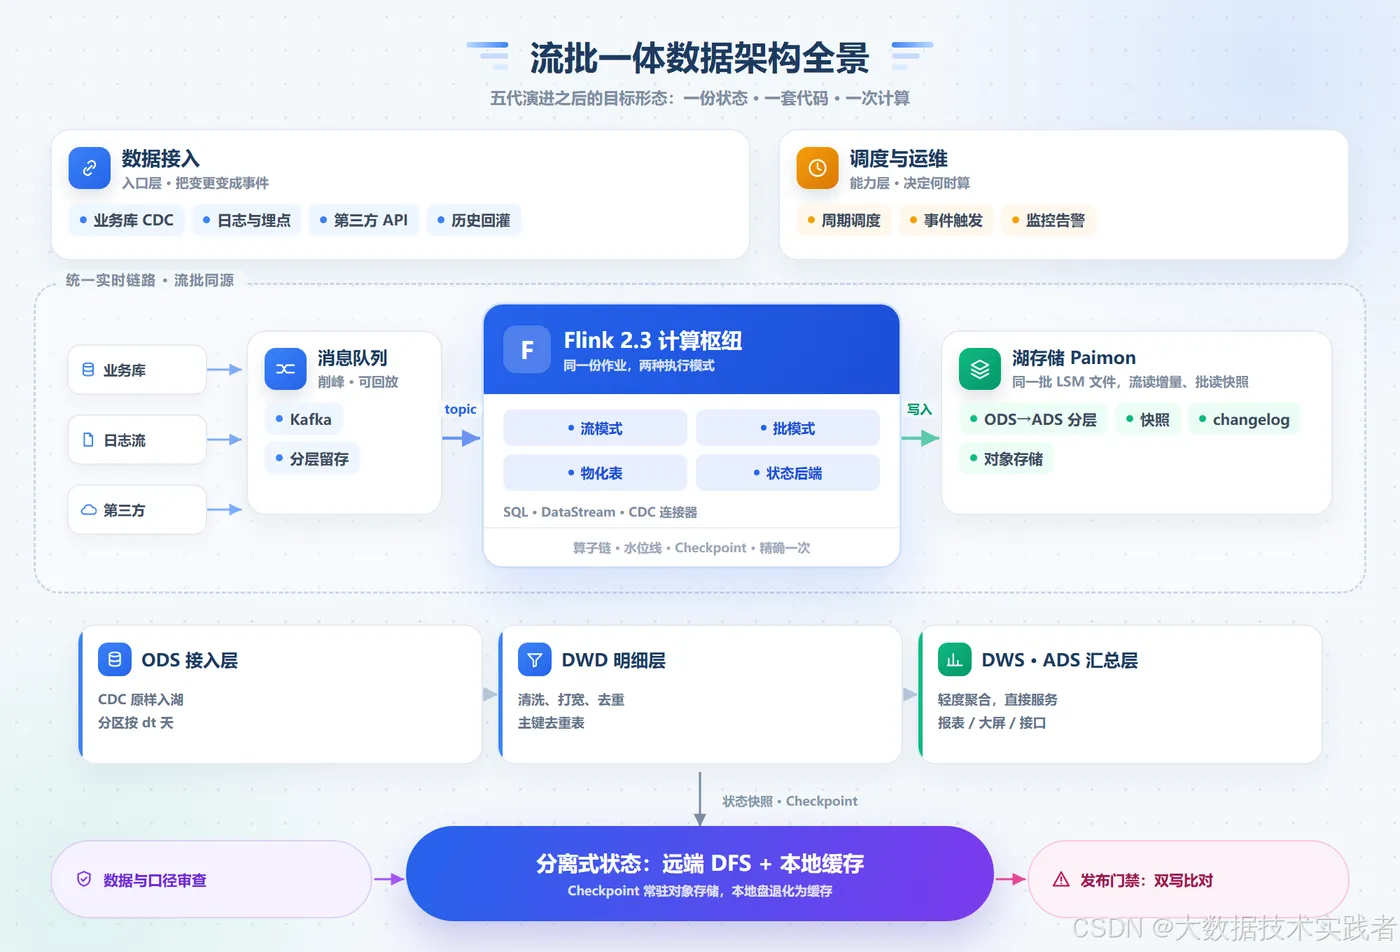
这张图值得多看两眼,它把几个容易混淆的东西一次性摆清了:
接入层只管把变更变成事件。 业务库 CDC、日志埋点、第三方 API,进的都是同一条消息队列。
计算层只有一个枢纽。 流模式、批模式、物化表、状态后端——同一份作业,两种执行方式,而不是两套代码。
存储层只有一份。 ODS → DWD → DWS/ADS 四层建模,每层都是湖表。流读拿增量,批读拿快照,读的是同一批 LSM 文件。
治理层管的是口径,不是数据。 数据与口径审查、双写比对、发布门禁,全都长在这份共享存储上。
四层里没有「离线链路」这个词。不是它被删了,是它被合并了。
二、单体到微服务:状态先集中,再散开
最早的企业系统是单体的。订单、库存、会员、财务挤在一个应用里,数据存在同一个关系型数据库。
这种结构的好处被严重低估了:状态是唯一的。 查订单就查订单表,算总额就 SUM,不存在「两份数据对不上」这种事。
它的问题是规模。业务越加越多,代码越来越缠;更致命的是分析会打死生产——一个分析师跑个全表扫描,交易接口跟着超时。这不是段子,是十年前 DBA 的日常。
矛盾在这里第一次显形:交易要短事务、高并发、强一致;分析要大范围扫描、宽松一致性、吞吐优先。 一个库同时满足这两件事,越来越难。
解法是把系统拆开:一个服务一个库,各自演进,各自扩容。扩展性解决了,代价立刻出现——状态散落在几十个数据库里。
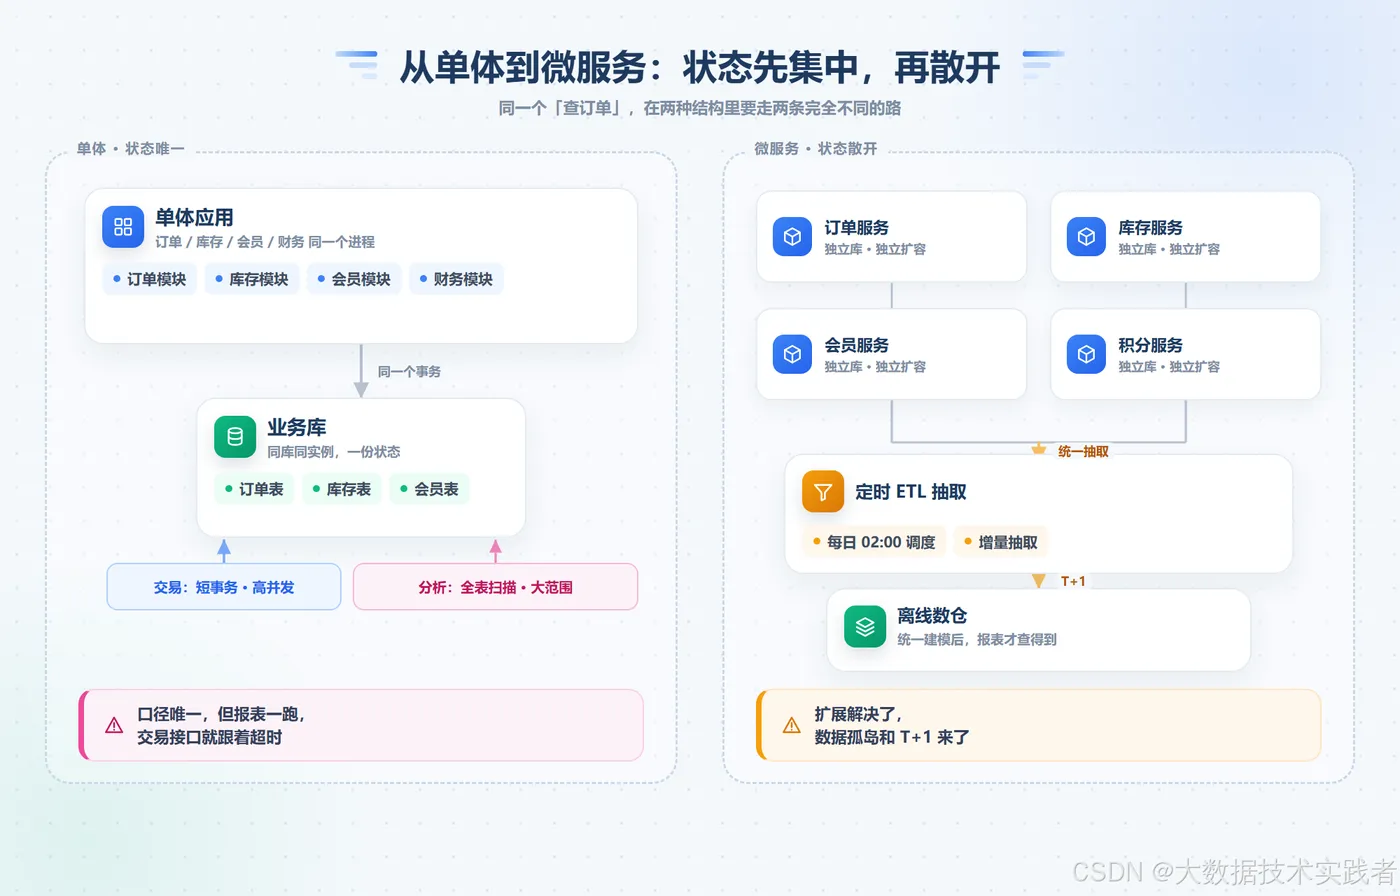
左边是「一份状态,两种用法争抢」;右边是「几十份状态,谁也看不见谁」。
用户想看的「我的订单 + 我的优惠券 + 我的积分」,在三个库里;老板想看的「各品类毛利」,在八个库里。于是 ETL 登场:定时任务从各业务库抽数,清洗、转换、装载到数据仓库,再统一建模。
注意这里的妥协:数据是「搬」过去的,所以永远滞后一个周期。T+1 的报表,本质上是架构决定的,不是技术不够好。
三、Lambda:一份指标,算了两遍
业务不满足于 T+1。运营要大屏,风控要秒级,老板开会时要看「现在」。
Lambda 的答案是分工:批处理层管准确,速度层管及时,服务层负责合并查询。 离线链路用 Hive/Spark 跑全量,保证最终正确;实时链路用 Storm/Flink 处理增量,保证分钟级可见。
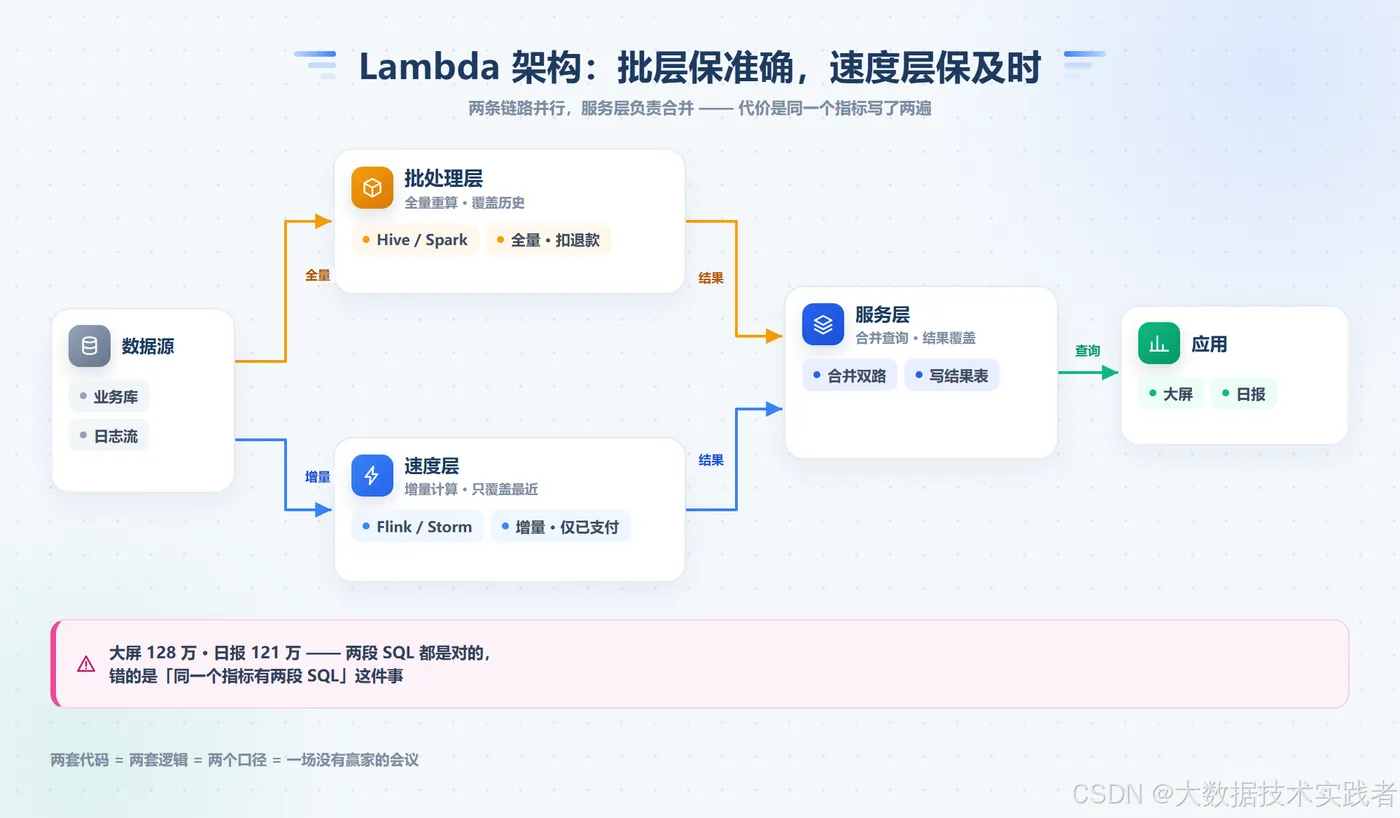
这个思路在 2010 年代被大量采用,也确实解决了很多问题。但它埋了一个几乎无解的雷:同一个指标,被写了两遍。
离线链路一段 SQL,实时链路一段 Java 或者另一段 SQL。上线半年后,两边开始漂移:一个用 user_id 去重,一个用 device_id;一个过滤了退款单,一个没过滤。
结果是大屏显示 128 万,日报里写 121 万。运营问:哪个对?
我见过一个更典型的版本。实时链路为了压低延迟,只算了「已支付」;离线链路按财务口径,扣掉了「已退款」。上线三个月没人发现,直到财务对账差了 7%,两条链路的负责人各自拿着自己的 SQL 互相证明对方是错的——两段 SQL 都是对的,错的是「同一个指标有两段 SQL」这件事本身。
这不是技术 bug,是架构的必然产物。两套代码 = 两套逻辑 = 两个口径 = 一场没有赢家的会议。运维成本同样翻倍:两套集群、两套监控、两套值班、两种故障处理方式。
四、Kappa:只留一条流
2014 年,Jay Kreps 写了一篇《Questioning the Lambda Architecture》,提出另一个答案:既然流处理能算增量,那它能不能也负责重算历史?
能——只要消息队列存得下历史,重放一遍就是了。批处理不是另一种计算,只是「有界流的处理」。这就是 Kappa:只有一条流处理链路,需要重算时重新消费。
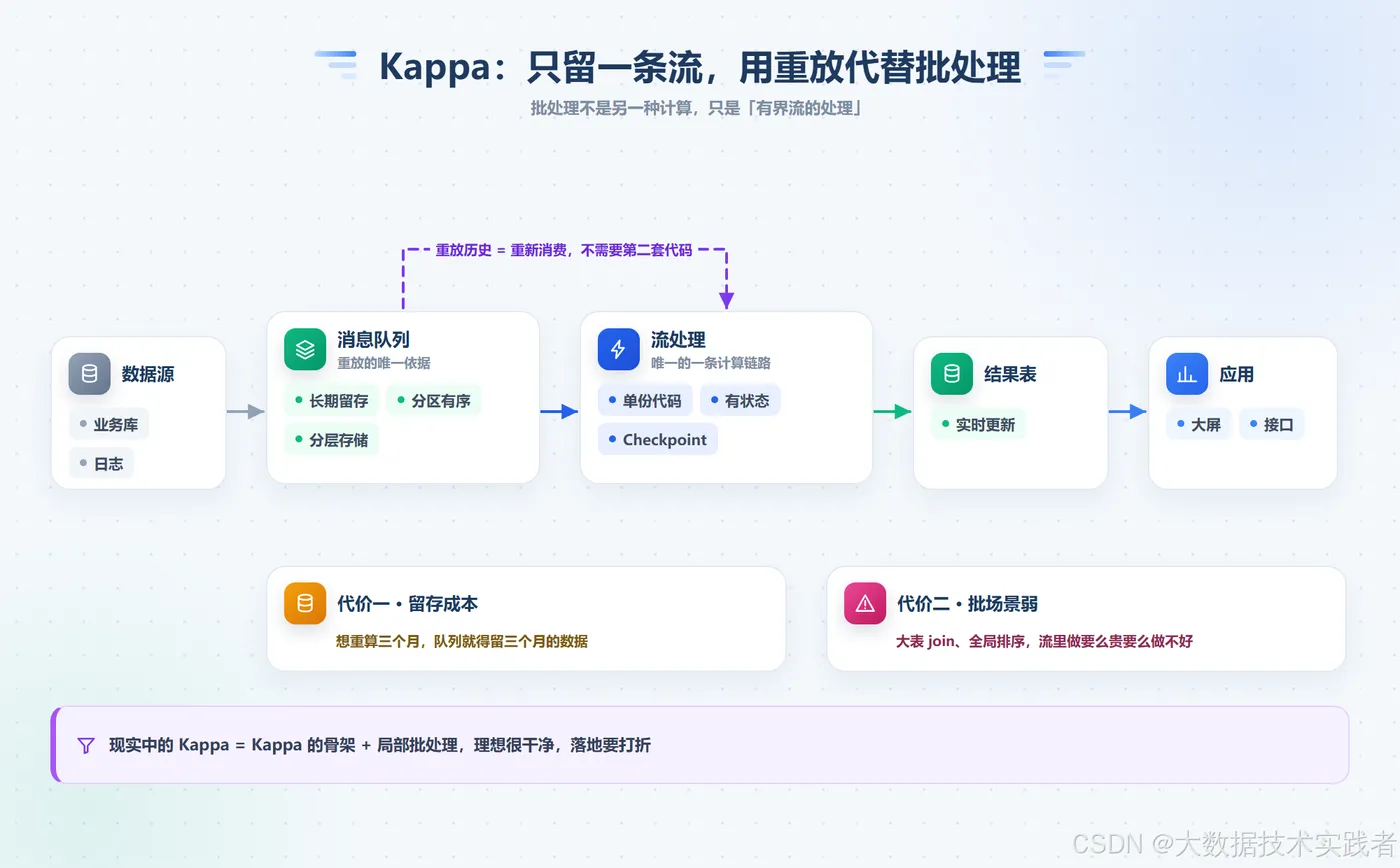
双份代码消失了,口径自然统一。但它把压力全转移到了两个地方:
一是留存成本。 想重算三个月,队列就得留三个月的数据。Kafka 的留存策略、分层存储、对象存储卸载,都是为这件事服务的。
二是流处理引擎的能力。 大表 join、全局排序、复杂的多路聚合,这些批处理的强项,用流的方式做要么成本高,要么根本做不好。
所以现实中的 Kappa,往往长成了「Kappa 的骨架 + 局部批处理」。理想很干净,落地要打折。
五、流批一体:三个「同一」
如果 Lambda 的问题是「算了两次」,Kappa 的问题是「只能算一次但很贵」,那真正的解法只有一个方向:
让流和批共用同一套代码、同一份状态、同一份存储。
注意这三个「同一」,少一个都不算成立:
- 同一套代码,口径才不会漂移;
- 同一份状态,切换执行模式才不用重建;
- 同一份存储,数据才不会搬来搬去。
Flink 从 1.12 开始支持批执行模式,让 DataStream API 用同一段代码跑两种模式,这是「同一套代码 + 同一份状态」。而「同一份存储」这块,答案来自湖。
Apache Paimon(前身 Flink Table Store)把表做成了 LSM 结构:写入不断产生新文件,后台合并。妙处在于——同一份文件既是流的 changelog,也是批的表。流读拿到增量,批读拿到快照,读的是同一批文件。
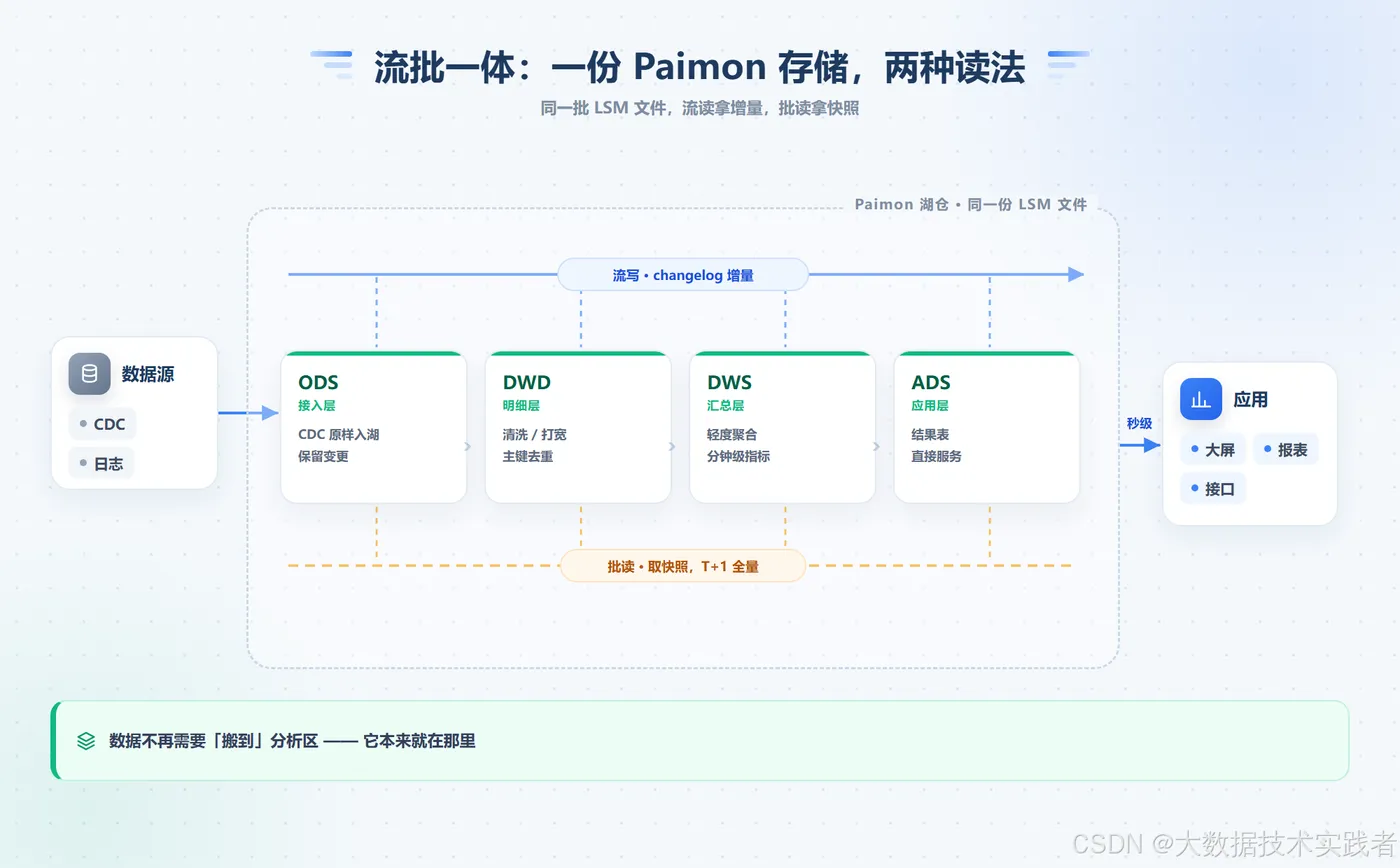
于是分层可以这样长:ODS 接 CDC,DWD 做清洗打宽,DWS 做轻度聚合,ADS 直接服务报表。每一层都是 Paimon 表,上游流写、下游流读是实时的;同一张表被批任务读,就是离线视图。
数据不再需要「搬到」分析区,它本来就在那里。
六、Flink 2.3 把这个方向落成了什么
理念好听,落地要看具体机制。2.3 里跟这件事直接相关的有三样。
物化表:让引擎替你选流还是批
物化表(Materialized Table)从 1.20 引入,思路是:你只声明「这张表要多久新鲜一次」,引擎决定用流还是批去刷。
CREATE MATERIALIZED TABLE dws_order_1min (
  PRIMARY KEY (user_id) NOT ENFORCED
)
PARTITIONED BY (dt)
FRESHNESS = INTERVAL '1' MINUTE
AS
SELECT user_id, COUNT(*) AS order_cnt, SUM(amount) AS gmv
FROM dwd_order
GROUP BY user_id;
FRESHNESS 是关键参数。声明 1 分钟,引擎起一个常驻流作业持续刷新;声明 1 天,引擎交给调度器周期性跑批。同一句 SQL,两种执行方式,你不需要关心底层是哪一种。
如果业务明确知道该用哪种,也可以直接指定 REFRESH_MODE,它的优先级高于 FRESHNESS:
| 声明方式 | 引擎行为 | 适合什么 |
|---|---|---|
| FRESHNESS 1 分钟 | 倾向 CONTINUOUS,起常驻流作业 | 大多数实时表 |
| FRESHNESS 1 天 | 倾向 FULL,交给调度器跑批 | 日更报表、T+1 指标 |
| REFRESH_MODE 连续 | 常驻流作业,持续刷新 | 需要秒级可见 |
| REFRESH_MODE 全量 | 周期跑批,覆盖分区 | 全量重算成本可接受 |
这才是「流批一体」落到开发者手上的样子:不再是两个 API 之间的选择,而是一个时间参数的填写。
START_MODE:改逻辑不用重跑历史
物化表有个隐藏成本:改了定义查询,默认从源头重跑全部历史。一个跑了两年、状态几百 G 的作业,改一列就要重放两年数据,生产上几乎不可接受。
2.3 引入了 START_MODE,把「从哪开始处理」和「旧状态要不要留」拆成两个独立开关:
ALTER MATERIALIZED TABLE dws_order_1min
  SET START_MODE = RESUME_OR_FROM_NOW(INTERVAL '1' HOUR)
  SET STATE_RETENTION = ALL
AS
SELECT user_id, COUNT(*) AS order_cnt, SUM(amount) AS gmv
FROM dwd_order
WHERE amount > 0
GROUP BY user_id;
可选值很直白:FROM_BEGINNING(默认,全量重算)、FROM_NOW、FROM_TIMESTAMP,以及 RESUME_OR_* 系列——优先从上一个作业停下的位点续跑,拿不到位点再回退。
STATE_RETENTION 则决定旧状态是 ALL、NONE 还是 PTF_ONLY。
这两个参数看着是语法糖,实际影响的是架构演进的经济性。加一个可空列、改一处过滤条件,从此不用付重放全量历史的账单。
原生 S3:状态外置才谈得上便宜
2.x 最大的架构变化是分离式状态:状态常驻远端 DFS,本地盘退化成缓存。这个方案成立的前提是——远端存储要足够便宜、足够快。
2.3 交付了 flink-s3-fs-native,基于 AWS SDK v2 重写,甩掉整棵 Hadoop 依赖树,JAR 从 30–93 MB 降到约 13 MB。官方基准里 Checkpoint 平均耗时从 Presto 插件的 90.1 秒降到 48.8 秒。
看起来是连接器的事,其实是架构的事:状态存在对象存储上的成本,直接决定了你敢不敢做那份「一份存储」的承诺。
七、真要迁移,分三步走
如果现在就有一套 Lambda 在跑,别指望一次性推翻。比较稳的路径是三步。
第一步,先做双写校验,不动读链路。 用 Flink 起一条新链路,把实时结果写进湖表,同时保留原 Lambda 的两条老链路。每天跑一次比对任务,比对两边的差异,直到差异能收敛到 0 或者能解释清楚。
这一步的价值不是切换,是把口径漂移从「吵架」变成「数据」。差异在哪、差多少、为什么差,全部量化。
第二步,把读请求切到新表,老链路降级为影子。 关键在下游改造:报表、大屏、接口都要换数据源。建议按「先内部、后对外」「先非核心、后核心」的顺序切。
第三步,删掉旧链路。 最难的不是技术,是心理——总有人想留个「万一」。留三个月可以,留一年就是双份成本,等于没迁。
这三步里,最容易被跳过的是第一步,而它恰好是唯一能证明「新架构确实更准」的环节。
八、这套架构的真实代价
讲到这里,很容易得出「都该上流批一体」的结论。但代价必须说清楚。
组件更多,排障链路更长。 单体时代查一个问题看一个库,现在要看 Kafka 有没有积压、Flink 有没有背压、Paimon 小文件是不是太多、对象存储限流没有。链路里每个环节都能成为瓶颈。
小数据量是纯负担。 每天几百万条数据、延迟容忍十分钟的业务,上这套架构属于用航母送快递。Spark 定时跑一把,或者直接用数仓 SQL,成本可能只有十分之一。
它对团队有要求。 状态管理、水位线、Checkpoint 调优、小文件合并——这些东西不看文档就会踩坑,且踩了不好查。
什么情况下不该上:延迟容忍超过 5 分钟、状态规模在 10 GB 以内、团队没有专人维护流作业。三条中占两条,就别上。
什么情况下该上:多源实时关联、口径必须唯一、下游对延迟敏感、状态会持续增长到 TB 级。也是三条中占两条。
九、回头看这五代
把四代架构摆在一起看,抽象的层次其实很清楚:
| 阶段 | 状态在哪 | 算几次 | 主要代价 |
|---|---|---|---|
| 单体 | 一个关系库 | 一次(OLTP) | 分析打爆交易 |
| 微服务 | 分散在多个库 | 抽出来再算 | 数据孤岛、T+1 |
| Lambda | 批层 + 速度层各一份 | 两次 | 口径漂移、双份运维 |
| Kappa | 消息队列 | 一次(可重放) | 留存成本、批场景弱 |
| 流批一体 | 共享湖存储 | 一次(同代码) | 组件复杂、团队门槛 |
每一代的进步,都是把「状态」往更靠底层、更共享的位置挪了一格:从应用内 → 独立库 → 各自的存储 → 统一的湖。
Flink 2.3 做的那些事——物化表补 DDL、START_MODE 控制重算、原生 S3 降低存储成本——本质都在降低「把状态放到共享层」的门槛。
技术选型从来不是选最强的,是选你能维护得住的那一层抽象。
你们现在这套链路,状态到底放在哪?是还在两套代码各算一遍,还是已经收拢到一份存储上了?评论区聊聊。
