9.0 起
POST _ml/anomaly_detectors/<id>/_flush标记弃用。官方给的理由是一条因果链:flush 只在 post data API 下才需要,而 post data 从 7.11.0 就弃用了。所以 flush 跟着一起弃用。源码里的弃用消息还提到了下一步方向:未来必须用 datafeed。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.0.0.yml、RestFlushJobAction.java、ml.post_data.json),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
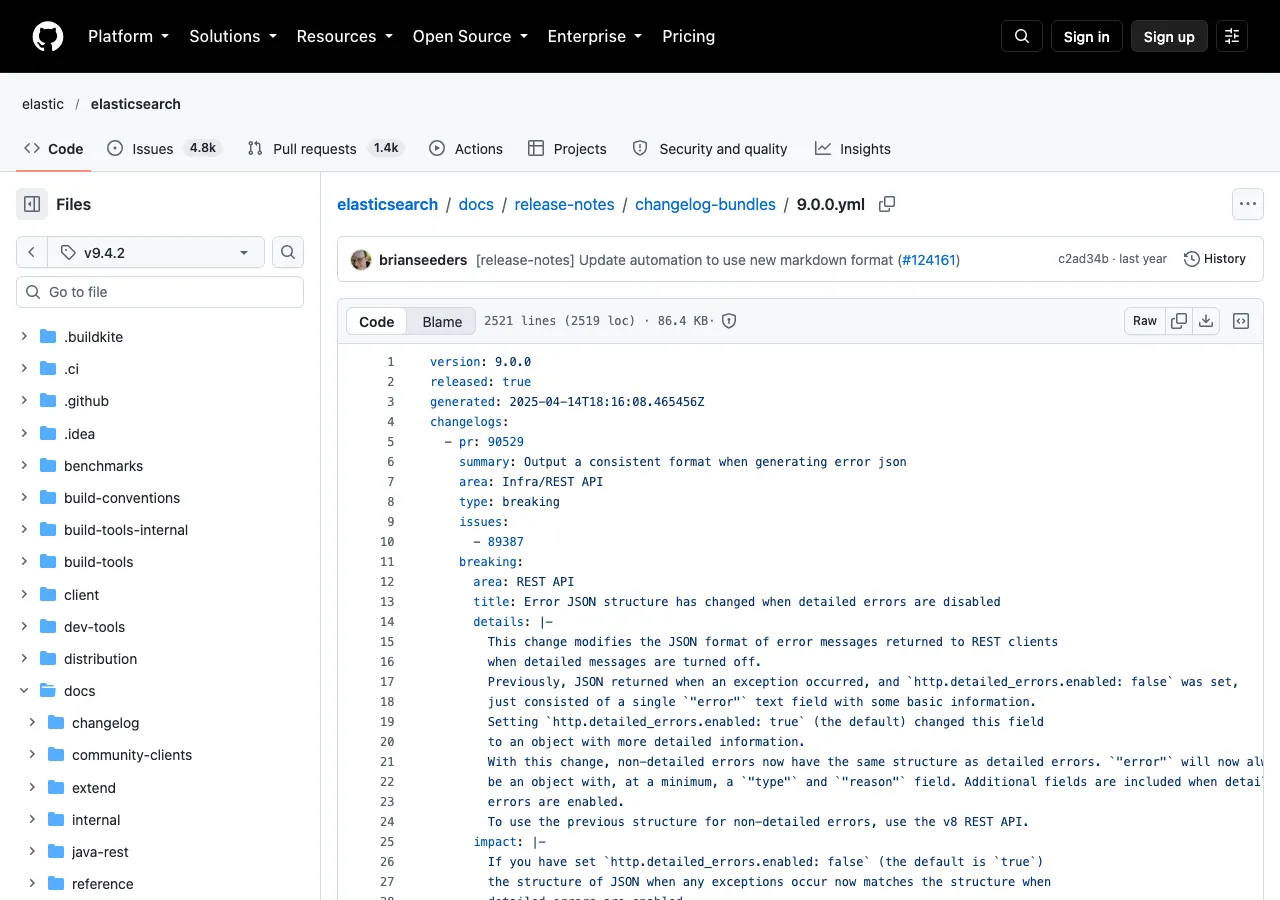
图 1:官方文件 9.0.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.0.0.yml
官方条目
9.0 的 changelog 标为 deprecation(9.0.0.yml 第 1980–1990 行 @ v9.4.2),area: Machine Learning,关联 issue 121506。
details 说明了原因:
The anomaly detection job flush API is deprecated since it is only required for the post data API, which was deprecated since 7.11.0.
impact 解释了为什么影响小:
This should have a minimal impact on users as the flush API is only required for the post data API, which was deprecated since 7.11.0.
两条说的其实是同一件事,只是角度不同:
- 原因:flush 的唯一用途是配合 post data;
- 影响小:既然 post data 早就弃用了,那还在用 flush 的人应该极少。
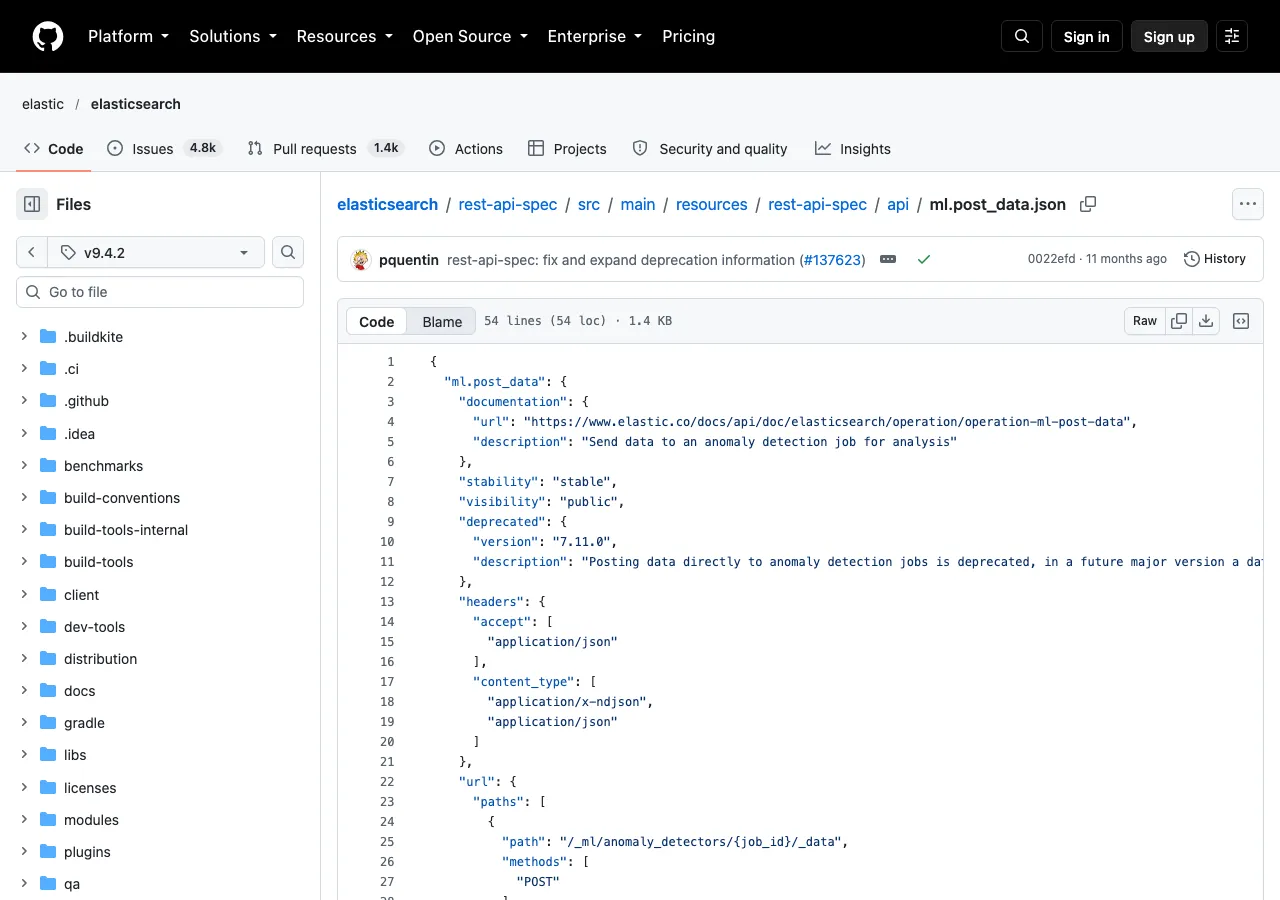
图 2:官方文件 ml.post_data.json(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 ml.post_data.json
这条因果链是怎么串起来的
把它理一遍,因为它示范了一种"连带弃用"的逻辑:
post data API(7.11.0 弃用)
        ↓
   它需要一个 flush 动作
        ↓
flush API(9.0 弃用)
flush 本身没有独立价值——它存在的意义就是服务于 post data。当被服务的一方弃用了,服务方也就没有存在理由。
这类连带关系在 API 演进里挺常见。我的建议是:读 changelog 时看到"某个 API 被弃用",顺藤摸瓜看它依赖/服务于什么——往往能更早预判到后续还会有相关 API 下线。
具体到本例:如果你看到 post data 在 7.11.0 被弃用,当时就该想到 flush 迟早也会走这一步。这条因果链在九年前(版本上)就埋下了。
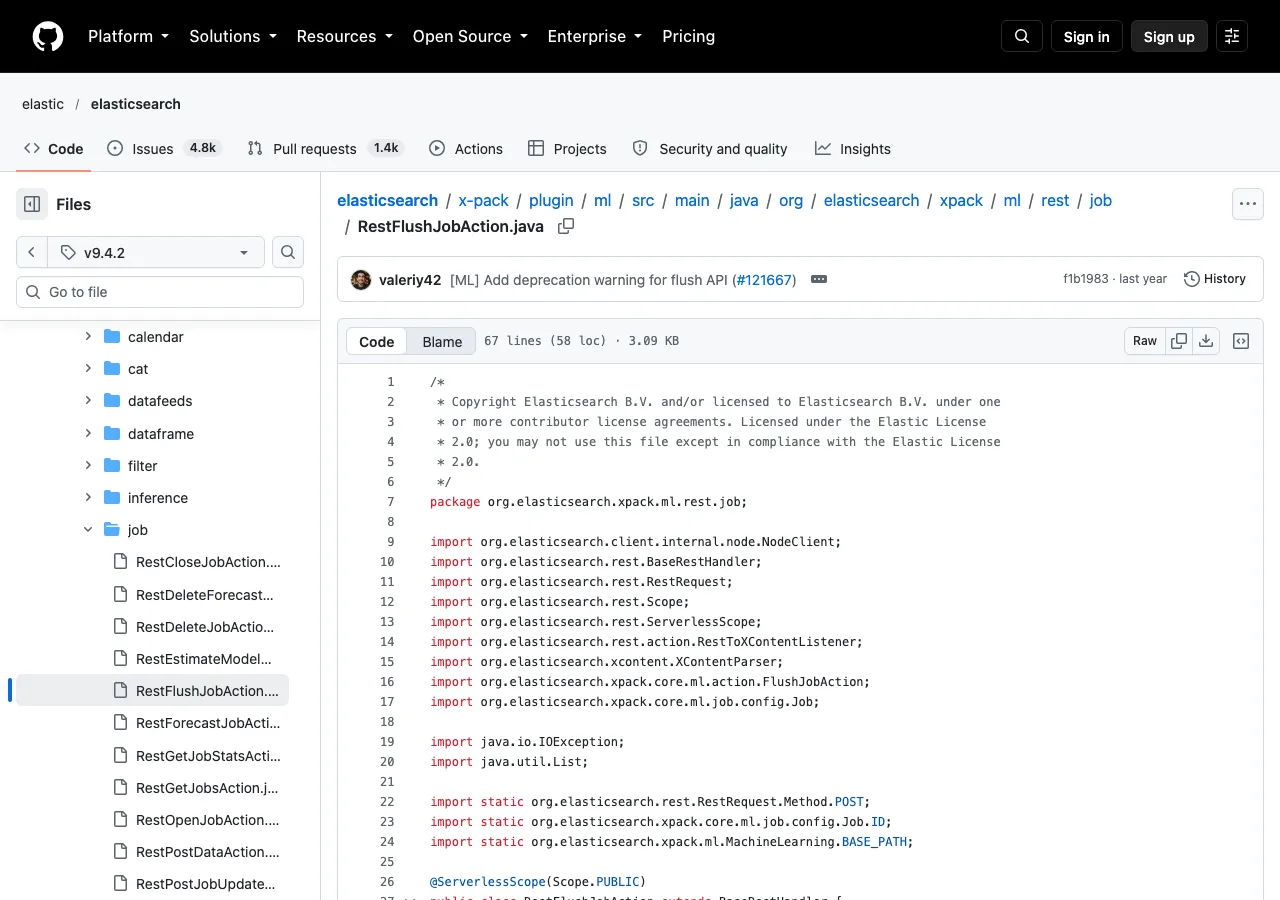
图 3:官方文件 RestFlushJobAction.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 RestFlushJobAction.java
这两个 API 是干什么的
post data API:直接把数据 POST 给异常检测任务做分析。也就是不走 datafeed,自己往任务里推数据。
flush API:强制处理缓冲中的数据。
为什么 post data 需要 flush?按理解——手动推数据时,数据可能积在缓冲区没被处理,需要一个显式动作触发处理。而走 datafeed(自动从 ES 索引拉数据)的话,数据流的节奏由 datafeed 控制,不需要这个手动触发。
(说明:这段关于"为什么需要 flush"的解释是推断,不是官方文档的说法。changelog 只说了两者的依赖关系,没解释机制。)
源码里的弃用消息更具体
changelog 之外,源码里那条弃用消息说得更明确(RestFlushJobAction.java @ v9.4.2,第 35–39 行):
public List<Route> routes() {

    final String msg = "Forcing any buffered data to be processed is deprecated, "
        + "in a future major version it will be compulsory to use a datafeed";
    return List.of(Route.builder(POST, BASE_PATH + "anomaly_detectors/{" + ID + "}/_flush").deprecateAndKeep(msg).build());
}
三个信息:
- 消息文本:"强制处理缓冲数据已弃用,未来主版本将必须使用 datafeed";
deprecateAndKeep——标记弃用但保留功能(这是 ES 里"弃用但不移除"的标准做法);- 路径是
POST _ml/anomaly_detectors/{id}/_flush。
"未来主版本必须使用 datafeed"这句是 changelog 里没有的,它明确了替代方向。这一点有价值——changelog 只说"弃用",源码消息说了"改用 datafeed"。
谁会受影响
按官方说法,影响极小。逻辑是这样:
- 用 flush 的前提是在用 post data;
- post data 从 7.11.0 就弃用了——那是很多年前的事;
- 所以还在用 post data + flush 的组合,属于极少数遗留用法。
多数异常检测任务走 datafeed,完全不涉及这条改动。数据先写进索引、由 datafeed 定期读取喂给任务,这才是现在的常规做法。
判断真正会撞到的是:很早期建起来的、手动推数据的遗留任务。这类任务通常跑了很久没人碰,升级时才发现问题。
排查方法
一,看有没有调用 flush 的代码。
grep -rn "_flush" --include=*.py --include=*.go --include=*.sh . | grep -i "anomaly"
二,看弃用日志。 用过的会在日志里留记录:
grep -i "flush" /var/log/elasticsearch/*_deprecation.log | head
三,确认有没有在用 post data。 这才是根本——如果没在用 post data,那 flush 也不该被调用:
grep -rn "_ml/anomaly_detectors/.*_data\|post_data" --include=*.py --include=*.go .
判断是第三条最根本:post data 弃用得早,如果你们还在用,那要处理的是 post data 这件事本身,flush 只是连带的一个表现。
要改的话往哪改
按源码里的消息,方向是改用 datafeed。
datafeed 是 ML 从 ES 索引自动拉数据的机制——数据先写进 ES 索引,datafeed 定期去读,喂给异常检测任务。这比手动推数据更规范:
- 数据有持久化(在索引里),不是推完就没;
- 重放、回溯都方便;
- 任务重启后能自己补数据。
所以官方要求"必须用 datafeed"是有道理的——手动推数据是早期的设计,datafeed 才是正常用法。
(说明:这段关于 datafeed 优势的说明是按一般理解写的,不是引自官方文档。迁移的具体做法要查官方的 ML 文档。)
一个读源码弃用消息的习惯
前面说到"源码消息比 changelog 具体",把这个方法展开一下,它在这一次之后会经常用到。
ES 的弃用标记在代码里通常长这样(以本条为例):
Route.builder(POST, "...").deprecateAndKeep(msg).build()
deprecateAndKeep 这个方法名本身就说明两件事:
deprecate——标记弃用;keep——功能保留。
也就是说,被标弃用的 API 在当期版本仍然可用,只是会返回警告头。这和前面写过的其它弃用条目一致——弃用不等于移除。
实际用法是:想知道某个 API 的弃用原因和替代方向,可以去对应的 Rest*Action.java 里看消息文本。那里通常写得比发布说明直白,因为消息是直接给调用方看的,要让人看懂该怎么做。
(说明:这个办法在本篇第一次用,是否有效还没经过多次验证。不同模块的写法也可能不一样。但至少这次拿到了 changelog 里没有的信息,值得继续用。)
这条改动属于哪一类
把它归为"连带弃用"——因为依赖项先弃用,本功能失去存在意义而跟着弃用。
和前面写过的其它弃用对比:
| 条目 | 类型 | 触发原因 |
|---|---|---|
| 单数据节点水位线开关移除 | 过渡期设置到期 | 为兼容而临时引入 |
| Behavioral Analytics 弃用 | 整块功能下线 | 功能被取代 |
| 本篇 | 连带弃用 | 依赖项先弃用 |
这一类的特点是:看到它的时候,真正的根因往往在别处。本例中,flush 弃用只是表象,根因是 post data 早在 7.11.0 就弃用了。
认识到这一点对排查有直接帮助:如果你收到 flush 的弃用警告,不要只想着"怎么去掉 flush 调用",而要想"为什么在用 post data"。前者是治标,后者才是治本。
所以处理这类条目的思路是:先解决根因,表象自然消失。如果你们还在用 post data,改掉它,flush 的调用也就不需要了。
post data 现在是什么状态
写这篇时查了一下 post data 接口的现状(ml.post_data.json @ v9.4.2),它的 stability 标的是 stable。
这有点意外——一个从 7.11.0 就弃用的 API,在接口规范里仍标 stable。
可能的原因(纯属猜测,没有依据,这点不重要,重要的是别被这个字段误导):
- 规范里的
stability字段可能指"接口形态稳定"而不是"未被弃用"; - 或者这个字段没有跟着弃用状态更新。
不确定是哪一种。 但有一点值得提醒:不要只看规范里的 stability 字段判断一个 API 是否该用。它和弃用状态是两回事——本例中 post data 标着 stable,实际却早已弃用。
判断依据还是要看 changelog 和源码里的弃用标记,那两处才是权威的。规范里的 stability 字段和弃用状态是两回事,别混着用。
写在最后
这条 deprecation 影响极小——官方明说了,而且推理成立:post data 都弃用这么久了,还在用它的人本来就该改了。我的建议是别为它排专门的迁移窗口,跟着 post data 那批一起改掉即可。
两个理由:
一,它的因果链很清楚,是个好样本。 一个 API 因为唯一用途被弃用而跟着弃用,这种关系在 API 演进里常见,认识它有助于预判后续变化。 一个 API 因为唯一用途被弃用而跟着弃用——这种连带关系在 API 演进里常见,认识它有助于预判后续变化。
二,源码里的弃用消息比 changelog 更具体,值得去那里找替代方向。 changelog 只说"弃用",源码说了"未来主版本必须使用 datafeed"。这提示:想知道替代方向时,可以去看源码里的弃用消息——那里往往写得比发布说明直白,因为消息是给调用方看的,要让人看懂该怎么做。
这个方法在本篇第一次用就拿到了 changelog 里没有的信息,后面会继续用下去。
一,先查 post data,别只查 flush。 根因在前者,flush 只是连带表现——改掉根因,表象就自己消失了。
二,替代方向是 datafeed。 这是源码弃用消息里明确写的,changelog 里没提。想知道替代方向就去源码里看弃用消息,那里通常比发布说明直白。
三,deprecateAndKeep 意味着当期仍可用。 不会立刻失效,但要把改动排进计划——未来主版本会强制。
参考
- changelog 9.0.0:Add deprecation warning for flush API(第 1980–1990 行)@ v9.4.2
RestFlushJobAction.java:deprecateAndKeep与弃用消息文本("未来主版本必须使用 datafeed",第 35–39 行)@ v9.4.2ml.flush_job.json:flush 接口定义 @ v9.4.2ml.post_data.json:post data 接口定义 @ v9.4.2- Elasticsearch issue 121506
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。"为什么 post data 需要 flush"的机制解释是推断,官方未说明;datafeed 的优势描述也是按一般理解写的,非官方表述,文中均已标注。撰写时未启动集群、未运行测试。