在百炼上用 qwen-mt-uni 做多模态翻译:能力边界与成本结构

简介: 百炼9月上线翻译模型qwen-mt-uni:全模态支持文本/文档/图片/音频,覆盖152语种。核心优势是直出可交付文件(PDF/图/音频),非纯文本。四类计费差异大(文档最省,音频最贵),适合跨境说明书、本地化初翻等场景,但不擅网络热梗等需语感的翻译。

百炼 9 月上了一个翻译模型 qwen-mt-uni,官方描述是「全模态翻译,覆盖 152 个语种,文档与音频翻译为核心」。

我花了一个下午把它四类输入都跑了一遍,顺便测了同一批内容在不同模型上的表现。

这篇文章讲三件事:它能做什么、它的边界在哪、一次多少钱。

一、能力面

四类输入,三种输出形态:

输入 输出 计费通道
文本 TranslatedTexts 字符串数组 文本 65 元/百万 token
文档(Txt/PDF/Word/PPT/Excel) 成品文件下载链接 文档 20 元/百万
图片 翻译后的图片 图片 32 元/百万
音频(语音/视频音轨) 翻译后的音频 音频 400 元/百万

关键差异:后三类返回的是文件,不是字符串。

这是它和通用大模型最本质的区别。通用模型给你一段可以复制的话,它给你一个能直接发给客户的文件。

跨境场景要的就是这个:说明书要 PDF,海报要图,客服语音要能播。

二、接入

bl 命令行没有翻译子命令,走 HTTP 直调。

端点不是翻译专用的:

POST /api/v1/services/aigc/multimodal-generation/generation

参数结构:

{
   
  "model": "qwen-mt-uni",
  "input": {
   
    "source_texts": ["..."],
    "target_lang": "English"
  }
}

文件翻译把 source_texts 换成 fileUrl,值必须是公网可访问的地址(OSS 加 --acl public-read 即可)。

返回结构统一在 output.Data 下:

  • 文本:TranslatedTexts
  • 文件:TranslatedFileUrl(带签名,有时效,要立刻下载)

FileType 字段会标明 strings / document / image / audio,可以做分支。

三、三条建议先做的事

先确认内容形态。 文本和文档的单价差三倍,但文档需要你先上传成公网 URL。如果内容本来就在文档里,别拆成文本发。

图片翻译前先看排版。 模型会替换文字,但不会重排版式。行高、字号、对齐都需要人工调。

音频先转 m4a。 WAV 不认这件事没有文档提示。

四、实测发现

文档:格式在,编号乱

一份说明书,原文「一、安装方法 / 二、注意事项 / 三、保修条款」。

译文:「1. Installation Instructions / II. Precautions / III. Warranty Terms」。

同一份文件出现三种编号体例。内容对,排版要返工。

图片:字换了,版式崩

一张英文海报,三行文字全部替换成功,但:

  • 标题与副标题合并成一行
  • 「无谷物」断行成「无谷 / 物」
  • 美元符号没有本地化
  • 商品图上的小字不处理

音频:WAV 不认

格式 结果
WAV(PCM 16bit 24kHz) 400 file is not a readable audio file
m4a(AAC) 200,输出 mp3

术语表静默失效

input.terminology 传进去,返回 200,译文不变,也不报错。

内容审核

韩语「어쩔티비」触发 DataInspectionFailed。同一个词在通用模型上可以正常翻译。
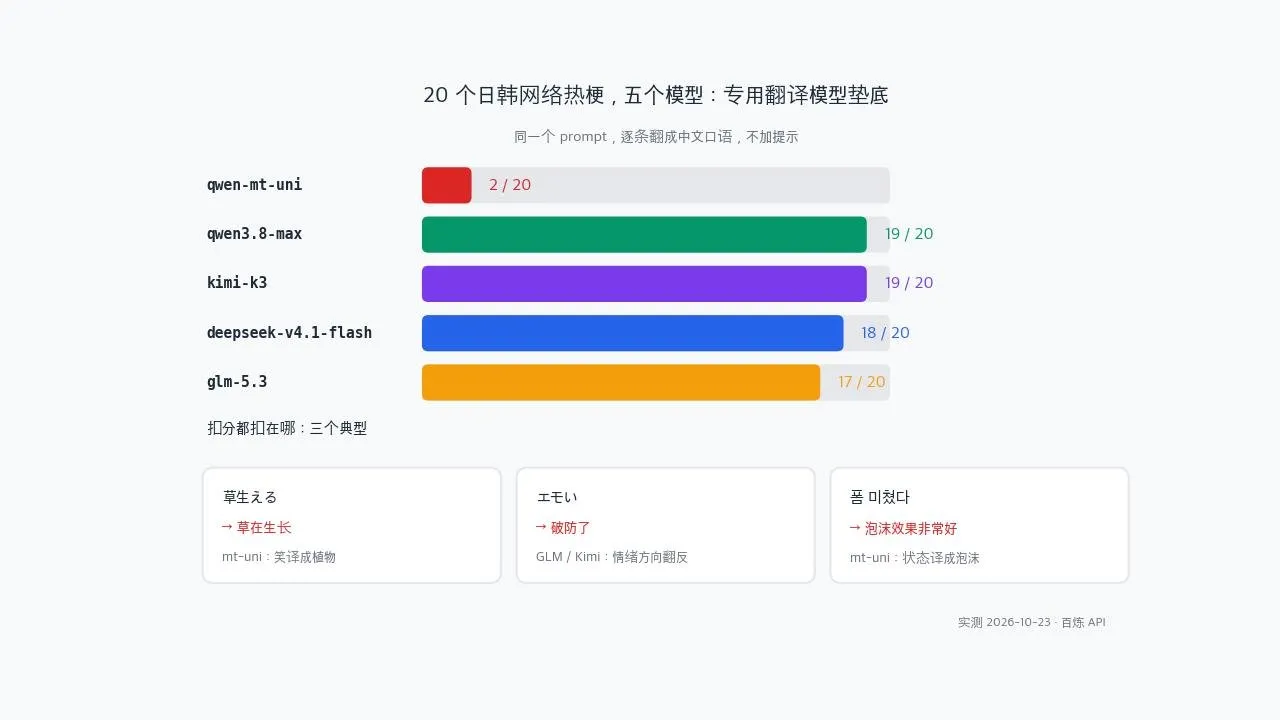
五个模型在 20 个热梗上的得分

四、一个需要注意的选择

我也测了同样的内容给 qwen3.8-max、kimi-k3、deepseek-v4.1-flash、glm-5.3。

20 个日韩网络热梗,翻译专用模型对了 2 个,四个通用模型分别对了 19、19、18、17。

这不是缺陷报告,是定位说明。

qwen-mt-uni 的产品约束是「严格对应、不增译漏译」。这个约束让它在合同、说明书、财报上可靠,在弹幕、字幕上不可用。

选型建议:

  • 要成品文件:qwen-mt-uni
  • 要人话:通用模型
  • 要便宜:文档通道

五、成本

四类通道单价差 20 倍:

文本 65 / 文档 20 / 图片 32 / 音频 400(元每百万 token)

一本 20 页、八千字的手册:

  • 当文本发:约 0.52 元
  • 打包成文档发:约 0.16 元

内容一样,差三倍。

实测这轮(文档、图片、音频各一次,加 20 个热梗三模型对照)总共不到 0.2 元。

音频最贵,7 秒的语音 177 个 token,约 0.07 元。折算成分钟,约 0.6 元每分钟。
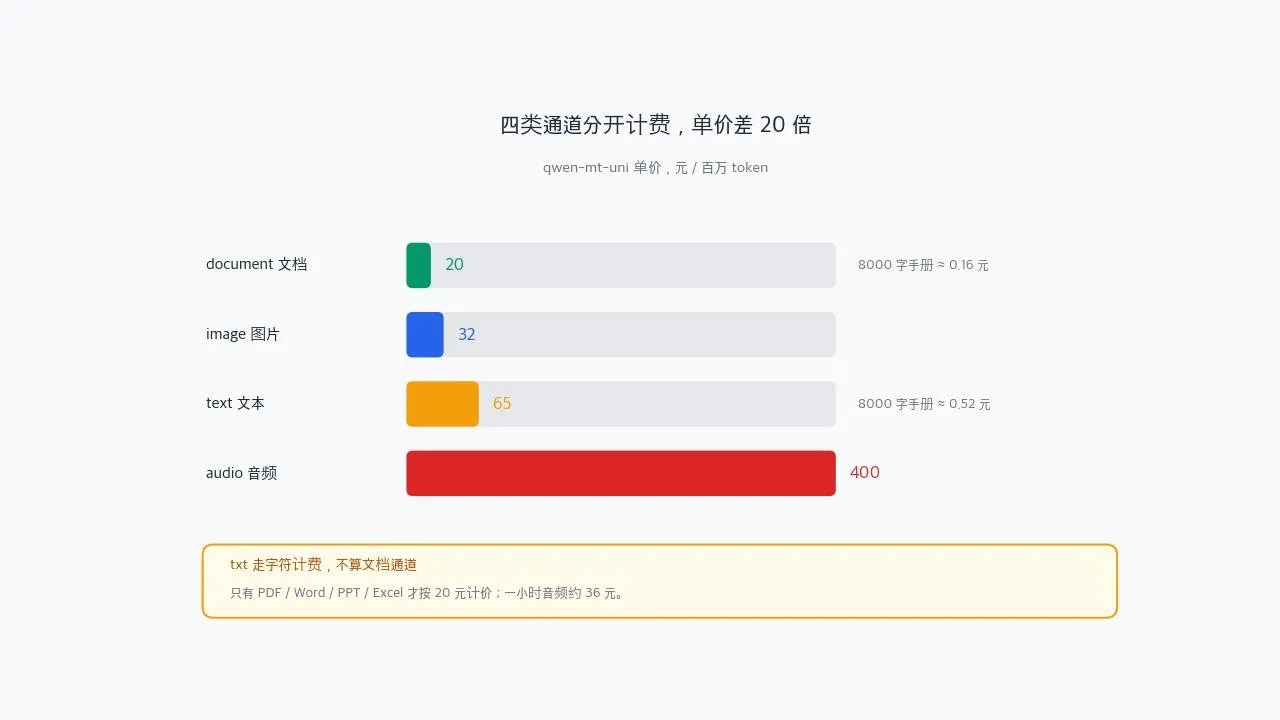
四类通道单价

六、成本怎么估

按内容形态估:

  • 纯文本:字数 × 2(输入输出)× 65 元/百万
  • 文档:字数 × 2 × 20 元/百万
  • 图片:一张约 1900 token × 32 元/百万,约六分钱
  • 音频:每秒约 25 token × 400 元/百万,一分钟约 0.6 元

四类里音频最贵,文档最便宜。同一个需求,选对形态能省一半以上。

举个具体的:一万字的客服话术库,走文本通道约一块三,走文档通道四毛,差三倍。一个月翻五次,差的不是钱,是习惯,一个月下来就看得出来了。

七、适合谁

跨境卖家:说明书、listing、详情页图,一次出成品文件。

本地化团队:初翻交给模型,人工只做排版校对和术语统一。

需要音频翻译的场景:会议录音、客服质检、视频字幕轨。

不适合:需要语感很细的社交内容、需要当天时效的新闻、需要逐条标注来源的学术写作。


模型在百炼上,走接口调用。控制台在这里,API Key 在这里。

相关文章
|
29天前
|
人工智能 测试技术 API
实时语音在百炼能力栈里的位置:从三段式管线到一条 WebSocket
阿里百炼推出`qwen3.8-omni-flash-realtime`,首创“听说一体”实时语音模型,将ASR、LLM、TTS融合为单条WebSocket连接,支持流式输入/输出、毫秒级打断、会话状态管理与工具调用,端到端首音频仅1.37秒,成本低至每轮0.0025元,大幅降低语音应用工程复杂度。(239字)
|
19天前
|
JavaScript API iOS开发
DeepSeek Harness下载、安装、配置一篇搞定(2026整理,送常用插件)
DeepSeek Harness(DSH)是DeepSeek于2026年开源的MIT协议AI Agent框架,支持插件化组装模型、工具、沙箱与UI,兼容主流大模型。本文提供免Node.js的桌面端安装包(Win/macOS),含详细图文教程及热门插件推荐。
5766 69
|
22天前
|
存储 搜索推荐 API
在百炼上给 Agent 补一层跨会话记忆:记忆库的三类资源与接入边界
百炼记忆库(Memory Library)提供平台级会话状态管理,将记忆分为事实、画像、技能三类,按用户隔离、自动抽取合并。支持API/CLI/SDK接入,写入异步、检索可调阈值。实测36次查询命中率达100%(调阈值后),兼顾隐私合规与多端复用,显著降低Agent状态维护成本。(239字)
在百炼上给 Agent 补一层跨会话记忆:记忆库的三类资源与接入边界
|
25天前
|
数据采集 自然语言处理 监控
百炼文本精调实操:700 条客服数据,4.2 元,58 分钟
本文实测宠物客服数据SFT-LoRA精调全流程:700条数据、58分钟训练、仅4.2元成本,验证平台能力边界与部署陷阱,揭示“训练成功≠能上线”的关键认知。(239字)
百炼文本精调实操:700 条客服数据,4.2 元,58 分钟
|
29天前
|
人工智能 缓存 前端开发
把「快乐生蚝」交给 Agent:HappyOyster Adventure 服务端全生命周期实测
HappyOyster(快乐生蚝)是抖音4月爆火的实时交互世界模型,9月17日上线百炼平台。本文实测北京区`happyoyster-1.0-adventure`全流程:从创建黄昏海岸世界、轮询就绪(19.5秒)、换票进房,到查询、删除,全程Open API驱动,6接口闭环管理,0.05元起试错,国内唯一可API接入的实时AI世界引擎。(239字)
|
1月前
|
API
百炼假期上新实测:qwen-image-2.1-pro 的透明能力,我们跑了 35 次
国庆期间,百炼上线Qwen-Image-2.1-pro API模型(0.25元/张),免27GB显存门槛。实测确认:透明通道仅可“继承”不可稳定“生成”,编辑透明图可稳定保持,白底图无法抠透明;支持10图合成与精准圈选编辑。推荐用于透明素材加工与批量拼图。(239字)
百炼假期上新实测:qwen-image-2.1-pro 的透明能力,我们跑了 35 次
|
25天前
|
人工智能 API
深度研究在百炼能力栈里的位置:不是 RAG,也不是搜索摘要
阿里云百炼「深度研究」(qwen-deep-research)是面向专业场景的第三层查资料能力:不依赖私有知识库,也不止于网页摘要,而是通过反问澄清→多步规划→自主检索→结构化成文,交付带章节与引用编号的6909字报告,适用于行业扫盲、方案底稿等任务。(239字)
|
2月前
|
存储 JSON API
百炼声景模型新成员实测:Qwen-Audio-3.1-TTS-Next 的调用路径、时序控制与成本边界
阿里百炼新推Qwen-Audio-3.1-TTS-Next(9月21日上线),支持文本一键生成含人声、音效、环境声的时序化声景,告别单音色朗读。实测覆盖接口调用、时序控制与成本核算,提示词≤3000字符,成品≤120秒,输出200 token/秒,约0.24分/秒。
百炼声景模型新成员实测:Qwen-Audio-3.1-TTS-Next 的调用路径、时序控制与成本边界
|
2月前
|
缓存 人工智能 监控
179 个模型进入下线倒计时:一次从自查到迁移的 CLI 全链路实测
本文记录百炼平台2026年10月10日大规模模型下线(179个)的完整自查与迁移实践。详解CLI三种查询模式差异,提供可复现的全量扫描脚本,完成公告与目录精准对账,并实测文本/图像模型性能、成本与兼容性,附三步上手指南。(239字)
179 个模型进入下线倒计时:一次从自查到迁移的 CLI 全链路实测
|
2月前
|
编解码 人工智能 自然语言处理
一条 76 分钟发布会全片,从理解到取证要几步?qwen3.8-omni-flash 长视频理解链路实测:截图点位抽帧 5/5 全对,单次分析两分钱
本文实测Qwen3.8-Omni-Flash在长视频理解中的工程落地:76分钟WWDC26录像,经转码后仅用一条`bl omni`命令,完成预处理→目录生成→图文笔记→抽帧验证四层链路,分钟级时间戳精准、5处截图100%吻合,音频模式适用纯口播场景,单次分析约2分钱,验证了高性价比、可复用的长视频AI分析范式。(239字)
一条 76 分钟发布会全片,从理解到取证要几步?qwen3.8-omni-flash 长视频理解链路实测:截图点位抽帧 5/5 全对,单次分析两分钱

热门文章

最新文章