
洗数据两小时,建模五分钟?开源 SmeltLab:AI 数据清洗 + 一键建模,脏数据进、能训练的模型出
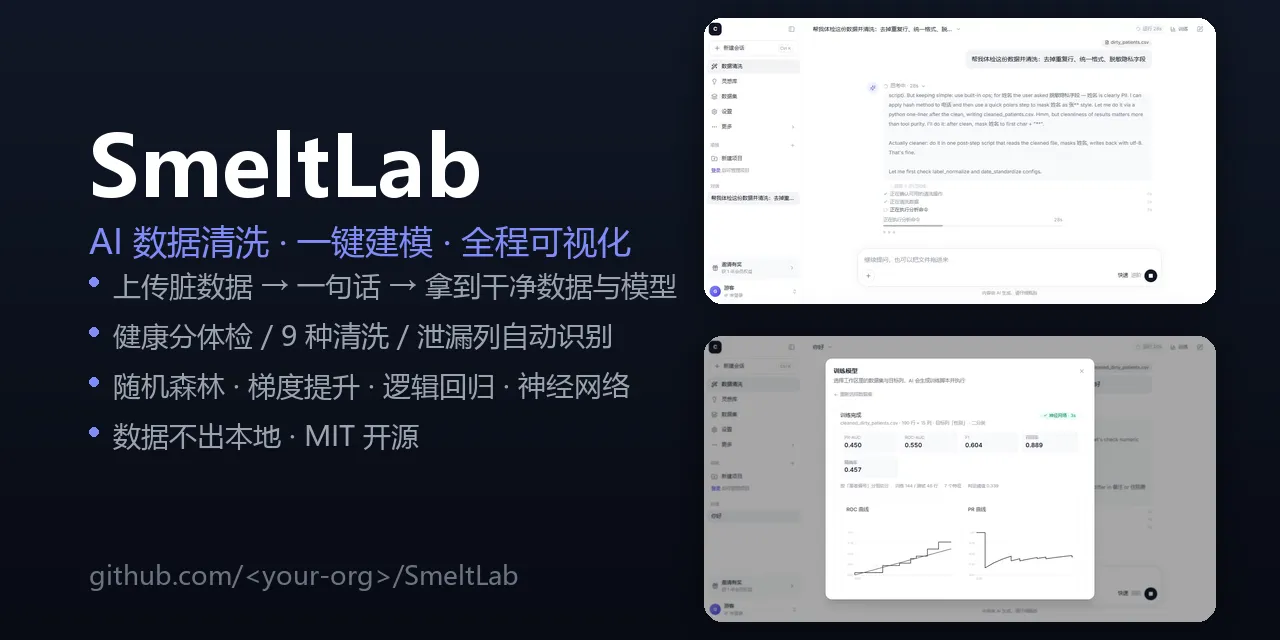
一句话概括:SmeltLab 是一个开源的、本地优先的 AI 数据清洗 + 一键建模工作台(Python 实现)。它把
数据体检 → 自动清洗 → 自动建模 → 结果解读这条链路压成三步:上传 → 说一句话 → 出结果。清洗与建模全部由确定性代码(Polars / scikit-learn)执行,LLM 只负责理解你的清洗意图和解释跑出来的指标——过程可见、结果可复现、数据不出本机。🔗 开源地址:https://github.com/PHclaw/smeltlab | License:MIT | 技术栈:Python · FastAPI · Polars · scikit-learn · Next.js
一、先说痛点:做 ML 的人,时间到底花在哪了
坦白讲,绝大多数机器学习项目的真实时间分布是这样的:
- 拿到一份 CSV,先花半小时
df.info()/df.describe()找缺失、找重复、找异常值; - 日期有三种格式(
2024-01-05/2024/1/5/2024年1月5日),性别有九种写法(男/男性/M/男/ 空串),999和-1混在年龄列里; - 洗完觉着挺干净,训出来 AUC 0.98 —— 回头一看,「住院费用」「出院科室」这种事后才知道的信息混进了特征,指标全是虚的;
- 好不容易洗干净,配环境、切数据、训模型、画曲线,又是一小时。
建模本身往往只占 10% 的时间,剩下 90% 都耗在数据准备上。 SmeltLab 想做的就是把这 90% 里能自动化的部分全自动化,而且每一步你都看得见。
为什么叫 SmeltLab:冶炼(smelt) 是把矿石炼成金属——脏数据进,能训练的模型出;Lab 是工作台——体检、清洗、训练、解读,一个界面走完。
二、SmeltLab 是什么
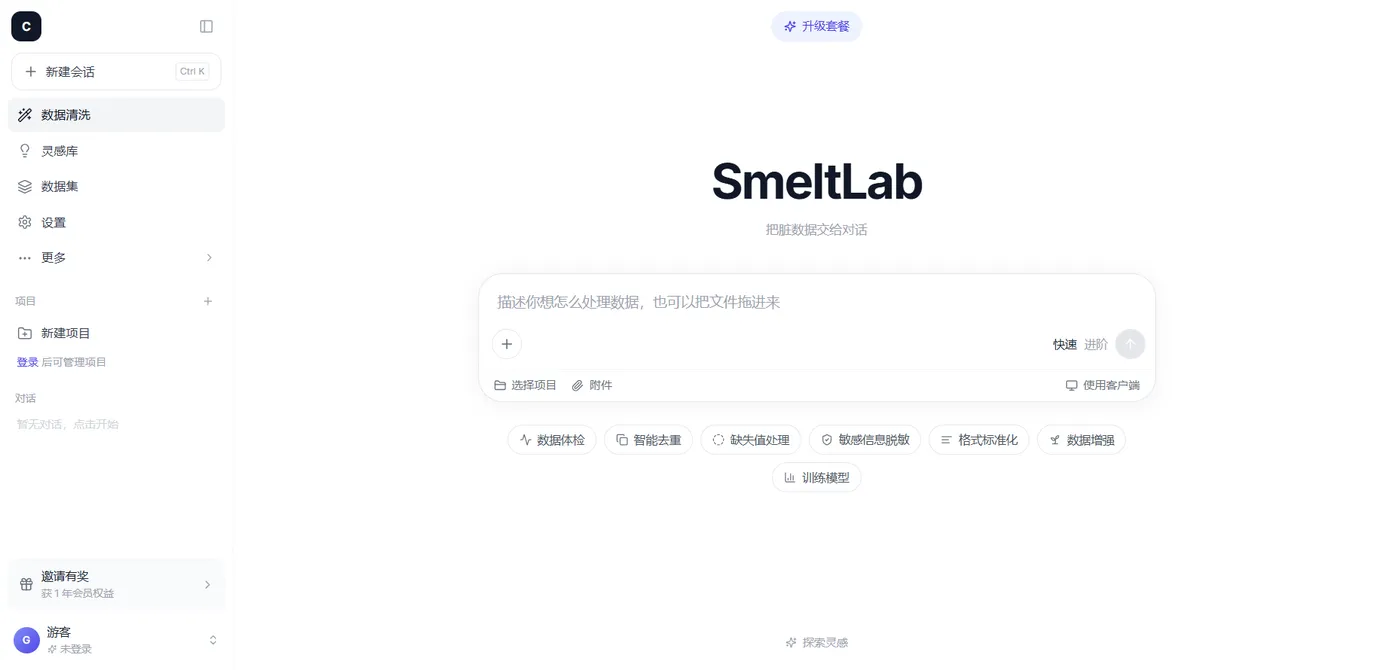
图:SmeltLab —— AI 数据清洗与一键建模工作台主界面
核心能力一览:
| 🩺 数据体检 | 健康分 0-100 · 5 大类问题 · 列级画像(含语义类型推断) |
| 🧹 一键清洗 | 9 种预置操作 · 改动前后逐条 diff 审查 · 可拒收、可回滚 |
| 💬 对话式清洗 | 说人话:「去掉重复行、统一格式、脱敏隐私字段」 |
| 👀 过程可见 | 步骤实时播报 · 每步耗时 · 长任务进度条 · 可随时停止 |
| 🎯 训练推荐 | 自动识别目标列 / 分组列 / 泄漏列 |
| 🚀 一键建模 | 随机森林 · 梯度提升 · 逻辑回归 · 神经网络(含基线对照) |
| 📈 结果可视化 | PR-AUC / ROC / 混淆矩阵 / 特征重要性 / 实时训练曲线 |
| 🤖 AI 解读 | 这个指标能不能用、风险是什么、下一步做什么 |
| 🧩 配方复用 | 清洗步骤存成 Recipe,同类数据一键套用,支持批量应用 |
| 🔒 本地优先 | 数据与产物留在本机,预置功能可全程离线运行 |
2.1 适合谁用
- 算法工程师 / 数据分析师:每来一份新数据就要重写一遍清洗脚本的人;
- 医疗、金融、风控从业者和研究者:数据敏感、不能上云,且天然存在类别不平衡、同一实体多条记录等问题;
- 学生与竞赛选手:想快速拿到一个「能跑通 + 指标可信」的基线,再去做深度优化;
- 非技术同学:不会写 pandas,但看得懂"缺失率 18%、重复行 4 条"这种体检报告。
2.2 几个高频场景
| 你的场景 | SmeltLab 怎么做 |
|---|---|
| CSV 里日期三种格式、性别九种写法 | date_standardize + label_normalize 自动统一 |
| 缺失值不知道该删还是该填 | 体检先报缺失率,清洗时可选 drop / 均值 / 中位数 / 众数 |
| 数据里有手机号、身份证,不敢往外传 | pii_mask 本地脱敏(redact / hash / replace),数据不出本机 |
| 同一患者多条记录,切分怕泄漏 | 自动推荐分组列,GroupShuffleSplit 分组切分 |
| 「住院费用」这类事后信息混进特征 | 中文 LEAK_HINTS 关键词表自动识别并剔除 |
| 清洗流程想复用到下个月的数据 | 存成 Recipe,一键套用,支持批量应用 |
三、30 秒上手
git clone https://github.com/PHclaw/smeltlab.git
cd smeltlab

# 后端(FastAPI · 8000)
cd backend
python -m venv .venv && .venv\Scripts\Activate.ps1   # macOS/Linux: source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env
python -m uvicorn app.main:app --reload --port 8000

# 前端(Next.js · 3000)
cd ../frontend
npm install && npm run dev
打开 http://localhost:3000,把仓库自带的 sample_data/dirty_patients.csv(194 行 × 15 列的医疗脏数据)拖进去,发一句:
帮我体检这份数据并清洗,然后训练一个模型预测「并发症」
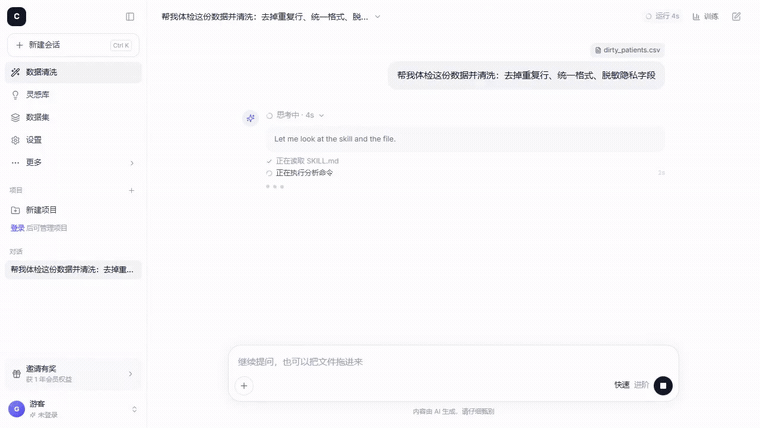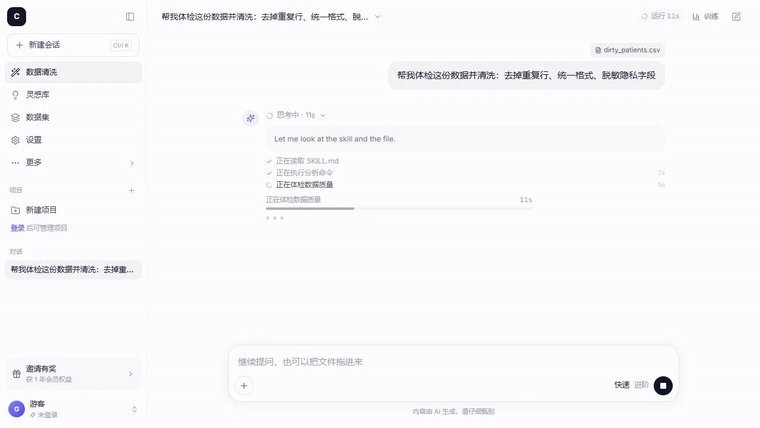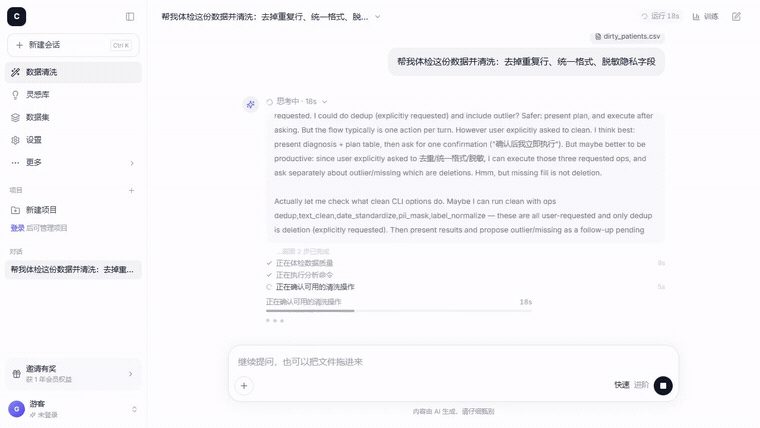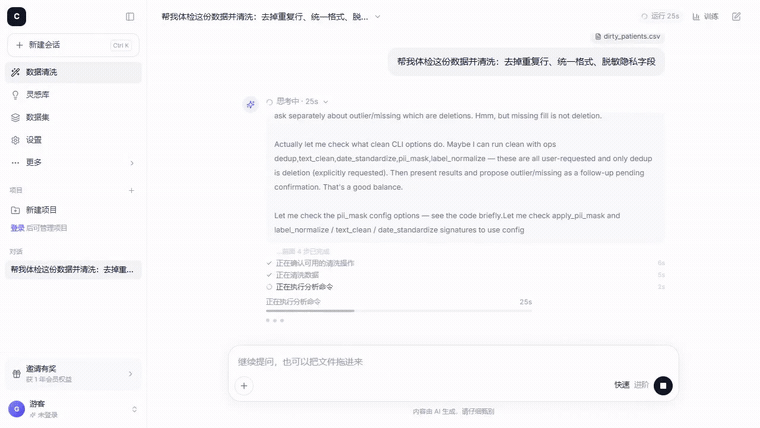
图:对话式数据清洗 —— 步骤逐条播报、每步带耗时、长任务有实时进度条
不配 API Key 也能完整体验:数据体检、9 种预置清洗、训练卡建模、指标曲线都不依赖 LLM。只有「用人话下指令」和「AI 解读指标」需要在 backend/.env 里配一个模型服务商(AI_PROVIDER=glm 或 anthropic)。
四、六个核心能力详解
4.1 数据体检:用一个健康分看清数据有多脏(缺失值 / 重复值 / 异常值)
上传后先出体检报告:健康分、5 大类问题(duplication / missing / outlier / format / consistency)、每列的语义类型与画像。
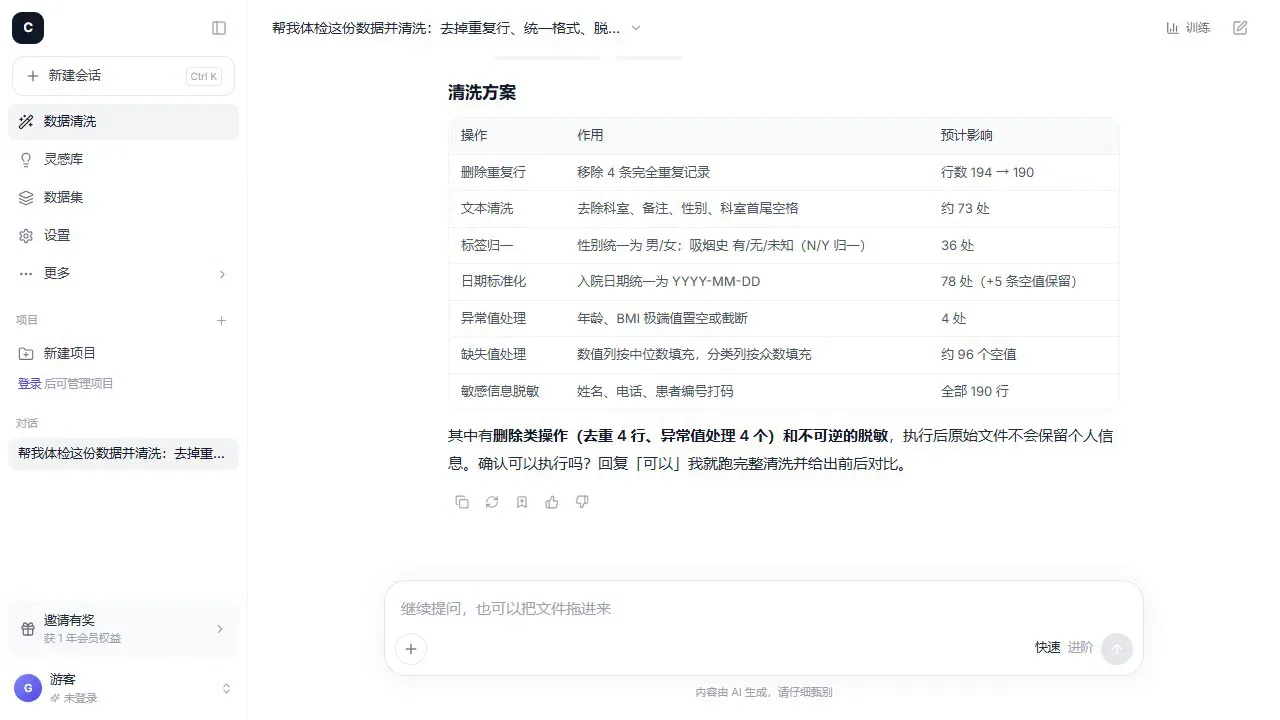
图:数据体检报告 —— 健康分、问题清单与逐列数据质量画像
不止看 dtype,还做语义类型推断:取前 100 个非空值做正则投票,命中率 >0.8 判为 email / url / phone,>0.7 判为 date(内置 11 种日期格式,含中文 %Y年%m月%d日)。所以它能识别出"这一列混了三种日期写法",而不只是告诉你"这是 object"。
4.2 自动清洗:9 种算子,去重 / 缺失值 / 异常值 / 隐私脱敏一次搞定
| 操作 | 干什么 |
|---|---|
dedup |
去重(支持按列子集) |
missing |
缺失值:drop / 均值 / 中位数 / 众数 / 指定值填充 |
outlier |
多列 IQR 异常值过滤(mask 求交) |
text_clean |
去空格 / 合并空白 / 转小写 / 去特殊字符 |
date_standardize |
多种日期格式统一成 YYYY-MM-DD |
label_normalize |
标签归一化(Positive/positive/POSITIVE 合并) |
pii_mask |
隐私脱敏:邮箱 / 手机 / 身份证 / 银行卡 / IP / SSN |
sample |
随机 / 分层 / 头尾 / 多样本采样 |
llm_validate |
数据集格式校验与修复(ChatML / Alpaca / ShareGPT) |
PII 脱敏做了中文本土化:内置 \b\d{17}[\dXx]\b(身份证)和 \b1[3-9]\d{9}\b(手机号),三种掩码方式 —— redact(打码成 [CN_PHONE_REDACTED])、hash(保留可关联性)、replace(***)。
关键是 diff:不是"跑完给你个新文件",而是每一步改了哪一行哪一列、改前改后是什么,全部列出来,你可以逐条拒收。被拒的步骤会从执行前状态重放并跳过。
4.3 训练卡:自动识别目标列、分组列与数据泄漏列

图:训练配置卡 —— 自动推荐目标列、分组列与需剔除的泄漏列
这一步的价值在于帮你避开那些"看起来很美"的坑:同一患者有多条就诊记录时,随机切分会让同一人既在训练集又在测试集;「住院费用」「出院科室」这种事后信息会让指标虚高。SmeltLab 会自动识别并剔除。
4.4 一键自动建模:4 种模型 + 基线对照 + 可视化评估指标
4 种模型 + 1 个基线模型(多数类 / 中位数),指标:PR-AUC / ROC-AUC / F1 / Recall / Precision,图表:ROC 曲线、PR 曲线、混淆矩阵热力图、特征重要性 Top10。
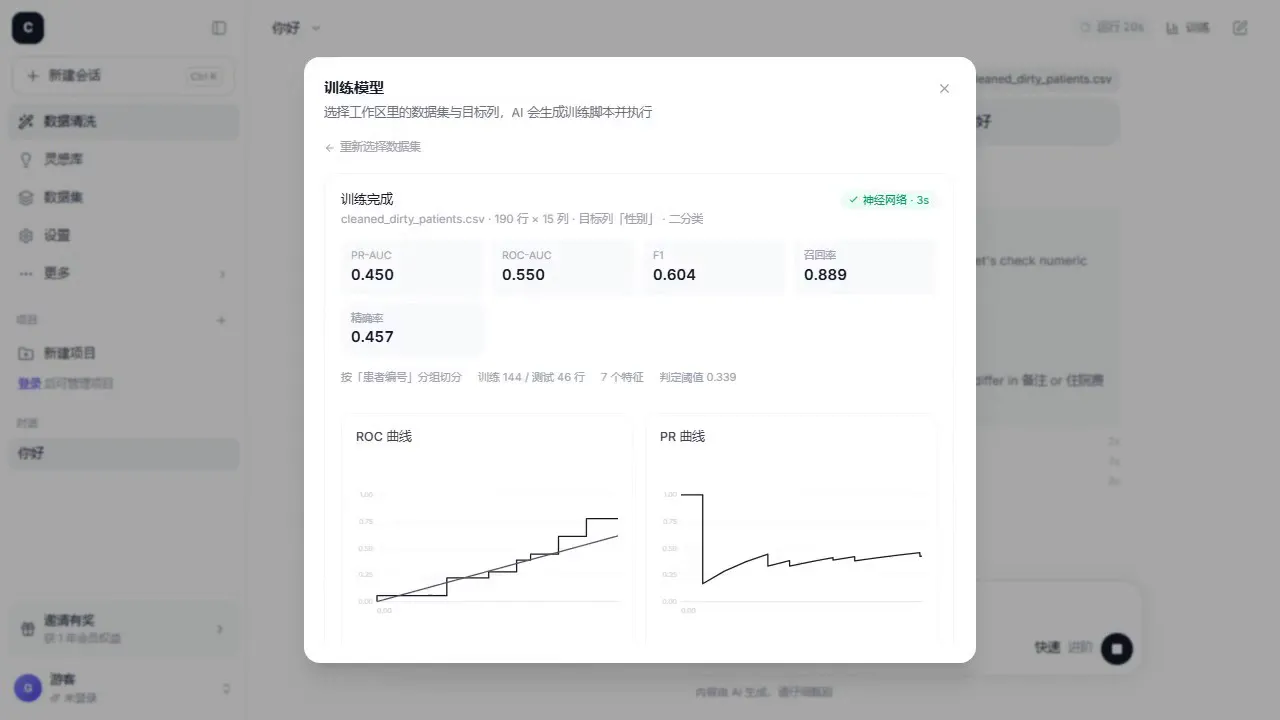
图:自动建模结果 —— ROC / PR 曲线、混淆矩阵与特征重要性
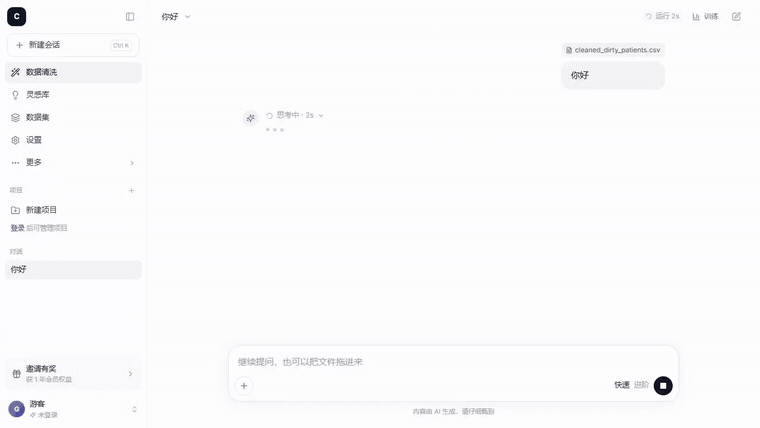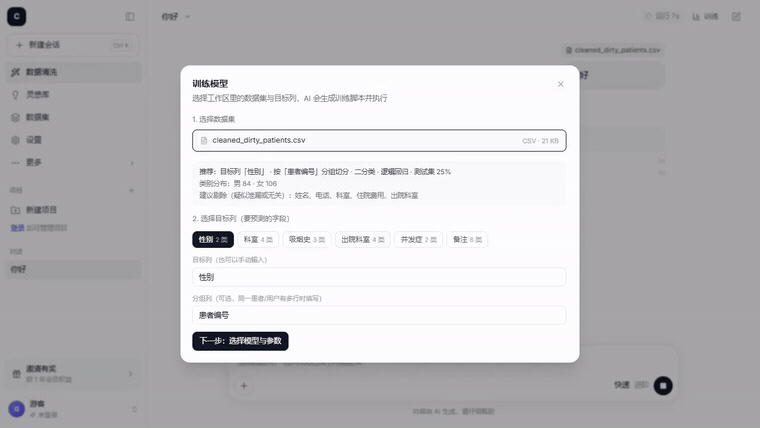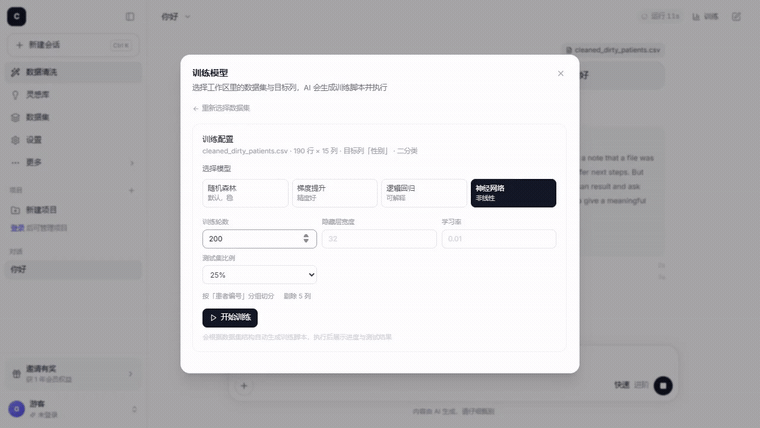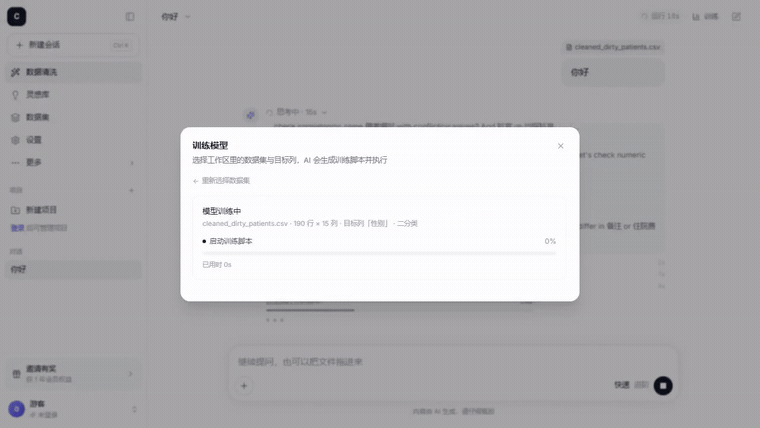
图:一键建模全流程演示
4.5 AI 解读指标 + 清洗配方(Recipe)复用
训练完可以点「让 AI 解读结果」,它会告诉你这个指标能不能用、风险在哪、下一步做什么。清洗流程可以存成 Recipe,下次遇到同类数据一键套用,还能对多个数据集批量应用。
五、技术架构拆解:为什么不让 LLM 直接洗数据
+---------------------------------------------------------------+
|  Browser    Next.js 14 / React 18 / TypeScript / Tailwind      |
|   上传 · 对话 · 训练卡 · 图表 · SSE 进度流                       |
+---------------------------------------------------------------+
                          │  REST + SSE
                          ▼
+---------------------------------------------------------------+
|  FastAPI    app/api/routes                                     |
|    datasets · clean · train · agent · recipes · auth · settings |
+---------------------------------------------------------------+
                          ▼
+---------------------------------------------------------------+
|  Services   app/services                                       |
|   profiler        健康分 / 问题检测 / 列级画像                   |
|   cleaner         9 种算子 + 变更记录 + 计划生成                 |
|   trainer         轻量 AutoML / 分组切分 / 指标 / 图表数据        |
|   trainer_codegen 可读训练脚本 + 进度上报 + JSONL 日志            |
|   training_jobs   子进程调度 / 日志解析                          |
|   pi_agent        本地 agent 引擎 -> 可见步骤流                  |
+---------------------------------------------------------------+
                          ▼
              Polars + scikit-learn(本地工作区)
5.1 核心设计取舍:LLM 只做意图理解
清洗与建模全部用确定性代码完成,LLM 只负责"理解意图 + 解释结果"。
理由很实在:让大模型去改一份 10 万行的表,既不便宜也不可靠,还可能编造数字。SmeltLab 的做法是——LLM 只看 schema 和 5 行样本,输出一个操作计划 JSON,真正动数据的是 Polars 算子:
# cleaner.py —— 提示词里写死了算子顺序
"dedup first, then PII, then format fixes, then outlier removal"
指标可复现、过程可审计,不会出现"模型编造数字"。
顺带解决了另一个工程问题:LLM 输出 JSON 经常被截断。项目里写了四级容错 _parse_json_robust:
- 直接
json.loads; - 正则抠出
{"steps": ...}对象; - 从最后一个
step_id做花括号配对,补齐]}; - 从末尾逐位回退,用栈算未闭合括号并补齐。
5.2 健康分怎么算:4 条规则,各自封顶
score = 100.0
score -= min(dup_pct * 2, 30)          # ①重复行:每 1% 扣 2 分,最多 -30
score -= min(avg_missing * 1.5, 30)    # ②全体列平均缺失率 ×1.5,最多 -30
score -= min(total_issues * 3, 30)     # ③列级问题条数 ×3,最多 -30
score -= min(constant_cols * 5, 10)    # ④常量列每列 -5,最多 -10
return max(0, min(100, round(score)))
四项上限合计正好 100,保证分数落在 0-100。分档:>=80 优秀 / >=60 一般 / >=40 较差 / 否则 严重。
问题严重度也有明确规则:缺失率 >20% → critical,重复行占比 >10% → critical,异常值/格式混用 → warning,高基数疑似 ID → info。
5.3 diff 不是事后比对,而是算子自带变更记录
这是我觉得设计得最漂亮的一点。每个清洗算子统一返回 (DataFrame, list[ChangeRecord]):
@dataclass
class ChangeRecord:
    row_index: int; column: str; before: Any; after: Any
    operation: str; step_id: str
先取 before = df[col].to_list(),执行表达式后再取 after,逐位比对,不同就记一条。行删除类操作用哨兵列名 "__row__" + after="removed" 表示——这样"删了哪些行"和"改了哪些值"能在同一套结构里表达。
好处是 diff 天然可审计:能按步骤分组展示、能逐条拒收(从执行前状态重放并跳过)、能做版本回滚(含 target_version=0 回到原始数据)。另外还有一层 drift 检测,对比清洗前后的分布漂移。
5.4 分组切分:重试 30 次,直到两侧都有正例
同一患者多条记录是最典型的泄漏场景:随机切分会让同一人跨训练集和测试集,指标直接注水。SmeltLab 用 GroupShuffleSplit,但加了一层重试:
groups = df[group].cast(pl.Utf8).to_numpy()
for attempt in range(30):
    splitter = GroupShuffleSplit(n_splits=1, test_size=test_size,
                                 random_state=SEED + attempt)
    train_idx, test_idx = next(splitter.split(indices, groups=groups))
    if task != "classification":
        break
    # 尽量让两侧都有正例,否则 AUC 根本算不出来
    if y_all[test_idx].sum() >= 2 and y_all[train_idx].sum() >= 5:
        break
用 random_state = SEED + attempt 最多试 30 次,直到测试集 ≥2 个正例、训练集 ≥5 个正例。专门治"某一侧没有正例导致指标不可算"这个经典坑。
5.5 泄漏列的三重防御
- 统计型:
unique / rows > 0.9且是整型 → 判为"疑似 ID",剔除; - 语义型:列名命中中文关键词表 → 剔除:
LEAK_HINTS = ("费用", "出院", "入院时间", "出院时间", "icu", "ICU",
              "住院日", "住院天", "科室", "姓名", "地址", "电话", "呼吸机")
- 编码防泄漏:中位数填充值、类别序数映射表只从训练集学习:
train_values = values[train_idx]
median = float(np.median(finite))
categories = sorted({
   str(v) for v in train_values})   # 只认训练集见过的类别
目标列和分组列也用类似的关键词打分自动选(TARGET_HINTS / ID_HINTS,命中 +10 / -20,unique==2 再 +4)。
5.6 阈值不用 0.5:在 PR 曲线上找 F1 最大点
precision_curve, recall_curve, thresholds = precision_recall_curve(y_test, proba)
f1_curve = np.divide(2 * precision_curve * recall_curve,
                     precision_curve + recall_curve,
                     out=np.zeros_like(precision_curve),
                     where=(precision_curve + recall_curve) > 0)   # 安全除法防 0/0
best_pos  = int(np.argmax(f1_curve))
threshold = float(thresholds[min(best_pos, len(thresholds) - 1)])
pred = (proba >= threshold).astype(np.int64)
这个 threshold 会一起存进模型产物,推理时直接复用。默认 0.5 在不平衡数据上基本没法用。
另外模型择优指标选的是 PR-AUC 而不是 ROC-AUC —— 对不平衡数据更敏感。而且每个任务都会先训一个基线模型(多数类 / 中位数),你一眼就能看出模型到底学到了东西没有。
全部模型都显式带 class_weight="balanced" 和 random_state=SEED,面向医疗、风控这类天然不平衡的场景。
5.7 训练进度怎么来的:树模型分块 warm start
这是个很巧的实现。树模型没法像神经网络那样逐 epoch 报进度,于是切成 6 段,只改树的数量、不重建模型:
chunk = max(target_total // 6, 1)
model = make_model(model_name, {
   **params, "n_estimators": chunk}, task)
grown = 0
while grown < target_total:
    grown = min(grown + chunk, target_total)
    model.set_params(n_estimators=grown)      # 关键:只改树数量
    model.fit(X_fit_s, y_fit)
    metric = eval_metric(model, X_val_s, y_val, task)   # PR-AUC 或 R²
    curve.append([step, round(metric, 4)])
    emit(20 + 62 * step / total_steps, f"{label} {grown}/{target_total}", ...)
逻辑回归 / MLP 则走 partial_fit 增量学习。脚本内部再从训练集切 20% 做验证集,训练曲线画的是验证集指标,绝不用测试集调参。
5.8 标记行协议:一套进度机制同时喂 CLI 和 UI
生成的训练脚本通过三个 stdout 标记和后端通信(flush=True 是必须的,否则管道缓冲会让进度卡住):
def emit(pct, stage, **extra):
    print("@@PROGRESS " + json.dumps({
   ...}, ensure_ascii=False), flush=True)

def finish(payload):
    print("@@RESULT " + json.dumps(payload, ensure_ascii=False), flush=True)
# 异常兜底:print("@@ERROR " + json.dumps({"message": str(exc)}, ...))
后端 training_jobs.py 用 subprocess.Popen 拉起脚本,逐行分派到 progress / result / error / log,threading.Lock 保护共享状态。前端 700ms 轮询一次。
5.9 生成的训练脚本能直接带走
trainer_codegen 生成的不是一段伪代码,而是一个完整独立可运行的 Python 文件。所有 schema(列名、各列填充中位数、类别取值表)都硬编码进 CONFIG:
自律训练脚本 —— 由 SmeltLab 根据数据集自动生成
数据集:xxx.csv(1200 行 × 18 列)
目标列:是否死亡(二分类)
模型:随机森林 · 特征 15 个(数值 10 / 类别 5)
流程:读取数据 → 构建特征 → 切分 → 训练(逐轮上报进度)→ 测试集评估 → 保存模型与预测
运行:python 本文件
零依赖后端,直接 python xxx.py 就能跑,可以拷进你自己的流水线。界面上也有「查看训练代码」按钮。
5.10 前端:对话即 UI
两个约定很值得借鉴:
- LLM 输出
chart 代码块就渲染成图,输出train-config 就渲染成可交互训练卡。后端只吐 JSON spec,前端手写 SVG 渲染(柱状/折线/多线/热力图/饼图五种,零第三方依赖)。 - 训练卡上的「让 AI 解读结果」按钮,本质是
window.dispatchEvent(new CustomEvent('smeltlab:ask', ...)),对话页监听后把这段文本当一条新用户消息发回 Agent —— 形成"工具 → 对话"的闭环。
进度条做了三态降级,避免"转圈转半天不知道在干嘛":
// ① 有真实进度 → 百分比条
// ② 没进度但已跑 ≥8s 且有工具步骤 → 不确定态脉冲条 + 已耗时
// ③ ≥30s 还没正文 → 安抚文案:「这一步比较耗时,仍在执行中;不想等可以点右下角停止。」
5.11 顺带一提:Windows 上的坑基本都踩过了
- npm 全局的
pi.cmd无法直接被subprocess拉起 → 映射成"<node路径>|<cli.js路径>"再还原 argv; - Windows 的 proactor 事件循环对 asyncio subprocess 支持不稳 → 改用
threading.Thread+queue.Queue回传,配CREATE_NO_WINDOW防弹窗; - 管道默认 GBK 会让 Agent 读到乱码 →
stdout/stderr强制reconfigure(encoding="utf-8")+PYTHONIOENCODING=utf-8; - 杀进程要杀树 →
taskkill /PID x /T /F。
六、命令行也能用
不想开界面?CLI 覆盖了完整链路,可以接进你自己的流水线:
cd backend

# 体检:健康分 + 问题清单 + 目标列候选 + 推荐训练配置
python -m app.cli profile --file ../sample_data/dirty_patients.csv

# 清洗:9 种操作自由组合
python -m app.cli clean --file ../sample_data/dirty_patients.csv \
    --ops dedup,missing,outlier,text_clean,pii_mask --out cleaned_patients.csv

# 看训练推荐配置
python -m app.cli schema --file cleaned_patients.csv

# 直接训练(分组切分 + 时间预算)
python -m app.cli train --file cleaned_patients.csv --target 并发症 --group 患者编号 --time-budget 300

# 全部可用操作
python -m app.cli ops
CLI 的输出协议也做了设计:中文摘要 + 末尾 ```json 代码块双轨——摘要给 Agent 读,JSON 给 Agent 解析关键数字。
七、和同类数据清洗 / AutoML 工具的区别
很多人会问:Python 数据清洗用什么库好?pandas、OpenRefine、ydata-profiling 和 SmeltLab 该怎么选? 简单对比一下:
| 工具 | 它擅长什么 | SmeltLab 的不同 |
|---|---|---|
| pandas 手写脚本 | 完全可控,任何奇怪需求都能写 | 把「体检 → 清洗 → 建模 → 解读」串成一条链路,清洗步骤可存成 Recipe 复用,不必每份数据重写一遍 |
| OpenRefine | 人工逐条整理、聚类合并脏值 | 侧重自动体检,并与后续建模衔接,支持「说一句话」触发多步清洗 |
| ydata-profiling | 生成详尽的数据画像报告 | 画像只是第一步,后面直接接清洗与训练,不用换工具 |
| 云端 AutoML 平台 | 模型调优与算力强 | 本地优先,预置功能可全程离线运行,数据不出本机 |
八、Roadmap
- [ ] 多分类与多目标支持
- [ ] 超参数自动搜索(Optuna)
- [ ] Docker Compose 一键部署
- [ ] Recipe 社区市场
已上线:数据体检(健康分 + 5 大类问题)· 9 种预置清洗 + diff 审查 · 对话式清洗且过程可见 · 训练卡(目标列/分组列/泄漏列自动推荐)· 4 种模型 + 曲线 + 特征重要性 + AI 解读 · JSONL 训练日志(可实时逐行读取)。
九、常见问题(FAQ)
Q:数据会被上传到云端吗?
不会。体检、清洗、建模、指标曲线全部在本地进程内用 Polars / scikit-learn 完成,原始文件与产物留在本机。只有「对话式清洗」「AI 解读」会调用你自己在 .env 里配的模型服务商。
Q:不配 API Key 能用到什么程度?
核心链路完整可用:上传 → 数据体检(健康分 / 5 大类问题 / 列级画像)→ 勾选清洗操作 → 改动前后 diff 审查 → 训练卡建模 → PR-AUC / ROC / 混淆矩阵 / 特征重要性。缺的只是"用人话下指令"和"AI 解读指标"。
Q:支持哪些数据格式?
CSV、Excel(.xlsx / .xls)、JSON、JSONL、Parquet;导出结果支持 CSV / JSON,CLI 支持 CSV 与 Parquet。
Q:缺失值是怎么处理的?
体检阶段先报每列缺失率(>5% 提示、>20% 判为严重),清洗阶段可选策略:drop(删行)/ fill_mean(均值)/ fill_median(中位数)/ fill_mode(众数)/ fill_value(指定值),不指定列时自动对所有有缺失的列生效。建模阶段另有兜底:缺失率 >90% 的特征直接剔除,填充用的中位数只从训练集学习。
Q:如何避免数据泄漏(data leakage)?
三层防御:① 分组切分——同一实体的多条记录不会跨训练集和测试集,且会重试 30 次确保两侧都有正例;② 自动剔除泄漏列——"费用""出院""科室"等事后信息关键词命中即剔除,取值近乎唯一的整型列也判为 ID 剔除;③ 编码防泄漏——填充值和类别映射表只从训练集学习。
Q:能处理多大数据量?
面向本地单机的中小规模表格数据(训练集上限 5 万行抽样),规模主要受内存限制,尚未针对分布式或亿级数据优化。
Q:清洗会覆盖原始数据吗?
不会,结果写入新文件,每一步改动都能在 diff 里逐列对比后再确认,也支持版本回滚到原始数据。
Q:支持多分类和回归吗?
当前支持二分类与回归(随机森林 / 梯度提升 / 逻辑回归 / 神经网络),多分类与多目标在 Roadmap 中。
十、最后
如果你也受够了每来一份新数据就重写一遍 pandas 清洗脚本,想找一个能自动做数据清洗、自动处理缺失值和异常值、还能一键自动建模的开源工具,欢迎试试 SmeltLab,也欢迎去点个 Star,这对接下来的开发帮助很大:
🔗 https://github.com/PHclaw/smeltlab
也欢迎提 Issue 和 PR(见 CONTRIBUTING.md)。
想请教大家一个问题:你最想让 SmeltLab 自动处理的脏数据场景是什么? 评论区聊聊,说不定下个版本就有了。
Tags:
数据清洗机器学习AutoMLPythonPolarsFastAPINext.js开源项目项目地址:https://github.com/PHclaw/smeltlab | License:MIT | 欢迎 Star ⭐


