
很多企业做实时数据平台,真正卡住项目的往往不是数仓建模,而是最前面的两个字:采集。 ERP、MES、WMS背后可能是MySQL、Oracle;生产现场有PLC、传感器和工业网关;业务事件进入Kafka;设备平台又通过MQTT、WebSocket持续推送数据。
如果每来一种数据源就单独开发一套接口,系统少的时候还能维护,系统一多,数据团队很快就会陷入脚本、驱动、接口和异常处理的泥潭。真正成熟的实时采集,不应该追求“接口越写越多”,而应该建立统一的数据接入层,把不同来源的数据收敛成可管理、可恢复、可监控的数据流。
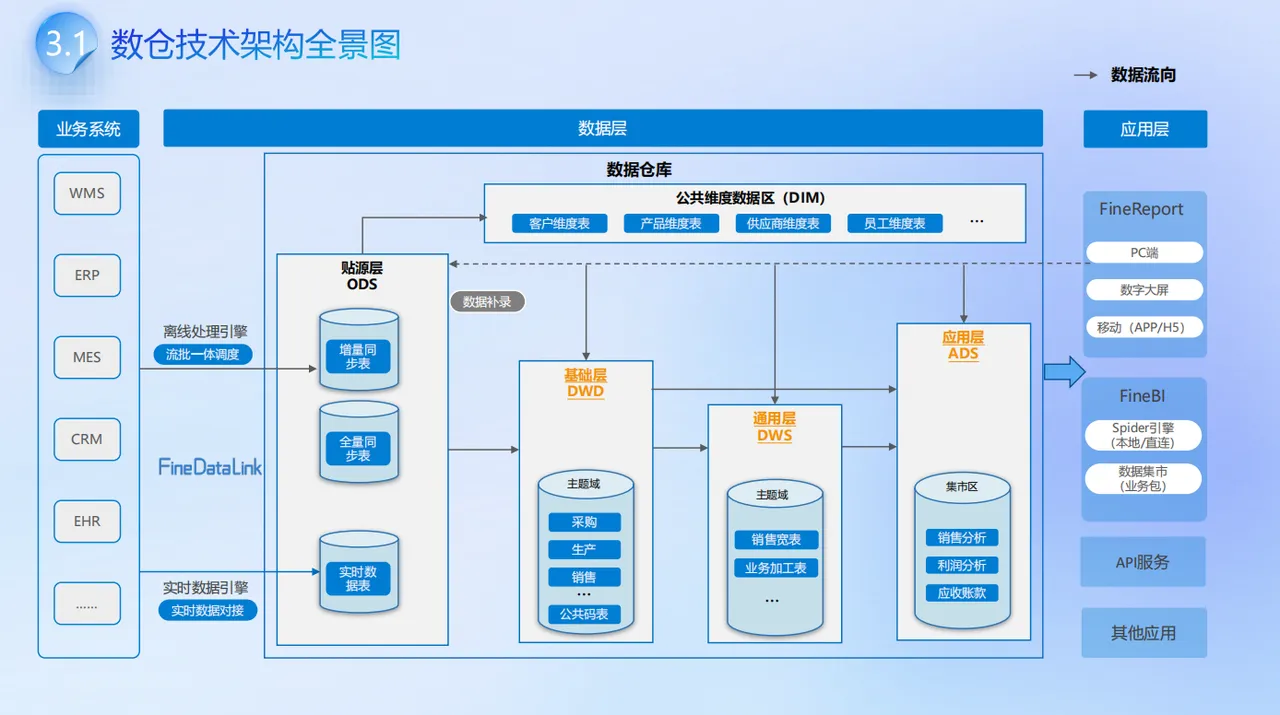
一、PLC实时采集:先解决协议异构,再谈实时
工业现场最大的特点不是数据多,而是设备和协议太杂。同一座工厂里,可能同时存在不同品牌PLC,底层又涉及Modbus TCP、OPC UA以及厂商专有协议。如果MES、设备管理、能耗平台、数据中台都分别连接PLC,同一台设备就可能被多个系统反复访问。
最终通常会出现三个问题: 设备侧连接压力增加; 驱动和协议适配重复建设; 设备调整牵动多个上层系统。
所以规模化项目更合理的架构往往是:PLC/传感器 → 工业网关或边缘采集层 → MQTT/WebSocket等标准协议 → 数据平台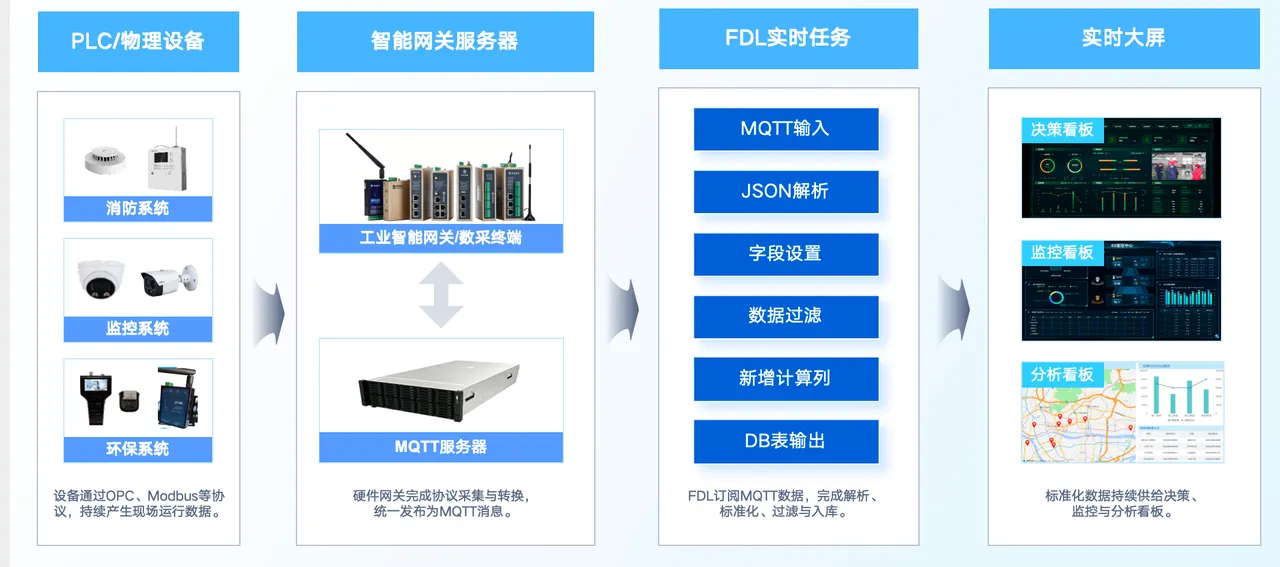
边缘层负责处理设备差异,上层只面对标准化数据流。这时候,数据平台真正需要解决的,就不再是“怎么连接某一台PLC”,而是标准化后的设备数据怎样持续接入、解析、处理和分发。
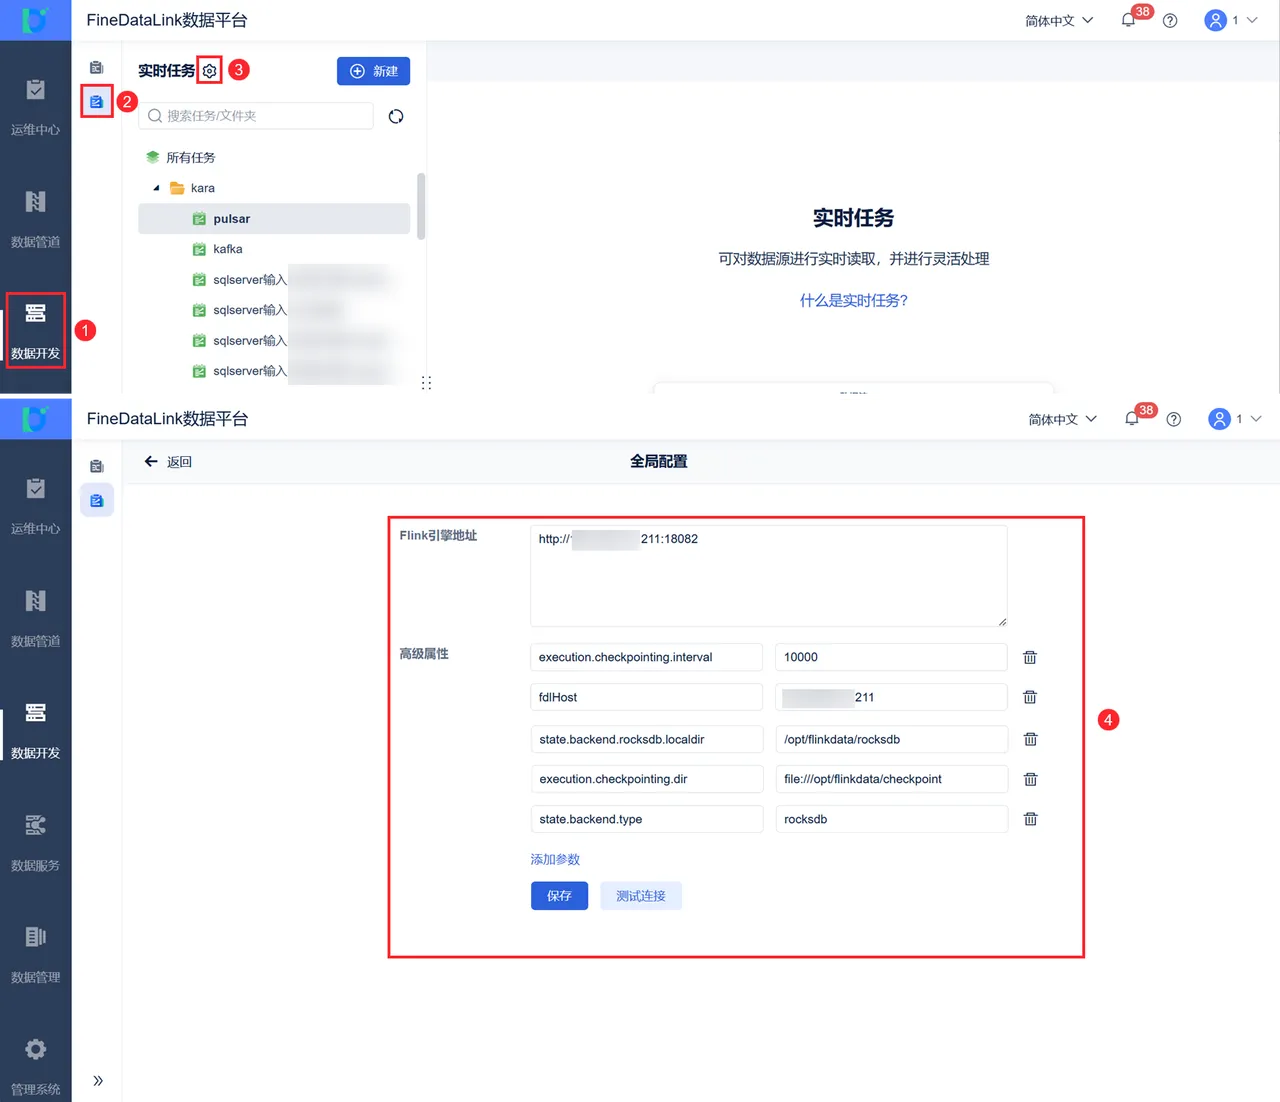
例如工厂已经通过工业网关把设备点位统一发布到MQTT,后续就没有必要再为每类设备重新写采集程序。这一段标准化后的数据链路:从MQTT、WebSocket等实时来源接收数据,再进入后续处理和落库流程。这样设备侧新增品牌、替换PLC时,变化主要留在网关和点位配置层,而不必一路传导到数仓和分析系统。所以工业实时采集的第一原则其实是:不要让数据平台直接面对所有设备复杂度,而要先把协议复杂度收敛掉。
二、Kafka实时接入:真正难的是不乱、不丢、能恢复
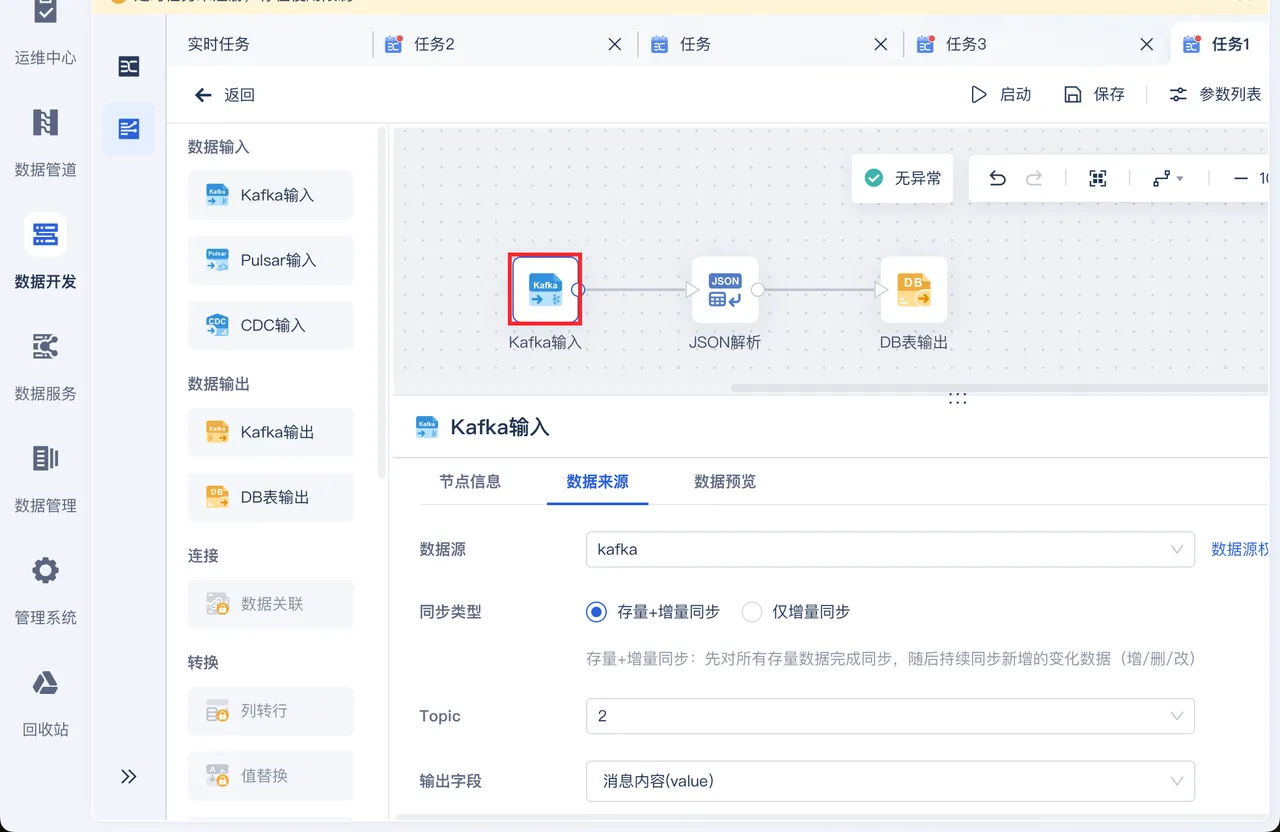
Kafka已经成为很多实时架构里的“中转站”。订单创建、设备报警、生产完工、库存变化等事件先进入Kafka,再分别被实时数仓、大屏、风控和其他业务系统消费。
这样做最大的价值,是把生产者和消费者解耦。业务系统只负责产生事件,不需要知道后面究竟有几个系统使用。但Kafka并不是“消费到消息”就结束了。
真正进入生产环境以后,至少要解决四个问题:Topic怎么规划、Partition怎么设计、Offset怎么管理、消息结构怎么统一。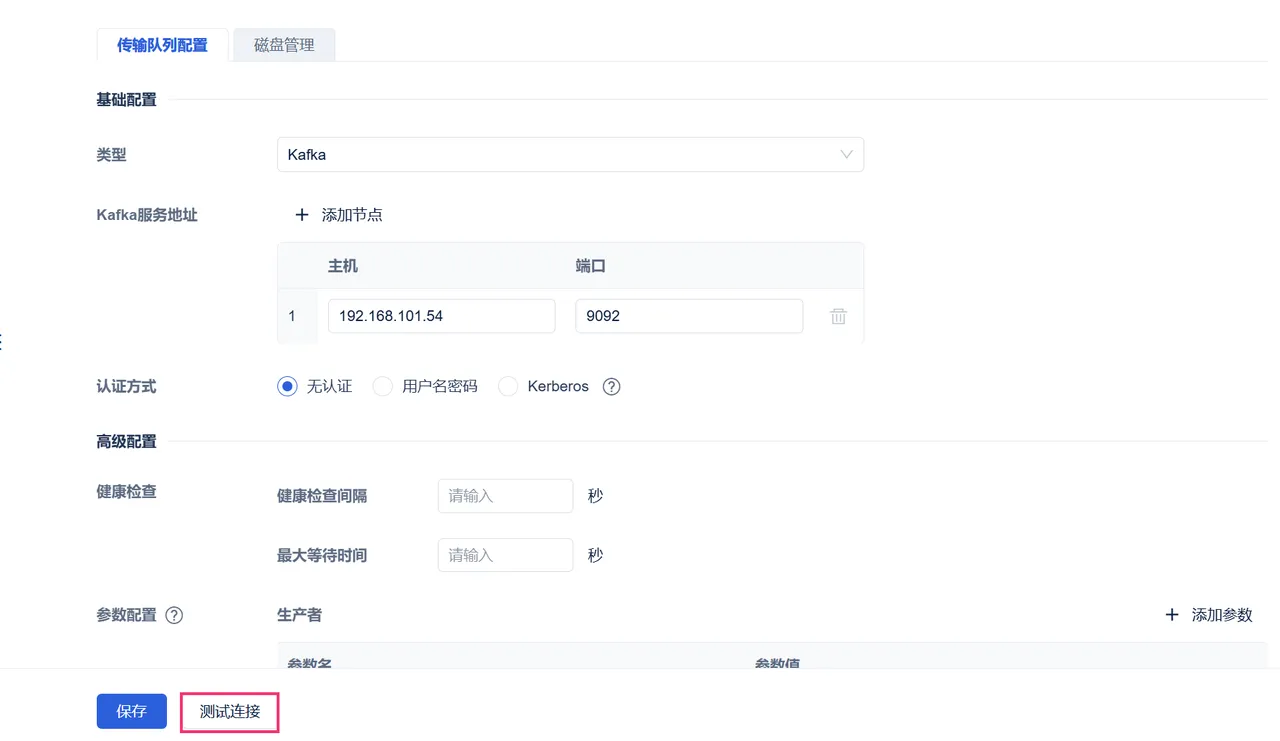
比如同一个订单连续经历:创建 → 支付 → 发货。 如果相关事件无法保持合理的分区和处理顺序,就可能出现后发生的状态反而先入库。
任务中断以后也一样。如果不知道上一次消费到哪里,重新启动时就可能重复读取;如果恢复位置错误,又可能直接漏掉一段数据。因此Kafka实时链路真正需要设计的是:分区键、顺序性、幂等、断点、消息版本和异常处理。
尤其是幂等。实时系统里,“至少处理一次”往往比“绝不重复”更容易保证,所以目标端必须考虑:同一条消息来了两次,会不会生成两笔订单、两条库存记录?
这也是实时系统和普通接口最大的区别之一:真正可靠的实时,不只是数据来得快,而是数据重复、乱序、任务重启以后,结果仍然可信。
三、数据库实时同步:别再反复查表,核心是捕获“变化”
数据库实时同步最典型的需求是:ERP刚产生一笔订单,希望几秒钟以后数仓就能看到。最直接的方法是不断执行:WHERE update_time > 上一次同步时间
数据量小时确实能用。但表从几十万行增长到几亿行以后,高频查询会持续占用源库CPU、IO和索引资源,而且还有几个天然问题:删除数据怎么发现?事务延迟怎么办?任务停掉以后从哪里恢复?
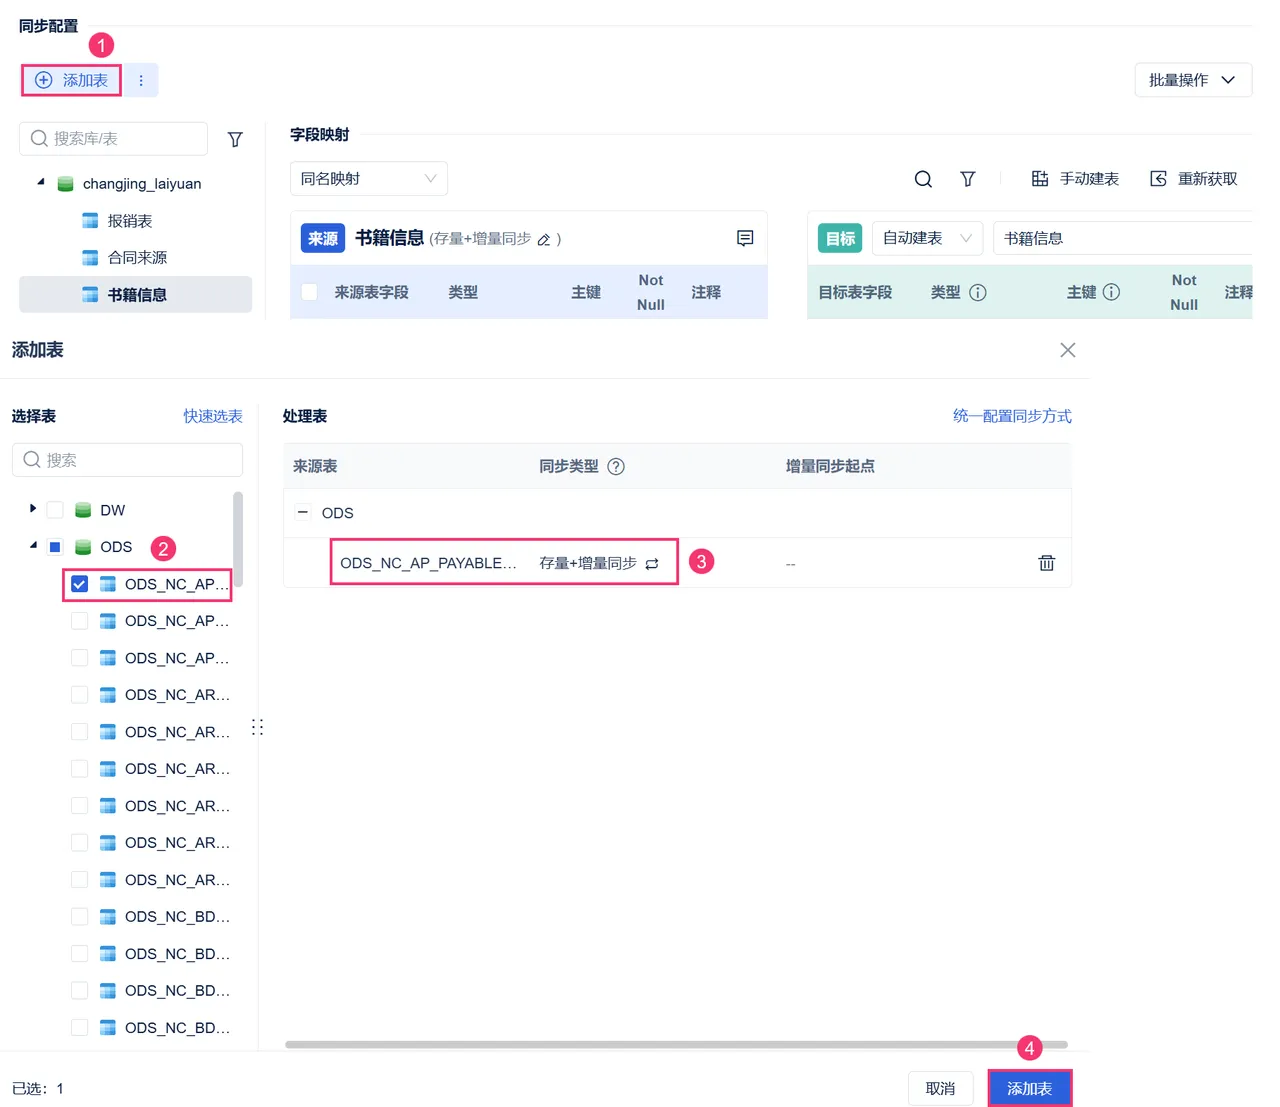
因此真正的数据库实时同步,通常会转向CDC,也就是变更数据捕获。数据库执行INSERT、UPDATE、DELETE时,本身就会生成事务日志。
CDC不是不断询问数据库:“现在有没有新数据?” 而是直接读取数据库已经记录的变化:“刚刚哪条数据发生了什么变化?”
完整链路通常是:全量初始化 → 记录日志位置 → 持续捕获增删改 → 写入目标端 → 保存断点, 这里还有一个特别容易被忽略的东西:主键。
更新和删除要准确同步到目标端,首先必须知道到底是哪一条记录发生了变化。如果来源表没有稳定的唯一标识,实时同步很容易从“数据传输问题”升级成“数据一致性问题”。
判断数据库实时方案时,不要只看“能不能做到秒级”。更应该看三件事:是否减少源库扫描、是否完整覆盖增删改、失败以后能不能从正确位置继续。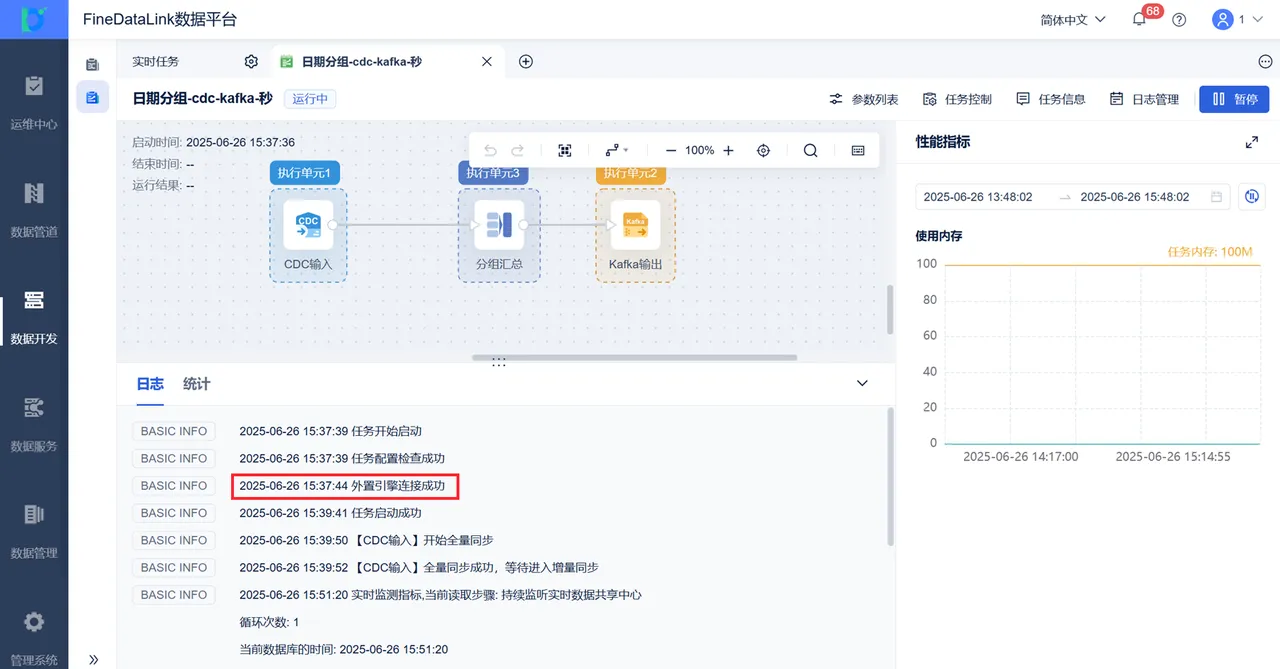
四、采集以后不处理,只是在更快地搬运脏数据
实时数据很少能够原样使用。例如设备上报:{"device":"A01","temp":"82.3","status":"01"}业务真正想看到的却可能是:设备A01、温度82.3℃、当前运行、所属二号产线、触发高温预警。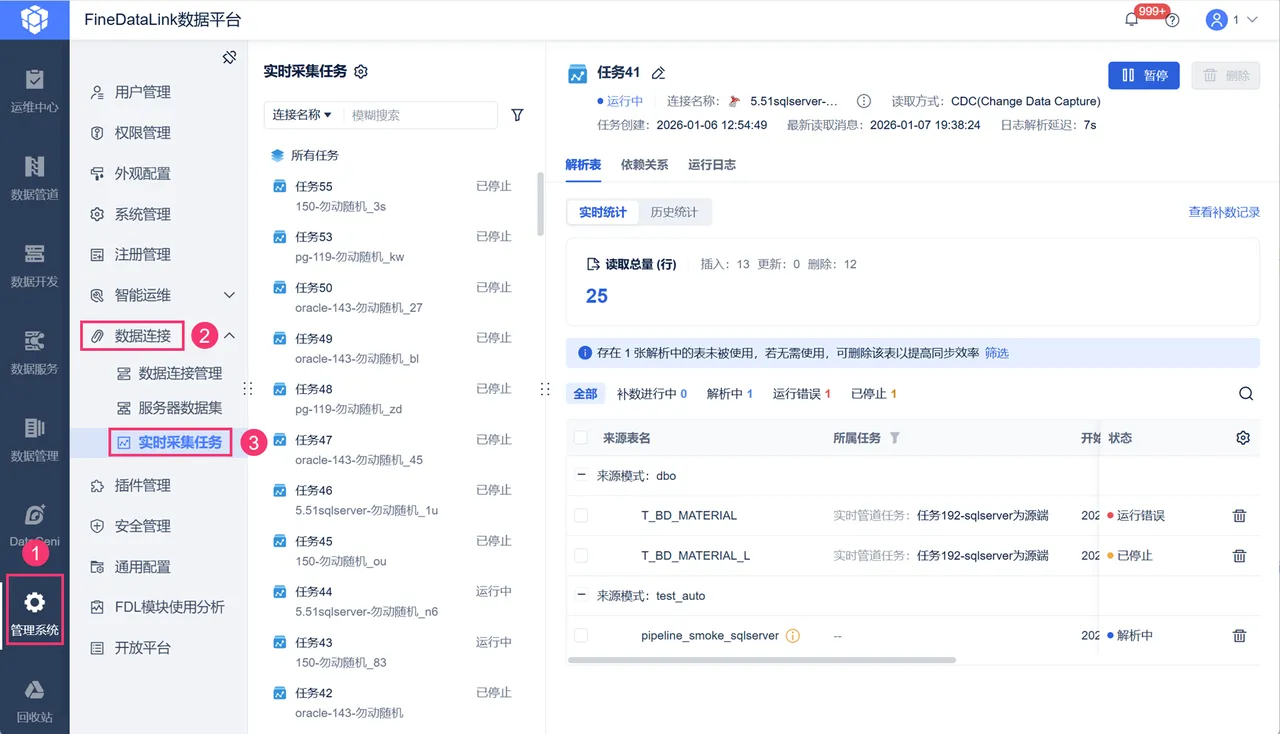
中间至少发生了:JSON解析、数据类型转换、状态码映射、规则判断。 如果采集平台只负责把数据搬进来,企业往往还要在后面再搭一套脚本、流计算程序或者接口服务。最后就会形成:采集一套、处理一套、调度一套、监控再一套。 系统越来越多,问题排查也越来越困难。
对于这类“数据刚进来就必须处理”的工作,没必要再额外维护一批脚本。比如MQTT里收到设备JSON后,可以在数据链路里直接完成字段解析、类型转换、过滤和计算,再将整理后的结果写入数据库或继续发送到Kafka。这样采集与基础处理处在同一条链路上,出现异常时也不用在采集程序、Python脚本和目标库之间来回排查。
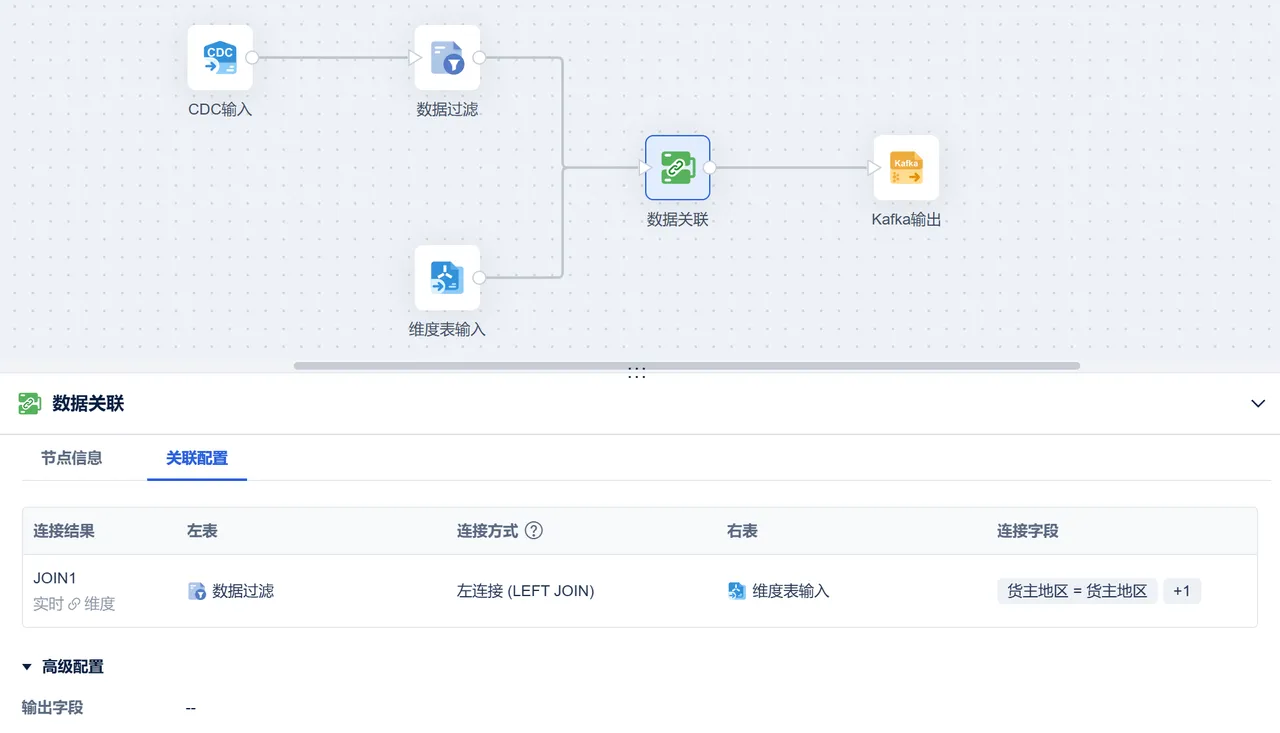
但这里也要明确一个边界:不是所有计算都应该实时化。 实时层更适合高频、规则明确、对时效敏感的处理。复杂历史重算、大范围多表分析、周期性指标加工,仍然可以留在离线数仓。
真正合理的实时架构,不是把整个数仓改造成流计算,而是:把必须马上处理的事情前移,把不需要马上处理的事情继续留在离线体系里。
五、50张表做50个CDC任务,源数据库可能先扛不住
实时任务少的时候,很少有人关注一个问题:数据库日志到底被解析了多少次? 假设ERP里有50张业务表需要实时同步。最直接的做法,是建立50个CDC任务。看起来每个任务各管一张表,非常清晰。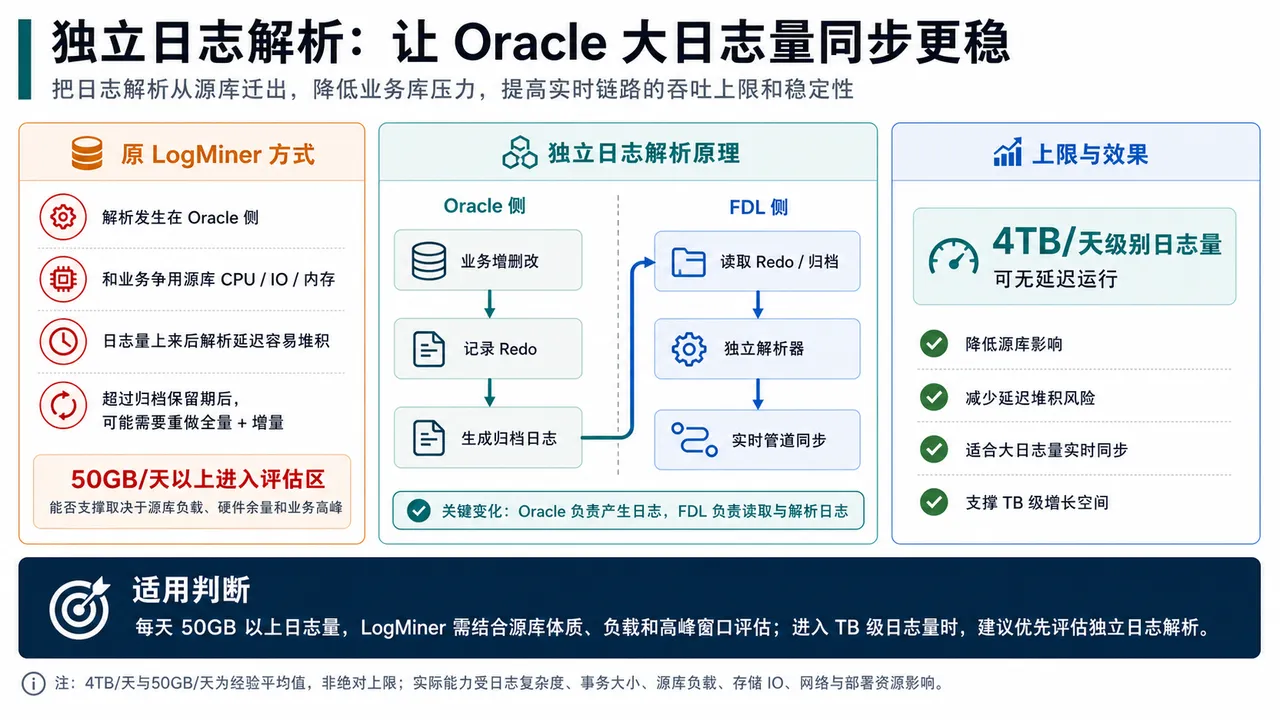
但如果每个任务都独立读取一次数据库日志,就意味着:同一份Binlog或事务日志,可能被反复解析。 任务数量越来越多以后,实时平台还没出问题,源数据库和采集端的资源压力可能先上来了。
因此规模化实时采集应该进一步把:日志解析和业务消费拆开。更合理的结构是:数据库日志 → 统一采集 → 变更数据共享 → 多个实时任务分别消费, 也就是:日志解析一次,变化数据可以被消费很多次。
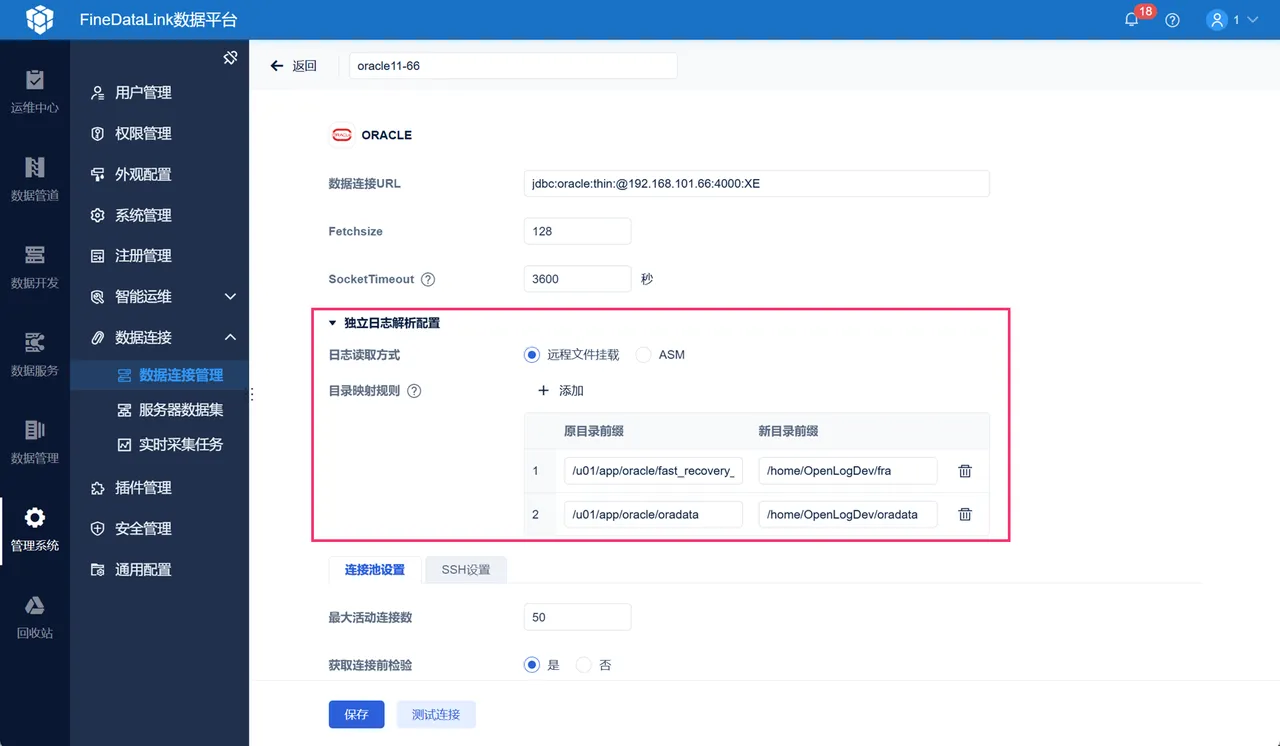
因为实时平台一旦规模扩大,决定它能不能撑住的往往不是连接器数量,而是:底层公共能力有没有被复用。 能共享的能力如果随着任务数量不断复制,10个任务还能运行,100个、500个任务以后,架构成本就会快速放大。
六、真正的实时采集平台,至少要管住这5层
如果企业准备建设统一实时数据体系,可以把整体架构拆成五层。
数据源层
PLC、传感器、数据库、Kafka、MQTT、WebSocket以及各种业务系统。这一层天然异构,不要试图强迫所有系统使用同一种接入方式。
接入层
解决“数据怎么进入平台”。设备侧通过边缘网关收敛协议,数据库通过CDC捕获变化,Kafka负责事件流接入。
处理层
解决“进入的数据能不能直接用”。包括JSON解析、字段转换、编码映射、过滤、规则计算等。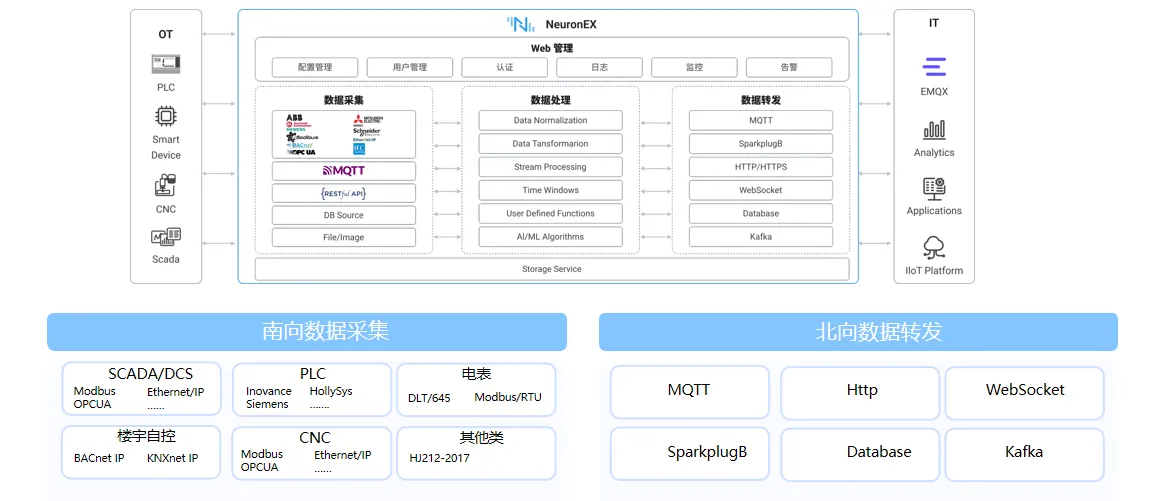
存储与分发层
数据可能进入实时数仓、业务数据库、Kafka或者分析平台。这里除了写入速度,还要关注:目标端失败怎么重试?重复写入怎么处理?
运维治理层
这是最容易被忽视的一层。至少要持续监控:输入速度、输出速度、端到端延迟、积压量、异常次数、断点位置和脏数据。
因为:“任务正在运行”不等于“数据真的实时”。 假设源端每秒产生1万条数据,而下游每秒只能处理5000条。任务没有停止,但是数据会不断积压。
一个小时以后,大屏显示的可能已经是几十分钟前的数据。所以真正应该监控的是完整链路:事件产生 → 数据采集 → 实时处理 → 成功落库。 只有端到端延迟长期稳定,所谓的“实时”才真正具有业务意义。
结语
过去企业做数据采集,习惯围绕系统开发:ERP写一个接口,MES写一个接口,PLC再写一套程序,Kafka再开发一个Consumer。这种模式最大的问题,不是单次开发有多难,而是:每增加一个系统、一个数据源、一个实时场景,都要重新增加一套技术负担。 所以实时数据建设最终要完成一次思路上的转变:从“项目式接接口”,走向“平台化接数据”。
设备侧通过边缘层收敛协议,数据库侧通过CDC读取变化,Kafka承担事件流转,实时处理完成必要的数据解析和转换,再把断点、积压、延迟、日志和异常恢复统一纳入运维体系。
真正有价值的实时数据平台,也不只是把数据延迟从一天缩短到一分钟、几秒钟。更重要的是建立一种可以不断复制的能力:以后再增加一条产线、一个PLC、一个数据库或者一个Kafka Topic,不需要再从头开发一套接口。 当数据接入从一个个独立项目,真正变成企业级基础能力,实时数据才算开始规模化。


