摘要:Structured Streaming 把“时间”拆成三种口径——事件时间、处理时间、摄入时间。选错时间,统计全错:延迟、重放、对账偏差都源于此。本文一次讲清三种时间的本质差异与责任边界(谁赋值、受不受延迟影响、重放是否一致),给出时间体系架构图与选型决策表,并用代码对比“事件时间窗口 vs 处理时间窗口”在故障重放下的口径漂移,最后点出四类高频翻车点。
关键词:Structured Streaming, Spark, 事件时间, 处理时间, 摄入时间, Event Time, Processing Time, Ingestion Time, Watermark, 流式计算
一、为什么会有三种时间
流数据没有“现在”。一条用户下单记录,业务系统 10:00 产生,因网络抖动 11:00 才进 Kafka,Spark 12:00 才处理——同一个事实,三个时间都不一样。
Structured Streaming 不是“不知道用哪个时间”,而是显式区分三种时间口径,把选择权和后果都交给你:
- 事件时间(Event Time):数据自己携带的发生时间;
- 摄入时间(Ingestion Time):数据进入流式系统的时间;
- 处理时间(Processing Time):算子真正执行计算的机器时间。
时间口径选错,是流计算里最隐蔽、最容易被“对账才发现”的坑。
二、三种时间各是什么
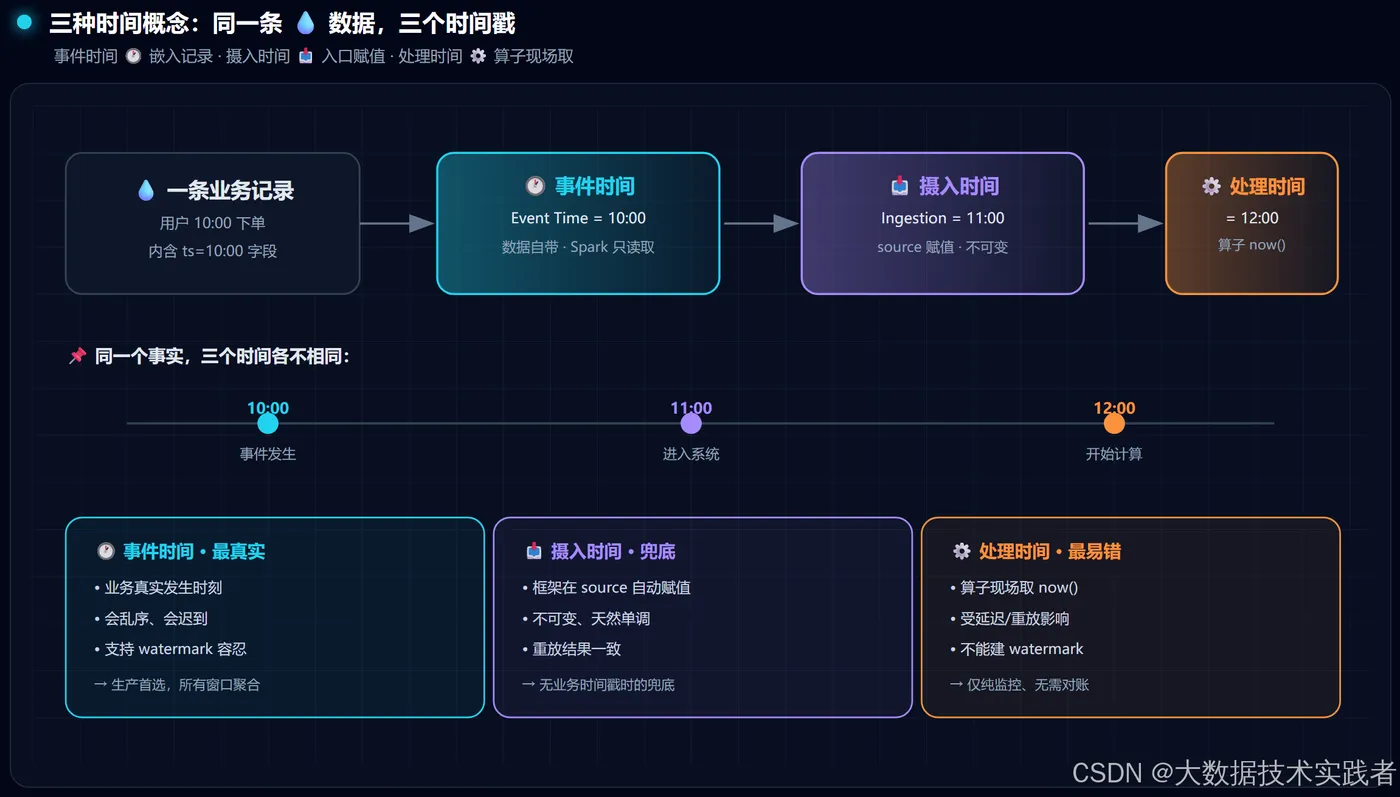
事件时间 🕐:嵌入在数据记录里的业务时间戳(如 eventTime 字段)。它最贴近真相,但现实里常常乱序、迟到——网络重传、客户端缓存、分区重平衡都会让它晚到。窗口聚合和 watermark 都围绕它构建。
摄入时间 📥:数据进入 Structured Streaming 的那一刻,由框架在 source 端自动赋值(Kafka source 的 timestamp 列就是它)。它介于事件时间与处理时间之间:一旦分配就不可变、天然单调递增,重放时不会变。适合“上游没有可靠业务时间戳”的兜底场景。
处理时间 ⚙️:记录被某个算子执行时的当前系统时间(相当于 current_timestamp())。它最简单、最省心,但受延迟和重放双重影响——同一批数据,今天跑和明天重跑,窗口归属可能不同。
三、时间体系架构:时间在哪一层被确定
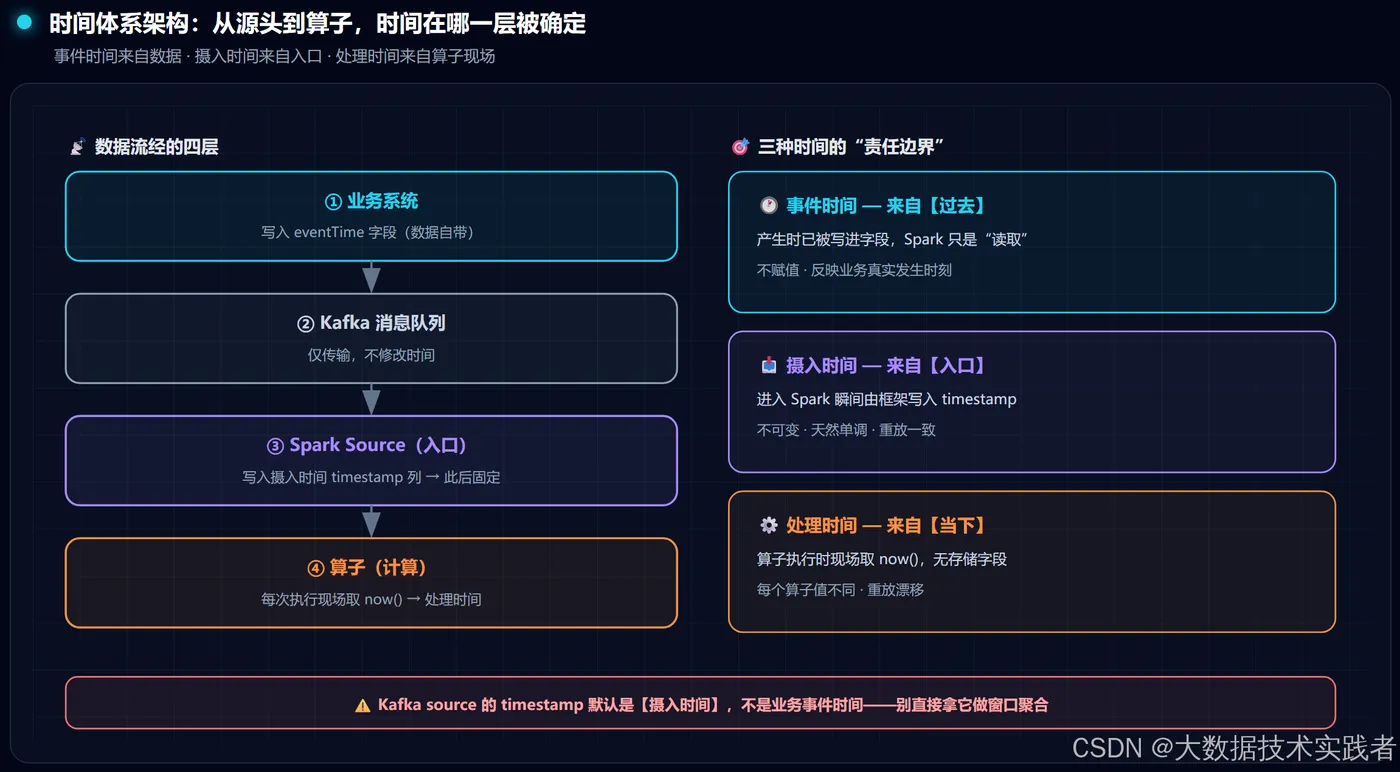
从数据源头到算子,三种时间在不同层级被确定,这是理解它们的关键:
- 事件时间:在数据产生时就被写进字段,Spark 只是把它“读出来”,自己不赋值;
- 摄入时间:在 Spark Source 接收数据的瞬间由框架写入
timestamp列,此后固定; - 处理时间:没有存储字段,每次算子执行时现场取
now(),每个算子看到的值都不同。
一句话记忆:事件时间来自过去(数据自带),摄入时间来自入口(框架赋值),处理时间来自当下(算子现场取)。
四、三种时间怎么用
| 维度 | 事件时间 | 摄入时间 | 处理时间 |
|---|---|---|---|
| 谁赋值 | 业务系统(数据自带) | Spark 框架(source) | 算子现场 now() |
| 受延迟影响 | 会乱序、迟到 | 基本不受 | 完全受 |
| 重放一致 | 一致 | 一致 | 不一致 |
| 能否用 watermark | 能 | 能 | 不能 |
| 适用场景 | 所有窗口/聚合 | 无业务时间戳兜底 | 纯监控/无需对账 |
代码上三者的差别只在“时间列从哪来”:
// ① 事件时间:从数据字段提取,这是生产首选
val df = raw.withColumn("eventTime", to_timestamp($"ts"))
            .withWatermark("eventTime", "10 minutes")

// ② 摄入时间:直接复用 Kafka source 自带的 timestamp 列
val df2 = kafkaDF.withWatermark("timestamp", "10 minutes")

// ③ 处理时间:现场取当前时间(不推荐用于需对账的统计)
import org.apache.spark.sql.functions.current_timestamp
val df3 = raw.withColumn("procTime", current_timestamp())
五、核心结论:生产默认用事件时间
为什么 90% 的场景该用事件时间?因为只有它反映业务真实发生时刻。处理时间统计在延迟、重放下会口径漂移;摄入时间解决了“无业务时间戳也要乱序容忍”的问题,却丢掉了真实发生时刻。
关键坑:Kafka source 的 timestamp 默认是摄入时间(broker 收到时间),不是业务事件时间。很多人直接拿它做窗口聚合,结果大屏数字和离线按事件时间重算对不上——对账偏差就来自这里。
事件时间 + watermark 才能正确处理乱序:
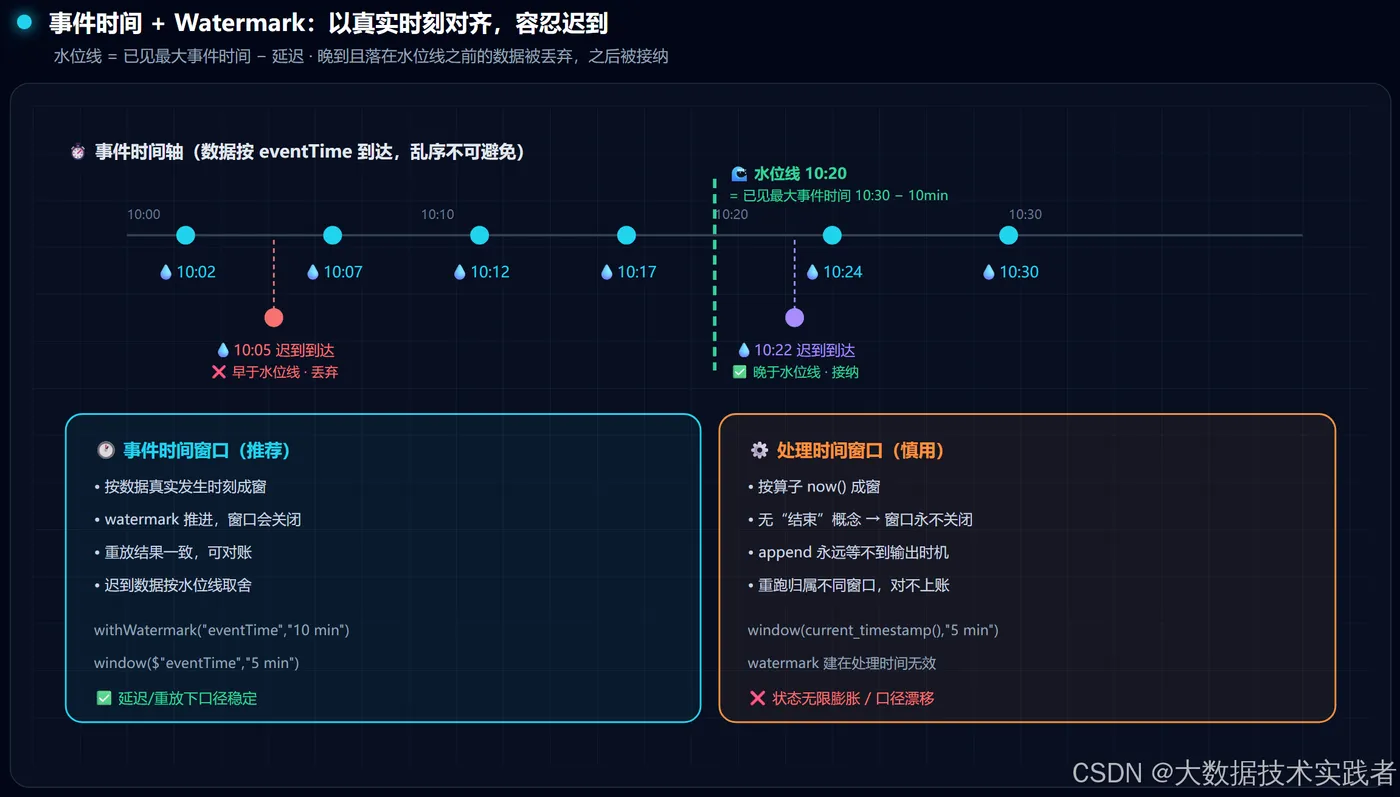
val result = kafkaDF
  .selectExpr("cast(value as string) as json")
  .select(from_json($"json", schema).as("d"))
  .select($"d.eventTime", $"d.province", $"d.cnt")
  .withWatermark("eventTime", "10 minutes")        // 水位 = 最大事件时间 − 10min
  .groupBy(window($"eventTime", "5 minutes"), $"province")
  .agg(sum("cnt").as("total"))

result.writeStream.outputMode("append").format("kafka")
  .option("topic", "province_5m").start()
对比:若把窗口建在处理时间上 window(current_timestamp(), "5 minutes"),窗口永不关闭(处理时间没有“结束”概念),append 模式永远等不到输出时机,update/complete 模式状态无限膨胀。
六、摄入时间的正确打开方式
当上游设备时钟不可信(如 IoT 传感器无 NTP)、或业务本身不关心真实发生时刻、只关心“到达后的处理”,用摄入时间兜底:它同样支持 watermark 推进,仍能容忍一定程度的乱序。
// 上游无可靠事件时间:用 Kafka 摄入时间做水位
val safe = kafkaDF
  .withWatermark("timestamp", "2 minutes")   // 摄入时间天然单调,水位稳定
  .groupBy(window($"timestamp", "1 minute"))
  .agg(count("*").as("arrived"))
注意:这样统计的是“每分钟到达多少条”,不是“每分钟发生多少条”——口径差异要在下游说清楚。
七、选型决策清单
- 有可靠的事件时间字段 → 事件时间(首选,所有窗口/聚合/对账);
- 无事件时间、又要容忍乱序 → 摄入时间(兜底,口径是“到达时刻”);
- 纯监控、不要求重放一致、越简单越好 → 处理时间。
八、四类高频翻车点
把 Kafka 摄入时间当事件时间:大屏与离线对不上。事件时间必须来自数据业务字段,先验证上游时钟无明显漂移。
处理时间窗口在重放下漂移:同一数据今天和重跑归属不同窗口。需对账的统计一律用事件/摄入时间。
watermark 只能建在事件/摄入时间上:建在处理时间毫无意义(窗口永不关闭)。报错不明显,只会“不输出”或“状态爆炸”。
上游时钟不同步:NTP 漂移让事件时间乱序更严重,watermark 延迟要按实测 p99 加余量,不能拍脑袋。
九、总结
- 三种时间责任边界清晰:事件时间来自数据、摄入时间来自入口、处理时间来自算子现场;
- 生产默认事件时间;无业务时间戳用摄入时间兜底;纯监控可用处理时间;
- watermark 只服务于事件/摄入时间,处理时间窗口永不关闭是铁律;
- 高频翻车点对症:对不上账查时间字段来源、重放漂移查时间口径、不输出/状态爆查 watermark 与时间列。