
一条消息里写着 café,输入同样的词搜索却没有命中。排查时先别急着加模糊匹配:屏幕上相同的字形,底层可能使用了不同的 Unicode 序列。
以米米商聊为背景,已整理的手机端资料包含按文字关键词搜索聊天记录。本文借这一场景讨论独立的 JavaScript 文本匹配示例,不代表产品采用下文的搜索规则、索引或实现,也不扩展为图片、视频内容检索。所有消息均为合成数据。
1. 字形相同,不一定意味着字符串相同
字母 é 可以写成单一码点 U+00E9,也可以写成 e 后面跟组合重音 U+0301。这两种写法具有规范等价关系,但原始字符串并不相等。
const composed = "caf\u00e9";
const decomposed = "cafe\u0301";

console.log(composed === decomposed);         // false
console.log(composed.length, decomposed.length); // 4 5
console.log(composed.normalize("NFC") === decomposed.normalize("NFC"));
// true
这里的长度是 JavaScript 字符串的 UTF-16 代码单元数量,不是用户看到的字符数量。两者长度不同,正好提醒我们不要把显示结果直接当成存储结构。
Unicode 标准附录 #15区分规范等价与兼容等价,并定义相应的规范化形式。本文选用 NFC,让规范等价的文本进入同一种表示;它不是识别所有相似字形的工具。
| 两种输入 | 本文 NFC 策略的预期 | 不应混淆的规则 |
|---|---|---|
| é 与 e + 组合重音 | 可作为同一规范化文本比较 | 不表示删除了重音 |
| e 与 é | 仍不同 | 忽略重音需要另行约定 |
| A 与 a | 仍不同 | NFC 不等于大小写折叠 |
| 全角 A 与半角 A | 仍不同 | 兼容规范化是另一项选择 |
2. 原始正文和搜索键,应该分工保存
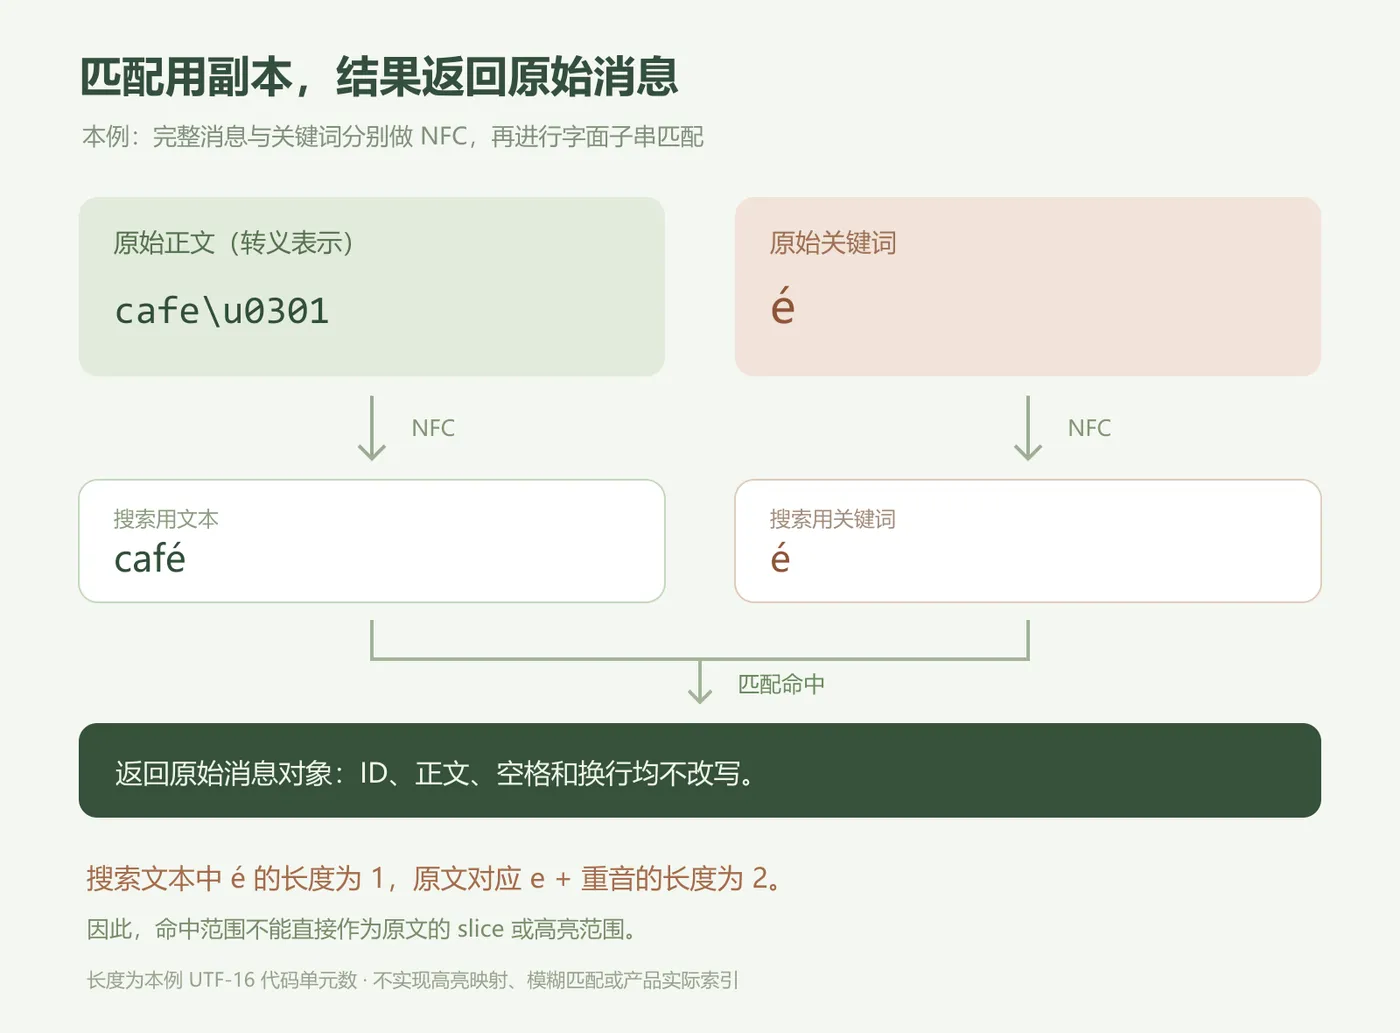
本文把用于比较的派生文本称为“搜索键”。原始正文用于展示、引用或复制,搜索键只承担当前规则下的匹配。生成搜索键,不需要覆盖原消息的 text 字段。
这个区分对排查很有帮助:如果命中结果出现异常,可以分别核对原始码点和派生结果;如果未来改变匹配规则,也可以从原文重新生成搜索键,而不是试图恢复已经改写的正文。
查询词也要经过同一条转换路径。只规范化消息、不规范化关键词,或者反过来,都会让相同规则在两侧表现不一致。本文只对正文和关键词的搜索副本做 NFC,不对消息 ID 或其他字段套用同样处理。
这个示例的“搜索”明确定义为:在 NFC 规范化后的完整消息中,进行区分大小写的字面子串匹配。它不提供分词、整词边界、字素簇边界、同义词或相似字识别。
3. 先生成关键词匹配器,再过滤原始消息
下面把关键词只规范化一次,再逐条检查消息。空字符串在本例中不返回任何结果;空格不会被自动裁剪,因此只含空格的查询仍按字面空格处理。真实产品可以选择其他规则,但需要明确说明。
function makeCanonicalMatcher(keyword) {

  if (typeof keyword !== "string") {

    throw new TypeError("Keyword must be a string");
  }
  const needle = keyword.normalize("NFC");
  return function matches(text) {

    if (typeof text !== "string") {

      throw new TypeError("Message text must be a string");
    }
    return needle !== "" && text.normalize("NFC").includes(needle);
  };
}

function searchMessages(messages, keyword) {

  const matches = makeCanonicalMatcher(keyword);
  return messages.filter(message => matches(message.text));
}
输入前提是有效的消息对象数组,每条消息的 text 为字符串;示例不是完整接口校验器。返回数组保留原有消息顺序,也保留命中消息对象本身,没有复制或改写它们。调用方之后若修改这些对象,仍会影响共享对象,不能把过滤结果理解成深复制。
normalize() 返回规范化后的字符串,具体用法可参考 String.prototype.normalize()。本文代码没有先转小写、移除重音或把关键词作为正则表达式执行。
因此,输入 e 不会因为 café 原文曾含有分解形式的 e 就必然命中:这份规则比较的是完整消息规范化后的文本,其中的 é 仍然带重音。规则应围绕实际比较对象解释,而不是混用转换前后的子串结果。
4. 规范化后命中了,也不能直接套用高亮下标
假设原消息用 JavaScript 转义写法表示为 cafe\u0301,关键词是 é。在 NFC 搜索文本中,命中位置对应一个代码单元;原文相应内容却由 e 和组合重音两个代码单元组成。
如果把规范化文本的起点和长度直接传给原文的 slice(),可能只截出 e,留下重音,或在后续位置切错范围。本文函数只返回命中的原始消息,不返回所谓“原文高亮位置”。
高亮是另一项任务:需要从转换后的范围映射回原文,并确认组合序列和显示边界。不要靠猜测一个固定长度差来修复,也不要为了省映射步骤,把原文悄悄替换成搜索键。
类似地,长消息分块建立索引时,也不能未经检查就假定“各块分别规范化后拼起来”必然等于“拼好完整文本再规范化”。组合序列可能跨越块边界。本文始终对完整的单条消息执行转换,不实现增量索引。
5. NFC 和 NFKC 的选择,会改变哪些输入被视为相同
NFC 不是“力度较弱但可以随意升级”的搜索开关。NFKC 还会处理兼容等价关系,例如把带圈数字 ① 转成 1。这样可能更容易搜到某些内容,也会合并原先保留的区别。
Unicode 附录关于兼容规范化的说明提醒,兼容形式可能移除有意义的区别,不能盲目用于任意文本。是否把全角、带圈字符或某些排印形式合并,应作为匹配规则来决定;展示用正文仍需有明确的保留策略。
同样,大小写处理、繁简转换、重音忽略和相似字识别,也不应被打包成一个没有说明的“统一清洗”。每多一个转换,就要核对它会合并什么、保留什么,以及是否影响位置映射。
如果把搜索键持久化,可以为生成策略记录版本。规则升级时,明确哪些索引需要重建;不能只改查询端,就默认旧索引已经使用新规则。这是工程设计建议,不是本文实现的索引系统。
6. 验证等价输入,也验证不该合并的区别
独立验证从本文两段 JavaScript 原样提取代码,用本地 Node.js 和合成文本运行。除 é 的两种形式外,还检查其他带组合符的字母和韩文音节的规范等价输入,并反向交换正文与关键词进行匹配。
| 检查场景 | 本文预期 |
|---|---|
| 合成形式正文,分解形式关键词 | 命中 |
| 分解形式正文,合成形式关键词 | 命中 |
| 普通 e 搜索 é | 不因 NFC 自动命中 |
| 小写查询搜索对应大写文本 | 不自动忽略大小写 |
| 1 搜索带圈数字 ① | 本例不命中 |
| 空字符串查询 | 没有结果 |
| 含空格、换行的原消息命中 | 返回原对象,正文原样保留 |
| 消息 ID 恰含可规范化字符 | ID 不被改写 |
这些检查验证的是本文定义的字符串匹配行为,不是完整 Unicode 一致性测试,也没有查询真实聊天记录、调用产品搜索接口或验证数据库排序规则。字体渲染和客户端输入法差异也不在本轮测试范围内。
排查“看着一样却搜不到”时,可以先对合成复现样本查看码点,再核对正文与查询是否采用相同转换;生产诊断无需把整段聊天正文写入日志。明确原文、搜索键及显示范围各自的职责,才能解释一次命中到底依据什么。
本文为独立教学示例,部分内容由 AI 辅助整理,代码与发布内容经独立核对。


