
SEO 标题:Hive是什么?一文讲透Hive架构原理、内外表/分区/分桶、存储格式选型与数据倾斜优化(附配置)
摘要:Hive 本身不存数据、也算不了数据,却是大数据离线数仓的事实标准。本文从数据仓库与数据库的本质区别讲起,拆解 Hive 四大核心角色、内外表/分区/分桶的表设计逻辑、ORC+Snappy 存储黄金组合,以及 Group By 与 Join 场景下的数据倾斜对症方案,配置均可直接复用。
关键词:Hive、数据仓库、Hive架构、Metastore、HiveServer2、分区表、分桶表、ORC、Parquet、数据倾斜、Hive优化、Map Join、Skew Join、SQL on Hadoop
每天,银行把数亿条交易记录写进离线数仓,分析师用一句 SELECT ... GROUP BY 就能扫完百亿行数据。支撑这一切的,很可能是 2010 年就开源的 Hive——一个自己不存数据、也不做计算的"胶水层"。
奇怪吗?一个 seemingly "什么都没干"的组件,为什么十五年过去仍是离线数仓的事实标准?这篇文章从定位、架构、表设计、存储、优化五个层面,把 Hive 讲透。所有配置均来自 Hive 4.0 实测环境,可直接复用。
一、定位:数据仓库不是"更大的数据库"
很多初学者把 Hive 当成"跑在集群上的 MySQL",这是理解偏差的根源。先看两者的本质区别:
| 维度 | 数据库(OLTP) | 数据仓库(OLAP) |
|---|---|---|
| 数据范围 | 当前状态数据 | 历史完整、反映变化的数据 |
| 操作特征 | 频繁增删改查 | 只增和查,几乎不更新删除 |
| 请求特点 | 小批次、高并发、低延迟 | 大批量、高吞吐、有延迟 |
| 建模思想 | 三范式、避免冗余 | 适当冗余、维度建模 |
| 使用者 | 一线业务系统 | 分析与决策场景 |
Hive 是基于 Hadoop 的数据仓库工具:用 SQL 读写存储在 HDFS 上的海量数据,HQL 默认翻译成 MapReduce 在 YARN 上执行(也可切换 Tez/Spark 引擎)。它把"会 SQL"和"会分布式计算"之间的鸿沟填平了——这是它统治离线数仓的根本原因。
同时要记住它的边界:Hive 为 OLAP 而生,不要拿它做高并发的线上事务系统。
二、架构:一条 SQL 背后的四个角色
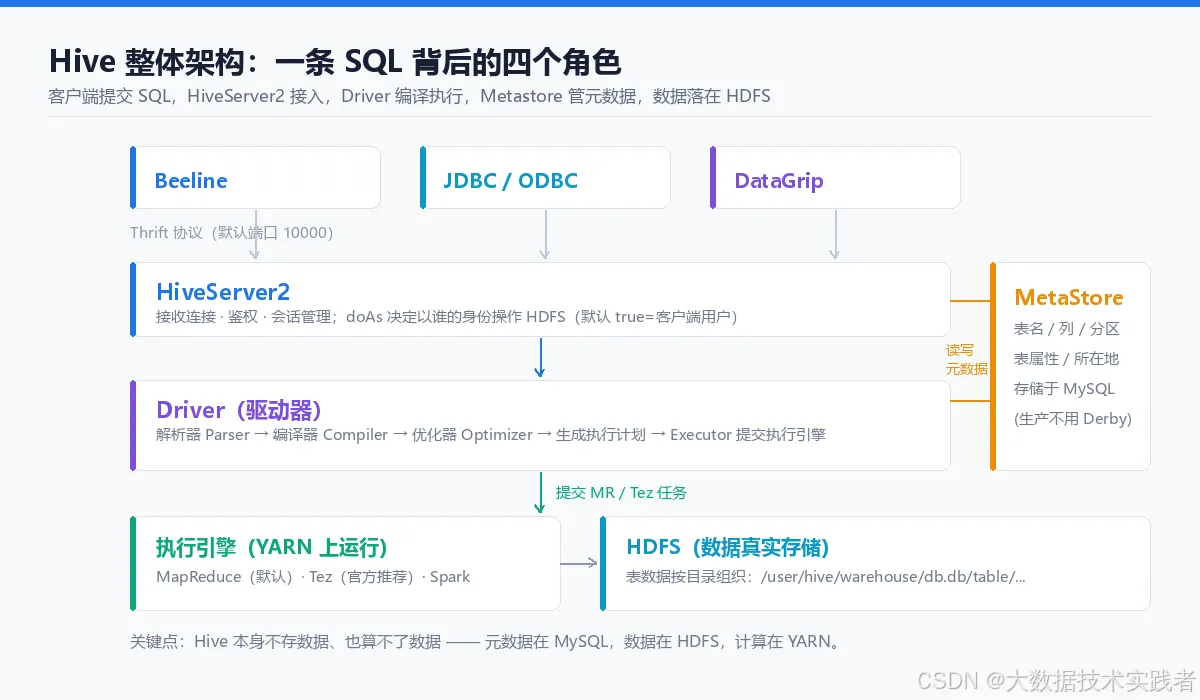
Hive 的架构可以浓缩为四个角色,理解了它们,99% 的连接类问题都能自行定位:
1. 客户端接入:HiveServer2。 Hive 4.x 已废弃老的 Hive CLI,统一走 Beeline(基于 JDBC)。Beeline → HiveServer2 是 Thrift 协议,默认端口 10000。一个高频坑:hive.server2.enable.doAs 决定 HiveServer2 以谁的身份操作 HDFS——默认 true 用客户端用户身份,设为 false 则全部以 HiveServer2 启动用户执行。权限报错时先查它。
2. 元数据中枢:MetaStore。 表名、列、分区、存储路径这些"数据的数据"存在 MySQL 里(自带的 Derby 只支持单连接,仅用于测试)。生产环境 Metastore 建议独立进程部署(9083 端口),客户端通过 hive.metastore.uris 远程连接——这就是"远程服务器模式",公司里用得最多。
3. 大脑:Driver。 负责把 HQL 走完"解析 → 编译 → 优化 → 生成执行计划 → 提交执行"全流程。
4. 干活的:执行引擎 + HDFS。 计算跑在 YARN 上(MapReduce 默认,Tez 官方推荐,Hive 4.x 已不支持 Spark 引擎),数据存在 HDFS 的 /user/hive/warehouse 目录下。
一句话总结:Hive 不存数据、不算数据——元数据在 MySQL,数据在 HDFS,计算在 YARN。
搭建环境时对应三种模式:内嵌 Derby(仅测试)、直连 MySQL(单节点,只起 HiveServer2)、远程服务器模式(Metastore + HiveServer2 独立部署,客户端任意节点接入)。初始化元数据库用:
schematool -dbType mysql -initSchema
直连 MySQL 模式的核心配置 hive-site.xml:
<configuration>
  <!-- 表数据在 HDFS 的根路径 -->
  <property>
    <name>hive.metastore.warehouse.dir</name>
    <value>/user/hive/warehouse</value>
  </property>
  <!-- 元数据存 MySQL -->
  <property>
    <name>javax.jdo.option.ConnectionURL</name>
    <value>jdbc:mysql://node2:3306/hive?createDatabaseIfNotExist=true&useSSL=false&allowPublicKeyRetrieval=true</value>
  </property>
  <property>
    <name>javax.jdo.option.ConnectionDriverName</name>
    <value>com.mysql.jdbc.Driver</value>
  </property>
  <!-- HiveServer2 地址与端口 -->
  <property>
    <name>hive.server2.thrift.bind.host</name>
    <value>node1</value>
  </property>
  <property>
    <name>hive.server2.thrift.port</name>
    <value>10000</value>
  </property>
</configuration>
远程客户端则只需一条配置,指向 Metastore:
<configuration>
  <property>
    <name>hive.metastore.uris</name>
    <value>thrift://node1:9083</value>
  </property>
</configuration>
Java 工程接入走 JDBC(Maven 引入 hive-jdbc 4.0.0):
Connection conn = DriverManager.getConnection(
        "jdbc:hive2://node1:10000/default", "root", "");
Statement stmt = conn.createStatement();
ResultSet rs = stmt.executeQuery(
        "SELECT e.emp_id, d.dept_name FROM emp e " +
        "JOIN dept d ON e.dept_id = d.dept_id");
while (rs.next()) {

    System.out.println(rs.getString(1) + "\t" + rs.getString(2));
}
三、表设计:内/外表、分区、分桶三板斧
3.1 内部表 vs 外部表:删除行为是唯一分水岭
-- 内部表:DROP 时元数据 + HDFS 数据一起删
CREATE TABLE inner_tbl (id INT, name STRING)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';

-- 外部表:DROP 时只删元数据,数据原地保留
CREATE EXTERNAL TABLE ext_tbl (id INT, name STRING)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';
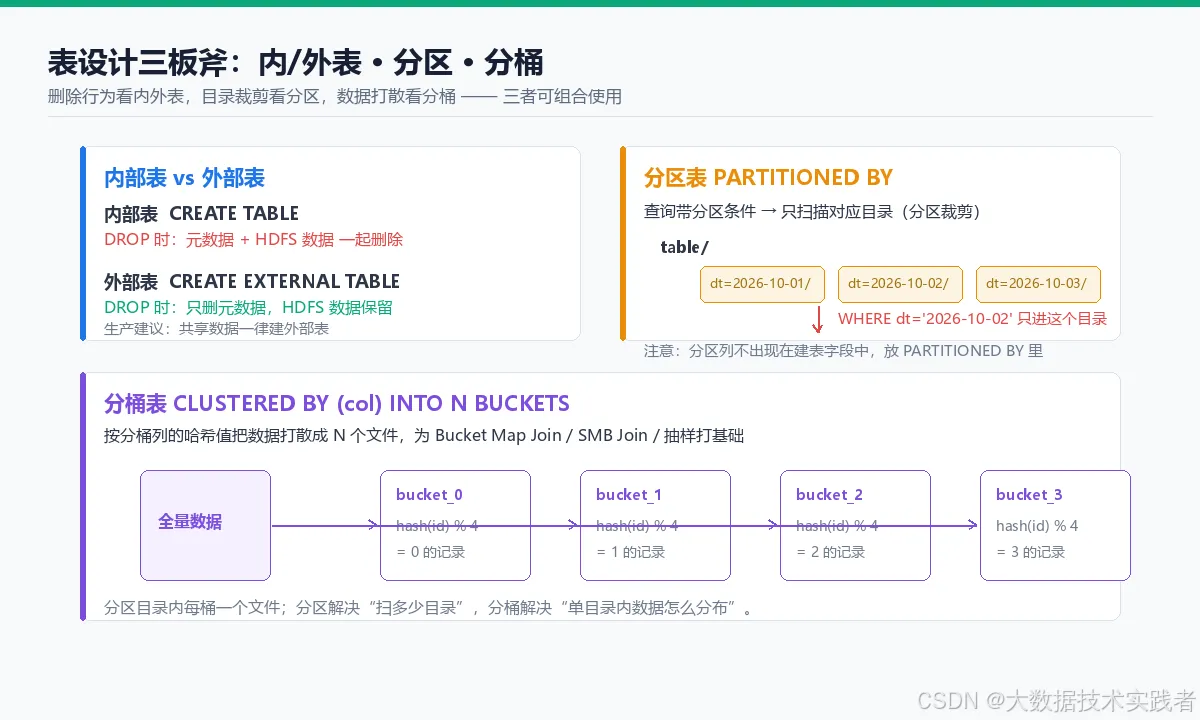
生产铁律:会被多个任务、多个团队共享的数据一律建外部表,防止误删上游数据;只有中间临时结果才用内部表,让生命周期随表自动回收。
3.2 分区:用目录裁剪换查询速度
分区把数据按分区列落到不同 HDFS 目录,查询带分区条件时只扫描对应目录:
CREATE TABLE dwd_order (
    id INT,
    amount DECIMAL(10,2)
)
PARTITIONED BY (dt STRING)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';

-- 只扫 dt=2026-10-22 这一个目录
SELECT sum(amount) FROM dwd_order WHERE dt = '2026-10-22';
两个易错点:分区列不能出现在普通字段里,只能写在 PARTITIONED BY 中;HDFS 上手动迁移了分区目录后要用 MSCK REPAIR TABLE 修复元数据。数据倾斜于写入的场景开动态分区,注意配好 hive.exec.dynamic.partition.mode=nonstrict。
3.3 分桶:让数据在目录内"打散"
分桶按分桶列的哈希值把每个分区的数据切成 N 个文件:
CREATE TABLE bucket_tbl (id INT, name STRING, age INT)
CLUSTERED BY (id) SORTED BY (age) INTO 4 BUCKETS
ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t';
分桶的价值在查询时兑现:两张同分桶列、同桶数的表 Join 时可走 Bucket Map Join 甚至 SMB(Sort Merge Bucket)Join,彻底跳过大表 Shuffle;TABLESAMPLE 抽样也只扫单个桶。一句话记住分工:分区决定"扫多少目录",分桶决定"目录内数据怎么分布"。
3.4 存储格式与压缩:ORC + Snappy 是默认答案

一张 600MB 的 CSV 明文表,转成 Snappy 压缩的 Parquet 后只有约 40MB——压缩比接近 15:1,扫描代价同步骤降。选型结论很收敛:
- TextFile:默认格式,可直接 load 原始文件,做贴源临时层;
- ORC:列存、自带索引,Hive 生态首选;
- Parquet:列存通用标准,Spark/Impala 混合引擎环境选它;
- 生产黄金组合:ORC + Snappy/LZO 或 Parquet + Snappy/LZO。
CREATE TABLE orc_tbl (id INT, name STRING)
STORED AS ORC
TBLPROPERTIES ("orc.compress" = "snappy");

CREATE TABLE pq_tbl (id INT, name STRING)
STORED AS PARQUET
TBLPROPERTIES ("parquet.compression" = "snappy");
注意:非 TextFile 表不能直接 load 原始文件,正确姿势是先 load 进 TextFile 临时表,再 INSERT INTO ... SELECT 转入列存表——转换过程会触发 MR 任务,压缩在此时生效。
四、优化:把参数用在刀刃上
Hive 参数有三种设置方式,优先级为:会话 set > beeline -hiveconf > hive-site.xml。调试用 set,固化写配置文件。
先讲三个"别关"的默认项:谓词下推(hive.optimize.ppd,where 条件前移减少下游数据量)、向量化执行(hive.vectorized.execution.enabled,从逐行处理变批处理)、Fetch 抓取(hive.fetch.task.conversion=more,让 select * limit n 这类查询不起 MR 任务)。它们默认开启,是 Hive 多年打磨的红利。
再讲四个"主动开"的高杠杆项:
① Map Join——大表 join 小表时把小表整个载入内存,SQL 只剩 Map 阶段,没有 Shuffle 就没有瓶颈:
SET hive.auto.convert.join = true;          -- 默认 true
SET hive.mapjoin.smalltable.filesize = 25000000;  -- 小表阈值 25MB,可调大
② Map 端预聚合——Group By 场景在 Map 侧先局部聚合,大幅削减 Shuffle 数据量:
SET hive.map.aggr = true; -- 默认 true
③ count(distinct) 改写——大表去重用一个 Reduce 硬扛是经典事故,改写后并行度完全释放:
-- 慢:单一 Reduce 去重
SELECT count(DISTINCT uid) FROM dwd_visit;

-- 快:先分组去重再计数
SELECT count(*) FROM (
    SELECT uid FROM dwd_visit GROUP BY uid
) t;
④ 小文件治理——hive.exec.compress.output 开启后小文件会更碎,定期用 INSERT OVERWRITE ... SELECT 重写表目录,或用 HDFS HAR 归档,保护 NameNode 内存。
用 EXPLAIN 验证一切优化是否生效:看 Stage 依赖(几个 MR Job)、看算子树(是否出现 Map Join / vectorized 标记)。
五、数据倾斜:先定位,再对症下药
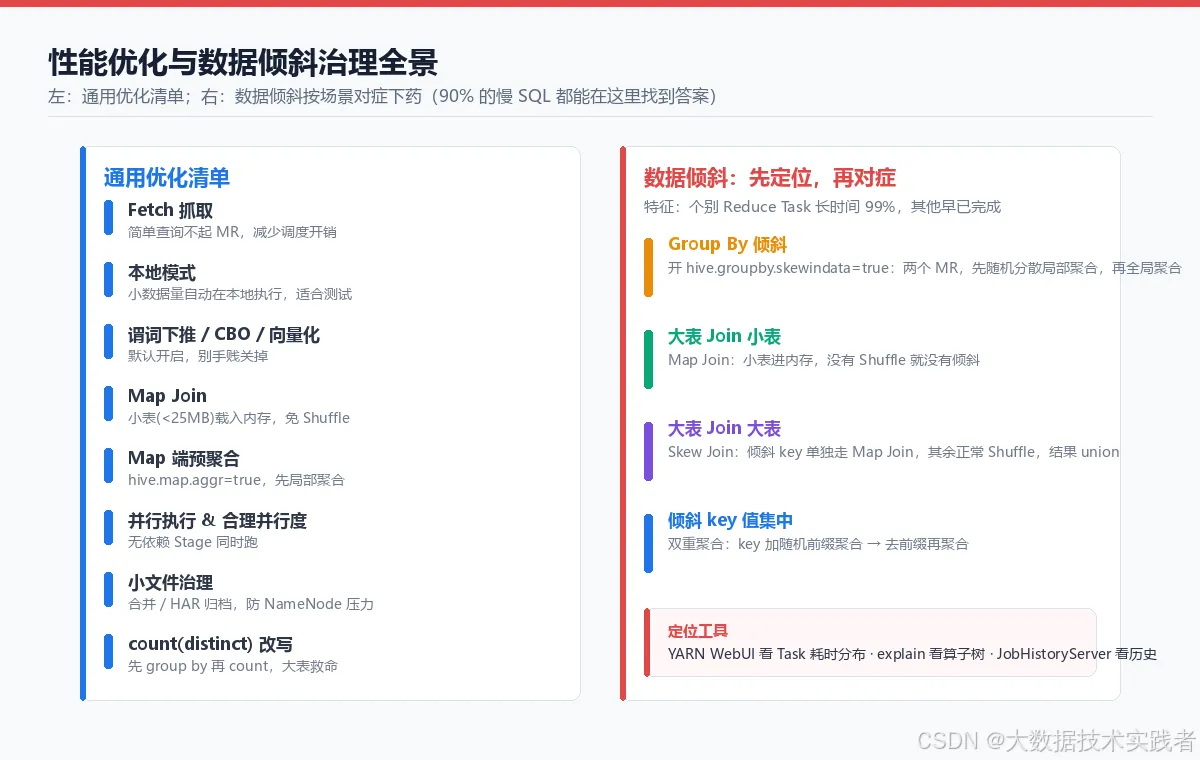
倾斜的典型症状:99% 的 Reduce Task 几秒跑完,个别 Task 卡在 99% 半小时不动。根源永远是同一句话:某个 key 的数据量远超其他 key,全部被哈希到了同一个 Reduce。
动手前先开 JobHistoryServer(mapred --daemon start historyserver),在 WebUI 里确认到底是哪个 Task、哪个 key 倾斜。然后按场景开药:
场景一:Group By 倾斜。 一键开关,代价是两个 MR Job:
SET hive.groupby.skewindata = true;
-- 第一个 MR:key 随机分散到各 Reduce 做局部聚合
-- 第二个 MR:对局部结果按原始 key 做最终聚合
场景二:Join 时大表配小表。 直接 Map Join(见上文),小表进内存,不存在 Shuffle 就不存在倾斜。
场景三:Join 时大表配大表、且倾斜 key 明确。 开 Skew Join,倾斜 key 自动单独走 Map Join,其余 key 正常 Shuffle,结果 union:
SET hive.optimize.skewjoin = true;
SET hive.skewjoin.key = 100000;  -- key 行数超过 10 万即判定倾斜
场景四:倾斜 key 无法用参数兜底(或参数版本不兼容)。 手工双重聚合——给 key 加随机前缀打散聚合,再去前缀二次聚合。假设 90% 订单属于同一家物流公司:
WITH prefixed AS (
    SELECT
        CONCAT(CAST(FLOOR(RAND() * 10) AS STRING), '_', company_id) AS pid,
        cost
    FROM ship_tbl
),
agg1 AS (
    SELECT pid, SUM(cost) AS partial_cost
    FROM prefixed
    GROUP BY pid
)
SELECT
    SPLIT(pid, '_')[1] AS company_id,
    SUM(partial_cost)  AS total_cost
FROM agg1
GROUP BY SPLIT(pid, '_')[1];
第一次聚合时 COMP0001 已被拆成 0_COMP0001、1_COMP0001……10 份并行处理,倾斜被彻底打散。这套"打散—局部聚合—合并"的思想,与 skewindata 参数一脉相承,只是控制权交到了你自己手里。
写在最后
回到开头的问题:Hive 为什么"什么都没干"却能统治离线数仓十五年?因为它做对了一件最难的事——把分布式计算的复杂性藏在了 SQL 方言背后。架构上它把元数据、存储、计算各归其位;表设计上用分区、分桶、列存给了你驾驭数据物理分布的全部抓手;优化上从 Fetch 到 Skew Join 提供了完整的梯度工具箱。
给你一份带走的生产 checklist:
- 共享数据建外部表,业务数据按日期分区;
- 存储默认 ORC + Snappy,跨引擎共享再考虑 Parquet;
- 上线前跑 EXPLAIN,确认 Map Join 和向量化已生效;
- 大表去重先 group by 再 count;
- 遇到 Task 卡 99%,按"Group By / 大小表 Join / 大大表 Join"三条路径对症处理。
把这张清单贴在工位上,你写出的 HQL 就已经比大多数人更接近"生产级"。
参考:Apache Hive 官方文档(hive.apache.org);文中配置基于 Hive 4.0.0 + Hadoop 3.x 集群实测。

